ARTICLE · 1317048
嵌入式开发硬件到软件只要1周!嵌入式的 AI 替代狂潮即将来临?
嵌入式的 AI 替代奇点已经到来?
10 月 30 日这一天,AI 和我一起完成了这些事:新建一个 LIN 工程,删掉原来的 CAN 代码,接入 LIN 协议栈和传输层,点亮灯,再实现静态颜色和三种动画。
当我坐在屏幕面前看着AI龙飞凤舞,极其熟练的调用powershell,流畅精确的进行测试工作时,我瘫坐在椅子上,震惊炫目,仿佛看到了核弹爆炸
放在以前,纯人工做完这些,少说要几周。写代码的速度,人已经比不过 AI 了。这几年,行业里裁员的消息一个接一个。
技术人心里或多或少开始意识到:技术人的路,是不是快走到头了?
笔者是一个刚入职的新人,基础薄弱,却在 AI 的帮助下,几周内做出了一款在研芯片的 Demo。这不由得让人担心起来:AI 可以做什么,人还能做什么?
第一部分
AI 如何加速嵌入式开发
1背景:一个新人接手一个新项目
1.1 笔者的情况
笔者在一家汽车半导体公司做 AE(应用工程师)。AE 的工作是帮客户把公司的芯片用起来:做 Demo 板和参考代码,支持客户调试,解答技术问题。所以 AE 要懂的面很宽,芯片、软件、硬件、总线协议,还有整车厂的规范,都要懂一些。
笔者刚入职,还在试用期,基础比较薄弱。微控制器底层的启动流程、存储布局和总线,以前基本没有接触过;LIN 协议没做过,公司的芯片和已有代码也不熟悉。
1.2 项目内容:设计一款在研芯片的Demo
这颗芯片是车规 LED 驱动芯片,内部合封了两颗 die:一颗 Cortex-M3 微控制器,一颗高压 LED 驱动。
主要任务有六项:
2嵌入式开发的痛点
要频繁查 DS 和 UM。手册有几百页,一个功能的信息分散在好几章。 笔者在半导体公司,芯片还在研发中,文档也还在编写。不同版本的文档会互相矛盾,例如引脚命名分两层,某张表是从别的版本复制过来的。 软件和硬件都要懂。为了“LIN 不通”这一个问题,笔者先后查过波特率、引脚复用、接地和总线电容,最后发现是收发器的问题。 每个器件、每个工具都要现学。收发器、调试器、总线分析仪、电源各有自己的手册和开发包。例如,总线工具的 VBAT 引脚要不要外接电源,笔者就查了很久。 协议和标准篇幅很大。ISO 17987 分好几个部分,一致性测试的条款也很多。 调试一次要走很多步。每改一行代码,都要编译、烧录、手动发帧、观察现象,每一步都要在图形界面里点。查出来的结论和遇到的问题,也只记在自己脑子里。 新人还有自己的难处:人是新的,芯片也是新的;不知道该问什么,不知道公司已有的代码在哪里,听不懂术语。 进度压力大:芯片可能延期,工作要拆到三块不同的板子上并行开发,最后再合并,时间又紧。
3人和 AI 各自擅长什么
由此得出的分工:AI 负责读资料、写代码、跑测试、做记录;人负责做决定、动手操作、审核改动、学懂原理。
4AI 在每个环节做了什么
4.1 AI 的能力有多夸张:LIN 怎么都收不到数据,AI 几分钟就查出了原因
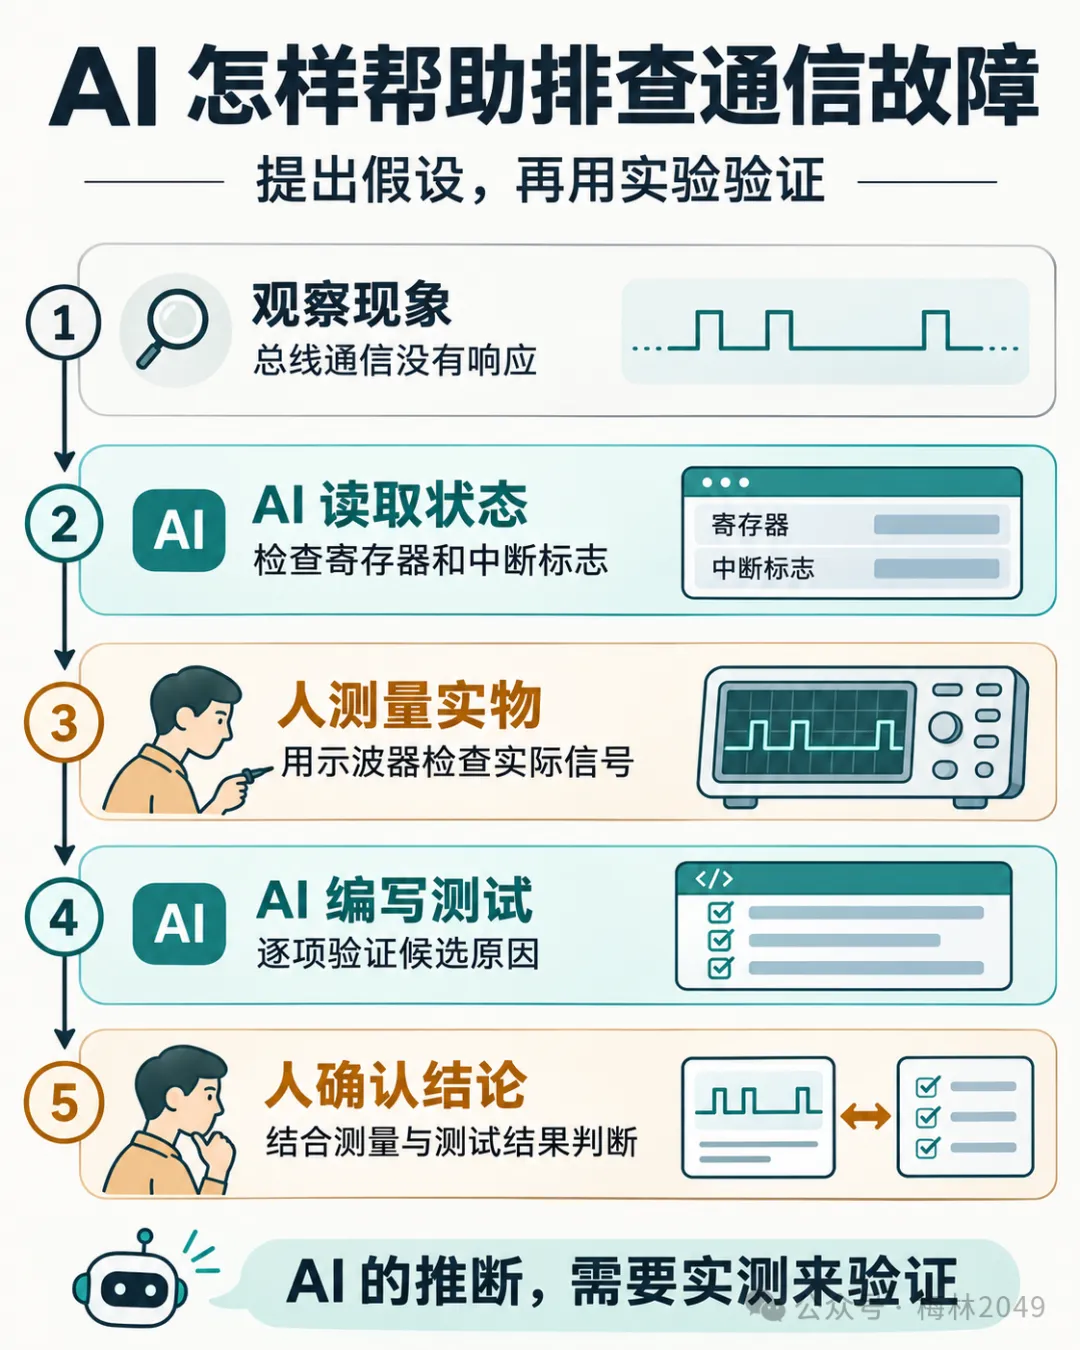
背景:新板子打样回来,要做功能测试。早期打样的 Demo 板有一部分是手工焊接的,硬件和软件都可能出问题。 现象:新板子的 LIN 没有响应。AI 自己读取寄存器,发现 GPIO 电平没有翻转,LIN 中断标志也没有置位,由此判断 MCU 根本没有收到数据。笔者随后用示波器测量,发现收发器没有把总线信号转出来,证实了 AI 的判断。 AI 的强大之处:它写了一个脚本,把 UART 的 RX 功能依次映射到 7 个候选 GPIO,每映射一个就检查波特率寄存器有没有锁定。几分钟后结果出来:实际的 RX 引脚和设计文档写的不同。
这个案例里,AI 用最根本的办法核实了 RX 的引脚映射:不看文档怎么写,把每个候选引脚都试一遍。各位不妨想一想:这样一个测试脚本,AI 5 分钟就写完、跑完了。换成是你,需要多久?
5让 AI 发挥优势:搭建知识库和工具链
AI 这么强大,打不过就加入。
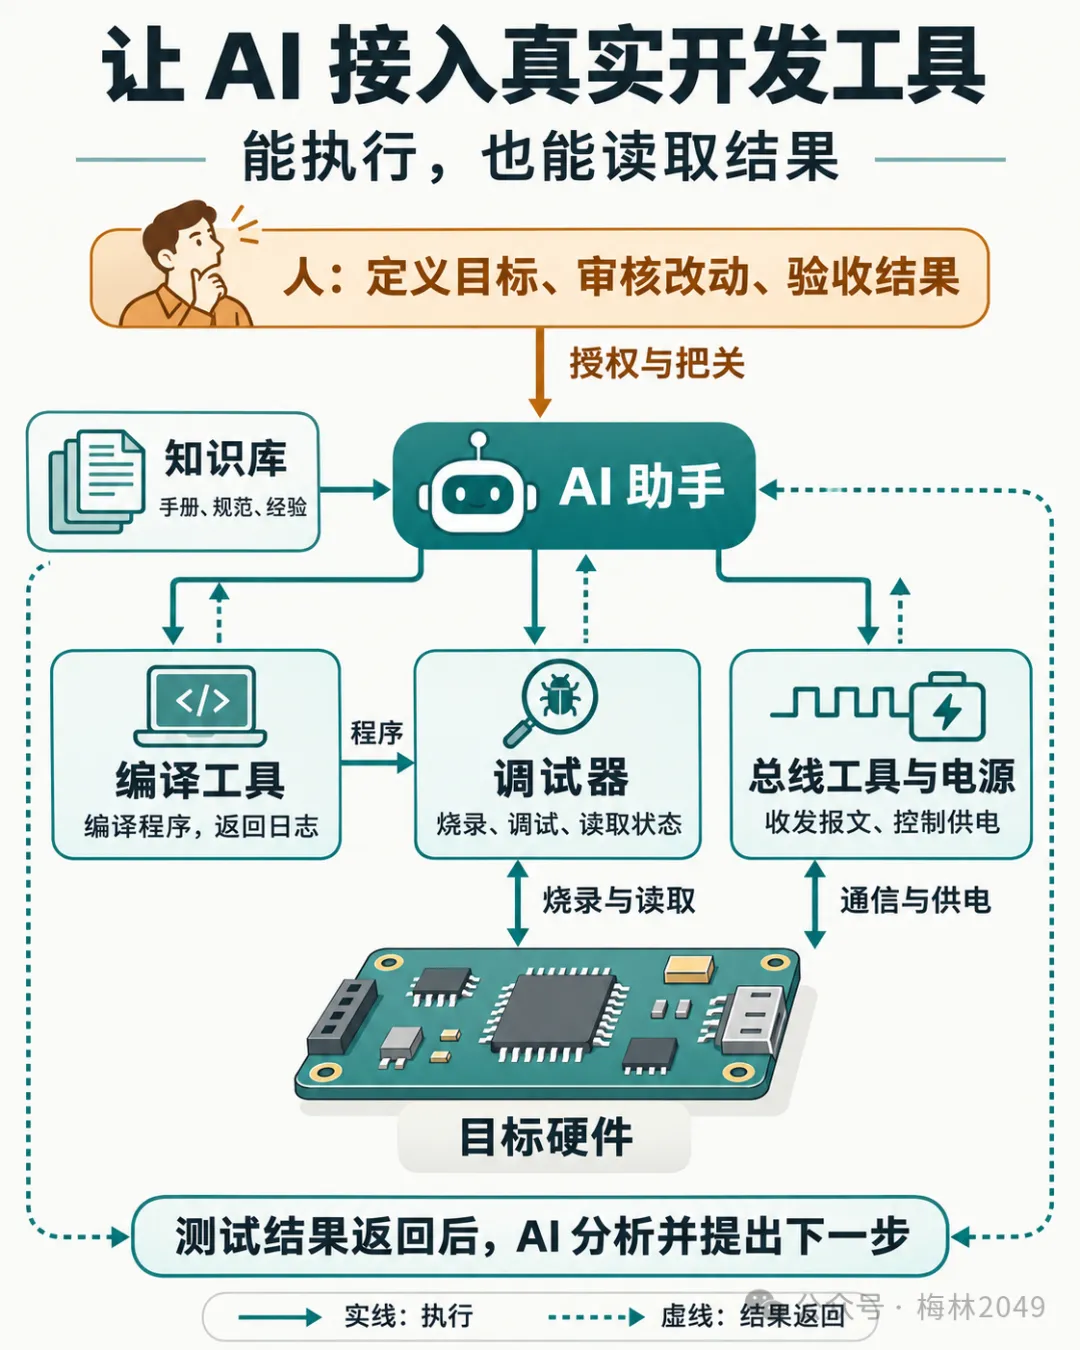
要让 AI 最大程度地辅助开发,原则是给 AI 三样东西:能读资料和芯片状态的“眼睛”,能编译、烧录、发帧、控制电源的“手”,能积累经验的“记忆”。
5.1 资料知识库(给 AI 装上项目专属的知识,这一步最重要)
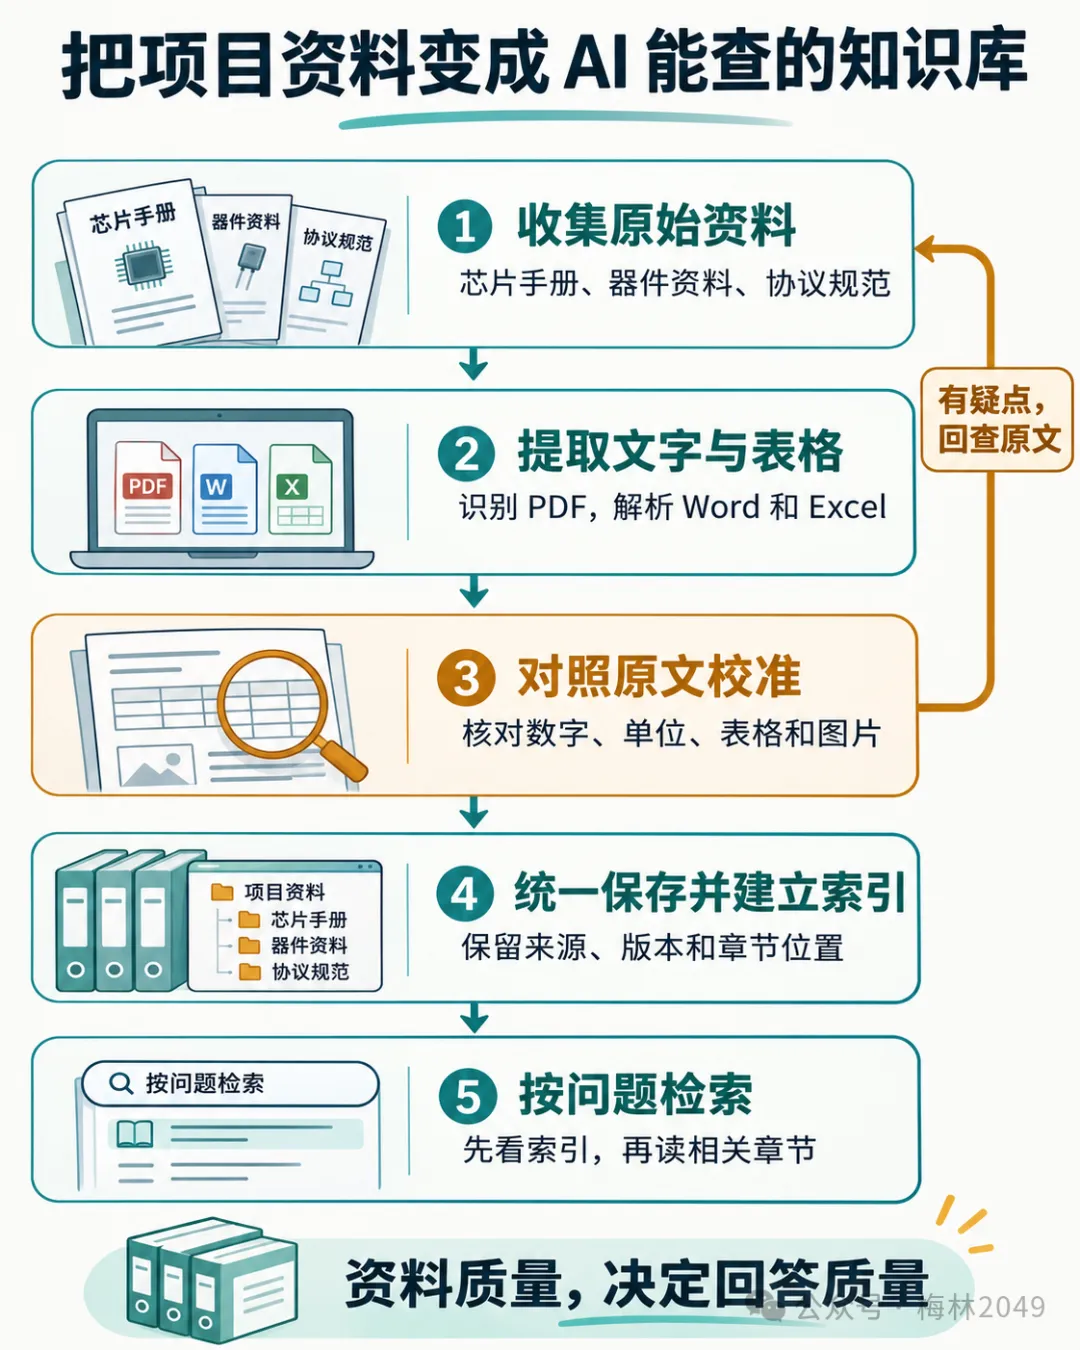
嵌入式的资料特别多、特别杂,而且分散在各处。要让 AI 帮上忙,第一步是让它有足够的背景知识。所以先为它准备一个知识库,AI 在需要的时候自己去检索。
要做四件事:
尽可能把资料收集齐。 用到的元器件资料、MCU 的数据手册(datasheet)和用户手册(user manual)等,都尽量收集齐,按规范统一存放。 把 Word、Excel、PDF 等资料全部转成 Markdown。为什么要转成 Markdown?因为这种格式对 AI 更友好。 做索引文件,说明每个文件讲的是什么。AI 遇到问题先看索引,就知道该去哪里查。 让 AI 交叉比对资料,有矛盾的地方提出来,交给人审核。
推荐的做法:
PDF:用 OCR 模型识别文字,得到文本草稿。推荐两个开源模型:MinerU( opendatalab/MinerU)和百度的 Unlimited-OCR(baidu/Unlimited-OCR)。Word、Excel,以及 PDF 识别出的文本草稿:用 AI 校准内容,整理格式,统一规范。 统一保存,再让 AI 生成资料索引。
这一步决定了后面所有环节的上限。AI 查资料、写代码、做硬件检查(见 5.3)、对照规范检查(见 5.4),都依赖知识库的质量。
5.2 MCU 开发工具链(手和眼睛)
MCU 开发离不开写代码、烧录和测试三步,测试时还要看寄存器、发串口命令和协议命令。要让 AI 加速开发,就得让它自己能做这些事,所以要给它搭好工具链:
几点补充:
AI 用寄存器描述文件(SVD)看懂寄存器每一位的含义,用链接器生成的 map 文件找到变量的地址。 MCP 是让 AI 调用外部工具的一种接口。 图莫斯提供开放的动态库,AI 直接用 Python 写测试脚本。本项目的多帧传输测试,10 个用例一次跑完。 数控电源通过 USB 虚拟串口受控,除了做长时间运行测试,还能测芯片上电、下电时的复位和初始化。
ARM Cortex-M 的生态完善,容易接入:芯片支持包、SVD 文件都有,J-Link 也自带命令行工具和动态库。相比之下,H430 内核在这方面就差很多(你说对吧,Elmos?)。
5.3 硬件设计与检查
嵌入式工程师用一个不熟悉的元器件,一般要先查它的手册,看它的典型应用电路。原理图画完,还要逐个核对引脚和网络。这些工作量大,又容易看漏,很适合交给 AI。
前提是器件资料已经转成 Markdown(见 5.1)。
本项目的做法:嘉立创 EDA 专业版,加上它的 agent 接口(easyeda-agent,命令行工具),AI 可以直接读写工程。
在笔者开发的过程中,AI 在下面几个方面帮了大忙:
查器件手册,找典型应用电路和关键参数。 例如 LIN 节点的总线电容,AI 能直接引用 ISO 17987 里的典型值和上限。 AI 能给出典型电路里外围元器件的选型,并判断是否需要额外的电路设计。 读回原理图和 PCB,逐脚核对。本项目中,AI 读回 Demo 板的原理图和 PCB,逐脚核对了收发器的连接和焊盘编号。 运行设计规则检查(DRC),读回违规列表;也能直接做小的修改。 辅助 PCB 布线:分析板上哪里还有空间,给出走线建议。笔者的板子面积有限,大部分线已经画完、走得很密,人很难再想到新路径,AI 帮笔者分析了剩下的线该怎么走。
5.4 总线和协议测试:把规范整理成文档,让 AI 对照检查
汽车产品要通过一致性测试,例如 LIN 一致性测试。而且每家 OEM(整车厂)都有自己的规范(spec)。这些规范动辄几百页,条款分散,人工逐条对照协议栈很费时间,也容易漏。
因此,要把规范也变成 AI 能读的资料:
把一致性测试规范和 OEM 的规范整理成 Markdown,方法同 5.1。 开发中涉及总线的需求,单独提取出来,整理成一份需求清单。 让 AI 拿自己的协议栈逐条对照,列出不符合的地方,交给人审核,由人决定改不改。
AI 能帮忙检查的内容:
LIN 一致性:协议栈的行为是否符合 ISO 17987 和一致性测试规范。 UDS 诊断服务:支持哪些服务、否定响应、超时参数是否符合规范。 OEM 的 OTA(远程升级)规范:升级流程是否符合 OEM 的要求。
本项目的例子:
AI 对照 ISO 17987 原文,逐条分析现有机制是否符合规范。例如,从机收到不支持的节点配置服务时,不应该应答;收到诊断请求以后,从机要在规定时间(P2max,500 ms)内应答。 AI 还找出了 2016 版和 2025 版在本代码上的差异。MCU 的 LIN 协议栈按 2016 版实现,使用 B9 到 BF 这段服务号;2016 版对这段服务号只说“默认不回否定应答”,而 2025 版明确要求节点不得响应。 AI 读 OEM 的测试规范时发现,传输层的测试用例要靠几个 UDS 服务来触发。所以要先实现一个最小的 UDS 子集,才能跑这些用例。
规范不全,AI 就查不出差异;规范转错了,AI 就会照着错的去改。
5.5 工程管控:项目说明文件和 skill(记忆)
做好一份项目说明文件。Claude Code 读 CLAUDE.md,Codex 等工具读 AGENTS.md。你可以在里面提醒 AI:
哪些资料放在什么位置; 做某件事之前,要先做什么。
积极把经验总结成 skill。遇到问题以后,为了以后不再反复遇到同类问题,或者为了让 AI 记住自己的操作偏好,可以把它写成 skill,或者写进对应的项目说明文件。
例如:按主题写操作手册(skill),每份手册附一份经验日志。日志按“现象、原因、做法”记录。同一件事出现第二次,就整理成规则写进手册。
5.6 版本管理和人工审核
用 Git 做版本管理。 关键位置由人介入,例如代码改动:改动拆小,由人逐个审核。 读取有副作用的寄存器之前,先提醒风险。
5.7 搭建过程本身也交给 AI
搭建工具链时,先让 AI 去 GitHub 搜索开源方案,再让它在本地实测。
本项目中,AI 评估了 7 个开源方案,并逐个实测。会卡死 IDE、会误写内存、需要更换驱动的方案都被淘汰了。
6遇到的问题和 AI 的局限
AI 也会得出错误结论。脱敏后举两个例子: 板子实物上的问题,最终要靠人用示波器、万用表和烙铁解决。 资料质量决定 AI 能做到什么程度。文档有错,AI 也会跟着出错,所以要以实测为准。 运行环境也会出问题,例如公司安全软件拦截程序、Windows 路径转义出错、调试器被另一个进程占用。
第二部分
在嵌入式开发中使用 AI Agent 的通用经验
把第一部分的做法往上提一层,得到两条在其他工程领域也适用的经验。
7优先选择 AI 友好的工具链
AI 最擅长处理文本。现在的 AI 也能读图,但读图消耗的 Token(AI 处理文字的计量单位)更多,效果却不如读文本准。所以选工具时,优先选能用文本和 AI 交互的工具:有命令行、有开发包,文件格式是文本,例如 Markdown、网表、SVD、LDF。
下文把这类工具称为“AI 友好”的工具。判断标准有四条:
有命令行、开发包或公开的通信协议。 不需要图形界面就能运行,输出结果能被程序读取。 不光能下命令,还能查询状态。 不和 IDE 争抢资源,不需要更换驱动。
分类举例:
8理解 Agent 的运行逻辑
最好弄明白 Agent 是怎么工作的,这样才能管控好工程。要点有三个:
项目说明文件( CLAUDE.md、AGENTS.md)在每次会话开始时自动加载,一直留在上下文里。所以它要写得短,只放最要紧的规则和资料位置。skill 平时只有一行描述留在上下文里,任务和描述匹配时,才加载正文。所以描述要写清楚“什么时候用”,正文可以写得详细。 上下文的容量有限,资料不能一次全部放进去。所以要靠索引,让 AI 按需检索(呼应 5.1)。
明白了这些,就知道一条规则该写在哪一层,也能理解 AI 为什么有时不遵守规则。
第三部分
AI 时代,人和工程师怎么立足
开篇留下了一个问题:AI 可以做什么,人还能做什么?纯比速度,人已经比不过 AI,和它比速度没有意义。这一部分先回答对所有人都成立的部分,再落到工程师身上。
9人在 AI 时代怎么立足
9.1 先拥抱 AI,再把它当成杠杆
第一个答案:打不过就加入。先在自己的工作里天天用起来,才知道 AI 能做什么、不能做什么。研究也表明,用得越久,用得越好(见 10.3)。
用起来以后,再把 AI 当成杠杆:把自己的工作变成 AI 能参与的形式。第一、二部分讲的就是这件事:资料转成文本,工具能用脚本控制,规范能拿来逐条检查。
9.2 生成变便宜了,检验变得更值钱
先下两个定义:
生成:产出新东西,例如写代码、写脚本、写文档、起草方案。 检验:判断产出的东西对不对、好不好,例如读懂代码、设计实验验证结论、对照规范逐条核对、比较方案的优劣。
AI 让生成的成本降到几乎为零,检验的成本却没有降多少。产出的东西越多,要检验的也越多。
那么,凭什么能从根本上证明 AI 做的是对的、好的?笔者的方法论是:从根本出发,只看科学的证据。
检验要看两个方面:
对:符合事实和规范。 好:方案本身好不好。例如实验设计得是否合理,需求草案有没有抓住重点。
要判断对和好,需要三种能力:
这三种能力,归根到底要求底子扎实。认知科学研究专家和新手的差别时,常用心智模型这个概念:人脑里对一个领域的简化地图,包括有哪些主要部件、部件之间有什么因果关系。地图准确,就能预测结果;结果和预测对不上,就知道哪里出了问题。
有一项经典研究(Chi 等人,1981 年)请物理专家和新手给物理题分类。新手按表面特征分,例如“都有斜面”;专家按背后的原理分,例如“都用能量守恒”。
所以,底子扎实不在于工作年头长、记得多,而在于脑子里有一张准确的地图,并且知道地图背后的原理。
人的角色也随之改变:从执行者变成负责人。人更像空中交通指挥员,定目标、分派任务、验收结果。指挥员虽然不开飞机,却必须懂飞机,否则飞机出了异常也发现不了。所以,人不必亲手做每一步,但要能看懂每一步。
9.3 AI 公司自己的研究怎么说
前面几节是笔者的体会。AI 公司自己也在研究这个问题:Anthropic 和 OpenAI 都发布过 AI 对各职业影响的报告。
报告提出了三个概念:
暴露度:理论上,AI 能不能把这类任务做完或做快。 实际使用:人们现在真的拿 AI 做了什么。 替代:岗位真的因为 AI 减少了。
多数研究测的是前两个。暴露度高,不等于岗位会消失。
几项研究的主要结论:
受影响最大的,是写代码、写文字、处理文书的工作。 Anthropic 2026 年 3 月的研究里,计算机程序员的观察暴露度最高,约 75%。OpenAI 2023 年的研究估算,约 80% 的美国劳动者至少有 10% 的任务会受大模型影响。 受影响小的工作,共同点是动手操作实物、面对面和人打交道、受监管且需要有人担责。 例如厨师、修理工、护理。Anthropic 2026 年 9 月的研究估算:机器人在技术上能做 74% 的体力任务,但只有约 0.3% 的体力任务,用机器人比用人便宜。 专业能力仍然有回报。 Anthropic 分析编程工具 Claude Code 的使用记录发现:新手的会话,经核实成功的只有 15%;中级及以上的用户是 28% 到 33%。遇到问题时,新手有 19% 选择放弃,其他人只有 5% 到 7%。AI 放大的是人原有的能力,底子薄的人被放大得也少(见 10.2)。 用得越久,用得越好。 Anthropic 2026 年 3 月的报告显示,用满 6 个月的用户,任务成功率更高,也更常反复迭代,而不是把任务一扔了之。
这些结论和笔者在项目里的体会是一致的:AI 接走了生成,人的价值转到了检验、动手和对结果负责。
9.4 再往上一层:从源头的需求看问题
市场上的每一样东西,都是为了满足人的某种需求:先是生存和安全,再是舒适、被认可和精神上的满足。AI 能把“怎么做”变得越来越便宜,但“为什么要有这个东西”,要从人和社会里找答案。
以氛围灯为例,一路问下来:
车里为什么要有氛围灯?为了舒适和情绪,属于精神需求;整车厂也靠它让车显得更高级。 为什么要做动态动画,还要控制很多颗灯?因为静态的灯光已经打动不了消费者。 为什么用 LIN 总线?因为灯多,每个节点都要省成本,而 LIN 便宜。 为什么要过一致性测试?因为同一条总线上挂着不同供应商的节点,必须按同一套规范通信。 公司为什么推出这颗芯片?因为客户希望每个灯节点用更少的器件,把微控制器和 LED 驱动合封成一颗,正好满足这个需求。 为什么要做这块 Demo?因为客户要先看到芯片跑起来。Demo 板和参考代码能降低客户导入的门槛,客户才更愿意选用。
问到这里,就明白了这块 Demo 板为什么存在,客户又为什么会提那些要求。
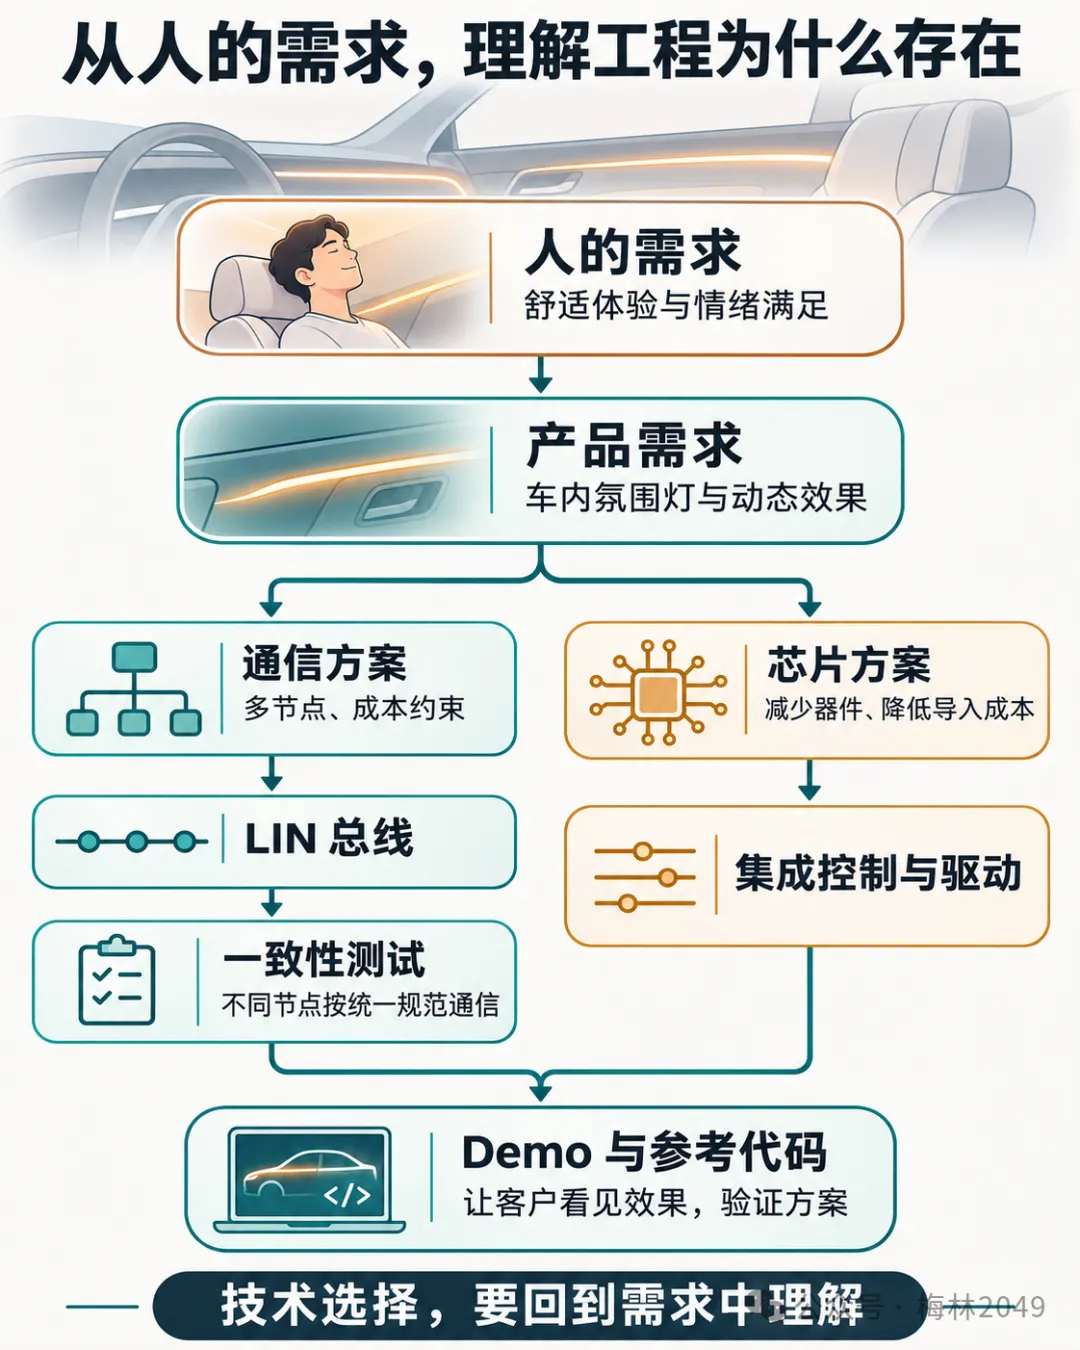
所以,与其只盯着“这个东西怎么做”,不如多问一句“世界上为什么需要这个东西”。前一个问题,AI 越来越擅长;后一个问题,要靠人去理解人、理解市场、理解社会。
10具体到工程师,应该怎么立足
前面讲的对所有人都成立。落到工程师身上,第一步是把自己的工作拆开看:哪部分 AI 能做,交给 AI;哪部分 AI 做不了,就把时间投进去。以笔者的 AE 工作为例,写参考代码这一半,AI 已经做得很好;调板子、到客户现场排查问题这一半,还得靠人。
笔者在这个项目里有两点体会,最后归结成一张能力表。
10.1 不懂细节会迷糊:警惕“理解债”
这次开发,笔者自己还处于半懂不懂的状态,整个工程却已经做完了。
作为研发工程师,不了解细节的时候会迷糊:出了问题判断不了原因,AI 说错了也看不出来。
这里借用“技术债”的说法,下一个定义。理解债:工程做完了,却没有人真正懂它。平时看不出来,等出了问题就要一次性偿还:现学原理、现读代码,而且往往是在最着急的时候。
笔者的做法是抓住工程主线和技术的主要框架,分三步:
先弄清为什么要做。 为什么要做这个 Demo,需求从哪里来,也就是 10.4 那条推导链。 在硬件和软件里抓主干。 硬件像一张网:先了解每个“点”,也就是各个芯片和电路主要做什么;再了解“点和点”之间怎么连接。 软件以功能为线索:跟着一个功能,看它涉及的数据怎么变化,经过哪些主要的函数。 让 AI 当自己的老师,关键的几步亲手做一遍。 让 AI 按这个框架一节一节地讲,笔者边听边问。
怎样才算懂了?笔者的标准是:能顺着框架讲清楚,为了实现某个功能,要按什么顺序做哪几步,每一步为什么要做。 讲得出来,才能说自己懂了。
10.2 新人的成长路径已断,主动学习
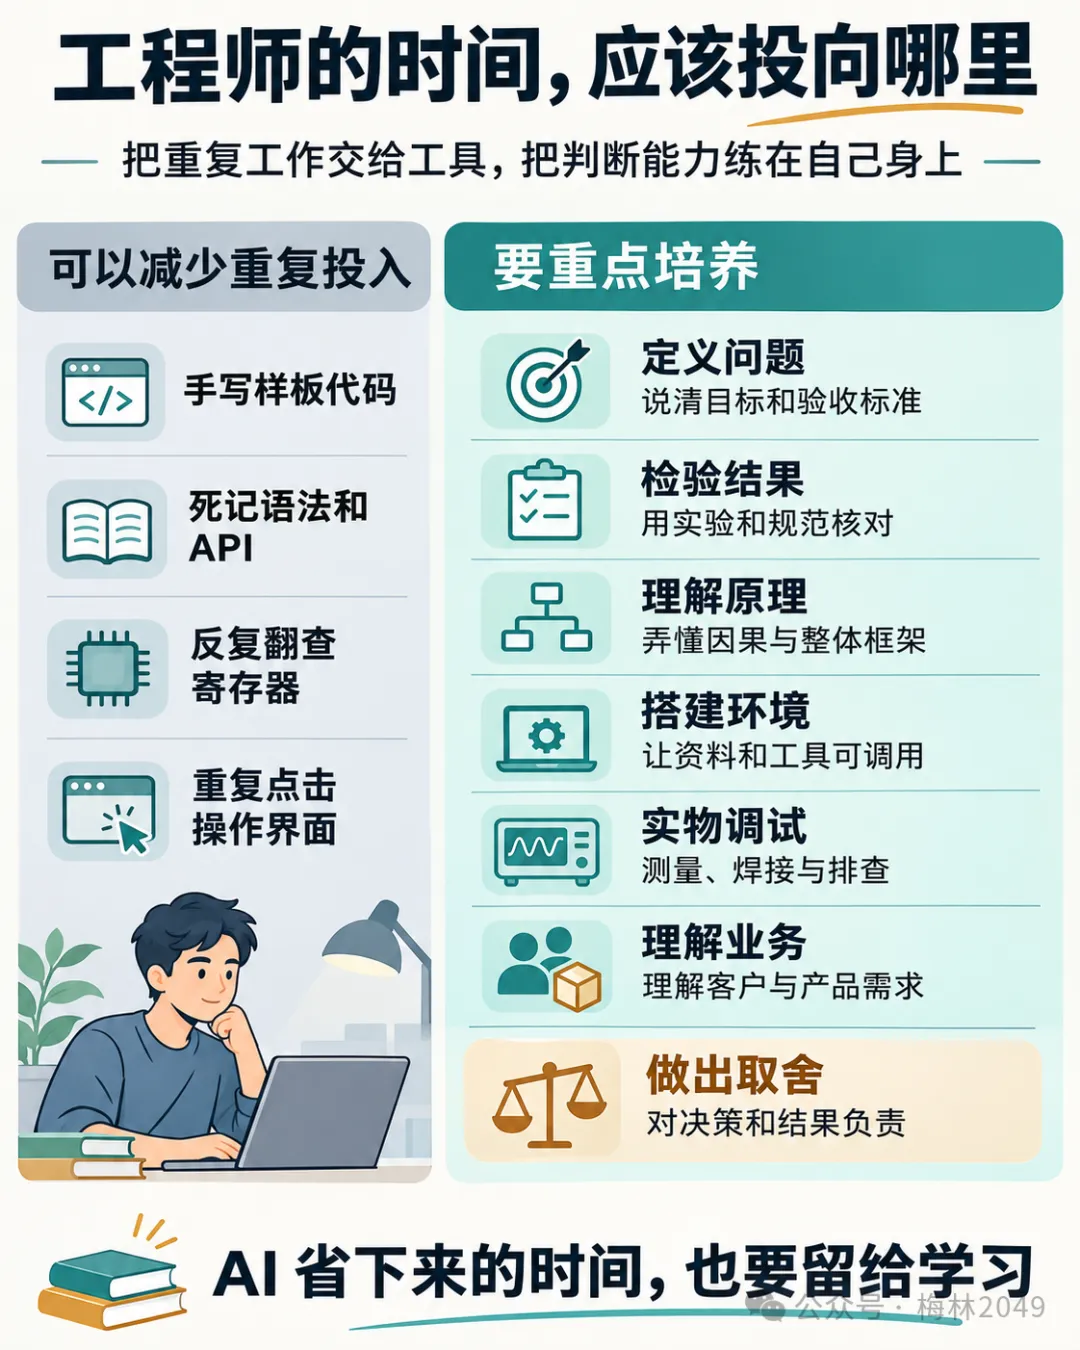
以前新人靠写样板代码、翻手册、做重复的调试打基础。这些杂活很枯燥,但基本功就是在里面顺带练出来的。
现在这些杂活都交给了 AI。基本功没法再顺带练出来,只能刻意去练:补课、做测验、回头学底层。
所以笔者的建议是:AI 省下来的时间,拿去学习,不要全拿去多干活。
10.3 哪些能力可以降低权重,哪些要重点培养
左边一栏都是生成类的工作,AI 能做得又快又好。右边一栏要么属于检验,要么是 AI 够不着的事:动手、和人打交道、对结果负责。
结语
这篇文章是一次分享。第一部分的做法,都在项目里实测过;第三部分的观点,是笔者目前的答案,笔者自己也还在探索。
笔者已经把这次用到的工具整理成了一个 skill。第一版是一份环境指引:
先提醒你为 AI 准备知识库,并说明怎么准备,做法就是第 5 节讲的 Markdown 化和索引。 列出硬件设计和软件调试要用的工具,例如编译烧录和调试工具、嘉立创 EDA 的 agent 接口、总线工具和数控电源,说明每一项能让 AI 做什么,逐项问你要哪些。 给出每个工具的官方获取地址,并告诉你哪些步骤要你本人来做,例如申请软件许可证、购买硬件。
用法很简单:克隆仓库,把 skill 链接到你所用智能体的 skill 目录,然后对 AI 说“帮我配置嵌入式 AI 环境”。
需要的话,可以到这里获取:https://github.com/levitation-well/embedded-ai-skills
编译烧录、电源控制、总线测试这些通用的 skill 和脚本
抛砖引玉,欢迎大家一起讨论:在你的工作里,AI 已经替你做了哪些事?省下来的时间,你打算用在哪里?
后续的实践和更新,会发在笔者的公众号“梅林2049”上,欢迎关注。
参考资料
Anthropic,AI 对劳动力市场影响的研究(观察暴露度),2026 年 3 月:https://www.anthropic.com/research/labor-market-impacts Anthropic,机器人能做哪些工作的研究,2026 年 9 月:https://www.anthropic.com/research/what-work-can-robots-do Anthropic,智能体编程与专业能力回报的研究,2026 年 6 月:https://www.anthropic.com/research/claude-code-expertise Anthropic,经济指数第六期(学习曲线),2026 年 3 月:https://www.anthropic.com/research/economic-index-march-2026-report OpenAI 与宾夕法尼亚大学,“GPTs are GPTs”,2023 年:https://arxiv.org/abs/2303.10130