ARTICLE · 1322717
首Token延迟最高改善56倍:AI推理的下一个瓶颈,为什么可能不在GPU?
首Token延迟最高改善56倍:AI推理的下一个瓶颈,为什么可能不在GPU?面对约 13 万个输入 Token,同一块 GPU 从头计算,要等 32.14 秒才开始回答。复用此前的计算结果,等待时间缩短到约 0.57 秒。这组数据给推理平台的建设者提出了一个问题:GPU 忙的时候,究竟有多少算力花在了重复读材料上? 
让 AI 审阅一份招标文件。第一个问题是“哪些设备需要提供第三方检测报告?”它找出了相关设备和条款。接着追问一句“这些报告要在投标时提交,还是可以在验收时补交?” 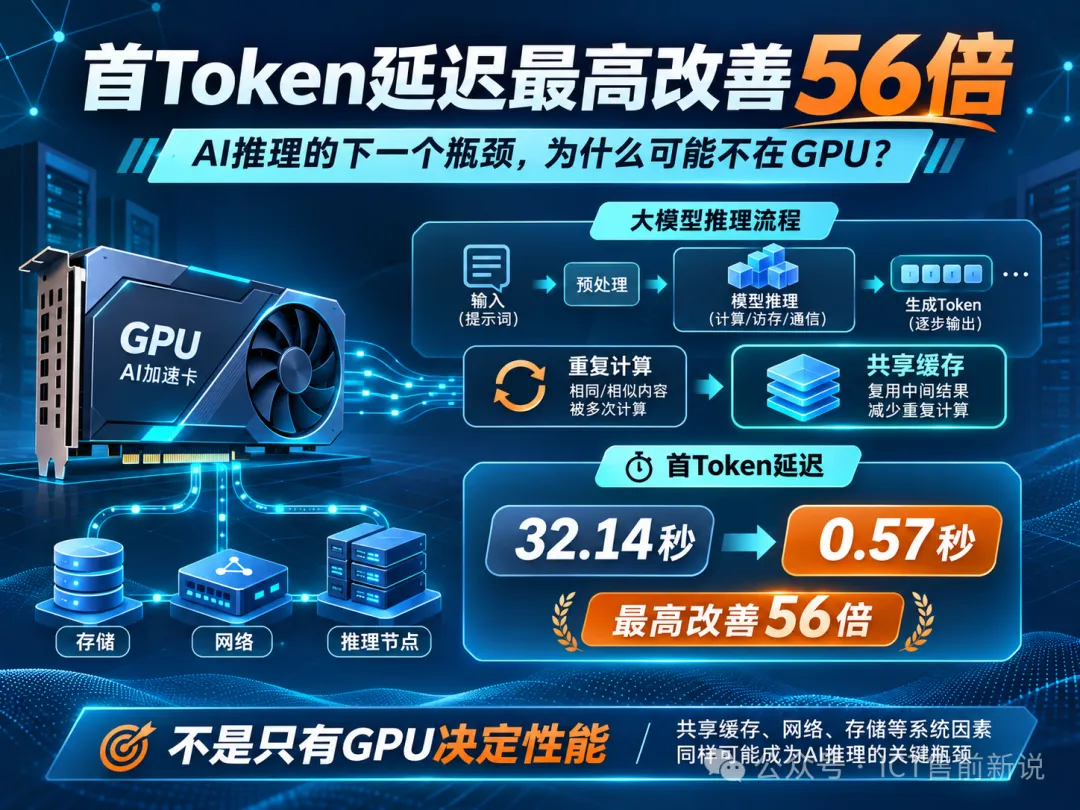
熟悉这份文件的人,大概会翻回刚才找到的几条原文,核对“投标时须提供”和“交付时提供”的措辞。可在推理系统里,这句只有几十个字的追问,有可能触发对整份文件的又一次计算。用户以为自己只是接着问,GPU 却可能要从第一页重新读起。 11 月 5 日,超微(Supermicro)发布了与 IBM、NVIDIA 合作的推理缓存方案。公告中“首 Token 延迟最高改善 56 倍”的数据,正好揭示了这类重复计算的代价。 大模型的回复有两种不同的“快”。一种是点下发送,很快就看到它开始输出。另一种是回复开始以后,文字生成得很快。首 Token 延迟(TTFT)衡量的是前一种,即从发出请求到收到第一个输出 Token 的时间。对需要反复追问、边看边判断的用户,这段等待尤其明显。 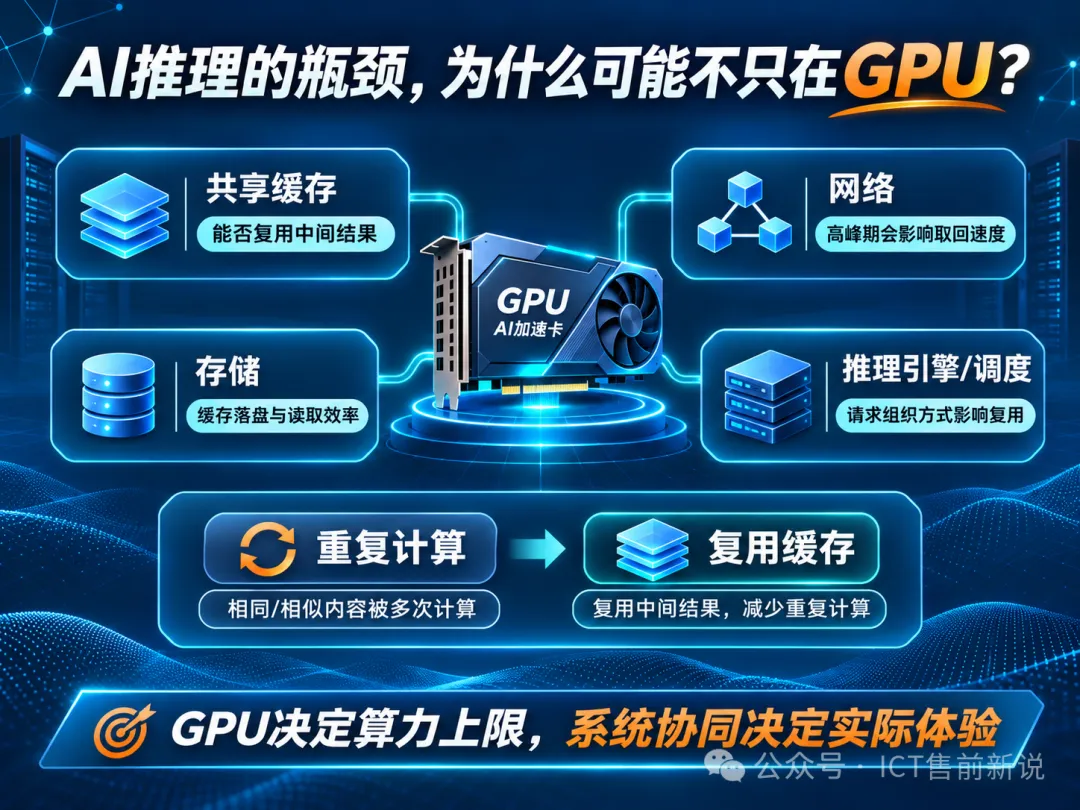
看 IBM 公布的原始测试。测试采用 gpt-oss-120b 模型和单块 NVIDIA RTX PRO 6000 Blackwell GPU。在约 13 万个输入 Token 的条件下,两种处理方式拉开了差距。
为单独测量共享存储的作用,测试关闭了推理框架中用于跨请求复用的显存和主机内存缓存层。因此,“56 倍”有一个明确的对照条件:面对同一段很长的输入,取回已有结果,比让 GPU 完整重算一遍,将首 Token 等待时间缩短至原来的约 1/56。这个数字衡量到第一个 Token 为止。一份几千字的分析报告能提前多久写完,还取决于后续文字的生成速度。 模型开始回答之前,要先处理系统指令、文档正文和对话历史。这个阶段称为预填充。在处理过程中,模型会形成一组供后续计算使用的中间结果,也就是KV 缓存(KV Cache)。可以把它理解为模型阅读材料时留下的“演算底稿”。底稿保留下来,下一次遇到相同的输入开头,模型就可以从已经算过的位置接着往下走。 还是那份招标文件。第一问关心哪些设备需要检测报告,第二问关心报告的提交时间。两个答案不同,前面要读的材料却高度重合。如果应用每次都把相同的审查规则和文件正文放在前面,再把本轮问题放在末尾,推理引擎就有机会复用前面那一大段计算,把 GPU 时间留给新问题。 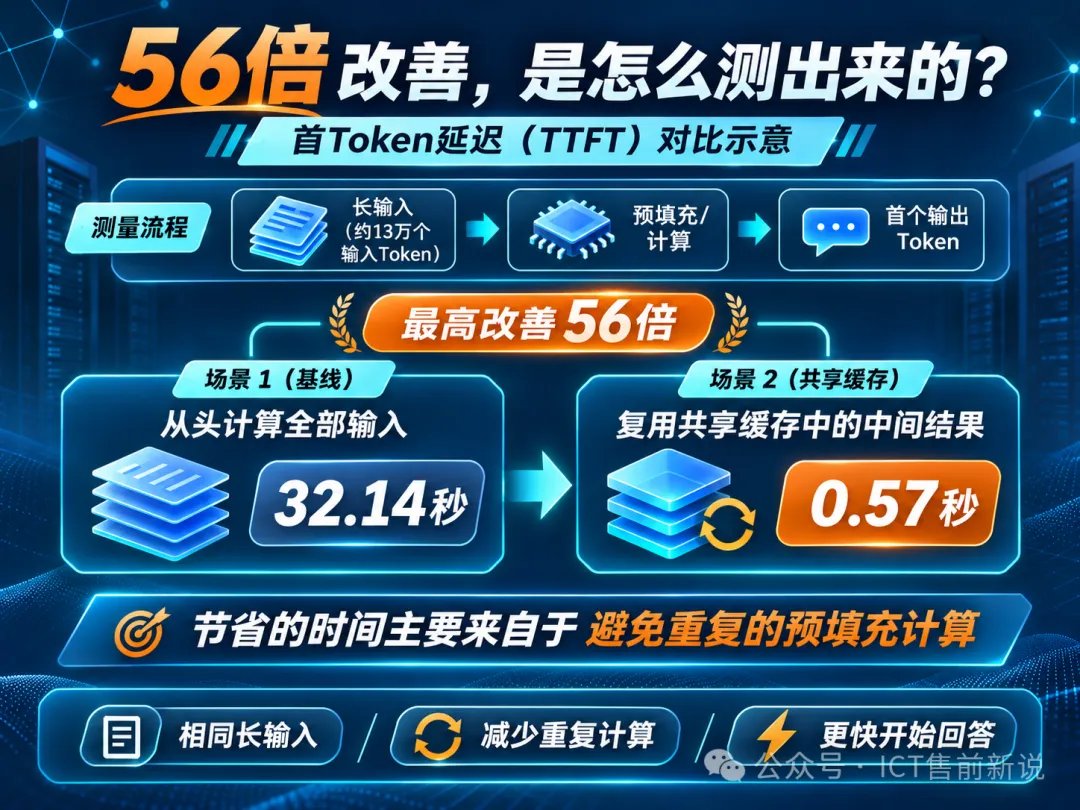
这里有一个容易被忽略的细节。假如应用把每次变化的请求编号放在文档正文之前,人眼看到的仍是同一份文件,按前缀匹配的引擎看到的却是两个开头不同的输入。一个无关紧要的编号,就可能让后面几万 Token 的正文失去复用机会。对文档助手而言,一项成本很低的排查,是看一眼模型实际收到的完整输入。在业务语义允许的前提下,把稳定材料放在前面,把变化的问题放在后面,有时改几行提示词模板,就值得重新测一次。 设想一个企业知识助手。上午,工程师围绕一份产品手册连续提问,相关缓存还在显存里,追问很快。午后,其他会话陆续占用显存。等工程师回来核对同一份手册,早先的计算结果可能已经被清理。共享缓存的价值就在这里:它给这些暂时离开显存、又可能再次用到的结果提供了一个保留位置。请求到来时,系统可以经网络把它们取回。 这笔账要看两个条件。第一,相同的长输入在业务中会重复出现多少次。第二,到了高峰期,把缓存读回来,还能比重新计算快多少。 如果用户每天上传的都是新文档,每份只问一次,平台应该先测首次处理长文档的能力。如果几十位工程师每天围绕同一套技术规范反复查询,就值得进一步统计可复用的输入有多长、两次访问通常相隔多久。前者关系到每次能省多少计算,后者关系到这些缓存值得保留多久。 网络也会改变结果。IBM 在另一组独立测试中,用 28 个并发连接处理 200 个请求。启用共享缓存后,系统每秒完成 4.26 个请求。随后,测试人员让其他客户端同时产生大量网络流量,吞吐降到每秒 3.60 个请求。这对企业项目有个直接启示:如果生产环境里的推理业务和其他业务共用网络,验收时就应该把两类流量同时跑起来。空闲时测出的半秒,很难独自回答高峰期的体验问题。 一张利用率接近满载的 GPU,可能在处理不断到来的新任务,也可能在反复计算已经读过的材料。两种情况在监控大屏上看起来相似,值得投入预算的地方却不同。 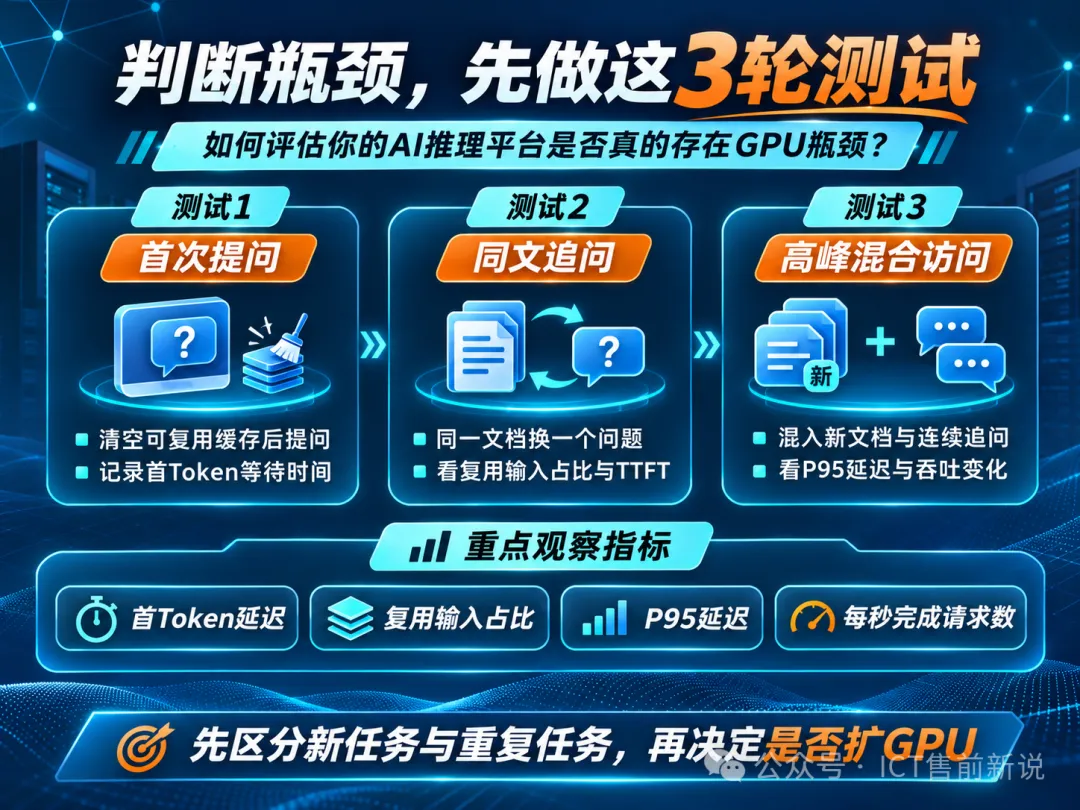
评估推理平台时,可以从业务部门拿一份真实材料,固定模型和输出长度要求,做三轮对照。
这张表里,尤其值得保留的是实际复用的输入 Token 占比。假设一份材料有两万个 Token,只匹配了开头几十个通用 Token,这个请求也可能被记作“缓存命中”。对项目负责人来说,“有多少次命中”远没有“整个平台少算了多少输入”更能说明投资价值。高峰测试也应把首次提问和同文追问分开统计,分别看 95% 的请求能在多久内开始返回,才能知道哪一类用户等得最久。 下次有人提出“推理太慢,再加几张 GPU”,不妨把这三轮结果带到评审会上,先问一句:用户等得最久的那几秒,GPU 在读第一次见到的新材料,还是在重读一份本可以保留下来的旧材料? 如果你也在做智算中心规划或推理平台选型,欢迎关注「ICT售前新说」,到文末知识星球交流真实业务中的压测方法,以及算力、网络和存储之间的预算取舍。
一、从 32 秒到半秒,省下的是哪段时间?
二、同一份材料,为什么换个问题还能沿用上次的计算?
三、什么时候值得给推理平台配共享缓存?
四、下一次讨论 GPU 扩容,先做三轮测试