ARTICLE · 1323347
AI与学术研究:这个4344星的开源工具给AI写的研究报告加了一道引文核查关卡
全文约 3451 字 · 阅读约 9 分钟
项目信号:★4344 stars、436 forks、16 人 watch、18 个未解决 issue,主要语言 Python,MIT 协议,创建于 2026-04-09,最近一次推送 2026-11-01,pyproject.toml 标注版本 0.13.0、开发状态 Alpha。项目主页 hyperresearch.ai 提供托管版。
关键词及解析:
- 深度研究(deep research)
:AI 代理自己拆解问题、成批检索和阅读网页与文献,再写成一份长报告的工作方式。 - 资料库(vault)
:每次读过的来源都存成本地 Markdown 笔记,配一个 SQLite 索引,下一次研究先查库再上网。 - 引文核查(cite-check)
:由一个专门的子代理抽查报告里的句子,看它所挂的来源是否真的支持这句话。 - 开放获取回收(OA recovery)
:遇到付费墙只拿到摘要时,去 Unpaywall、Europe PMC、CORE 找同一篇论文的合法免费全文。
它把一次研究拆成十六个步骤,每一步交给不同的子代理,写稿之后只许小范围修补,不许整篇重写。
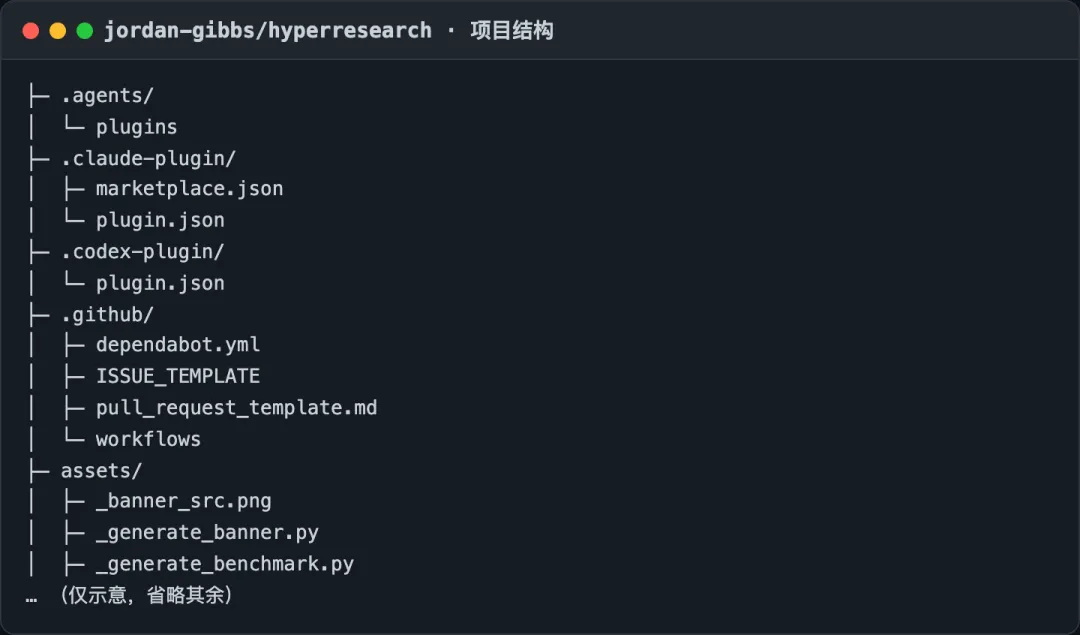
jordan-gibbs/hyperresearch 项目结构
结构图里最显眼的是三个配置目录。`.claude-plugin/` 和 `.codex-plugin/` 分别让它以插件形式装进 Claude Code 和 Codex,`.agents/` 放子代理与技能,真正的流水线代码在 Python 包里,用 `pip install hyperresearch` 装上。控制流是这样走的,入口技能先把你的原始问题一字不改存进 `query.md`,此后每一步、每个子代理都回头重读这份文件;第 1 步拆题,第 2 步派 8 到 12 个抓取代理并行检索,中间几步找来源之间的矛盾、分专题深挖、请批评代理追问哪条来源能推翻当前方向,第 10、11 步写三份草稿再合成一份。
写成之后的流程最值得研究者看。四个批评代理并行挑错,修补代理在 Claude Code 里被限定只能用读取和编辑两种工具,每处改动有字数上限,物理上写不出一份新稿。交付前还有一组校验,凡加引号的原文必须能在资料库某条笔记里逐字找到,引用了已撤稿文献而未说明的直接拦下,查不到出处的数字会被标出。这几道关卡针对的正是 AI 写综述最常见的毛病,编出一句原文、引一篇撤了稿的论文、给一个来路不明的数字。
文献检索单独做了一层。`hpr scholar search` 一次查 OpenAlex、Crossref、CORE、DOAB(开放获取学术书籍)、ClinicalTrials.gov、SEC EDGAR 和 FRED,按 DOI 和标题合并去重;README 说"八个来源",第八个 RePEc 因为官方接口不支持检索,只是列出来提示缺口。README 特意强调覆盖人文社科,DOAB 能找到书本身,在以专著为主要成果的学科里有用。
评中。安装两行命令,`pip install hyperresearch` 之后在项目目录里跑 `hyperresearch install`,再在 Claude Code 里输入 `/hyperresearch <问题>`。
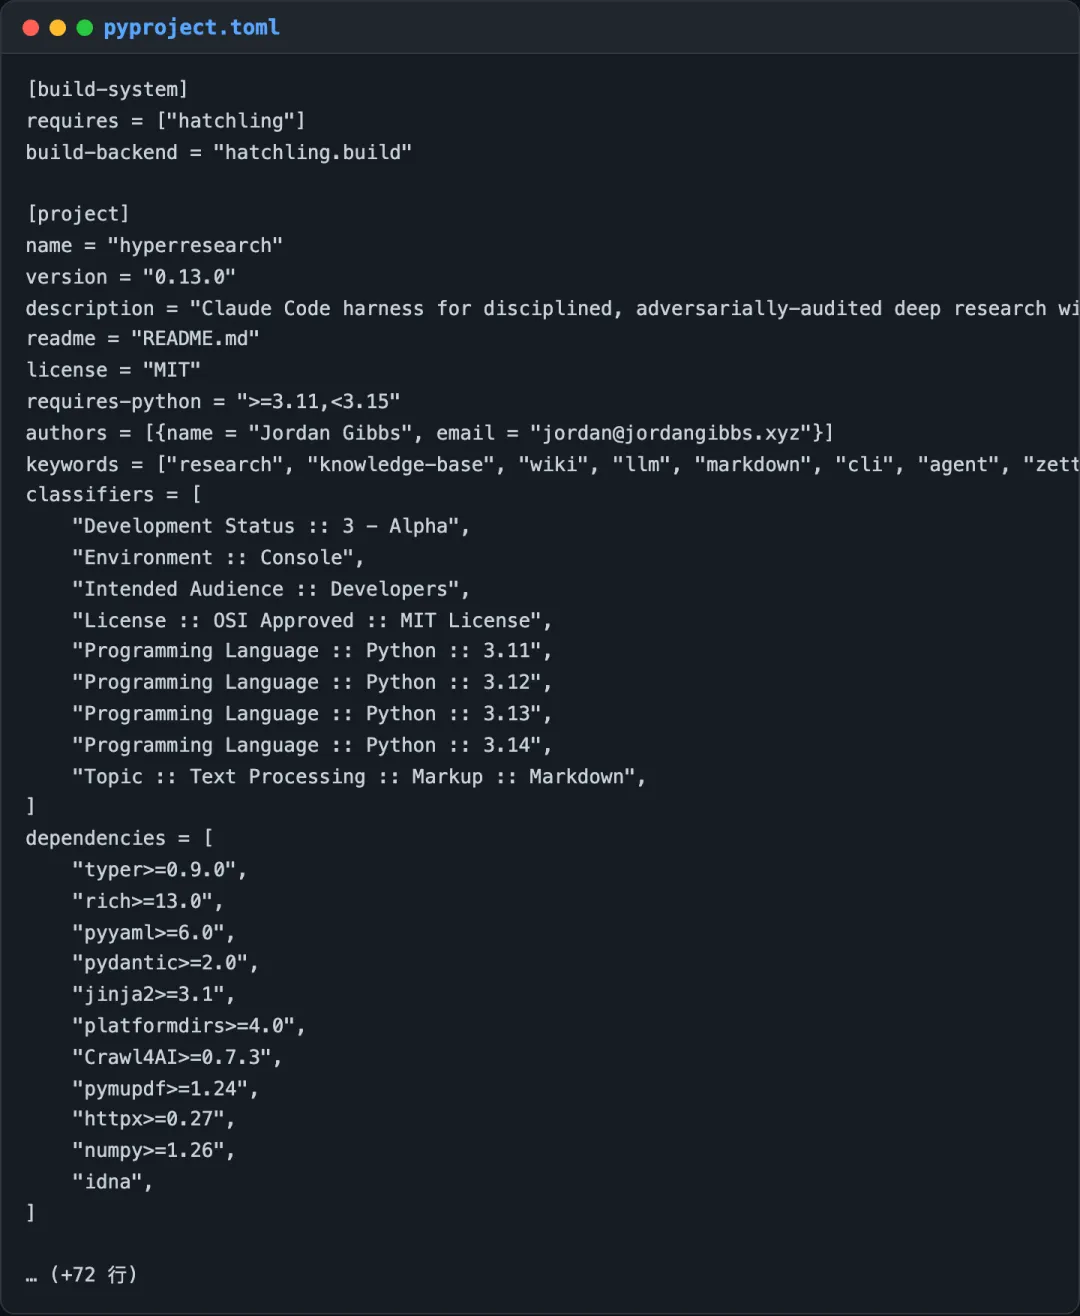
关键配置:pyproject.toml
配置文件写明需要 Python 3.11 到 3.14,依赖里有 Crawl4AI(无头浏览器抓取)和 pymupdf(解析 PDF)。门槛在后面几项设置上。开放获取回收要在 `.hyperresearch/config.toml` 里填一个真实邮箱,否则 Unpaywall 不会启用,只剩 Europe PMC 的生物医学子集;CORE 和 FRED 各要一个 API key。在 Codex 上跑还得手动开放写文件和联网权限,而且 README 承认那边的工具限制只是提示词里的要求,没有强制执行,基准分数也只测过 Claude Code 版本。Alpha 的开发状态,加上 README 承认博士论文模式的篇幅与引用目标尚未接通,说明这是一个仍在快速改动的项目。
费用上,代码按 MIT 协议免费开源,花钱的是模型调用。默认配置里写稿、批评、修补都用 Opus,抓取和核查用 Sonnet,README 说用量随档位和资料量增长,没有给出每次的价格;`run init --budget 50` 可以给一次运行设开销上限,超了就停。
它最能替你省的是检索、筛选和整理来源的时间,读懂文献、下判断的那部分仍要你自己来。
README 给的耗时是,简单的事实或对比类问题走五步快速通道约 30 到 40 分钟,默认的完整流程约 1.5 到 2.5 小时、读 55 到 80 个来源,加大档位 100 到 130 个来源、3 到 5 小时。据此估算,为一个新课题摸清文献版图,人工检索、去重、建笔记通常要两三个工作日,交给它跑一轮完整流程,再花半天到一天核对它挑出的关键来源,大致能省下一到两天。这个估算以课题的英文开放获取文献较多为前提。
项目在自家网站公布的 DRACO 基准上得 77.7 分,高于 Claude Research 的 73.0 和 ChatGPT 深度研究的 55.2。这组数字只有 10 道题,由项目自己发布,只能当参考。
有三件事不能放心交给它。第一,由模型判断来源是否支持句子的那一步是抽样核查,逐字比对只管加了引号的原文,转述有没有歪曲原意,仍要你回原文看。第二,付费墙后面的论文,没有开放获取版本就只剩摘要,笔记会注明这一点,你要看清哪些来源它其实只读了摘要;拿到预印本或作者接受稿的,引用原话前要对照正式出版版本。第三,README 自己写明 lint 关卡只查结构问题,不保证事实准确。检索源清单里没有任何中文数据库,研究我国问题、依赖中文文献的课题,它覆盖不到核心材料。
资料库存在你自己的硬盘上,可是你的问题和读到的内容都要经过云端模型和第三方检索服务。
本地部分比较干净。笔记是纯 Markdown,索引可以删掉重建,不装这个工具也能打开,语义检索默认关闭、不调用任何向量化接口。外发的部分有三条路。研究问题和抓回来的全文会发给 Anthropic 或 OpenAI 的模型;检索词会发给 OpenAlex、Crossref 等学术接口,换用 exa、tavily 等网页检索服务时也发给它们;用托管版 hyperresearch.ai 的话,整个过程都在对方服务器上,README 没有说明托管版的数据保留方式。
另有两处要留意。`hyperresearch setup` 会打开浏览器让你登录各个网站,遇到登录墙时它还可以借 Claude-in-Chrome 操作你已登录的 Chrome,这等于把你的账号会话交给代理使用,验证码和二次验证则一律交还给你处理。项目把抓回的网页内容包在"不可信来源"标签里,防止网页上的文字被当成指令执行,这一点做得认真。
用它查公开文献、梳理一个领域的已有研究,风险较低。未发表的数据、访谈记录、受访者身份信息不要写进研究问题,也不要放进它的资料库目录。 替期刊或基金审的稿件同样不要拿来跑。
它适合需要快速摸清一个英文文献领域、愿意花时间核对关键来源的研究者,尤其是做政策、经济、医学这类开放数据多的方向。依赖中文文献、处理敏感访谈材料,或者想让它直接代写综述的人,不该指望它。
来源:Hyperresearch,jordan-gibbs/hyperresearch,https://github.com/jordan-gibbs/hyperresearch,4344 stars,MIT。