ARTICLE · 1332855
AI读PDF用哪个?5款工具对比,长文档不卡
一份 200 页的行业报告,明天上午要提三个结论。
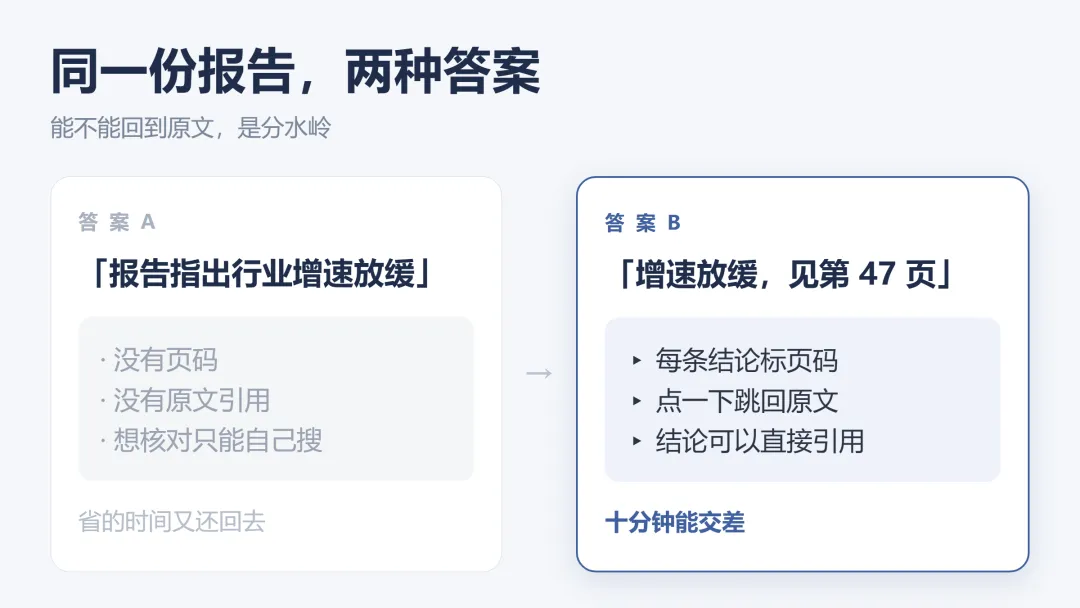
你把它拖进对话框,问「这份报告讲了什么」。回答很快,四平八稳,但你想核对其中一句时,找不到它在第几页。
于是又翻回 PDF 手动搜索。省下的时间,全还回去了。
这就是读 PDF 这件事的核心矛盾:能不能定位到原文,比能不能总结更重要。
总结错了你未必看得出来,定位不到你就没法验证。而五个工具的差别,主要就差在这里。
五款工具逐项对比
价格与额度来源为各产品官方页面与官方帮助文档,信息截至 2026-10;各家活动与定价调整频繁,下单前以官网为准。
表格只是初筛。真正的差别在下面三个地方。
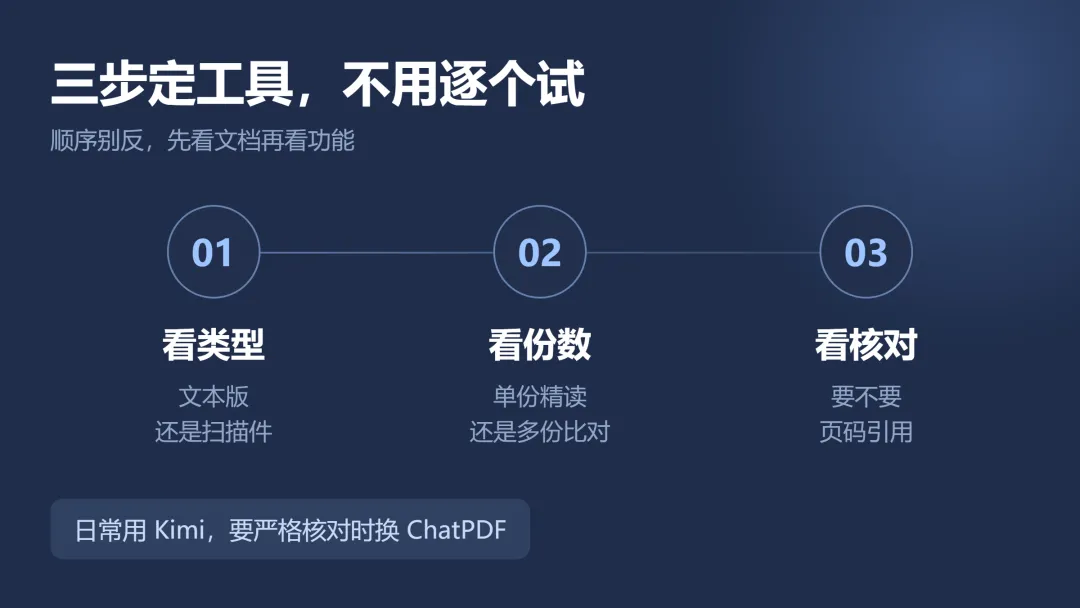
差别一:能不能回到原文
这是最重要的一条,也是最多人忽略的一条。
ChatPDF 在这一项上做得最直接:每条回答后面标页码,点一下能跳回原文位置。代价是免费版限制很硬——据其官方页面,免费每天 2 份、单份 120 页、单文件 10 MB,付费版才解锁到 2000 页。
Kimi 的长文本能力是它的招牌,中文长报告丢进去能给出结构化的梳理。但它给的是概括,不是逐条带页码的引用。要核对,还得自己搜关键词。
通义千问 的文档模式标称上下文极长(官方口径为千万级 token),理论上能一次吞下一本厚书。据公开反馈,文档超过三五百页后,中间章节的召回质量会下降。数字好看,可用区间要打折。
Claude 的上下文约 200K token,折算一百多页,不算最长,但它对条款之间隐含逻辑的把握更稳。审合同、看协议这类「漏一条就出事」的场景,它更合适。
NotebookLM 走的是另一条路:不是读一份,是读一堆。免费版可放 50 个来源、合计约 50 万字,能在多份材料之间做交叉比对。
差别二:扫描件能不能读
这一条决定工具在你的场景里能不能用。
纸质文件扫描出来的 PDF,本质是图片,没有文字层。多数通用模型会直接告诉你「无法读取」,或者更糟——根据标题编一段。
ChatPDF 对纯图片型 PDF 的识别能力偏弱,官方支持列表里也没有强调 OCR。Claude 和通义千问对图片型 PDF 的支持更好一些,但同样取决于扫描清晰度。
判断方法很简单:打开 PDF,试着用鼠标选中一段文字。选不中,就是图片型,先过一遍 OCR 再交给 AI,比反复重试省时间。
还有一类文档容易被误判:双栏排版的论文和表格密集的财报。文字层是有的,但按栏切分错了,模型读到的句子会前后串行,答案看着通顺,数字对不上。这类文档建议先转成单栏 Word 再上传,或者只截取相关页单独提问。
差别三:一份还是多份
单份文档问答,和几十份材料交叉比对,是两种完全不同的任务。
看一份合同、一份财报 → 单文档工具就够,重点是页码定位 比对五家公司的年报、十篇论文 → 需要多文档能力,NotebookLM 这类工具更合适 一批文件反复查 → 更适合自建知识库,而不是每次重新上传
多数人一开始就选错:拿单文档工具去做多文档比对,然后抱怨「它记不住上一份」。
同一份文档,四种问法
工具选对之后,问法决定答案质量。下面四条可以直接复制,按顺序用效果最好。
这份文档的结论是什么?只列 3 条,每条后面标出对应的原文页码。找不到页码的不要写。
第一句就要求它标页码,能过滤掉大部分凭印象编出来的内容。
第 3 章提到的三个风险,分别在原文哪一段?逐条引用原句,不要改写。
要原句,不要转述。转述一次,术语就可能被换掉。
作者的结论建立在哪些前提假设上?如果这些假设不成立,结论会怎么变?
这一条用来判断这份报告能不能直接引用。很多结论只在特定口径下成立。
用 200 字复述这份文档,再列出我需要亲自读的 3 个部分。
最后这条最实用。它替你筛掉八成内容,剩下的两成才是你要花时间的。
上传之前,先做两件事
第一件是脱敏。合同、财报、内部制度里常有客户名、金额、身份证号。多数工具的默认设置是把文件传到云端处理,上传前删掉或替换敏感字段,比事后担心有用。
第二件是拆章。三百页的报告整份丢进去,模型的注意力会被摊薄。按章节拆成三到五份分别提问,答案的具体程度通常更高,也更容易定位。
按场景直接选
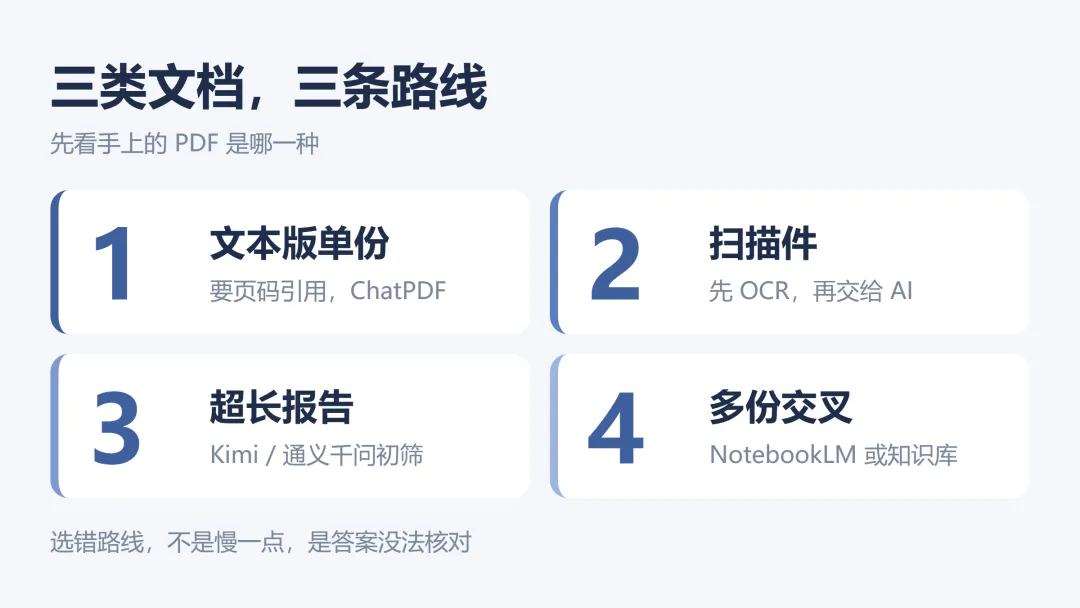
省掉纠结,按这三种情况对号入座:
- 一份报告,要提结论并核对
→ ChatPDF 或 Claude,优先看有没有页码引用 - 中文长文档,先摸清结构
→ Kimi 或通义千问,免费额度够用 - 十几份材料互相比对
→ NotebookLM,或自建知识库
如果只选一个:日常用 Kimi,需要严格核对时换 ChatPDF。
更省事的组合是两个一起用:先用免费的长文本工具摸清结构,挑出需要引用的那几页,再交给带页码能力的工具做精读。两步都不花钱,准确率比单用一个高。
三个必须自己核的事
- 页数上限
宣传的「超长上下文」和「实际可用页数」经常不是一个数,超过三五百页要留余量 - 扫描件
官方页面很少写清 OCR 能力,用自己手上的扫描件试一次最准 - 价格
ChatPDF 这类海外工具的订阅价在不同渠道差异较大,以官网结算页为准
读 PDF 的核心不是让它替你读,是让它告诉你这句话在第几页。
本周七篇到这里结束。下周开始新的 SOP 系列,第一篇是把「写项目方案」拆成六步,每步给提示词和验收标准。
觉得有用?点个关注,持续获取优质内容。