ARTICLE · 1342927
拆开 REA:两份源码,为什么得到同一份伪代码?
Ghidra 反编译出一个运费函数。最关键的几行是这样的,param_1 就是地区编号。
if (param_1 < 8) { uVar1 = *(undefined4 *)( &DAT_180002000 + (ulonglong)param_1 * 4); } 它先判断编号是否小于 8,然后从一处按编号计算的地址读出费用。
如果只看这段伪代码,你会猜原作者写了一个数组,还是八个 match 分支?
我们各写了一份 Rust 源码,用相同设置分别编译。两份 DLL 都是 2,048 字节,逐字节比较完全一致。
把两份 DLL 分别交给 REA。REA 调用本机的 Ghidra 分析,再把伪代码、汇编和引用关系放进同一条证据。两次分析得到的伪代码和证据编号都一样。
只拿到这份 DLL,已经分不出作者用了哪种写法。不过,顺着这条证据,我们还能找回每一档的运费。先看编译器给两个版本留下了什么。
01 两份源码什么时候变成了同一回事?
这个自制运费函数接收一个无符号的 32 位地区编号。0 到 7 各有一档费用,其他编号返回 9999。第一份源码把八个编号分别写成八个 match 分支。第二份把同样的八个数写进一个数组,先检查编号,再拿编号当下标。
这两份写法之间有个很适合编译器处理的条件。八个分支对应连续的编号,每个分支做的事只是返回一个常量。只要按编号把常量排成一张表,先检查范围,再取表中的那一项,就能算出同样的结果。
怎么确定这张表是编译器加的?我们保留了 match 版优化后的 LLVM IR。它是编译器生成机器码之前使用的一种中间表示。原本的八个分支已经变成一张名为 switch.table 的八项常量表。执行路径只剩下无符号比较和两个去向。编号小于 8 的路径按下标取一个 32 位整数,另一条路径直接用 9999。两路在返回前汇合。
所以,看到伪代码像在查表,第一件事是弄清这张表在哪一步出现。 本例的答案可以从编译产物里查到。REA 打开 DLL 之前,表就已经在里面了。两份 DLL 的一致性来自这组固定构建条件,使用 rustc 1.89.0、优化级别 2、Windows x64 目标,并保留相同的函数导出名。
02 七条汇编里,哪一步决定读不读表?
Ghidra 导入 DLL 后,会按目标架构把机器码解释成汇编。下面是这个函数的七条指令,地址简写成末三位。
000 MOV EAX, 0x270f 005 CMP ECX, 7 008 JA 016 00a MOV EAX, ECX 00c LEA RCX, [0x180002000] 013 MOV EAX, [RCX + RAX*4] 016 RET ECX 里是传进来的编号,EAX 是这个函数交回整数结果的寄存器。第一条指令先把 EAX 设成 9999,也就是 0x270f。接着比较编号和 7。拿输入 8 走一遍,JA 按无符号比较跳到 RET,一路上没人再改 EAX,所以返回 9999。
输入 3 时,跳转不发生。程序先把编号复制过去当下标,再用 LEA 得到表基址。这里有一个容易看反的细节。LEA 算出地址,下一条 MOV 才从内存读数。 那条 MOV 以表基址加上编号乘 4 得到地址,从那里读四个字节,并覆盖原来的 9999。
你也可以回到原始文件核对分支。这个 DLL 的 .text 节从文件偏移 0x400 开始,JA 的两个字节在 0x408,是 77 0c。目标地址从下一条指令算起,再向后跳 0x0c 字节,正好落在 RET 上。这样即使先放下伪代码,也能确认越界路径确实跳过了读表。
03 Ghidra 怎样从两条路写出一个 if?
仅仅把机器码写成汇编,还回答不了一个问题。到了最后的 RET,EAX 里的数是哪一条指令留下的?在代码里找离它最近的一次赋值会找到读表,但输入 8 根本没执行过那条指令。要回答这个问题,必须把控制流走哪条路和这条路上值从哪里来一起看。
按 Ghidra 的 SLEIGH 文档,处理器的指令规则可以把机器指令翻译成 p-code。它用更统一的操作描述寄存器和内存怎样变化。反编译器可以在此基础上分析分支,并沿着值的定义查找它后来在哪里被使用。这里展示的高层 p-code,是经过分析和变换后的结果。
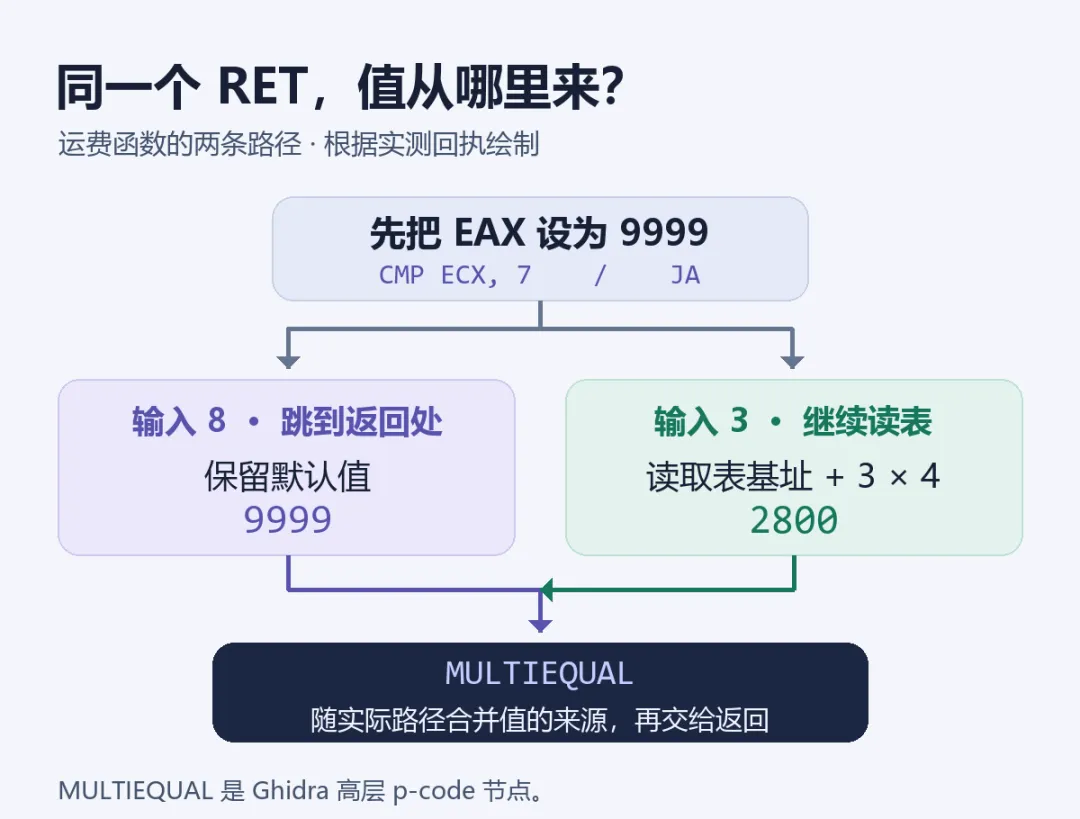
顺着回执里的值流往回找,返回值来自两处。
一条指向函数开头的 COPY,值是 9999。一条指向读表位置的 LOAD,值来自内存。
这两条边指向同一个 MULTIEQUAL 节点,节点的结果随后传给返回操作。它记录的是「从哪条路进来,就沿用那条路提供的值」。输入 8 只保留默认值,输入 3 才取表值。CPU 并没有在 RET 前执行一条叫 MULTIEQUAL 的指令。这个节点由 Ghidra 在构建数据流时引入,用来把同一个返回位置的两种来路写清楚。
有意思的是,回看编译时保留的 LLVM IR,也能找到一次相似的汇合。编译器用 phi 节点表示「默认值或读表值」。两端看到的材料不同。编译器手里有源码,Ghidra 手里是 DLL。Ghidra 从分支和寄存器的变化重新推导出值怎样汇合,这次分析没有把那份 LLVM IR 交给它。
最后,Ghidra 用 C 风格的 if 表达这段行为。汇编写「大于 7 就跳走」,伪代码写「小于 8 就执行读表」。对这个无符号输入,两种表达覆盖同一组路径。伪代码里的 param_1 和 uVar1 也足够说明问题。它们是分析器生成的名字,用来讲清参数、临时值和返回值之间的关系。
04 为什么拿到伪代码,还要翻 REA 的回执?
回到一个具体问题。编号 3 到底多少钱? 首屏的伪代码给了地址和算法,费用数字仍在 DLL 里。
在这次分析中,Ghidra 桥接程序返回函数结果和限制。REA 先解开这层结构,检查返回值是否符合该操作的格式,再把桥接原始响应和整理后的函数结果一并保存在 Evidence 中。要回查 Ghidra 原先给了什么,可以看原始响应。要顺着结果定位那笔费用,可以直接查汇编、引用和值流。
- 用汇编和值流判断会不会读。
这份回执里, LEA和那条读表的MOV都留下了指向表基址的DATA引用。它告诉你地址在哪,单凭这个标签无法区分「算地址」和「从那里取值」。要确认读取,看那条MOV对应的LOAD,再看控制流何时会经过它。 - 用数据引用和 PE 节表定位字节。
表基址 0x180002000减去映像基址0x180000000,得到相对地址0x2000。在 PE 节表里,这正好是.rdata的起点,对应文件偏移0x600。每项占四字节,编号 3 再向后数3 × 4字节,到0x60c读出f0 0a 00 00。按小端整数解码就是 2800。 - 核对分析对象、配置和证据内容。
回执记录了 DLL 的 SHA-256、Ghidra 版本和分析配置。实验中两份文件放在不同路径,两次调用却得到相同的 Evidence ID,因为这个编号根据记录中的分析内容计算。它可以核对纳入计算的内容是否一致,无法区分两次调用。要验证费用有没有读对,还得回到分支和文件字节。
我们又独立运行了自己编译的两份 DLL。输入 0 到 7 时,两版都返回预期的表值。输入 8 和无符号 32 位整数的最大值时,两版都返回 9999。静态解释说清了这两个边界为什么都跳过读表,执行结果核对了这十个输入。
05 如果从 Codex 开始,哪一步才用到模型?
这次对照直接用 REA CLI 指定导出的运费函数。Ghidra 生成伪代码的过程没有经过对话模型。换成在 Codex 里问「编号 3 为什么收 2800」,Codex 可以先选择函数分析,再根据 REA 返回的证据,决定追哪条数据引用、核对哪四个字节。模型参与的是把问题拆成查询,以及根据查到的材料作解释。
判断一个回答够不够扎实,可以问三个问题。哪个条件选了这条路径?值是从哪条指令或哪个文件位置来的?什么输入能对照验证? 本例里,输入 3 要给出 0x60c 处的四个字节,输入 8 要解释为什么压根不走到那次读表。如果回答只复述了那段 if,追问到这里才算真正打开了黑盒。
至于作者原来写的是八个分支还是一张表,单靠这份 DLL 无法判断。两种写法留下的是同一组字节。