ARTICLE · 1343038
装插件越多Agent越笨?谁吃掉了上下文
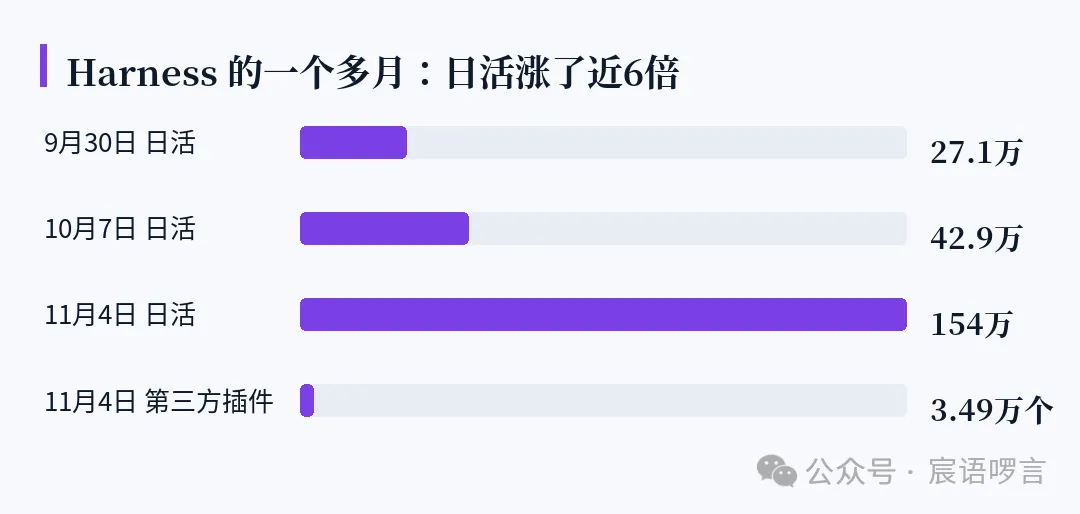
先把这两件事摆在一起看。官方口径是:截至11月4日,Harness日活154万、月活548万,比9月29日桌面端刚上线时增长545%;单日消耗Token约92万亿,人均每天请求261次;第三方插件约3.49万个,其中GitHub渠道2.94万个、npm渠道1.85万个。产品8月13日以MIT协议开源,9月29日出桌面端,日活从9月底的27.1万涨到11月初的154万,一个多月翻了近六倍。
另一边,用户的反馈是另一副样子。据技术社区整理的用户反馈,装了较多插件之后,常见问题有三类:上下文溢出,也就是聊到一半提示装不下了;重复调用同一个工具,明明刚查过还要再查一遍;Token消耗上升、执行时间变长。这些是个体反馈,不是对平台整体性能的测量,但它指向同一个问题——工具越多,AI越容易“忙不过来”。
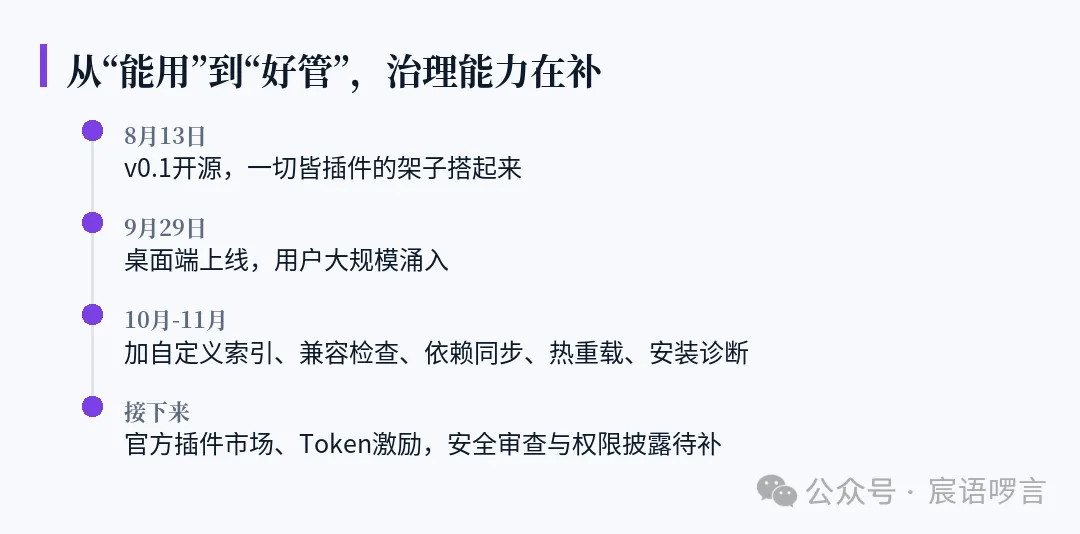
官方的姿态其实已经承认了这件事。近期版本陆续加上自定义索引、兼容性检查、依赖同步、热重载、更新恢复、安装诊断这些能力,还有上下文压缩、缓存复用、开发者统计。这些名字听起来枯燥,翻成大白话就是:给插件排座位、贴上标签、能随时抽走,同时告诉你哪里最费钱。
把两边的说法放在一起,其实不矛盾。平台在报增长,用户在报体感,而体感往往比数字更早暴露设计上的欠账。日活从27.1万涨到154万只用了一个多月,插件从零到3.49万个也只用了一个多月,但让这些插件彼此不打架、装上去也不添乱的经验,显然还没跟上同样的速度。
要理解为什么会变笨,得先知道大模型是怎么干活的。它每次开干之前,手里只有一块固定大小的“工作台”,也就是上下文窗口。你能放进台面的东西就这么多:你的需求、它查到的资料、它调工具的记录、以及所有工具的说明书。台面满了,前面的东西就得挪走;挪走的内容,它当场就“想不起来”了。
插件是往台面上加东西的。每装一个插件,就要多放一份说明书:它是干什么的、什么时候该用、参数怎么填、需要什么权限、依赖哪些服务。插件越多,说明书越厚。而模型每次回答之前,都得先把这摞说明书翻一遍,判断该用哪一件。
举个生活里的例子。你家工具箱里有锤子、螺丝刀、卷尺的时候,找东西很快;等到塞进两百件工具,每样还配一张用法卡片,你想钉个钉子,得先把两百张卡片过一遍。手还是那双手,活却干得越来越慢。AI的情况一样:模型的推理能力没变,是它花在“认工具”上的力气变多了,留给“解问题”的力气就少了。
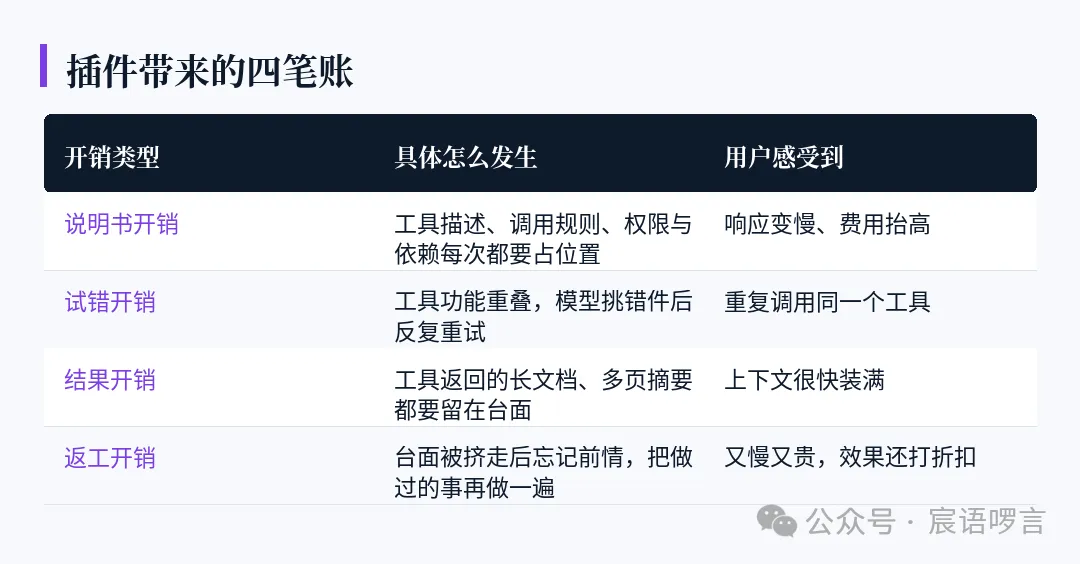
先说说明书的固定开销。工具描述、调用规则、权限声明、依赖关系,这些东西不管你用不用,每次都要占位置。有插件作者会写得很详细,方便模型理解,但详细本身就是成本。
再算试错的账。台上工具一多,功能又有重叠,模型很容易挑错件。用户看到的“重复调用”,往往是它在两个相似工具之间反复试探:调一个发现不对,换一个,还不对,再换回来。每一次试探都是一次完整的请求,都要花Token。
然后是回传的结果。工具跑完要交作业,作业也放在台面上。查一份长文档返回几千字,翻一遍搜索结果返回十几条摘要,这些都占地方。一次任务里连调十几次工具,光作业纸就能把台面占满。
最后一笔是返工。台面挤满之后,模型开始忘前面说过的话,于是把已经做过的事再做一遍。这不只是慢,还是双倍的钱。所以有用户发现,装完一堆插件后账单涨得比功能涨得快。
老实说,挤占上下文的不只是插件。长对话、粘贴进来的大段资料、连着调的多个工具,都在抢位置。模型本身的老毛病也一个没少:上下文一满就开始胡说,工具参数填错,多步任务跑到第三步忘了第一步要干什么。
但插件有个不一样的地方:它是可以提前收拾的。对话长短你控制不了,工具返回多少字你也管不住,唯独装哪些插件、开几个、要不要常开,主动权在你手里。这也是为什么官方治理的重点落在插件层——这层的改动见效最快。
排座位,指的是按需出场。不是所有插件都要一直站在台上,能不能让不常用的先回后台、需要时再叫上来,这直接决定台面的剩余空间。选择性披露工具、按需加载,是社区里被提得最多的解法。
说短话,指的是把说明书和作业纸都写薄。工具描述能不能更精简,返回结果能不能先摘要再交,长任务能不能做上下文压缩和缓存复用,这些在近期版本里都能看到影子。官方也加了开发者统计,让作者看得到自己的插件到底花了多少Token。
留后路,指的是能撤回。插件装上去往往不是随手一挂,而是和模型路由、MCP服务、本地依赖、Agent预设绑在一起,动一个可能牵一串。社区反馈里,升级导致配置丢失、版本不兼容、恢复困难的例子并不少见。所以自动备份、版本兼容检查、一键回滚这些“不性感”的功能,实际决定用户敢不敢长期用下去。
用户抱怨的“变笨”,有相当一部分不是平台的问题,而是插件写法的差异。同样一个功能,写得好的和写得糙的,对台面的占用可能差好几倍。
写得糙的典型长这样:说明书恨不得把产品手册全搬进去,功能写得又大又全,什么场景都说自己能干;返回结果不做裁剪,用户要一句话,它给三页纸;参数设计得含糊,模型只能靠猜。这样的插件单看没问题,装十个就出事。
写得好的相反:描述只讲“什么时候该叫我”,不铺产品卖点;返回先给结论、细节按需再查;功能切得细,一个插件只干一类事。社区里有一种说法是,日活154万意味着细分需求极其密集,专做单一垂直场景的插件,反而比大而全的更容易被正确调用,也更容易被留下来。
这一点对做插件的人也意味着机会。官方扶持计划已经明确会往Token激励、技术交流和流量推荐这几个方向走,而评价一个插件该拿多少资源,最合理的标准恐怕不是下载量,而是它在一个真实任务里到底省了多少步、花了多少Token。把一个垂直场景做透,比塞进五十个功能去撞运气更划算。
Harness已经明确要搭官方插件市场,简化上传、检索、使用流程,同时健全插件安全防护机制;面向插件作者的扶持计划也在筹备,方式是Token激励、技术交流、作品流量推荐。方向没错,但这一步有个绕不开的副作用:供给了,质量不一定跟上。
插件生态最容易出的两个问题,一是刷量,二是僵尸。刷量的动机很直接:如果激励只看调用次数,作者就有动力把插件做大做全、到处撒描述,让它被更多任务误撞上。僵尸则相反,上线时热闹一阵,没人维护,装的人还在用,出问题却找不到人。
对用户来说,这两件事的直接后果都是同一件:台面被自己不用的说明书占着。所以市场能不能被信任,不看插件总数,而看这几件事什么时候到位——评分、安全审查、权限披露、版本兼容标注、自动备份和回滚。缺了这些,用户在市场上逛的每一步都是在赌。
第一,从一件事开始。别一上来就把市场搬回家,先让Agent把一件固定的小事做顺,比如每天早上出一份行业简报。跑通了再加第二件,你会很清楚是哪一步让它变慢的。
第二,常关不常开。功能相近的插件留一个,其余关掉;不常用的设成按需调用。判断标准很简单:过去一周真正用过的,才是该留下来的。
第三,先备份再升级。把模型路由、MCP服务、本地依赖、Agent预设这些配置整理一份存好,升级前留个底。Harness目前仍是开发者预览版,官方也提示核心插件和API还在调整,后续更新可能不兼容旧版。
第四,把重要的活分开跑。吃饭的活别全押在一个装了两百个插件的环境里,单独留一个干净的、只装必要工具的环境,重要任务用它。
· DeepSeek Harness 日活突破 154 万,将建立官方插件市场(环球网)
· DeepSeek Harness Reaches 1.54 Million Daily Users as Plugin Governance Becomes Critical(CCTest(综合 InfoQ 中文))
· DeepSeek Harness日活154万:Agent生态开始拼插件了(CSDN DevPress)
· 解析 DeepSeek Harness:154万日活下,Token激励重塑Agent生态(腾讯新闻(搜索快报))