ARTICLE · 1353394
论衡:AI写作插件推荐
📦 6 Parts
👉 滑动
PART 01
九个岗位,二十六道关
PART 02
机器只能查「数得清」的东西
PART 03
改到第几版,才算改好
PART 04
它不便宜,也不万能
PART 05
把挑错变成习惯
PART 06
资料与说明
三分钟写完五千字,这件事已经不稀奇了。稀奇的是接下来那一步:这五千字里,有哪一句你敢替它担保?
写作的门槛从来不在打字速度,而在每一句话都能被追问。一个结论背后有没有一份查得到的文件,一个数字换个人复算还是不是那个数,一个判断在最强的反例面前还站不站得住——这些事,写的时候没人催,写完了也没人查。生成越便宜,需要被证明的句子就越多。
有一套公开的写作系统叫论衡(19.27.15 版 [D01]),就是从这道缝里长出来的。它不解决「写不出来」,只解决「谁来证明每一句站得住」。
01
PART
九个岗位,二十六道关
它把一篇文章拆成九个互不替代的岗位,另设一个总调度 [D02]。管检索的不写,管写的不给自己打分,管复核的不参与写作,谁想抄近路,都得先说服别人。落到检查上,26 道里有 25 道由程序跑,剩下一道只能由人做 [D03]。随包还带着 37 个脚本与 13 个命令 [D08]:这不是一份提示词,是一套能跑起来的检查工具。
从定题到交付,整个流程被切成六步,中间嵌着四道要人参与的关口 [D09]:默认只有两道会停下来等答复,另外两道只发通知,主人可随时介入。
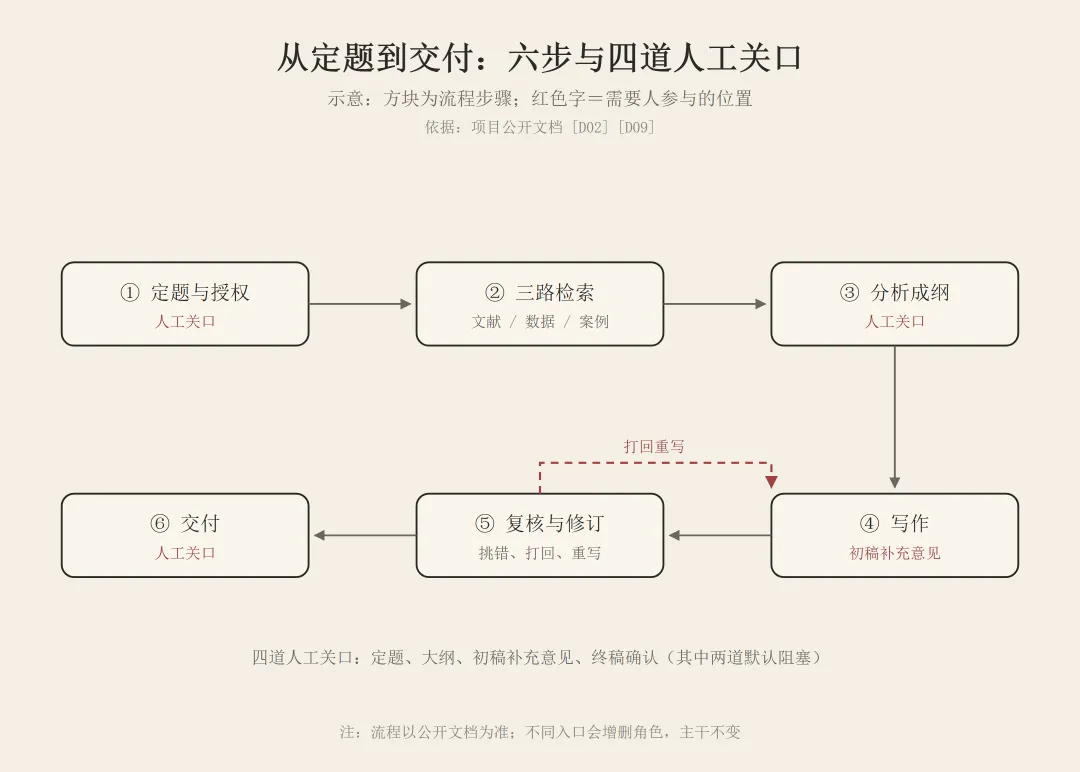
图 1|从定题到交付——六步与四道人为关口
这个设计基于一个不太讨喜的判断:写作者的自我检查不可靠。这不是道德问题,是结构问题。同一个模型先写再评,评的时候用的还是那副有盲区的眼光——[L03] 的实验说明自我批判确实能涨分,但涨到某个位置就封顶了。要让检查真正起作用,写和挑错就不能坐在同一个位子上。
多角色协作本身不算新东西,AutoGen 一类的工作早把「多个可对话的角色分工」做成了成熟路线 [L01]。差别在目标:多数系统用分工换速度,这套系统用分工换制衡,让每一个判断都有一个没参与它的岗位来质疑。同类工具各有各的着力点,STORM 把力气花在写前的多视角提问与提纲 [先01],GPT Researcher 把研究压到分钟级 [先02],LongWriter 想解决的是「写得不够长」[先03]。它选的是另一条路:写完之后怎么挑错。
检查项的分布也说明了这一点:11 项管格式,12 项管该有的东西在不在,2 项管一致性与事实,1 项留给人的判断 [D03]。格式项听上去琐碎,可长文的塌方常常就是从编号错位、占位符没删开始的。
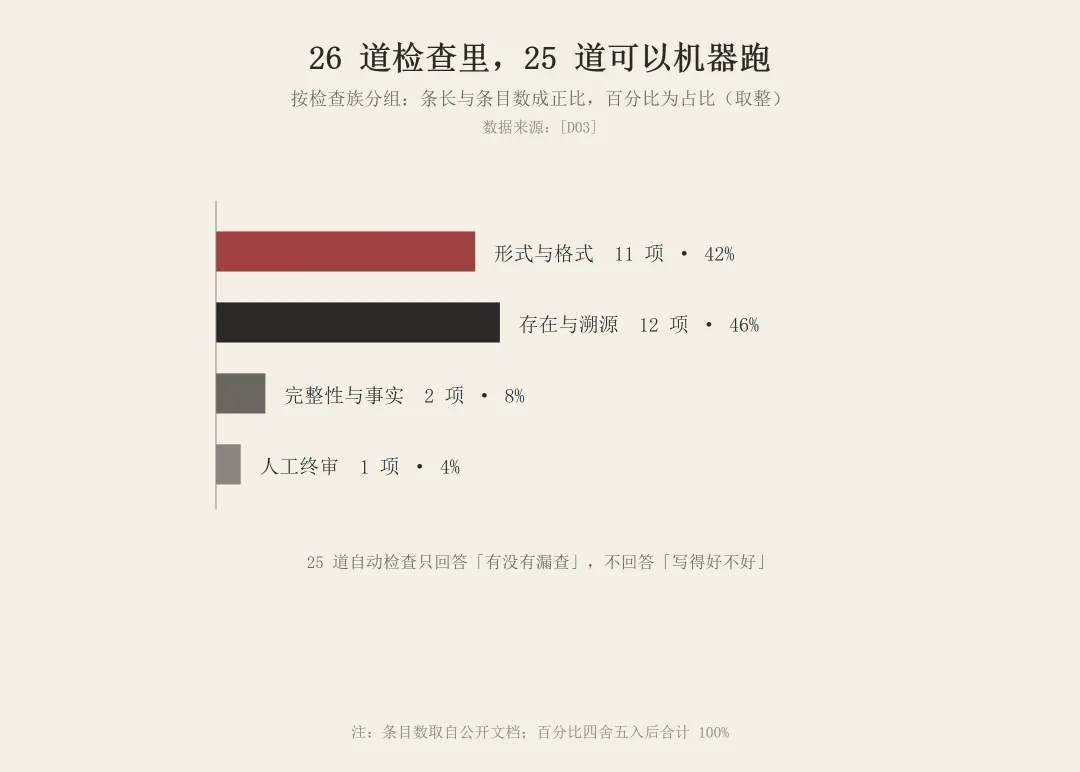
图 2|26 道检查的构成
当然,把一件事拆成九次调用,成本翻了几倍,准确率未必跟着涨——多智能体系统的实测增益常常小于宣传 [L02]。这话成立,所以它从不承诺「岗位越多越准」,只是把「谁负责证明」从个人自觉,改成结构里的一格。
02
PART
机器只能查「数得清」的东西
程序跑的那 25 道 [D03],查的都是数得清的东西:编号有没有对上、占位符删干净没有、字数超没超、图表缺没缺、前后两处说法一不一致。这类错误不需要理解力,只需要比对。程序能确认「这句话后面跟着一个编号」,不能确认「这个编号指向的材料真的支持这句话」。
越过这条线,机器就迅速失灵。项目公开过一个读数:约 45% 的检查项并不像预期那样能由程序定论,仍需人工修正 [D05]。这个数字是按当时的 22 项检查统计的,样本只有一次,项目把它和限定条件一起写进了文档 [D05]。
它抓不住的东西长什么样?有一篇稿子里出现过「2020 年,2500 万」这样的句子 [C03],数字记得很稳,来源却是空的。复核时才发现,它把 2019 年的 22 万欧元和 2024 年的另一件事搅在了一起 [C03]。这种错误程序查不出,因为每一个字都长得对;它缺的不是格式,是出处。
文献给出的解释很一致。同一模型自评,改进幅度被自身盲区封顶 [L03];把验证拆成独立的提问、让答案隔离生成,才比笼统自查有效 [L04];用强模型当裁判,与人类偏好的一致率能到八成以上,但位置、冗长、自我增强三类偏差是结构性的,只能压不能消 [L05]。多智能体系统的失效分析里,「验证不足」被单独列为一类失败,和模型能力并列 [L02]。
反方也在这里。这套检查是作者自己出题、自己判卷;45% 要人来改 [D05],恰恰说明机器判不准。把人的经验固化成流程,不会让它更可靠,只会更慢。
这个反驳是对的,但它打的是「自动过关等于可以发布」这个假设,而这套系统从没这么宣称。检查不产出质量分,只把「可能忘了查」变成「必须回答」,把数得清的错误自动清掉,把数不清的交给反方论证和人工复核。
最难的一关它也承认:标准、清单、复核流程都是作者自己写的,能不能被自己的门拦住,取决于作者肯不肯把门调到会拦自己的位置。一个自己出题的系统,能给出的最不利证据是「我的定稿在盲评里低于第一版」,而它把这条也写进了文档 [D06]。
03
PART
改到第几版,才算改好
改稿的默认假设是多改几轮总会更好。公开记录里有一个反例:某篇学术稿的定稿,在一对独立盲评判者手里低于它的第一版——22 分对 16 分,19 分对 18 分,两个判者的方向一致 [D06][C01]。改稿通常被当成质量上升的过程,这个读数说明两件事之间没有必然关系。
它自己写明了这份读数的噪声有多大:同一篇稿子换判者,分差平均 1.5 分、最大 3 分;改稿带来的位移在 +0.5 到 −3.5 分之间 [C01]。改稿的位移落在换人的波动里,谁也分不清是稿子变了还是判者变了。样本只有两名判者、跨体例的六份稿样,这份读数只能当方向,不能当刻度;这条残余风险项目自己也承认。
于是判据换了:不问改到第几版,问这一轮提出的缺陷关掉了多少。每一条被打回来的问题编上号,要么改掉,要么写清不改的理由;两样都没有,就还在原地。轮次是过程记录,关闭率是结果记录,两者对不上时以结果为准。关闭率不告诉你稿子有多好,只告诉你哪些问题有了结论,而它可以被另一个人重新数一遍。
04
PART
它不便宜,也不万能
先说时间。17 个有效项目里,8 个跨度在 8 小时以上,8 个在 4 小时以内,1 个落在中间 [D04]。这个分布很诚实:同一套流程,有的题目四小时收工,有的要跨夜。
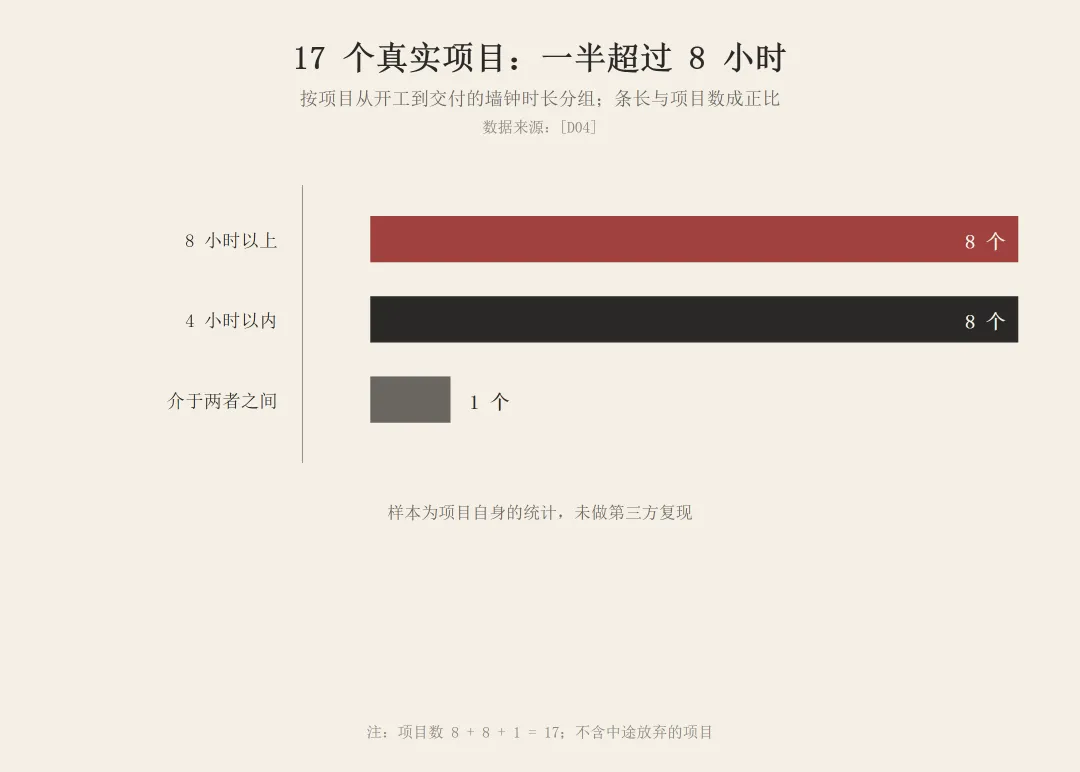
图 3|17 个真实项目的耗时分布
中断的代价更直接。一个测试项目里,负责分析的环节两度中断,接手的三条线全部失败,最后连收尾也断了 [C02]。改法不是加人,是改保存方式:先搭骨架,完成两三条就写一次,中途停下时已经写下的部分必须自洽可用 [C02]。
也有跑得顺的:一篇约 9500 字、12 篇文献、34 条数据、6 个案例的稿子,含 4 轮修改用了约 4 小时,项目自评 A-[C04]。这条要打折看,A- 是内部评级,不是外部评分。
它把挑错制度化到什么程度,还有一个数字:42 类一致性规则,多数管的是「文档说的事」和「机制实际做的事」对不对得上 [D07]。这类维护成本通常不出现在演示里。
至于不适用,它自己的说明写得比能力清单还清楚:短稿、文学创作、理工科论文、营销软文、缺一手数据的题目,明确劝退 [D01]。同样被写进边界的还有自证。AI 生成文本的可检测性在对抗改写面前本身就站不住 [L06],所以它不承诺「这稿子是我写的」。
贵在哪里也清楚:机器查得又快又便宜,人查得慢而贵,而那 45% 的修正量全落在人这边 [D05]。所有数字都来自项目自述,没有第三方复现,这一条要记住。
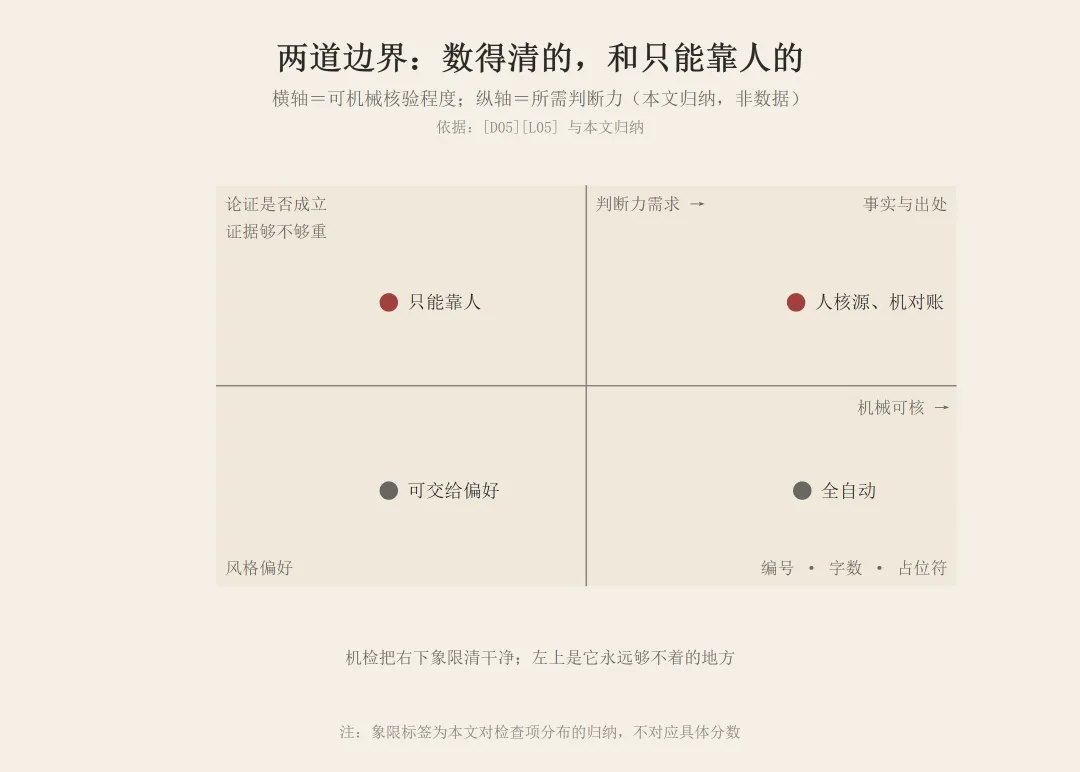
图 4|机器能查与只能靠人的分工
05
PART
把挑错变成习惯
能搬走的部分,不是九个岗位 [D02],是几个习惯。岗位要靠工具撑,习惯不用;工具会换,习惯留得下来。
一个数字至少要两个来源,第二个来源不能是第一个的转述,转述不算第二份证据。最吃重的证据也别同时撑好几个论点,同一份材料被反复借用,等于没有第二条。动笔之前先把最强的反方写出来——写不出来,说明还没想清。改稿则分段改、每段留版本:轮次不是质量,关闭的缺陷才是 [D06][C01][L05]。
有人会说这些都是常识。确实是常识,但知道要核实,和每一条都必须核实,是两件事。这套系统做的事很笨——把「大概查过了」变成「这一条必须回答是或否」,然后不让自己给自己打分。
写作变便宜之后,值钱的部分往后挪了。挪去没人愿意做、又必须有人做的地方。
06
PART
资料与说明
参考文献
[L01] WU Q, BANSAL G, ZHANG J, et al. AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation[EB/OL]. (2023)[2026-11-05]. arxiv.org/abs/2308.08155.
[L02] CEMRI M, PAN M Z, YANG S, et al. Why Do Multi-Agent LLM Systems Fail?[C/OL]//Proceedings of NeurIPS 2025. (2025)[2026-11-05]. arxiv.org/abs/2503.13657.
[L03] MADAAN A, TANDON N, GUPTA P, et al. Self-Refine: Iterative Refinement with Self-Feedback[C/OL]//Proceedings of NeurIPS 2023. (2023)[2026-11-05]. arxiv.org/abs/2303.17651.
[L04] DHULIAWALA S, KOMEILI M, XU J, et al. Chain-of-Verification Reduces Hallucination in Large Language Models[C/OL]//Findings of the Association for Computational Linguistics: ACL 2024. (2024)[2026-11-05]. doi.org/10.18653/v1/2024.findings-acl.212.
[L05] ZHENG L, CHIANG W L, SHENG Y, et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena[C/OL]//Proceedings of NeurIPS 2023. (2023)[2026-11-05]. arxiv.org/abs/2306.05685.
[L06] SADASIVAN V S, KUMAR A, BALASUBRAMANIAN S, et al. Can AI-Generated Text be Reliably Detected?[EB/OL]. (2023)[2026-11-05]. arxiv.org/abs/2303.11156.
数据与文档
[D01] 论衡(lunheng-article-pipeline)当前发布版本 19.27.15[EB/OL]. 公开仓库 package.json 的 version 字段,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh
[D02] 论衡的岗位构成:9 个独立岗位 [EB/OL]. 公开仓库 docs/quick-facts.md 第 22 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/docs/quick-facts.md
[D03] 检查项总数:程序执行 25 项 + 人工 1 项 = 26 项(构成为 11 + 12 + 2 + 1)[EB/OL]. 公开仓库 docs/quick-facts.md 第 31 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/docs/quick-facts.md
[D04] 17 个有效项目的实际耗时跨度:≥8 小时 8 个、≤4 小时 8 个、中间 1 个 [EB/OL]. 公开仓库 SKILL.md 第 129 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/SKILL.md
[D05] 程序检查项中需人工修正的比例:约 45%(当时按 22 项检查统计,单例样本,不随检查项增长自动平移)[EB/OL]. 公开仓库 SKILL.md 第 110 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/SKILL.md
[D06] 跨体例盲评:某学术稿定稿 22 分对第一版 16 分、19 分对 18 分(两名独立判者,方向一致;版本区间 v18.80.4)[EB/OL]. 公开仓库 references/pipeline-readme.md 第 270 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/references/pipeline-readme.md
[D07] 一致性自检主规则:42 类 [EB/OL]. 公开仓库 docs/quick-facts.md 第 55 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/docs/quick-facts.md
[D08] 随包工具面:脚本 37 个、斜杠命令 13 个 [EB/OL]. 公开仓库 docs/quick-facts.md 第 52-53 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/docs/quick-facts.md
[D09] 主流程 6 步与人在环 4 个节点(默认 2 个阻塞、2 个通知)[EB/OL]. 公开仓库 SKILL.md 第 196 行,2026[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/SKILL.md
案例记录
[C01] 跨体例盲评:定稿低于第一版。论衡项目公开记录,2026-09 至 2026-10(v18.80.4 版本区间)[EB/OL]. [2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/references/pipeline-readme.md
[C02] test-paper-01 测试项目连续中断:分析环节两度中断、三条接手线全败、收尾中断,后改为「先搭骨架、每完成 2-3 条即保存」[EB/OL]. 论衡项目公开记录,2026-08 至 2026-09(v2.5.2-dsh.9 版本区间)[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/references/pipeline-readme.md
[C03] 无出处的数字被复核抓出:文中「2020 年,2500 万」实为 2019 年 22 万欧元与 2024 年另一事件的混淆 [EB/OL]. 论衡公开记录,2026-08-18(v2.2.3 版本区间)[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/references/case-studies.md
[C04] 原创性悖论项目:约 9500 字、12 篇文献、34 条数据、6 个案例,约 4 小时、4 轮修改,项目自评 A- [EB/OL]. 论衡公开记录,2026-08-13(v2.2 + v2.3 版本区间)[2026-11-05]. github.com/zuoyunlai/lunheng-article-pipeline-dsh/blob/main/skills/lunheng-article-pipeline/references/case-studies.md
同类工作
[先01] SHAO Y, JIANG Y, KANELL T, et al. Assisting in Writing Wikipedia-like Articles From Scratch with Large Language Models[C/OL]//Proceedings of NAACL-HLT 2024: Volume 1, Long Papers. 2024: 6252-6278[2026-11-05]. doi.org/10.18653/v1/2024.naacl-long.347
[先02] ELOVIC A, et al. GPT Researcher[EB/OL]. 开源项目,2023(仓库创建 2023-05-12)[2026-11-05]. github.com/assafelovic/gpt-researcher
[先03] BAI Y, ZHANG J, LV X, et al. LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs[EB/OL]. (2024)[2026-11-05]. arxiv.org/abs/2408.07055
作者签名:[作者签名] 日期:[日期 YYYY-MM-DD]
最后问你一句:你的长文里,最花时间的是写还是挑错?评论区说说,尤其是那些 AI 查不出来的错。