ARTICLE · 1358114
DeepSeek把App里的搜索、读链接和文件一起开放了,还送了个开源聊天前端
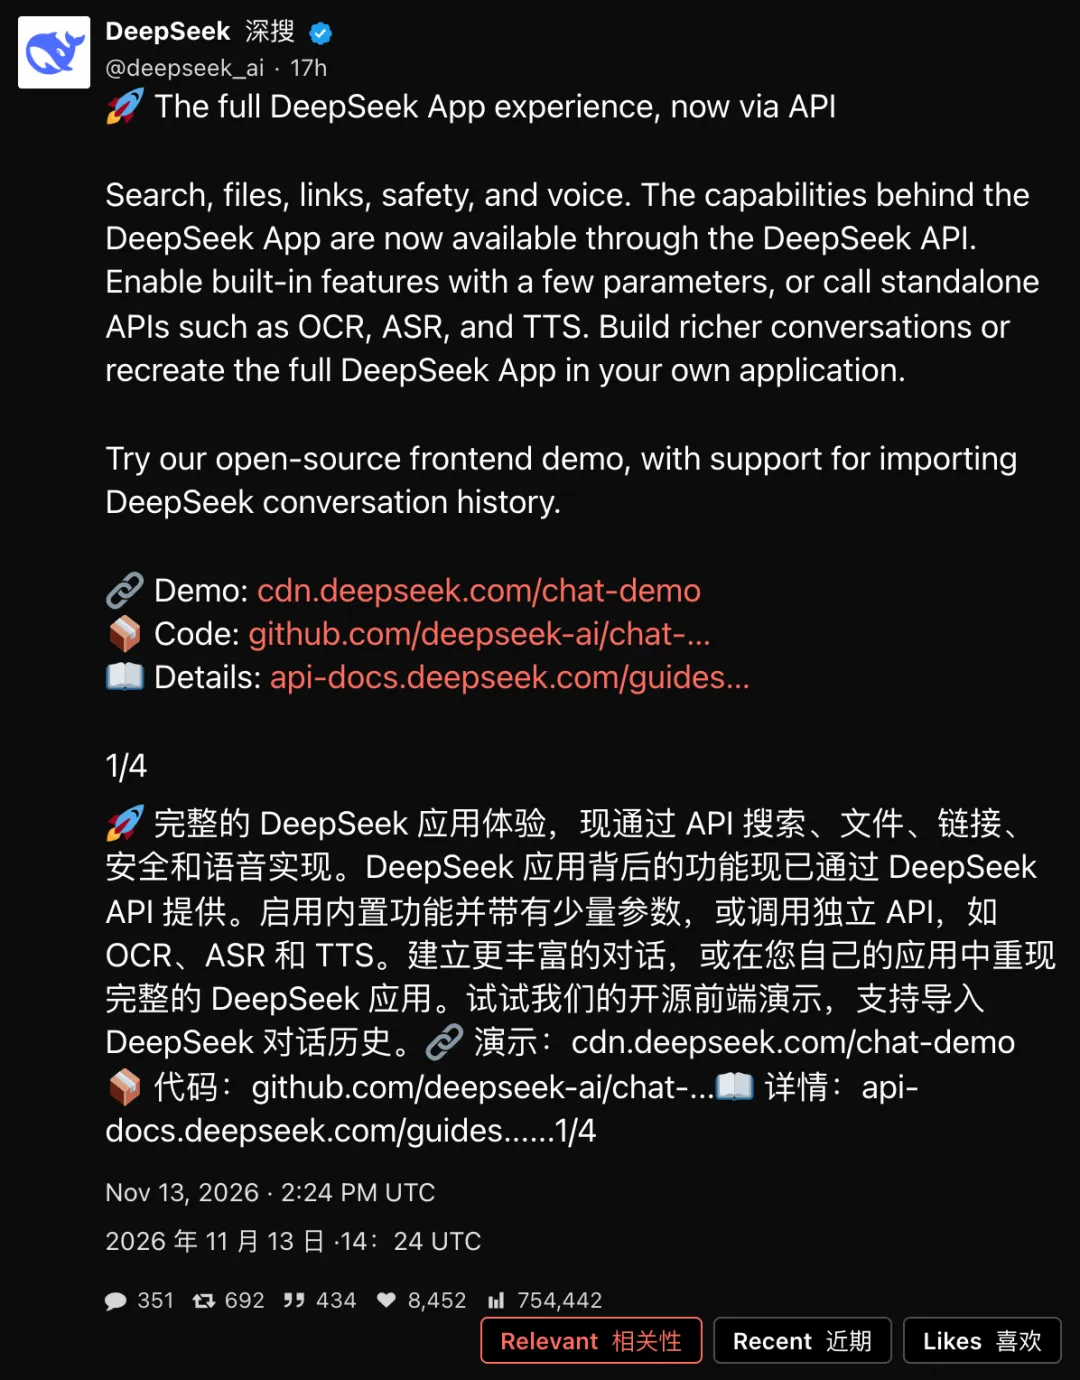
昨晚,DeepSeek 把自家 App 里几样最常用的东西一起开放给了开发者。联网搜索、读网页、读文件,可以接到已有的对话 API 里。它还把一个能导入历史聊天的演示前端放到了 GitHub。
我先去点了那个前端。聊天框旁边就有附件入口,输入框下方就能点智能搜索。这个东西挺适合拿来开工。比方说我平时看 AI 新闻,桌上往往有一份已经存下来的 PDF,浏览器里又开着官方更新页。以前自己写个聊天工具,得先想办法把这两样东西变成模型能接着读的内容。现在用 DeepSeek 的演示前端,就能先看看它们拼到一轮对话里是个什么样子。
同一条消息里,一个附件,再加一个链接
举个我真会拿来用的例子。周一下载了一份工具的套餐说明,周五看到官网更新。想知道个人用户是不是多了一个入口,我会把旧 PDF 上传,把新页面的地址贴进去,接着说一句「只找套餐、地区和开放时间的变化。每条差异标明来自旧文档哪一页,还是新页面哪一段。没找到就写没找到。」
这里有两个东西要处理。附件在你本地,链接指向网站上那一份,模型需要分别拿到。文档那边,可以先通过 Files API 上传,再在对话里引用文件。网页那边,开启 deepseek_read_url 后,模型可以识别消息里的地址,服务端去取网页内容。拿到的材料会跟着这一轮对话走,开发者可以用原来的 Messages、Responses 或 Chat Completions 接口。
我想先用一份两页的小 PDF 试。第一页写个明显的旧日期,第二页放一段容易和新版搞混的限制。测试时对一下引文。它要是把旧表里「团队用户」抄成新版的开放范围,哪怕别的几条都答得漂亮,这轮也得回去查。PDF 里的双栏、表格、扫歪的字,本来就有可能让解析跑偏。页码也是我交给模型的任务,最后得回到原件核。
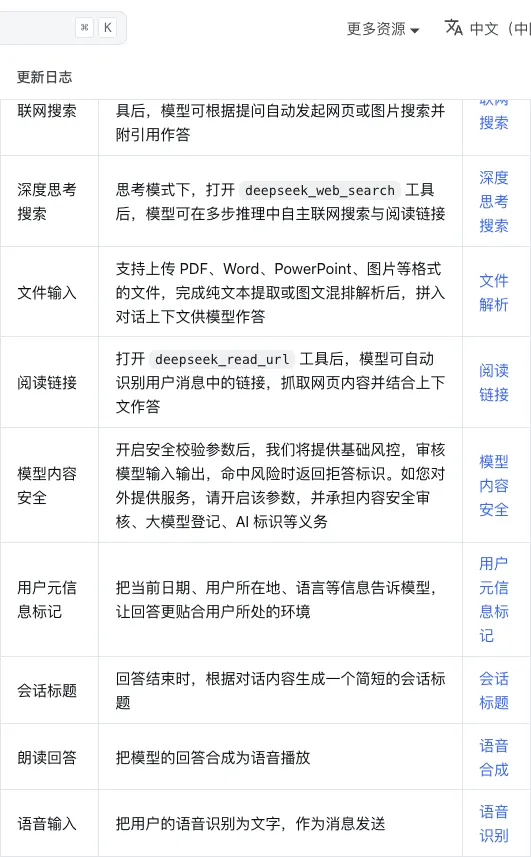
还有一种情况,我手上连新链接都没有。比如只知道某家昨晚改了定价,要先找到公告。用的是另一个工具 deepseek_web_search。普通模式能按提问发起网页或图片搜索,回答里带引用。深度思考模式下,它可以在几轮推理里继续搜和读。先交代「优先找官网和版本记录」,要是第一轮搜出来全是转载,再沿发布日期、产品名或者发帖账号补一轮。
已知网址就给网址,要找材料再开搜索。 搜和读这两个动作分开以后,拿来查新闻挺顺手。比如同一条更新有中文和英文两版,我更愿意先贴两条官方页面,让模型把冲突的句子并排摆出来。它如果读不出来,直接把没读到的那一版留给我。这对经常点到登录页、动态渲染页面和公众号链接的人很实际。你拿不到正文,换成 API 发请求也未必就能拿到。读网页工具的文档里有成功和失败状态,接到自己的工具里时,把它显示出来,比出一段看似完整的摘要有用。
不想写前端,先上那个演示客户端
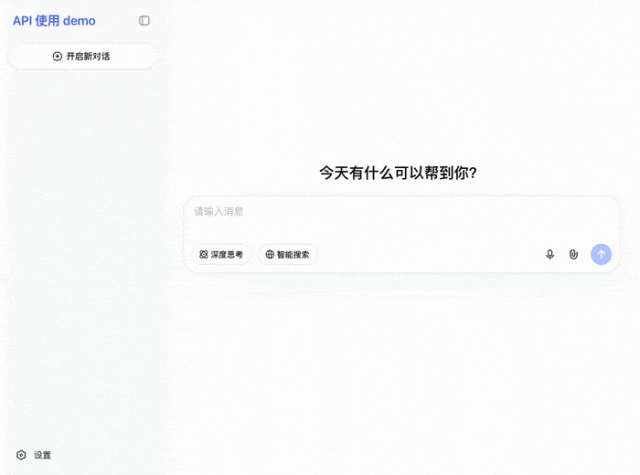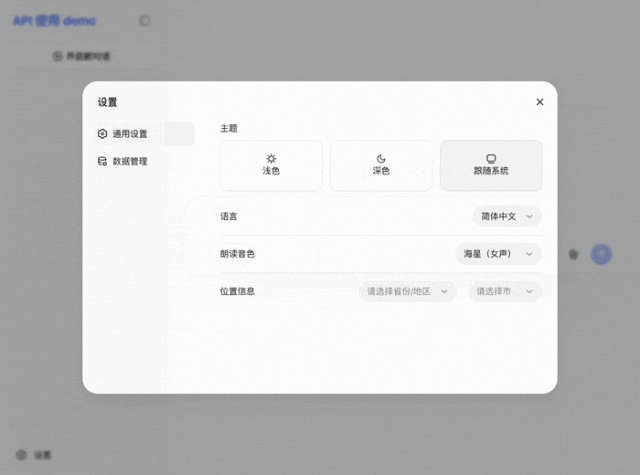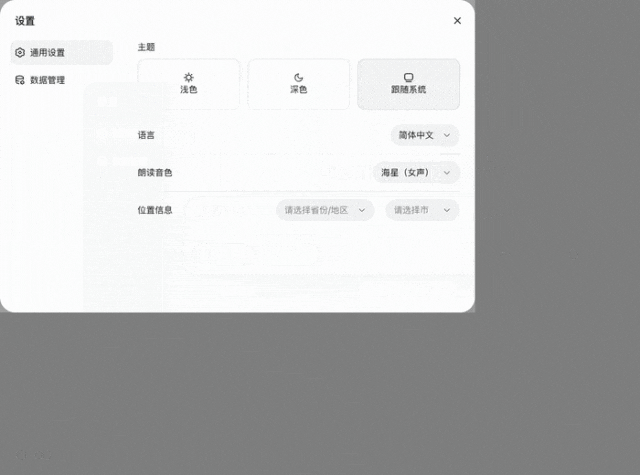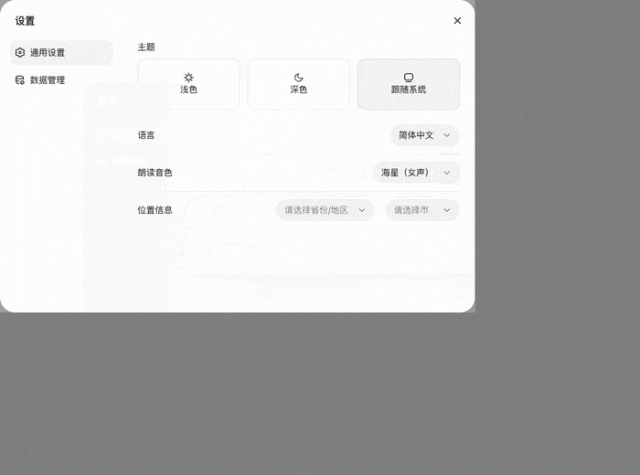
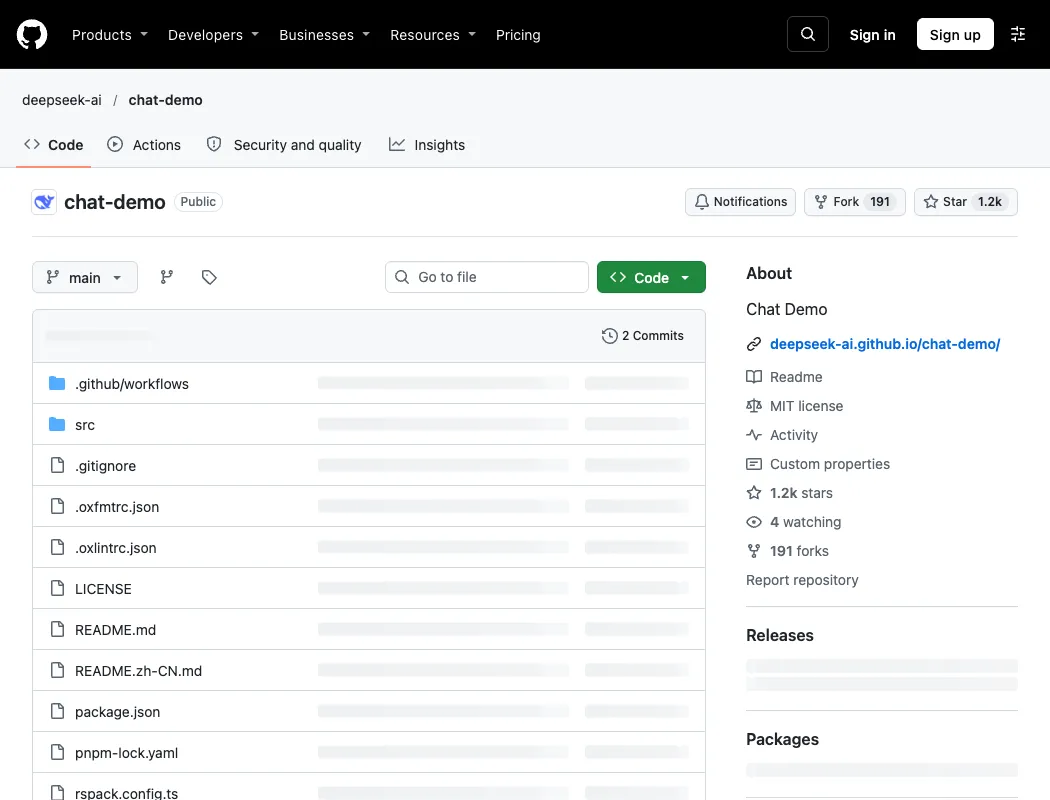
入口好找。在 GitHub 搜 deepseek-ai 的 chat-demo,从仓库说明打开官方演示。我喜欢它把用来试的东西摆得很近。先打开设置填自己的 API Key,回到聊天页,拿一份可公开的文档和一个普通网页试一轮。第一条只读链接,第二条再把文件放进来。出了问题,你一下就知道该查哪边。语音识别和播报也可以在这个演示里体验。
回车之前,我还会把来源摆得很明显。附件叫「旧版套餐表」,网页那条在消息里先标「更新公告」。然后故意追问一句「刚才那条专业版的限制出自哪里?」我想看它能不能顺着两轮聊天指回对的那份材料。做自己的页面时,给最后一条消息留一个可展开的来源栏,文件就写名称和页码,网页就写标题和取回状态。这样答错了一处,也能从界面走回去。
我去翻了它的文档和仓库。这个项目是 MIT 许可,官方定位是演示。它可以导入从 DeepSeek 网页端导出的历史对话,适合把一个长聊了一半的主题捡起来。导入会覆盖演示客户端现有历史,已经在这里聊过几轮的话,先把这边要留的东西导出来。你也可以空白起一条,把以前做过的一个请求复制来重新跑,判断工具调用是不是符合自己想要的方式。
API Key、历史记录和图片在这个演示前端里由浏览器本地保存。实际聊天、解析文件或联网时,对应请求会发到 API。把页面放自己电脑上跑,同样会发生这次调用。我会先用公开材料把按钮和流程摸清;真要给同事用,密钥放服务端,不能让每个人打开网页源码就能看到一个共用 Key。限制每个用户一天能用多少,给文件和网页请求做超时提示,这几件事要从第一版就想好。碰到有图表的年报,还可以先看看解析模式。只拿文字,价格和页码这类内容通常就够查。想判断一张图的横轴单位,单纯 OCR 出几个词就很难。官方有图文版面解析,可能把部分图表裁出来,放回原来的位置附近。我会先拿一张柱状图试,要求回答同时说出轴的单位和两条图例。它说不出来,路就很清楚了,把图单独送进去,或者自己看。
还有一个我觉得省事的地方。你的网站想做的可能只有「录完音就存一份文字」,那就直接用官方的 ASR,不用先接一套聊天。相反,要让用户说「把我刚才传的报告和官网更新一起读一下」,把工具接到对话里更省心。联网搜索、抓取、OCR、语音识别和文字转语音都有独立 API,可以按自己那条流程选。
账单里会多出什么
DeepSeek 已经有 V4.1 Flash 1017,这次加的是调用工具的办法,模型参数仍写 deepseek-flash。这事儿容易搞混。我看价格表时会把模型消耗、工具消耗各记一笔。一轮请求跑了几次搜索、抓了几页网页,费用会跟着这些实际操作走。
这次有新工具,联网搜索本身其实有前情。DeepSeek 10 月已经开放过独立搜索 API。那时候想做一个能引用网页的聊天框,开发者可以先自己找结果、再喂给模型。这回几种常用工具进了对话请求,同一轮里模型可以自己决定何时搜、何时读。文档也说明了,要不要触发由模型决定,开启工具不等于强制执行。要是我就想检查固定的三个地址能不能抓,独立的 Fetch 更直接,成功还是失败可以自己处理,再决定哪部分内容要送去生成。
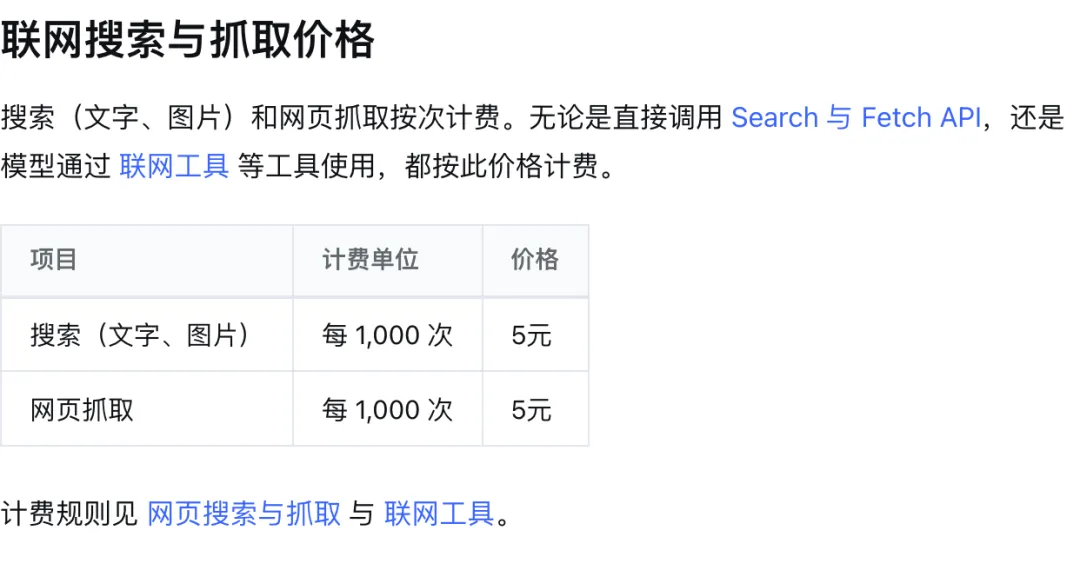
按发布时的人民币价格,网页搜索、图片搜索和抓取各 0.005 元一次,文件解析和独立 OCR 都标 0.0015 元一页。举个容易按计算器核的账。一轮用两次网页搜索、一次抓取,再解析一份四页 PDF,这些操作按价目表合计 0.021 元,模型输入和输出的 token 费用另算。搜索按成功返回结果的查询词计,一个工具调用里有三个查询词,也可能按三次收。PDF 成功解析以后按页收一遍,下次继续引用这份已解析文件,算实际拼进去的输入 token。XLSX 和 CSV 走普通文件上传时不收解析费。每种文件怎么放进去,直接影响账单。如果深度思考自己又搜了几轮,操作数也会变。工程里要算预算,先让测试请求把调用轨迹和用量记下来,十次之后看分布,比只拿最便宜的一条算月成本靠谱。
另外,如果是把聊天功能接到一个对外开放的产品,DeepSeek 要求开启内容安全检查,开发者仍负责产品自己的审核与合规。对我来说,这也提醒一件很细的工程活。前端得把几种失败分开。文件没传上去,网页打不开,内容被安全检查拦了,分别给出对应的提示。三个情况都弹出「AI 暂时无法回答」,用户只能拿原话再碰一次运气。
我会先把它当成一个素材整理台来试。上传旧发布说明,贴新公告,让模型只给我三段原文和它判断变了的地方。遇到读不到的链接,就在旁边挂一条待人工确认。等这个小流程跑顺了,再考虑加语音、批量搜资料或者自动做晨报。每天能省下一次找旧 PDF、复制网页和手工对日期的功夫,我就愿意留着用。