ARTICLE · 1367112
最新DeepSeek 把 App 拆成了零件:全家桶 API 到底改了什么
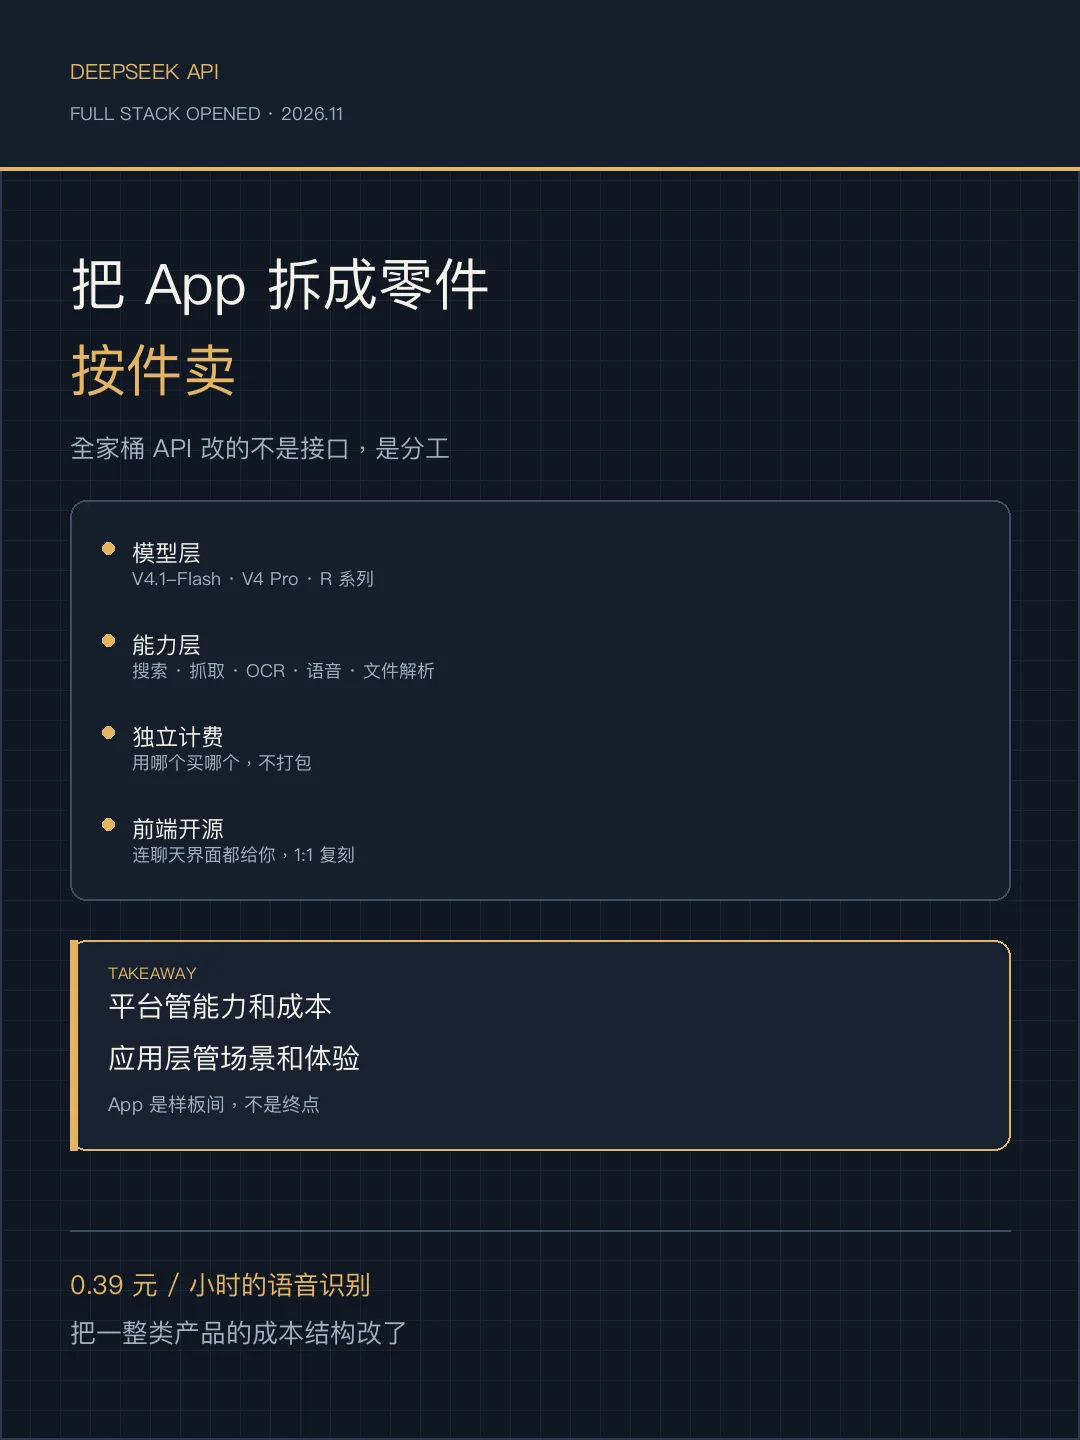
从“调一个模型”,到“拼一条流水线”
引子
周五晚上八点,一个做合同审核的小团队在群里发了张截图。
他们原先的链路是自己搭的:调搜索接口找法规,自己写代码抓网页,再调 OCR 读扫描件,最后把三份结果拼成一段提示词,塞给模型。任何一环返回空,整条链路就断,排查一次要半天。
这次他们只改了一行配置:把“联网搜索”打开。
什么时候搜、搜什么、读哪几页、读完怎么接着答,全交给模型自己判断。
这个变化来自 11 月 13 日周五晚上 DeepSeek 的一次发布:App 背后那套能力,全部开成了 API。
第二天上午,这条消息已经在开发者群里刷屏。到 15 日,已经有人拿它改完了自己的第一条链路。
把时间摊开看,脉络很清楚:10 月 17 日先放了 Search 和 Fetch 两块砖,编排还得自己写;11 月 13 日晚把搜索、文件、OCR、语音一次性开出来,还附赠一套能导入历史对话的开源前端;48 小时后,第一批尝鲜的应用已经跑起来了。
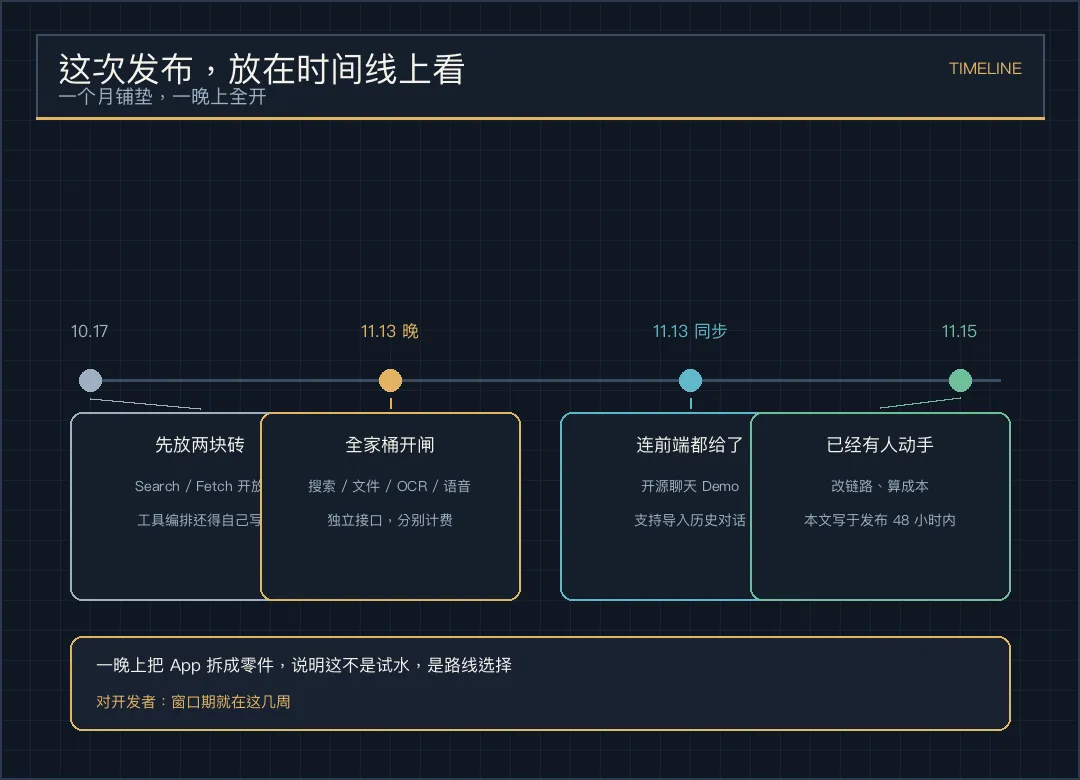
图 1|这一个月的时间线
一个月铺垫,一晚上全开。这不是试水,是路线选择。
01|全家桶里装的是什么
以前说“调 DeepSeek”,指的是调一个对话模型。现在这个 API 里装的是两层东西。
模型层:V4.1-Flash、V4 Pro、R 系列,负责理解和生成。V4.1-Flash 已经支持 Messages、Responses、Chat Completions 三种接口形态下的对话扩展。
能力层:联网搜索、深度思考搜索、文件上传解析、链接阅读、OCR、语音识别 ASR、语音合成 TTS,以及十月份就开放过的 Search 和 Fetch。
关键在于:能力层不是打包卖的。 每个都是独立接口,可以单独调用、分别计费。
这句话听起来像句废话,其实是这次发布里最重要的设计。打包意味着你为一个功能付全部的钱;拆开意味着你可以只买“读图”,不买“搜索”。
一家做票据识别的公司,不需要 Agent,也不需要联网,它只需要 OCR。以前这种需求只能塞进一个大而全的方案里,现在可以只调那一个接口。
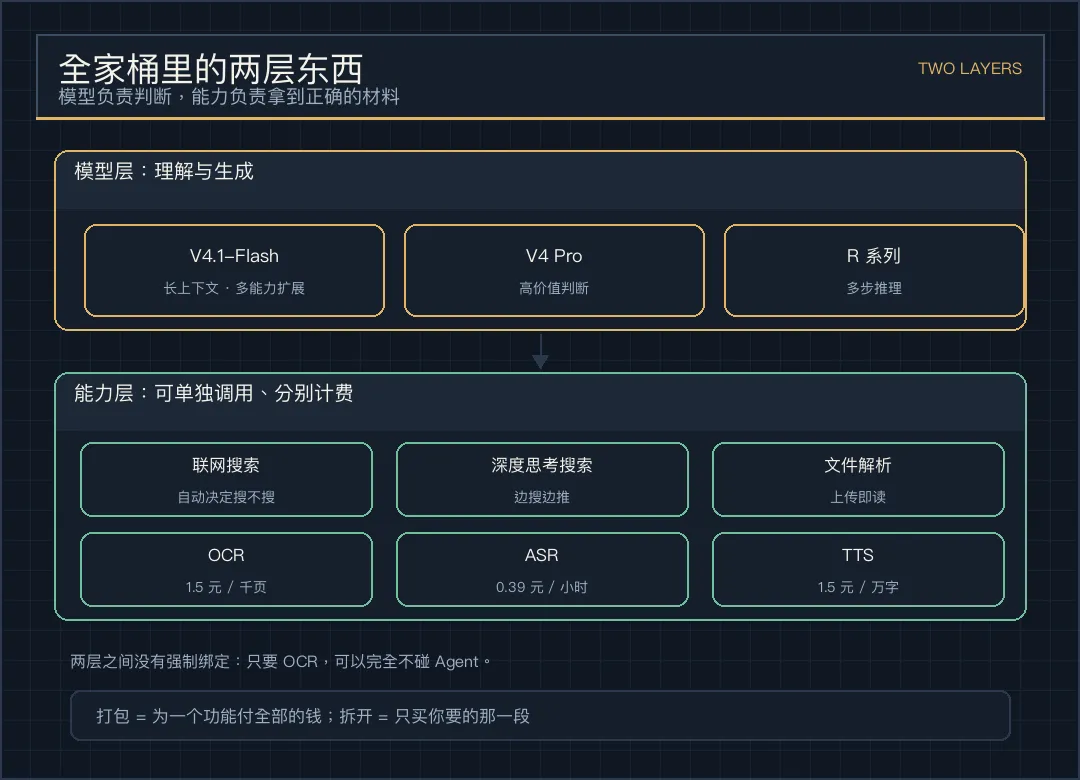
图 2|全家桶的两层结构
02|自己串和平台串,差在哪
十月份开放 Search 和 Fetch 时,开发者拿到的是两块砖。
用户问“最近 AI 圈发生了什么”,你得自己判断要不要搜,自己调 Search 拿链接,自己调 Fetch 读正文,自己截断、自己排序、自己拼回上下文,再请求一次模型总结。这套编排逻辑不难写,难在稳定:网页抓取失败、正文超长、结果互相矛盾,每一种都要单独处理。
这次的变化是把这段编排收进了模型侧。你打开开关,模型自己决定搜不搜、搜几次、读哪几篇。
代价是可控性下降——它可能搜了你不想让它搜的东西,也可能只读了一页就下结论。收益是工程量骤降,尤其对小团队。
这是一个典型的取舍:编排交给平台,控制权也交给平台。 需要审计每一次检索的团队,仍然应该自己串;只想尽快跑通产品的团队,用平台版更快。
03|“1:1 复刻 App”,这句话才是重点
官方公告里有句话挺有意思:开发者甚至可以 1:1 复刻出一个完整的 DeepSeek App。
配套动作也很实在:开源了一套轻量聊天前端 Demo,支持导入历史对话。
把这两件事放一起看,意思很清楚——DeepSeek 不打算把 App 当成护城河。
多数公司的做法是:能力开放一部分,最好用的留在自家产品里。DeepSeek 反过来,把搜索、读文件、语音都放出去,连前端都给你,剩下的你自己发挥。
这么做的底气来自成本结构:模型和基础设施在自己手里,多一个开发者调用,边际成本很低;而应用层的胜负,本来也不由模型厂商决定。
对开发者来说,这是好事,也是提醒:如果一门生意的全部价值就是“我会调这几个接口”,那它很快就不值钱了。
04|价格表里藏着真正的杀招
这次最扎眼的不是功能,是语音的定价。
•语音识别:原价 0.78 元/小时,五折后 0.39 元/小时
•语音合成:原价 3 元/万字符,五折后 1.5 元/万字符
•搜索 / 抓取:5 元 / 1000 次成功调用
•OCR:1.5 元 / 1000 页,平均一页 0.0015 元
拿去和海外比:OpenAI 的转写服务一小时约 1.81 元,轻量版约 1.21 元;Google 标准语音识别一小时约 6.43 元。0.39 元分别只有它们的四分之一到十六分之一。
这不是“便宜一点”。语音转写是会议记录、客服质检、口述笔记、字幕生成这几类产品的成本主项,一小时四毛和一块八,决定的是同一门生意能不能做。
OCR 也是同理:一页一分五,意味着“把整箱纸质档案扫进系统”从项目变成了日常操作。
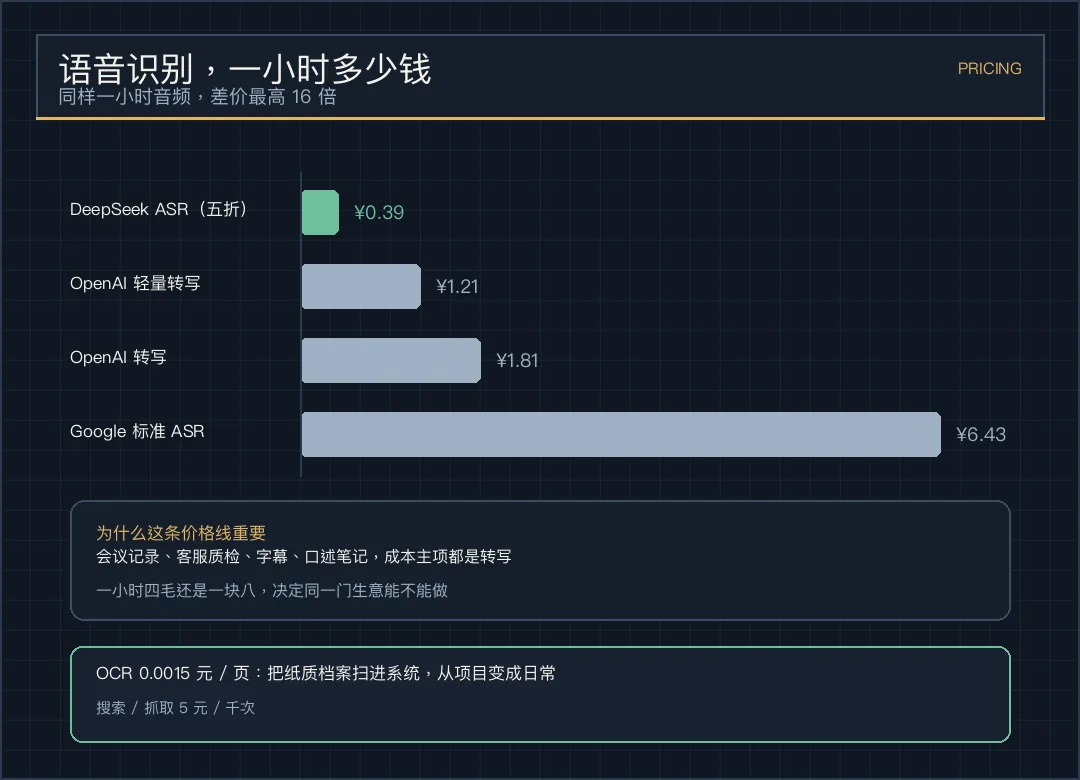
图 3|语音识别的价格对比
05|三条能跑通的链路
合同与票据审核。 OCR 读扫描件 → 模型抽字段 → 需要时联网查法规 → 输出结论。这条链路里,最贵的不是模型,是返工。OCR 准一点,后面全省。
会议纪要与跟进。 ASR 转写 → 模型分段、提取待办 → TTS 生成语音摘要。过去这类产品的毛利全被语音接口吃掉,现在成本结构变了。
行业信息监控。 定时 Search → Fetch 读正文 → 模型归纳变化 → 推送给业务。注意这条链路最容易失控:搜索质量决定一切,模型只能锦上添花。
三条链路的共同点是:能力层负责“拿到正确的材料”,模型层负责“做出判断”。 材料错了,模型再强也只是把错误说得更通顺。
写在最后
这次发布表面上是在开放接口,实际上是在重新划分边界:平台负责能力和成本,应用层负责场景和体验。
对开发者,短期是红利——省掉一堆脏活;长期是压力——接口人人可用,差异化只能来自你比别人更懂那个场景。
App 是样板间,不是终点。接口可以照抄,场景照抄不了。
创作不易,如果这篇文章对你有启发,欢迎点个“关注”,“星标”,一起交流AI行业动态和技术。