ARTICLE · 1374850
PDF 打码别只盖黑框:AnyRedact 用 AI 打码防泄露
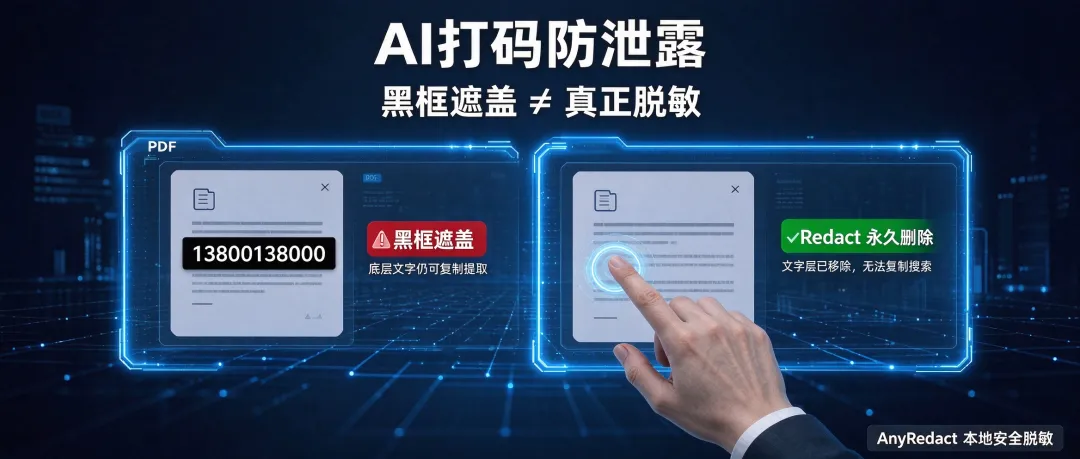
平时给文件打码,多数人习惯拖个黑框上去就完事。问题是有些黑框只是盖在文字上面的一个图形,原始文字还老老实实躺在 PDF 里,别人一点选中、一复制就能读出来。
盖上黑框,信息就真的没了吗
不一定。前面说的那种黑框,很多只是浮在文字上方的一个图形对象,文字本身并没删掉。别人选中、复制,或者把黑框挪开,被遮的内容就露出来了。
AnyRedact 的做法不太一样:导出时它把整页重新生成成图片,遮盖区域直接写进像素里,原来的文字层不再保留,普通覆盖层留文字的毛病就避开了。但这里有个前提——该遮的都得遮到。要是漏了一个账号、一处签名或者一个二维码,它照样会出现在导出文件里。所以哪怕用了自动识别,最后还得自己过一遍。
它能帮你找出哪些敏感信息
拿一份要发给客户的合同来说,联系人姓名、手机号、银行账号散在各处,自己逐页找很容易漏。AnyRedact 可以先用 AI 把这些挑出来标记好,再由你决定哪些遮、哪些留。
它认的不只是个人资料。除了邮箱、地址、证件号码,官方还列了 IP 地址、API Key、密码、Token 这些技术信息。要分享日志或配置文件,拿它辅助排查可能泄露的内容也挺顺手。
当然,AI 不会百分百找全。签名、二维码、照片,或者只有你自己知道要保密的内部编号,还是得在页面上手动拖框。反复出现的客户名称、项目代号,可以加自定义敏感词,省得每次都重新找。处理完它还会提供一次可选的 AI 查漏,但这个只能当辅助,最终遮哪些还是你自己说了算。
除了 PDF,它也支持图片、Word、Excel、PowerPoint、文本文件和音频,比如给截图隐藏联系方式、分享表格前处理客户信息。不过不同格式的处理方式不一样,别想当然地以为都跟 PDF 一样是图片化导出。
实际用一遍:四步给 PDF 打码
下面按官方 PDF 指南走一遍,直接在浏览器里就能弄。
先把文件丢进去。打开 AnyRedact PDF 打码页面,选择文件或者直接拖进编辑区,PDF 就在浏览器里打开并预览了。扫描版 PDF 会用浏览器端的 Tesseract OCR 识别文字,不过低对比度、模糊印章和手写内容可能认不太准,后面还得手动补。
中文也能用。我实际试过,它支持中文内容识别,不只是英文 PDF。扫描件的话建议核对一下识别结果,尤其身份证号码、手写和模糊区域,别让敏感信息漏网。
选 AI 自动检测,还是自己框?想让 AI 找姓名、账号、电话,就按编辑器提示点 Upload,确认把提取的文本送到服务端检测。不想把文档内容发出去,可以跳过 Upload,直接在浏览器里手动框选要遮的地方。
逐条审核,把漏的补上。检测完,Found 列表会列出识别到的敏感信息并在文档里标出位置。用不着的可以取消,也可以手动补。比如银行流水要证明收入,姓名、银行名称、某些交易记录可能得留着,就不能把 AI 找到的一股脑全删。签名、照片、二维码、页面边缘和模糊扫描件也值得单独看一眼。客户名称或内部编号反复出现的话,用 Always redact 自定义词条能省点事。
导出,然后再查一遍。确认好遮盖内容就能下载了。AnyRedact 会把每页重新生成图片,敏感文字不再留在文字层里。下载后最好重新打开看看,姓名、账号、签名、二维码这些最容易漏的地方重点盯一下,也可以试着搜索或复制之前打码的文字,确认没有残留再发出去。
它到底会不会上传你的 PDF
如果你只想遮住几处文字,手动框选就行,不用上传整份文件。但开了 AI 自动识别,AnyRedact 会把提取出来的文字发到 Cloudflare Workers AI,用来找姓名、电话、银行账号这些。扫描版 PDF 的 OCR 是在浏览器本地跑的;导出前那个 AI 查漏功能会再调一次云端;车牌、路牌识别以及音频处理则可能涉及图片或音频数据的传输。
只是打几个黑框,手动处理足够。想让 AI 帮你揪出遗漏的姓名和账号,就得接受文本被送到云端。客户合同、财务资料或公司内部文件,最好先确认一下:这类内容允不允许交给第三方 AI 服务。官方隐私政策在这里。
导出的 PDF,能恢复被打码的文字吗
正常打码完成后,别人没法靠复制文字或者挪开黑框把内容找回来。AnyRedact 会把每一页重新生成图片,打码区域也并进图片里,原来的文字层、附件和文档元数据都不保留。
代价是导出的 PDF 变成了图片型文件:文字不能直接搜索或复制,超链接、表单和电子签名也会受影响。后面还要编辑、填表单或者验证签名的话,原文件得留着。
还有一点容易忽略:工具只能处理你标出来的内容。漏掉的姓名、账号照样留在导出文件里。发出去之前,务必打开再看一遍。
免费额度够用吗,价格怎么样
AnyRedact 不用注册就能用,每天有 10 Credits 免费额度。偶尔给简历、账单或几页合同打码,免费版基本够。量大的话可以按月订阅,也能单独买积分,不一定非得开会员。
Credits 说白了就是处理额度。普通文档大约每 3,000 个字符消耗 1 Credit,每天免费的 10 Credits 大致能处理 10 页普通文字,但不固定——文件里字越多,消耗越高,部分图像识别还会额外扣。单份 PDF 最多 60 页,更长的得拆开。中文能识别,但 AI 仍有漏掉的可能,模糊扫描件、手写、特殊格式的编号尤其要注意。
另外,AnyRedact 目前没有公开的开源或自托管版本,想部署在自己服务器上得另找工具。价格可能调整,最新的看官网价格页。
和 Secure PDF Editor 怎么挑
一份十几页的 PDF,姓名、电话、账号散落在不同角落,自己逐页翻确实累。这种时候 AnyRedact 先让 AI 找出来、你再决定遮哪些,比较合适。
要是只遮一两个名字或签名,就没必要惊动 AI 了。之前介绍过的 Secure PDF Editor 支持手动框选,还能自行部署,整个过程都在本地。简单讲:敏感信息多、懒得逐页找,用 AnyRedact;只改几处,或者希望全程本地,Secure PDF Editor 更省事。
❓ 几个常被问到的问题
Q:导出后还能恢复被打码的文字吗?
正常打码后不行。文字层、附件、元数据都不保留,黑框也没法挪开。但导出的文件变成了图片型,文字不能搜索复制,超链接、表单、电子签名也会失效。
Q:会上传我的文件吗?
手动框选在浏览器里完成,不用上传。开启 AI 识别时,提取的文本会发到 Cloudflare Workers AI;扫描件 OCR 在本地跑;导出前的 AI 查漏会再调用云端。
Q:支持中文吗?
支持。不过扫描件的身份证号码、手写、模糊区域建议人工复核一遍。
Q:免费额度够用吗?
每天 10 Credits,普通文档大约能处理 10 页。偶尔用用足够,大批量就得算算积分。
🔗 官方网站
如果这篇工具分享对你有帮助,欢迎点赞、在看、分享给需要的朋友 👏