ARTICLE · 1383584
你把整篇文档塞给 AI,它为什么反而答得更差
你把整篇文档塞给 AI,它为什么反而答得更差很多人第一次用 AI 处理长文档,都会经历同一个落差。 你把一整份 80 页的材料丢进去,问它「关键风险在哪」。它回你一段四平八稳的总结:市场风险、政策风险、执行风险,每一条都对,每一条都没用。 然后你换了个做法:只贴三页——那一页写了违约条款,那一页写了付款条件,那一页有一句模糊的「其他费用由双方另行协商」。 这一次,它答得又快又准,还把那句模糊表述单独拎出来提醒你。 于是问题来了:给的材料越多,它为什么反而越糊? 这不是错觉,也不是「模型不行」。过去三年,有不止一组研究在测同一件事:模型到底怎么使用长输入。结论比想象中具体。 
给得越多,不等于看得越清。 要理解这件事,先把三个常被混着用的词分开。 第一个,上下文窗口。 指的是一次能「读进去」多少内容。宣传里常说的 128K、200K、100 万字,说的是这个。它更像一张桌子的面积:能摊开多少纸。 第二个,有效长度。 指的是读了之后,还能「用对」多少。这两件事不一样。NVIDIA 的 RULER 评测就发现,不少模型的实际可用长度明显低于宣称值;后续有研究具体测到,一些宣称128K 的模型,有效长度只有64K 左右。 桌子变大了,不代表桌上每张纸你都看得清。 第三个,注意力。 模型不是把输入里的每个字都等同对待。它会分配权重,而分配的方式有自己的偏好——这一点,正是「塞得越多反而越差」的根源。 所以那句常听到的话要改一下:不是「它能读多长」,而是「它读长了还能记住多少」。 这是两件完全不同的事,而绝大多数使用说明只告诉你前者。 2023 年,斯坦福等机构的研究者做过一项现在被引用很多的研究,标题就叫《Lost in the Middle》(迷失在中间)。 他们设计了两类任务:多文档问答,以及从长文本里找键值对。做法很巧:把同一份关键信息,放在输入的不同位置——开头、中间、结尾,看模型答得准不准。 结果画出来是一条 U 形曲线:关键信息在开头和结尾时,准确率最高;放到中间,明显下降。 更值得注意的是,这个现象在「明确宣称支持长上下文」的模型上同样存在;在某些情况下,当关键信息落在中间,模型的表现甚至不如「干脆不给它任何材料」。 研究者给这个现象起了两个名字:开头叫「首因偏好」,结尾叫「近因偏好」。 这个规律其实很像人。一场两小时的会,你记得最清的是开场那几页和最后一页 PPT,中间那半小时讲了什么,得靠笔记。 所以「塞整篇」的第一个代价,是把你最想让它看见的那句话,放到了它最容易忽略的位置。 而现实里,最难的材料往往就在中间:合同的附则、报告的方法说明、制度文件的第七页。 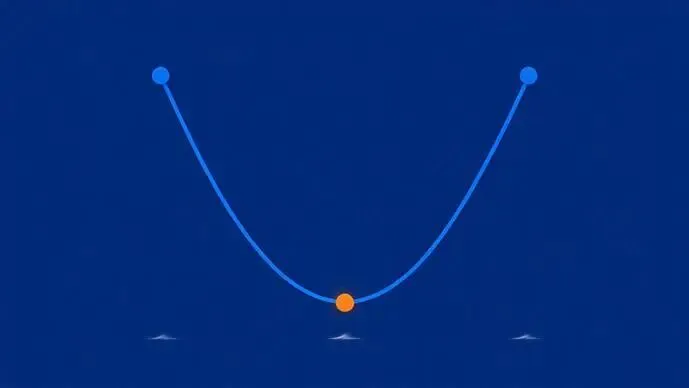
两头记得清,中间最容易漏。 还有一种更隐蔽的情况:材料根本没到窗口上限,质量就已经开始掉了。 2025 年 7 月,Chroma 发布了一份技术报告,起了个很形象的名字——「上下文腐烂」(Context Rot)。他们测了 18 个主流模型,包括当时最新的几款。 结论有三条,都很反直觉。 第一,每个被测模型都出现了退化。 不是某一家的毛病,是这一类模型的共性。 第二,退化远在窗口填满之前就开始了。 哪怕任务本身很简单——找一句话、做个分类、复述一段内容——输入一长,稳定性就下降。也就是说,「没超上限」不等于「没受影响」。 第三,导致变差的不只是长度。 报告指出,还与三个因素有关:干扰项有多少、目标信息和你的问题在字面上像不像、以及文本的组织方式。翻译成人话:无关内容越多、你和它说的词越对不上,它越容易漏。 这解释了一个常见现象:你丢进去一份 60 页的会议材料,问「关于预算,最后定了多少」。它答了一个中间讨论时的数字,而不是最终结论。不是它不会读,是它在一堆相似表述里,选错了那一个。 除了模型那边的原因,还有两个成本经常被算在使用者头上。 一是指令被稀释。 很多人习惯把要求写在最后:请用表格输出、只回答三点、不确定就说不知道、不要编。 可是当前面压着几十页材料时,这几句话在模型眼里,就成了背景噪音的一部分。表现出来就是「它不听话」——你要求三点,它给你八点;你说不确定就别答,它照样编。 这不是它故意违反,而是你的要求被稀释了。 二是你自己失去了核对的能力。 材料太长的时候,它给一个模糊的答案,你也没法判断对错——因为你不知道那句话在第几页。 于是你只能凭感觉:「好像不太对,但也说不出哪里不对。」 一次两次之后,结论就变成了「AI 处理长文档不行」。其实是你和它,都被长度拖住了。 还有一个很少被提的成本:时间和钱。材料越长,处理越慢,按量计费的产品也越贵。而你为那 60 页无关内容付的钱,可能一点作用都没有。 知道原因之后,改法其实很朴素:不是喂得更多,而是喂得更准。 第一步,先说任务,再说材料。 顺序别反。开头就写清楚:我要做什么判断、给谁看、要多长、不要什么。材料放在后面。 第二步,先给一张地图。 如果必须整篇给它,就先给目录或者各级小标题的清单,再问「按结构,哪三部分和这个问题相关」。让它先定位,再读细节。 第三步,只贴相关段落,但保留标题和页码。 截图粘贴也行,但一定带着「第三章第三条」这样的位置信息。文本的结构本身会影响它的判断,光秃秃一段话,它不知道自己在哪。 第四步,把「找不到就说找不到」写进开头,并要求它回引原文。 比如:请指出结论来自哪一节;如果材料里没有,直接说没有。 这一条的作用不只是防编,更重要的是给你一个可核对的锚点。你能翻回去看见,才敢用。 第五步,分轮,不要一次问完。 第一轮:定位(哪几段相关)。第二轮:分析(这几段说了什么、矛盾在哪)。第三轮:输出(按格式写成你要的东西)。 三轮下来,每轮的输入都更短,注意力更集中,你也更容易发现它在哪一步跑偏。 错误一,整本扔进去,然后问一个宏观问题。 「帮我总结这份材料的重点」。这类问题没有判据,它只能给你一段谁都能写的总结。 错误二,一次问八个问题。 问题越多,每个问题分到的注意力越少。这不是玄学,是稀释。 错误三,把要求埋在最后。 格式要求、禁止事项、输出长度,全写在几十页材料之后。写在前面的指令,效果通常好得多。 错误四,用「你觉得怎么样」这类没有判据的问法。 换成「这一条和第三条有没有冲突」「这个数字在文中出现过几次,分别是多少」——有明确答案的问题,它才不容易糊。 如果你只想做一件事,就做这个自检:同一份材料,先整篇问一遍,再只贴三段问一遍,把两个答案并排放。 如果后者更具体、引用更准、编得更少,那就不是模型不行,是喂法不对。 还有一个更快的测法:挑一句你确定在文中出现过的话,问它「这份材料里有没有提到这句话」。它说没有,就说明它已经漏了中间。 回到开头那个反常识的现象:为什么只贴三页,答得反而比贴八十页更好。 因为那三页是「相关的那三页」。你把无关的七十多页拿走之后,剩下的每一句,都在它的注意力范围内。 所以这件事的本质,不是模型笨,而是我们对「窗口」的理解错了一位。 窗口是能力上限,不是使用建议。就像一个人能一次搬五十斤,你也不该每次都给他五十斤,然后怪他走得慢。 三条边界,收个尾。 第一,能塞进去,不等于该塞进去。宣传上的「支持百万字」,解决的是「能不能」,不是「准不准」。 第二,少给材料不是偷懒,是把注意力还给关键那几句。你替它做的筛选,往往比它自己找更可靠。 第三,你能核对的答案,才是能用的答案。一份说不出出处的结论,无论多流畅,都还只是草稿。 下次再想把整份文件丢进去时,先做一件很小的事: 把那三页标出来。 剩下的交给它,可能反而更接近你想得到的那个答案。
01先把三个词分清:窗口、有效长度、注意力
02第一个原因:中间那一段,最容易被忽略