ARTICLE · 1386649
AI 读不懂你公司的文档,问题出在第一步
AI 读不懂你公司的文档,问题出在第一步前两篇我们讲了两件事:企业直接用大模型有四个痛点,而“先查资料再回答”是对症的药。 但 RAG 不是一句话,它是两条链路:一条把公司的文档变成“可查的东西”,一条把你的问题变成“带出处的答案”。 这一篇只讲第一条——入库。它是整件事里最不性感、却最决定上限的一段。 一个比喻先放在这里:医院要上 AI 读片,决定成败的不只是医生有多聪明,还有片子拍得清不清楚。片子糊了,谁来读都一样。 ▍环节一:解析——垃圾进,垃圾出 公司里的资料,格式比想象中更乱:Word 制度、PDF 扫描件、Excel 台账、PPT 汇报、网页、工单、邮件,还有群聊里的截图。 解析这一步要做的,是把这些奇形怪状的文件,变成干净的文本和结构。 常见的翻车点非常具体:双栏排版被读成串行、表格被拍平成一段流水账、页眉页脚混进正文、图片里的字全部丢失、扫描件没做 OCR。 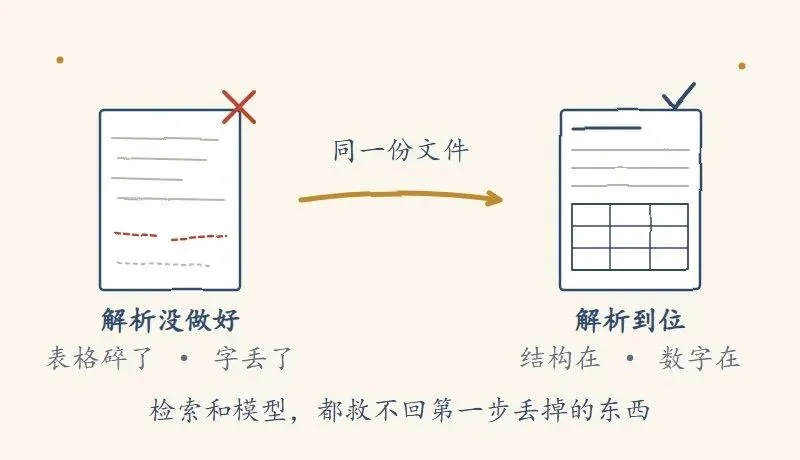
这里有一条几乎适用于所有链路的规律:解析阶段丢掉的数字,检索阶段找不回来。 所以表格最好转成保留结构的形式,图里的文字要单独提取,扫描件必须过一遍 OCR。 顺带说一个判断标准:如果一份文档解析出来,连人都读不懂它的表格,那问题不在模型,在第一步。 现在这条路也多了一个选项:用视觉模型直接读版面,对扫描件和复杂表格更友好,代价是更慢、更贵。两种路线混用很常见——规整文档走解析器,乱七八糟的走视觉模型。 实操建议也很简单:先拿公司最典型、最脏的十份文档试解析,看还原度,再决定要不要扩大接入范围。十份就够暴露问题,不需要等全库倒完。 ▍环节二:清洗与元数据——标签比正文更值钱 清洗是体力活:去水印、合并被跨页切断的段落、统一编码。 真正决定后续能力的是元数据:每段文字除了内容,还要带上“我是谁”。 常见的字段是:来源系统、部门、作者、创建和更新时间、版本号、密级、文档类型。 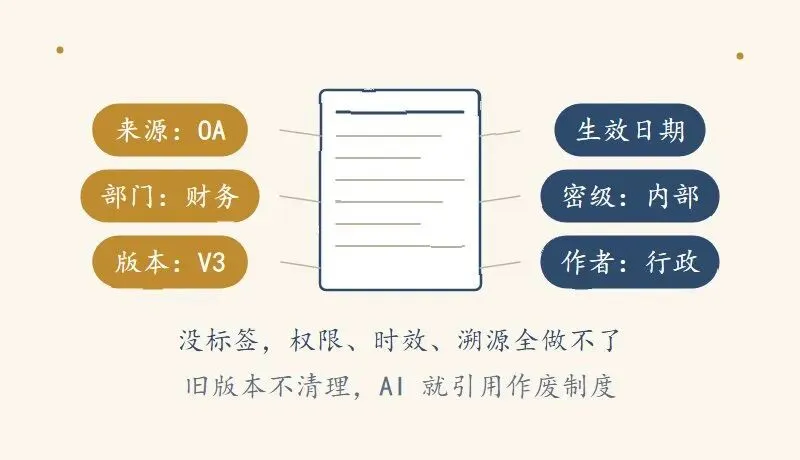
为什么重要?因为没有元数据,后面三件事全都做不了:权限过滤、时效过滤、答案溯源。 换句话说,元数据不是给检索加分的,是给检索划边界、留证据的。 它还有个隐藏用途:让你能回答“这条结论是从哪份文件来的”——这是企业场景里建立信任的起点。 更要紧的是,权限过滤的抓手几乎全在元数据上。“只让财务看财务制度”这句话,落到实现层面,就是每条记录带着部门标签去检索。 还有一个更隐蔽的坑:旧版本没清理。同一份制度改了三次,库里留着三个版本,AI 会一本正经地引用那份已经作废的。 这种错误比“查不到”更危险:查不到你会察觉,引用了作废制度,你可能不会。 ▍环节三:切分——最影响效果的一步 文档不能整篇塞进索引,得切成小块,检索才有合适的粒度。 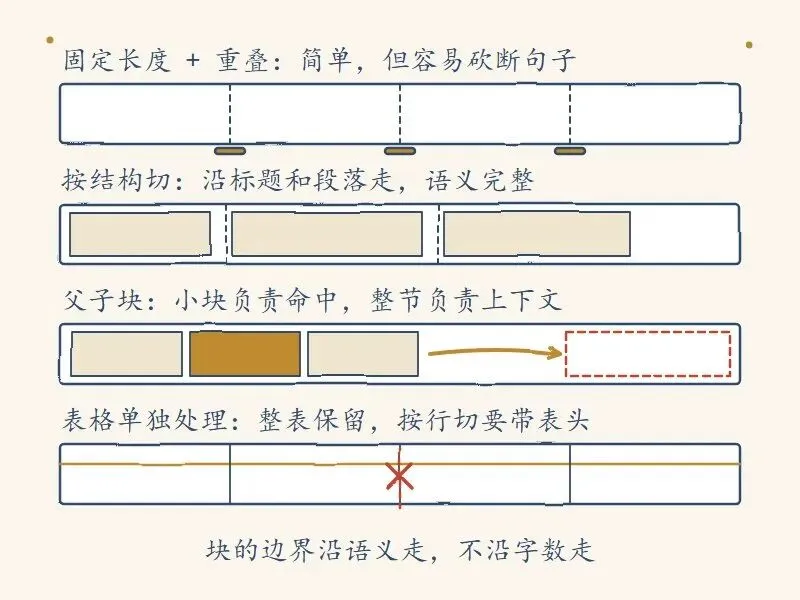
四种主流切法各有取舍。 固定长度加重叠:实现最简单,但容易把一句话拦腰砍断;前后各留一点重叠能缓解,代价是块之间内容重复。 按结构切:沿着标题层级、段落、列表走,语义最完整,企业文档通常首选。 父子块:用小块去做检索,命中更准;命中之后带出它所在的整节,上下文更全,两头都占。 表格单独处理:能整表保留就别硬切;必须按行切的时候,每一行都要带上表头,否则数字失去含义。 块要多大?常见做法是几百 token 一块,但没有标准答案:制度长文切太碎会丢上下文,FAQ 切太粗会把无关问答混进来,只能按文档类型实测调。 块的边界应该沿着语义走,而不是沿着字数走。 切分还有一层容易被忽略:每块最好带上它所在的章节路径。“第三章第五条”这几个字,往往就是让一段孤立文字重新变得可理解的东西。 ▍环节四:向量化——把文字变成一串坐标 嵌入模型把文字编码成一串数字,语义越接近,数字越接近。 有了它,“找相关资料”就变成了数学上的“找最近的邻居”。 选型要看四件事:中文效果、最大输入长度、向量维度、能不能本地部署。 有一条铁律:入库和查询必须用同一个模型。不同模型产生的向量不在同一个空间里,换模型等于全库重刷——这是很多人第一次做 RAG 时踩到的成本陷阱。 另外要提醒一句:语义相近不等于相关。“报销标准”和“报销流程”在向量空间里离得很近,但你要的可能只是其中一个——这也是为什么后面还需要重排那一步。 成本上倒是有个好消息:向量化是入库时算一次,之后每次提问只需要给那一句话算向量。这就是 RAG 比“每次把全部文档塞进提示词”便宜得多的原因。 入库前还有个动作值得做:先把语料的语言分布看清楚。中英混排的技术文档,和纯中文的制度文件,合适的嵌入模型经常不是同一个。 ▍环节五:索引与增量更新——别只建一种索引 存储层的选择很多:小规模用 PostgreSQL 的 pgvector 扩展就够,规模上来再考虑 Milvus、Qdrant、Weaviate、Elasticsearch 这类专用引擎或带向量能力的检索系统。 但比选型更重要的一条是:别只建向量索引。 型号、编号、错误码、合同号这类精确匹配,语义检索经常翻不到,关键词索引(BM25 这类)反而是刚需。两路都建、结果融合,是目前的主流做法。 还有一种容易漏的:文档进去了,图没进去。图纸、流程图、照片里的信息,如果没走多模态提取,就等于没入库。 然后是增量更新:源系统改了文档,索引要跟着变;文档被删除,向量必须同步删掉。 这条最容易被忽略,后果也最持久——库里残留的旧知识不会报错,只会安静地答错。 也别把“全量重建”当成默认手段。文档一改就全库重跑,规模小的时候无所谓,规模大了就是自我折磨。先想清楚增量方案,再谈上线。 ▍五个环节串起来 文档 → 解析 → 清洗与元数据 → 切分 → 向量化 → 索引,这就是入库链路的全貌。 每个环节都会把错误往下传,所以排查问题要倒着来:先看检索有没有把材料取回来,再怪模型答得不好。 一句话总结这一篇:入库不是“上传”,是把资料变成能被检索的形态。 这五个环节里,最常被跳过的恰好是第二个和第五个:元数据嫌麻烦,增量更新嫌琐碎。而线上答错的问题追溯到最后,往往就落在这两处。 ▍写在最后 如果你的公司正在考虑上知识库,建议的顺序是:先挑一个部门、一套高质量文档,把解析和切分这两步做扎实,跑通最小闭环。 而不是先花两周搭基础设施,最后发现文档本身根本没法用。 如果你只有两周时间,别去调检索策略:先把十份最脏的文档解析干净、把版本治理做对,收益比调参大得多。 效果上限由数据质量决定——而数据质量,就藏在这五个环节里。 口径与参考:本文为原理科普,正文不含统计与量化数据。“几百 token 一块”“小规模用 pgvector 就够”等为常见实践的定性表述,需按自身文档类型实测调整,不构成基准结论;文中提及的 pgvector、Milvus、Qdrant、Weaviate、Elasticsearch、BM25 均为公开技术组件,仅作类型举例,不构成选型推荐,相关名称与定位已于 2026-11-20 联网核对。概念出处:RAG 见 Lewis P. 等《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,NeurIPS 2020(arXiv:2005.11401),该文献于 2026-11-18 联网核对。