 夜雨聆风
港科广×AI2Robotics提出SOMA:赋予VLA机器人"空间记忆",视野外操控成功率大幅提升
「空间记忆、视野外操控、VLA模型」
让机器人听懂指令并完成任务,是具身智能的核心目标之一。然而,当前绝大多数VLA(Vision-Language-Action)模型都隐含一个前提假设——任务相关物体必须始终在视野范围内。当目标移出摄像头视场时,模型缺乏推断其位置的能力,导致任务失败。
针对这一核心痛点,港科广(HKUST-GZ)× AI2Robotics团队提出了SOMA(Spatial Memory for Out-of-Vision Manipulation)—— 一套面向视野外(OOV)操控的空间记忆VLA框架。
该框架通过空间记忆构建、动态记忆精炼、上下文记忆检索三大核心模块,赋予机器人持续的空间感知能力,即使在目标不可见时也能完成精准操控。
在实验中,SOMA在RoboCasa GR-1基准上达到49.3%平均成功率,超越GR00T-N1.5(46.0%)和Diffusion Policy(39.2%)。更重要的是,团队在真实世界部署了5项视野外操控任务,验证了该框架的实用价值。
1 — 行业痛点:VLA模型的"视野盲区"瓶颈
第一大瓶颈:视野依赖的感知-行动闭环
现有VLA模型通常基于大规模预训练的多模态大语言模型(MLLM),将视觉观测和语言指令编码后直接预测机器人动作。这种架构隐含假设:任务相关物体始终可见。
当目标物体暂时被遮挡或移出视野时,模型缺乏对场景持久表示的能力,感知-行动闭环变得严格依赖当前视图——看不见 = 无法行动。
图| 现有VLA模型的视野外(OOV)局限。机器人仅依赖当前视图进行反应式感知,当目标移出视野时,感知无法支撑操控,导致任务失败。
第二大瓶颈:空间推理的脆弱性
近期工作尝试通过静态摄像头配置下的内部空间推理来弥补视野外感知。然而,这种推理本质上很脆弱——当目标完全脱离可观测视场时,空间估计迅速恶化。
当推断关系偏离物理现实时,误差会沿感知-行动管道传播,导致定位不准、动作错位或任务失败。
第三大瓶颈:缺乏持久场景记忆
现有VLA范式的一个根本局限在于:仅靠空间推理而缺乏实际感知证据是不够的。当物体从未被观察或过去观测未被保留时,增加模型容量或推理深度都无法补偿缺失的感知基础。
要解决这个问题,需要能够获取超出当前视野的空间证据并将其保留在持久场景表示中的机制。
2 — 核心突破:SOMA三大模块构建空间记忆框架
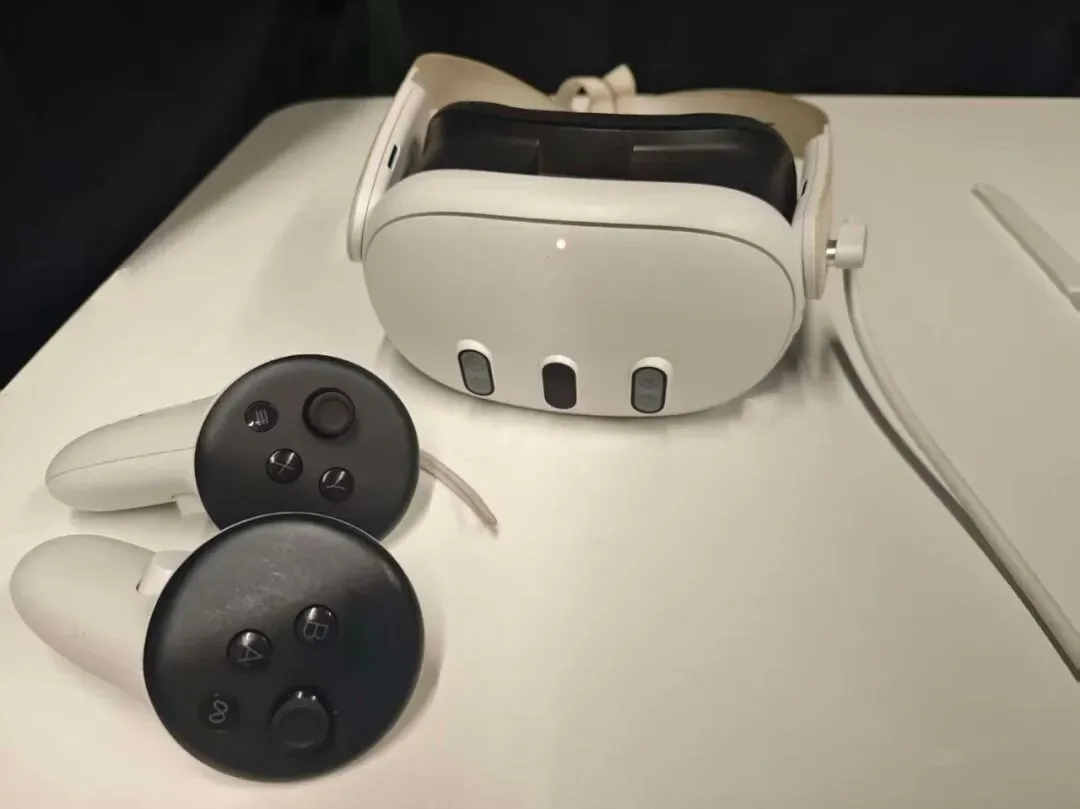
SOMA的核心创新在于将感知建模为以记忆为中心的过程,通过三大模块实现视野外操控:
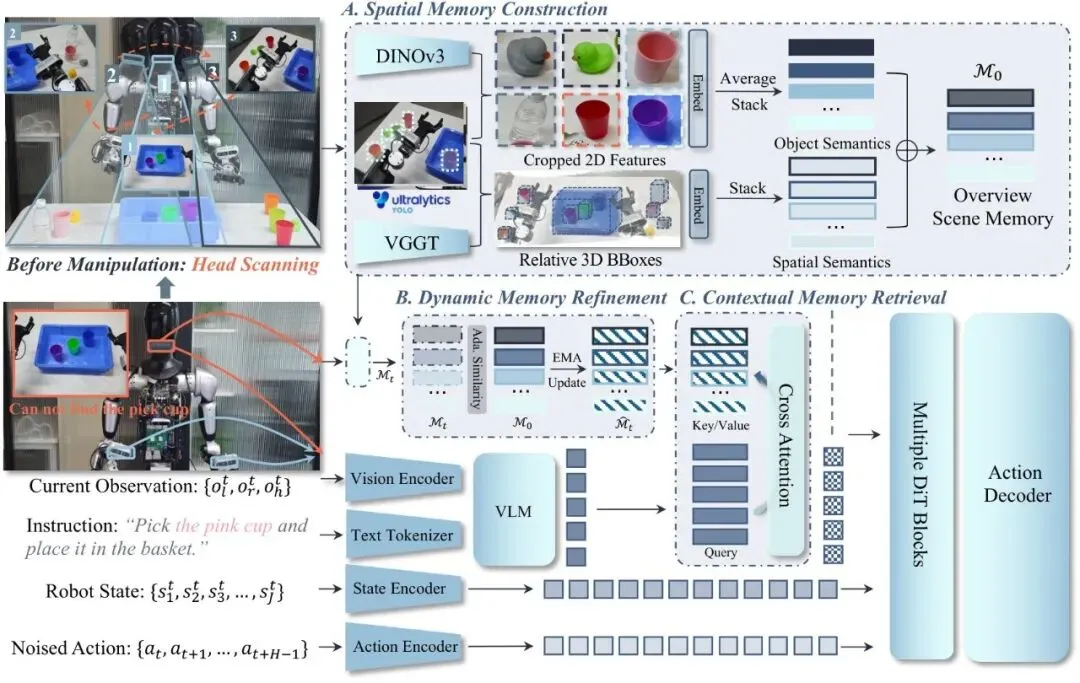
图| SOMA系统整体架构。框架包含三大核心模块:A.空间记忆构建(通过扫描聚合多视角观测)、B.动态记忆精炼(维护全局一致性)、C.上下文记忆检索(激活指令相关的空间线索)。
2.1 空间记忆构建(Spatial Memory Construction)
核心思路:通过可移动的头部摄像头获取工作空间的多样化视角,将角度级观测聚合成统一的空间-语义表示。
| 组件 | 功能 | 技术要点 |
|---|---|---|
| DINOv3 | 语义特征编码 | 提取2D图像的语义特征 |
| VGGT | 几何估计 | 预测相对3D边界框 |
| 实例融合 | 多帧聚合 | 将多帧观测融合为全局场景记忆 M0 |
在操作前的扫描阶段,机器人头部摄像头环顾工作空间,捕获多视角观测。系统提取每帧的语义特征(DINOv3)和几何信息(VGGT 3D边界框),通过实例关联和相似性感知融合,构建初始全局记忆。
2.2 动态记忆精炼(Dynamic Memory Refinement)
核心思路:在操作过程中持续更新记忆,在场景变化和观测更新之间保持平衡。
该模块使用自适应相似度评分和动态融合权重:
- 对每个观测到的实例,计算其与记忆中对应实例的相似度
- 基于相似度计算动态融合权重
- 使用EMA(指数移动平均)策略更新记忆状态
这种设计确保记忆在微小视角变化下保持稳定,但对真实场景更新保持响应。
2.3 上下文记忆检索(Contextual Memory Retrieval)
核心思路:在推理阶段,根据当前指令和视觉观测,从记忆中检索最相关的空间线索。
该模块包含:
- Memory-VLM对齐MLP:将记忆token投影到VLM特征空间
- 记忆-token Transformer:3层自注意力Transformer,执行记忆与VLM token的跨模态交互
- 输出:记忆增强特征 X_boost,作为DiT动作预测器的条件
3 — 实验验证:仿真与真实世界双重验证
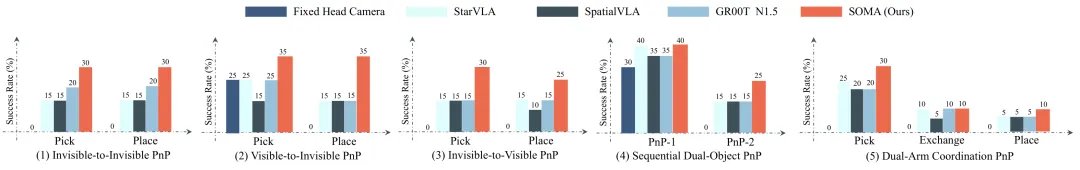
图| 5类视野外操控任务的对比结果。SOMA(红色)在所有任务中均超越基线方法(StarVLA、SpatialVLA、GR00T N1.5)。
3.1 RoboCasa Tabletop GR-1基准测试
RoboCasa GR-1基准包含30项桌面重排任务,由GR-1人形机器人(配备傅利叶灵巧手)执行,强调多样化桌面设置下的手-臂协调。
核心结果(Full Data设置):
| 方法 | 平均成功率 |
|---|---|
| Diffusion Policy | 39.2% |
| GR00T-N1.5 | 46.0% |
| SOMA (Ours) | 49.3% |
样本效率优势:
- SOMA仅用30条演示即达到48.3%成功率,超越GR00T-N1.5使用完整数据集(46.0%)
- Container Interaction任务:SOMA 55.7% vs GR00T-N1.5 40.3%
任务类别表现(完整数据):
| 任务类别 | SOMA | GR00T-N1.5 | Diffusion Policy |
|---|---|---|---|
| Container Interaction | 55.7% | 40.3% | 54.3% |
| Cooking Preparation | 46.4% | 49.2% | 35.3% |
| Tabletop Serving | 47.5% | 39.5% | 28.4% |
| Dish Transfer | 49.5% | 50.0% | 39.0% |
| Tray Organization | 47.6% | 50.8% | 39.2% |
3.2 消融实验
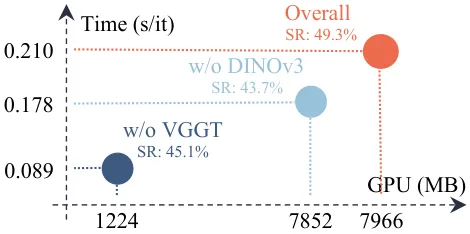
图| 消融实验:GPU内存占用 vs 推理时间 vs 成功率。完整SOMA达到49.3% SR,移除VGGT(几何线索)导致-4.2%性能下降,移除DINOv3(语义编码)导致-5.6%性能下降。
| 消融维度 | 配置 | 平均SR |
|---|---|---|
| 基线(完整SOMA) | - | 49.3% |
| 无VGGT(几何线索) | w/o VGGT | 45.1% |
| 无DINOv3(语义编码) | w/o DINOv3 | 43.7% |
| 无记忆更新 | NoUpd | 41.5% |
| 纯对象语义 | Obj. only | 33.3% |
| 纯几何线索 | Geo. only | 37.5% |
关键发现:
- 几何建模是主要计算开销但必不可少(移除VGGT:-4.2% SR,GPU降至1224MB)
- 语义编码对维持空间-语义一致性至关重要(移除DINOv3:-5.6% SR)
- 动态记忆更新对动态环境必不可少(无更新:41.5%)
3.3 真实世界视野外操控验证
团队在真实世界设计了5项视野外(OOV)操控任务,包括多步和双臂协调场景:
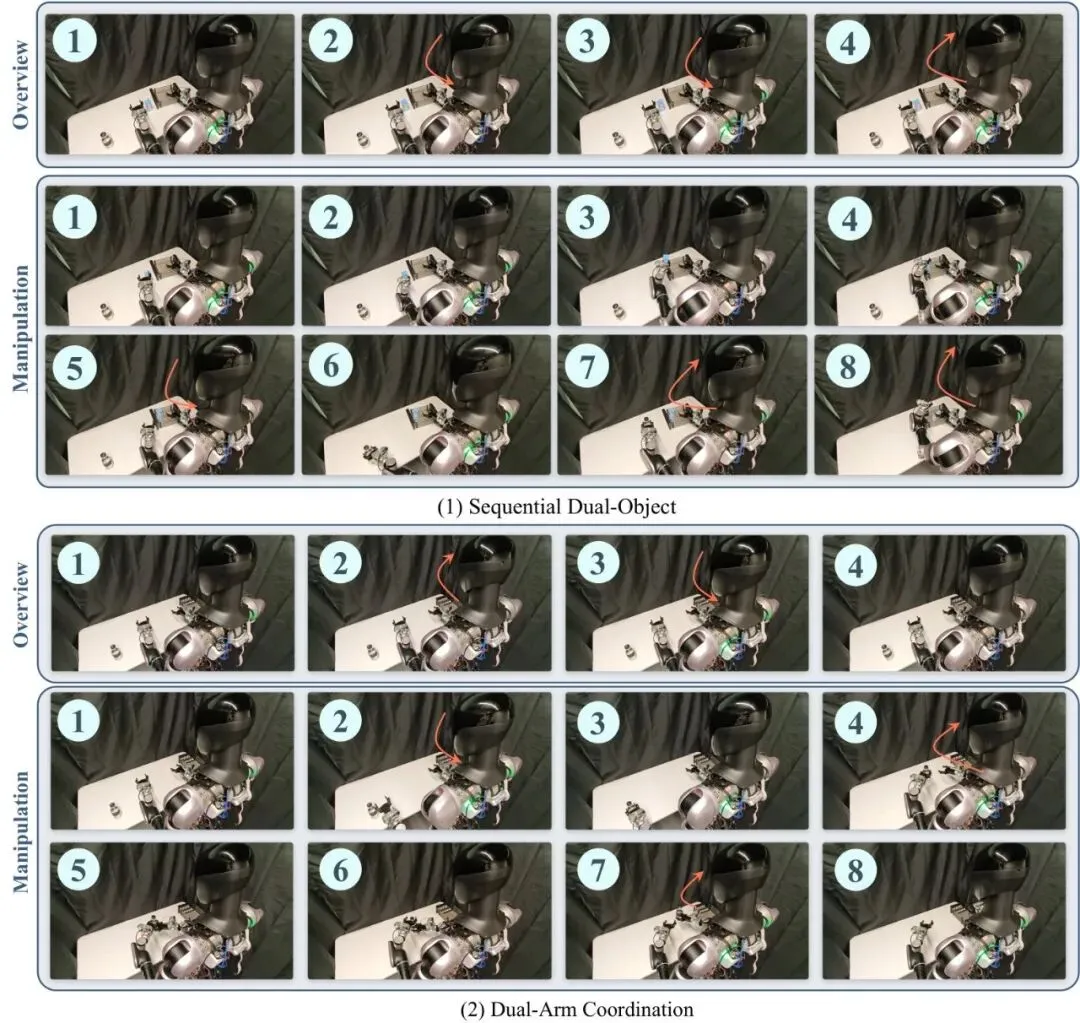
图| 真实世界执行示例。(1) 顺序双物体PnP任务;(2) 双臂协调PnP任务。展示了SOMA在真实场景下的视野外操控能力。
任务类别:
- Invisible-to-Invisible PnP:源容器和目标容器均不可见
- Visible-to-Invisible PnP:源可见,目标不可见
- Invisible-to-Visible PnP:源不可见,目标可见
- Sequential Dual-Object PnP:顺序处理两个视野外物体
- Dual-Arm Coordination PnP:双臂协调的视野外操控
关键指标:
| 指标 | SOMA表现 |
|---|---|
| 头部视角修正次数 | 更少(更快目标定位) |
| 抓取尝试次数 | 接近1次(近单次抓取) |
| 抓取耗时 | 更短(更高执行效率) |
定性观察表明,SOMA不仅提高了任务成功率,还引发了质的不同操控行为:更快目标定位、减少视角搜索、在部分可观测下近单次抓取。
3.4 推理延迟评估
| 方法 | 推理延迟(s/chunk) |
|---|---|
| StarVLA | ~1.26 |
| GR00T-N1.5 | ~1.30 |
| SpatialVLA | ~1.45 |
| SOMA | ~1.58 |
尽管引入了额外的空间记忆建模和几何感知感知模块,SOMA的推理速度与现有VLA基线相当,保持在同一数量级。
4 — 局限与未来方向
现存局限(来自论文原文):
| 局限 | 具体问题 |
|---|---|
| ① 动态场景适应性 | 依赖准静态扫描和全局固定阈值,对完全动态场景、嘈杂自运动和密集杂乱的适应性有限 |
| ② 语义粒度 | 记忆精炼目前仅在对象级别(位置和外观)操作,无法区分语义上有意义的状态转换(如抽屉开/关) |
| ③ 安全与隐私 | 持久空间记忆在人机共享环境中可能带来物理安全风险,以及隐私和潜在滥用问题 |
失败模式分析(真实世界25次失败):
- 不准确抓取姿态(48%):头部摄像头移动期间视觉搜索导致抓取估计退化
- 放置时机与精度错误(32%):记忆引导导航期间的释放时机误判
- 头-臂协调(20%):头部运动与手臂动作协调不足
未来方向:
- 实时跟踪、基于置信度的重扫描、学习匹配标准
- 显式阶段转换信号增强空间token,支持多阶段任务
- 层次化记忆结构、回环检测、SLAM-based对齐以扩展至移动操控和房间级环境
- 置信度评分、重扫描触发、记忆过期、设备端存储、人在回路确认
论文与资源:
论文信息:
- 📄 论文标题:Spatial Memory for Out-of-Vision Manipulation in Vision-Language-Action
- 👥 作者:Pengteng Li, Weiyu Guo, He Zhang, Tiefu Cai, Xiao He, Yandong Guo, Hui Xiong
- 📎 论文地址:[arXiv](https://arxiv.org/abs/2605.22283)
- 📚 会议:ICML 2026(国际机器学习顶会)
- 💻 代码地址:即将开源(Code will be released soon)
- 🏫 单位:港科广(HKUST-GZ)× AI2Robotics × HKUST
💬 今日互动:你认为空间记忆技术会如何改变未来的机器人交互方式?欢迎在评论区聊聊~
如果觉得有启发,点个「在看」,让更多人看到前沿科技的力量 ✨
— 完 —