 夜雨聆风
做运维这些年,缓存这玩意儿我算是玩出花来了。Memcached 这东西,装起来确实快,yum/apt 一条命令的事儿,启动之后就能用。但很多兄弟装完之后,默认配置直接跑,内存给个 64MB、连接数 1024、还绑在 0.0.0.0 上 —— 这不等于给全网留了个后门吗?
今天这篇文章,我把 Memcached 从安装配置、Python 客户端接入、生产环境调优到故障排查的完整流程给你讲透。所有配置和命令都来自 memcached 1.6 官方文档和多年实战经验,直接复制就能上生产。咱们不讲虚的,只讲能用的。
一、安装与启动:先把服务跑起来
Memcached 在主流 Linux 发行版上都有现成的包,不需要自己编译。不管你是 RHEL/CentOS/AlmaLinux 还是 Ubuntu/Debian,包管理器一条命令搞定。
1.1 安装
# RHEL/CentOS/AlmaLinux 9
yum install -y memcached
# Or on Debian/Ubuntu:
apt-get install -y memcached libmemcached-tools
安装完成后,Memcached 会自动创建一个 memcached 系统用户,以非 root 身份运行,这是安全最佳实践。
1.2 配置
配置文件的位置因发行版而异。RHEL 系在 /etc/sysconfig/memcached,Debian 系在 /etc/memcached.conf。
RHEL/CentOS 系:
# /etc/sysconfig/memcached (RHEL系)
PORT="11211"
USER="memcached"
MAXCONN="4096"
CACHESIZE="2048"
OPTIONS="-l 0.0.0.0"
Debian/Ubuntu 系:
# /etc/memcached.conf (Debian系)
-d
-m 2048
-p 11211
-u memcache
-l 0.0.0.0
-c 4096
-t 8
几个关键参数的含义:
PORT/-p:监听端口,默认 11211
CACHESIZE/-m:分配给缓存的内存(MB),默认 64MB,生产环境至少给 1024MB 以上
MAXCONN/-c:最大并发连接数,默认 1024,生产环境建议 4096 或更高
OPTIONS/-l:监听地址,默认 0.0.0.0(所有网卡),生产环境建议绑内网 IP
-t:工作线程数,默认 4,建议设为 CPU 核心数
-U:UDP 端口,设为 0 表示禁用 UDP(生产环境建议禁用)
1.3 启动与验证
# Start and enable memcached service
systemctl enable --now memcached
# Verify service is running
systemctl status memcached
# Quick connectivity test
echo "stats" | nc -q 1 localhost 11211 | head -5
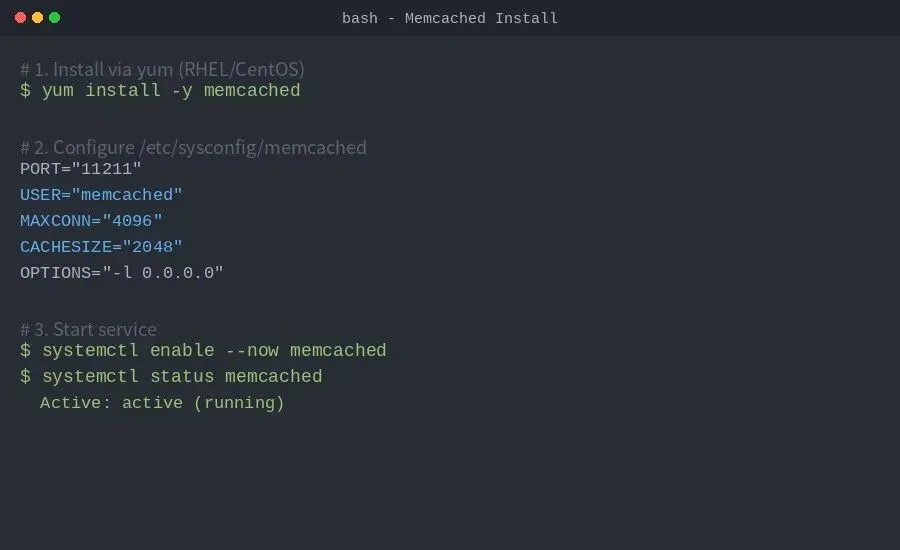
Memcached 安装与启动验证
二、详细使用指南:从命令行到代码
Memcached 的协议极其简单,就是一组基于 ASCII 的命令:set、get、delete、incr、decr。但它没有列表功能、不支持持久化、不能做复杂查询。简单归简单,速度快是真的快,单机轻松扛几十万 QPS。
2.1 命令行工具
先装客户端工具包,里面自带了好几个实用的 CLI 工具:
# Install python3-memcached (pure Python client)
pip install python-memcached
# OR install pymemcache (recommended, better performance)
pip install pymemcache
# OR install libmemcached (C client + CLI tools)
yum install -y libmemcached
libmemcached 自带的几个工具,日常运维特别好用:
# Install libmemcached tools (RHEL系)
yum install -y libmemcached
# memcp - store data
echo "hello memcached" | memcp --servers=127.0.0.1:11211 mykey
# memcat - retrieve data
memcat --servers=127.0.0.1:11211 mykey
# memstat - server stats
memstat --servers=127.0.0.1:11211
# memdump - dump all keys
memdump --servers=127.0.0.1:11211
2.2 Python 客户端接入
实际项目里肯定不会用命令行操作缓存,都是通过代码接入。Python 这边有两个主流库:
python-memcached:纯 Python 实现,API 简单,社区广
pymemcache(推荐):Twitter 出品,性能更好,支持连接池,API 更接近原生协议
推荐用 pymemcache,性能更好。下面是基本用法:
from pymemcache.client.base import Client
client = Client(('192.168.1.10', 11211))
# Store a value (key, value, expire_time)
client.set('user:1001', '{"name":"张三","age":30}', expire=300)
# Retrieve
result = client.get('user:1001')
print(result)
# Delete
client.delete('user:1001')
# Batch set (mget/mset)
client.set_many({
'user:1002': '{"name":"李四","age":25}',
'user:1003': '{"name":"王五","age":28}'
}, expire=300)
# Batch get
results = client.get_many(['user:1002', 'user:1003'])
2.3 集群模式(客户端分片)
Memcached 本身不支持集群,所谓的"集群"是客户端做的 key 分布。多个 Memcached 节点之间互不通信,客户端根据 key 的 hash 值决定存到哪个节点上。
from pymemcache.client.hash import HashClient
client = HashClient([
'192.168.1.10:11211',
'192.168.1.11:11211',
'192.168.1.12:11211',
])
# Keys are automatically distributed across nodes
client.set('session:abc', 'data') # goes to one node
client.get('session:abc') # reads from same node
这种架构的优点是简单、扩展方便,加节点就行。缺点也很明显:某个节点挂了,它上面的数据就丢了,不会自动迁移。所以 Memcached 适合存"丢了也不心疼"的数据,比如 Session、页面缓存、验证码等。重要数据别往里面放。
三、生产环境优化:让缓存跑得更快更稳
默认配置跑测试可以,上生产就得调。这部分是真正考验运维功力的地方。
3.1 内存规划
CACHESIZE 是最核心的参数。给少了缓存频繁淘汰,命中率上不去;给多了系统内存紧张,触发 swap,性能直接雪崩。
经验公式:CACHESIZE = 总 RAM × 60% ~ 70%
比如 16GB 的机器,给 10240MB ~ 11264MB(约 10~11GB),剩下的留给系统和应用
千万不要让 Memcached 的内存占用超过物理 RAM,一旦开始 swap,延迟直接从亚毫秒跳到几十毫秒
3.2 连接数调优
MAXCONN 决定了能同时接受多少个客户端连接。生产环境默认 1024 绝对不够。但也不是越大越好,每个连接会占用少量内存。
经验值:MAXCONN = 应用服务器数 × 每台服务器连接池大小 × 1.5(冗余系数)
比如有 10 台应用服务器,每台连接池 200,那就是 10 × 200 × 1.5 = 3000,取 4096 或 8192
3.3 线程数配置
-t 参数控制工作线程数。Memcached 是多线程架构,每个线程处理一部分客户端请求。默认 4 个线程,在现代多核机器上完全浪费了。
建议设为 CPU 核心数,8 核机器就 -t 8,16 核就 -t 16
注意:线程数不是越多越好。过多的线程反而会加剧锁竞争,降低性能
3.4 LRU 优化(1.6.x 新特性)
Memcached 1.6.x 引入了一些重要的 LRU(Least Recently Used)优化选项,生产环境强烈建议开启:
lru_maintainer:独立的 LRU 维护线程,不再阻塞请求线程做淘汰
lru_crawler:后台定时扫描过期键并释放内存
slab_automove:自动在 slab class 之间迁移空闲页,解决"某个尺寸的数据特别多导致其他 slab 浪费"的问题
开启方式:
# /etc/sysconfig/memcached — Production config
PORT="11211"
USER="memcached"
MAXCONN="8192"
CACHESIZE="4096"
OPTIONS="-l 192.168.1.10 -U 0 -t 8"
或者通过 systemd override 的方式:
# /etc/systemd/system/memcached.service.d/override.conf
[Service]
ExecStart=
ExecStart=/usr/bin/memcached \
-u ${USER} \
-p ${PORT} \
-m ${CACHESIZE} \
-c ${MAXCONN} \
-o lru_maintainer,lru_crawler,slab_automove \
${OPTIONS}
# Reload systemd and restart
systemctl daemon-reload
systemctl restart memcached
3.5 系统级优化
3.5.1 文件描述符限制
每个 TCP 连接都要消耗一个文件描述符。如果 MAXCONN 设得很大但系统 ulimit 不够大,Memcached 会无法接受新连接。
# /etc/security/limits.d/99-memcached.conf
memcached soft nofile 1048576
memcached hard nofile 1048576
memcached soft nproc 65535
memcached hard nproc 65535
3.5.2 TCP 参数调优
高并发场景下,TCP 参数也要跟着调:
# /etc/sysctl.d/99-memcached.conf
# Increase max open files
fs.file-max = 1048576
# Optimize TCP buffer sizes
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216
net.core.rmem_default = 4194304
net.core.wmem_default = 4194304
# Apply changes
sysctl -p /etc/sysctl.d/99-memcached.conf
3.5.3 关闭 THP(透明大页)
透明大页(Transparent Huge Pages)会导致 Memcached 出现延迟毛刺。生产环境建议关闭:
# Disable THP on RHEL/CentOS
echo never > /sys/kernel/mm/transparent_hugepage/enabled
echo never > /sys/kernel/mm/transparent_hugepage/defrag
# Add to /etc/rc.d/rc.local for persistence
if test -f /sys/kernel/mm/transparent_hugepage/enabled; then
echo never > /sys/kernel/mm/transparent_hugepage/enabled
fi
3.5.4 生产级完整配置清单
# Production /etc/sysconfig/memcached
PORT="11211"
USER="memcached"
MAXCONN="8192"
CACHESIZE="4096"
OPTIONS="-l 192.168.1.10 -U 0 -t 8 \
-o lru_maintainer,lru_crawler,slab_automove \
-o slab_reassign,slab_automove_freereserve"
四、安全加固:别让缓存变漏勺
Memcached 没有任何内置认证机制。任何能连上 11211 端口的客户端都可以 get、set、甚至 flush_all 清空所有数据。这就是为什么 2018 年那场 memcached DDoS 攻击能搞出 1.35 Tbps 的流量 —— 全网裸奔的 memcached 服务器被人拿来做了反射放大器。
4.1 网络隔离(最重要)
Memcached 的安全,核心就一句话:不要让公网能访问 11211 端口。做好网络隔离比什么都重要。
# Listen on localhost and private IP only
OPTIONS="-l 127.0.0.1,192.168.1.10"
# Or use firewall rules
firewall-cmd --permanent --add-rich-rule='
rule family="ipv4"
source address="192.168.1.0/24"
port protocol="tcp" port="11211" accept'
firewall-cmd --reload
4.2 防火墙白名单
# Install iptables (if not present)
yum install -y iptables-services
# Allow only app servers to access port 11211
iptables -A INPUT -p tcp -s 192.168.1.0/24 --dport 11211 -j ACCEPT
iptables -A INPUT -p tcp --dport 11211 -j DROP
# Save rules
iptables-save > /etc/sysconfig/iptables
systemctl enable iptables
4.3 禁用 UDP(防范反射攻击)
2018 年的 DDoS 攻击就是通过 UDP 反射放大的。生产环境直接禁用 UDP:
在 OPTIONS 中加上 -U 0,或者直接不设 -U 参数。确认一下:
ss -ulnp | grep 11211 —— 没有输出就说明 UDP 已经禁用了。
4.4 SASL 认证(可选)
如果你的 Memcached 必须暴露在不太可信的网络里(比如和第三方应用共用 VLAN),可以考虑启用 SASL 认证:
# Install SASL support
yum install -y cyrus-sasl-plain cyrus-sasl cyrus-sasl-devel
# Create SASL password file
saslpasswd2 -a memcached -c cache_user
Password: ********
# Make SASL config readable by memcached user
chown memcached:memcached /etc/sasldb2
chmod 400 /etc/sasldb2
# Add -S flag to OPTIONS in /etc/sysconfig/memcached
OPTIONS="-l 192.168.1.10 -S -t 8"
# Restart memcached
systemctl restart memcached
注意:启用 SASL 会带来约 5%~10% 的性能开销。如果网络已经做了严格隔离,就不需要开 SASL。
五、监控与状态分析:掌握缓存的健康状况
Memcached 提供了一个极其丰富的 stats 命令,通过 telnet 或 nc 就能看。这是排查所有问题的第一手资料。
5.1 基础 stats 解读
$ echo "stats" | nc localhost 11211
STAT pid 12345
STAT uptime 86400
STAT time 1704067200
STAT version 1.6.29
STAT curr_items 45678
STAT total_items 892156
STAT bytes 2147483648
STAT curr_connections 2048
STAT total_connections 5678901
STAT cmd_get 15432876
STAT cmd_set 8921567
STAT get_hits 13876543 # Cache hit count
STAT get_misses 1556333 # Cache miss count
STAT evictions 0 # 0 = no memory pressure
STAT bytes_read 987654321
STAT bytes_written 123456789
STAT limit_maxbytes 4294967296 # Total memory limit
END
其中最关键的几个指标:
get_hits / cmd_get:缓存命中率,生产环境建议在 85% 以上
evictions:因内存不足被淘汰的键数量。如果这个数字持续增长,说明内存不够用了
curr_connections:当前连接数,接近 MAXCONN 说明要扩容了
bytes / limit_maxbytes:已用内存 vs 总内存限制
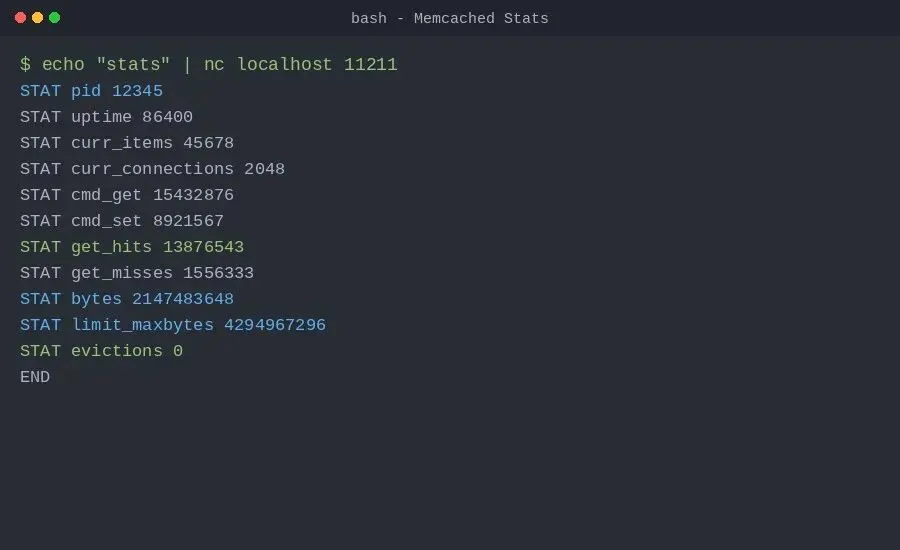
Memcached 核心指标解读
5.2 计算命中率
# Calculate hit rate
echo "stats" | nc localhost 11211 | awk '/get_hits/{h=$2} /cmd_get/{g=$2} END{printf "Hit Rate: %.2f%%\n", (h/g)*100}'
# Hit Rate: 89.92%
命中率低于 80% 就得警惕了。常见原因:TTL 设得太短、缓存策略不合理、热点数据没做预热。
5.3 Slab 分配分析
$ echo "stats slabs" | nc localhost 11211
STAT 1:chunk_size 80
STAT 1:chunks_per_page 13107
STAT 1:total_pages 1
STAT 1:total_chunks 13107
STAT 1:used_chunks 8234
STAT 1:free_chunks 4873
...
STAT active_slabs 12
STAT total_malloced 4294967296
END
Memcached 的内存被分成多个 slab class,每个 class 管理固定大小的 chunk。如果你的数据大部分是 100 字节左右,但 slab class 1 的 chunk_size 是 80 字节,那这些数据就会被塞到 class 2(比如 100 字节),而 class 1 的内存就浪费了。
可以通过 -f 参数调整 slab growth factor(默认 1.25),让 class 之间的间隔更细密或更粗犷。
5.4 Items 统计
$ echo "stats items" | nc localhost 11211
STAT items:1:number 8234
STAT items:1:age 86400
STAT items:1:evicted 0
STAT items:1:evicted_nonzero 0
STAT items:1:evicted_time 0
STAT items:1:outofmemory 0
STAT items:1:tailrepairs 0
...
END
items 统计能告诉你每个 slab class 里有多少有效数据、淘汰了多少、有没有 OOM 事件。如果某个 class 的 evicted 数字很大,说明这个尺寸的缓存占满了内存,需要针对性优化。
六、故障排查:生产环境常见坑和解决方案
这部分是我在生产环境里踩过的坑,总结出来的排查清单。遇到 Memcached 问题,按这个顺序过一遍,基本都能定位。
6.1 Memcached 进程没了(服务宕机)
# Check if memcached is running
systemctl status memcached
# Quick test
echo "version" | nc localhost 11211
# Check logs
journalctl -u memcached --since "1 hour ago"
# Check if port is listening
ss -tlnp | grep 11211
排查思路:
查看 systemd 日志:journalctl -u memcached
如果是 OOM Killer 杀掉的:dmesg | grep -i "killed process"
如果是配置文件有语法错误,启动就会失败,日志里会明确报错行
修复后重启:systemctl restart memcached
6.2 缓存命中率暴跌
命中率从 90% 掉到 50%,这是最常见也最影响业务的故障。
第一步:检查 evictions。如果 evictions 持续增长,说明内存满了在疯狂淘汰旧数据,解决方案是加大 CACHESIZE 或加节点
第二步:检查是不是有应用重启。应用重启会导致缓存全部失效(冷启动),命中率会短暂下降然后慢慢回升
第三步:检查 key 的 TTL 是否合理。如果 TTL 太短(比如 10 秒),大部分请求都会 miss
第四步:检查是否有新的缓存穿透。比如某个不存在的 key 被大量请求,每次都 miss 到数据库
# Check if evictions > 0 (memory full)
echo "stats" | nc localhost 11211 | grep evictions
STAT evictions 1234567
# If evictions > 0, cache memory is insufficient
# Solutions:
# 1. Increase CACHESIZE in /etc/sysconfig/memcached
# 2. Add more memcached nodes
# 3. Set appropriate TTL for keys
# 4. Enable slab_automove for dynamic slab rebalancing
6.3 连接数打满(Connection Refused)
# Check current connections vs limit
echo "stats" | nc localhost 11211 | grep connections
STAT curr_connections 4096
STAT total_connections 5678901
# If curr_connections approaches MAXCONN:
# 1. Increase MAXCONN in config
# 2. Enable connection pooling on client side
# 3. Use persistent connections instead of short-lived
# 4. Check for connection leaks in application code
临时方案:加大 MAXCONN,systemctl restart memcached
根本方案:检查应用侧是否没有用连接池,每次请求都新建连接。换成 pymemcache 的 PooledClient
# Enable persistent connections
client = Client(('192.168.1.10', 11211),
connect_timeout=1,
timeout=1,
no_delay=True,
keepalive=True)
# Use connection pooling
from pymemcache.client.base import PooledClient
client = PooledClient(('192.168.1.10', 11211),
max_pool_size=100)
6.4 内存分配不均(某些 slab 爆满,某些空闲)
这是 Memcached 的经典问题。不同大小的数据被分到不同 slab class,如果某个 class 的 chunk 用完了,即使其他 class 有大量空闲内存,也无法利用。
# Check slab distribution
echo "stats slabs" | nc localhost 11211
# Check for out-of-memory events
echo "stats items" | nc localhost 11211 | grep outofmemory
# Check slab class utilization
# If free_chunks is very low in a specific class,
# that class is the bottleneck
# Tune slab growth factor (default 1.25)
# Smaller factor = more granular but more overhead
# OPTIONS="-f 1.1" (in /etc/sysconfig/memcached)
6.5 系统级问题
6.5.1 Swap 导致性能雪崩
Memcached 是纯内存数据库,一旦出现 swap,延迟直接从亚毫秒跳到几十毫秒。排查方法:
# Check system memory pressure
free -h
vmstat 1 5
# Check if system is swapping
vmstat 1 3 | awk 'NR>3{print $7}'
# If swap usage > 0, memcached performance will degrade
# Fix: increase CACHESIZE, add RAM, or reduce MAXCONN
解决方案:减少 CACHESIZE(留出更多系统内存)、增加物理 RAM、或者在系统层面限制 swap(vm.swappiness=0)。
6.5.2 TIME_WAIT 堆积
# Monitor with sar (sysstat package)
sar -n TCP 1 10
# Check for TIME_WAIT accumulation
ss -s | grep TIME-WAIT
# If TIME_WAIT count is high, tune:
sysctl -w net.ipv4.tcp_tw_reuse=1
sysctl -w net.ipv4.ip_local_port_range="1024 65535"
总结一下
Memcached 这东西,上手容易但用好不简单。几个核心要点:
内存规划:CACHESIZE 占总 RAM 的 60~70%,永远不要让 Memcached 吃光内存
连接数:MAXCONN 要根据应用服务器数量 × 连接池大小来算,默认 1024 肯定不够
网络隔离:bindIp 绑内网 IP、禁 UDP、防火墙白名单,这三件事做了就不怕被攻击
LRU 优化:1.6.x 的 lru_maintainer、lru_crawler、slab_automove 一定要开
监控命中率:低于 80% 就要查原因,evictions 持续增长就是内存不够
数据性质:Memcached 适合存"丢了不心疼"的数据,重要数据用 Redis 或者数据库
下期我们聊聊 Redis 和 Memcached 的选型对比,以及什么时候该用 Redis 替代 Memcached。有问题评论区见。