当前时间: 2026-08-17 17:47:47
分类:办公文件
评论(0)
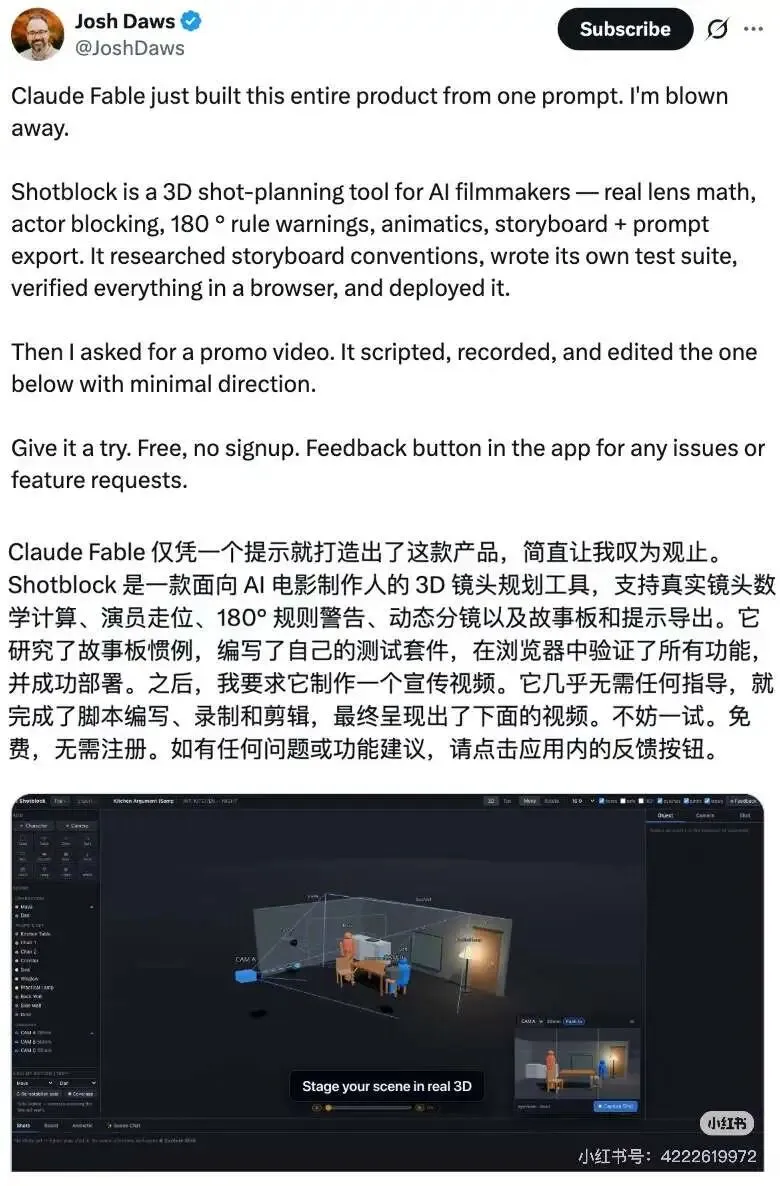
AI能一句话生成工具,普通人应该如何优化提问?AI 已经很会干活了,普通人应该如何让AI理解自己的需求?这两天改我小说的分镜剧本,最烦的不是剧情,是台词。Codex 已经很强,它能写,也能改,可对话总像少一点人味。Fable、Mythos最近非常火,似乎已经全能到一句话就能做出一个完整的工具。工具越来越强,执行越来越快,回到我把我的小说改成剧本这件事,那如何让AI 知道我说的"人味"具体指什么。skill的本质是把要做的事具像化,那么这个问题的本质就是如何把“人味”两个字具像化,在A I动笔前,如何让它能找到符合“人味”本质的资料,我觉得需要去设计工作流。我说"更有人味",AI 可能会去通用经验里找答案:口语一点,短一点,加点情绪词,加点梗。于是它给我一段看起来很顺的台词。可我要的不是这种顺。但我要的是我小说里的女主:八岁身体,成年人灵魂;前小摊主、厨子、社畜底色;务实,怕死但不软;遇事先算账,再找能不能吃、藏、挖、试、跑。她可以吐槽,但不能连续讲段子。她可以怕死,但不能软成小白花。她可以说现代话,但梗要从钱、摊位、做饭、保命这些处境里长出来。世界观信息也不能让她一口气讲完,要拆进追问、误会、动作失败和面板短句里。这时问题就从"怎么提示模型"变成了"怎么优化 AI 的搜索路径"。现在很多系统已经不是"提问,然后生成"这么短。更常见的做法是:先把资料拆开、编号、保留出处;再把文字向量化;用户提问后,系统先用关键词找显性线索,再用语义搜索找近义材料,找完还要重新排序,把最贴近这次任务的内容放到模型面前。复杂一点的系统,还会把人物、事件、地点、设定抽成关系图。模型最后输出的确实是一段文字,但前面已经跑了一次查资料。小说原文 → 拆成章节、场景、人物、设定 → 给每段编号,保留出处 → 向量化,放进可检索资料库 → 搜索相关原文和旧改稿规则 → 找出角色声纹、剧情禁忌、视觉连续性 → 再让 AI 写分镜和台词 → 最后审计有没有编错、有没有失去人味。这里有个词要拆一下:向量化,也叫 embedding。可以把它理解成给文字打坐标。人看到一句话,知道它在讲离职、赔偿、小说台词还是分镜节奏;机器一开始不知道。向量化就是把一段文字变成一串数字,让机器能计算两段话的意思近不近。比如"这句台词像作者解释设定""这句话不像真人临场反应""角色不该在紧张时完整复述世界观",字面不一样,但病根很接近。向量化以后,它们会落在相近区域。下次你问"这段对话为什么假",系统不只找包含"假"这个字的资料,还能找回"长句缺少临场反应""世界观要拆进追问和动作失败""梗不能连续堆"。相似度搜索解决的是找资料的问题。聚类解决的是看分布的问题。你把 500 条改稿意见放进去,系统可能会分出几堆:台词太长、设定说明太重、现代梗过密、角色声纹不稳、动作缺失、爽点没有铺垫。机器只负责分堆,名字还得人来取。可分出来以后,会知道自己最常犯的错在哪里。RAG,也就是检索增强生成,说白了就是回答前先翻资料夹。普通聊天像一个凭印象说话的人;RAG 会先翻你的资料,再开口。所以我以后不该只对 Codex 说:把这段写得更有人味。先检索本场小说原文和前后场;检索女主声纹卡;检索人味改稿规则;检索最近几次台词审计;检索已经验证好用的"原句 / 改后 / 为什么这样改"样例。最后审计:有没有改掉剧情事实;有没有让角色替作者讲设定;有没有超过 24 字还不拆句;有没有连续堆梗;有没有从"事实说明 → 事实说明 → 事实说明"变成"先愣一下 → 追问 → 得到信息 → 不服 → 补刀 → 立刻做事"。看,这里说的"人味"已经不是一个形容词了。它变成了一组可搜索、可检查、可迭代的东西。这也是 Fable、Mythos 这些工具给我的提醒。Anthropic 在 2026 年 6 月 9 日发布的 Fable 5,官方页面写得很清楚:它面向长任务、复杂代码和知识工作,可以在 agent harness 里规划阶段、分配子任务、检查自己的工作。Claude Code 的 dynamic workflows 更直白,能把大任务拆给大量并行 subagent,最后再合成一个结果。强执行者已经出现了。接下来的差距,会出在它执行之前搜到了什么。一句"帮我做个场景"太空。更好的系统会先查镜头规则、资产规范、材质样例、角色动作、上次失败记录,再让 AI 写脚本、摆镜头、生成模型、检查比例。小说转剧本只是一个更容易看懂的例子。写短视频,也可以把前三秒钩子、评论争议、节奏模板、违规边界做成资料库。很多人说普通人也能训练自己的小模型。我会把顺序放慢一点。先训练搜索,再谈训练模型。先把资料留下来。成功样例、失败样例、修改理由、读者反馈、审计结果,都不要散在聊天记录里。再把资料切开。每条资料要知道自己来自哪里,解决什么问题,适合什么场景。然后做检索。关键词负责找明确线索,向量负责找意思接近的线索,重排负责把最有用的几条放到前面。最后固定流程。小说转分镜剧本,就固定成:提取情节节点、检索原文、检索声纹、生成场景、写台词、做人味审计、按问题类型改稿、输出可替换版本。到这一步,你还没有微调模型参数,但已经拥有了一个小型个人系统。它知道你说的"好"大概长什么样,也知道你最讨厌哪些写法。AI 的能力越强,人越不能只剩一句"帮我做个好的"。这句话太空,模型只能去公共经验里找答案。你得把自己的"好"拆开。拆成资料,拆成样例,拆成规则,拆成审计表,拆成能被搜索召回的片段。以后我再说"让这段对话更有人味",我希望 AI 先去找:我以前到底把什么叫人味。
 夜雨聆风