第二章 一维随机变量及其分布
巩固练习
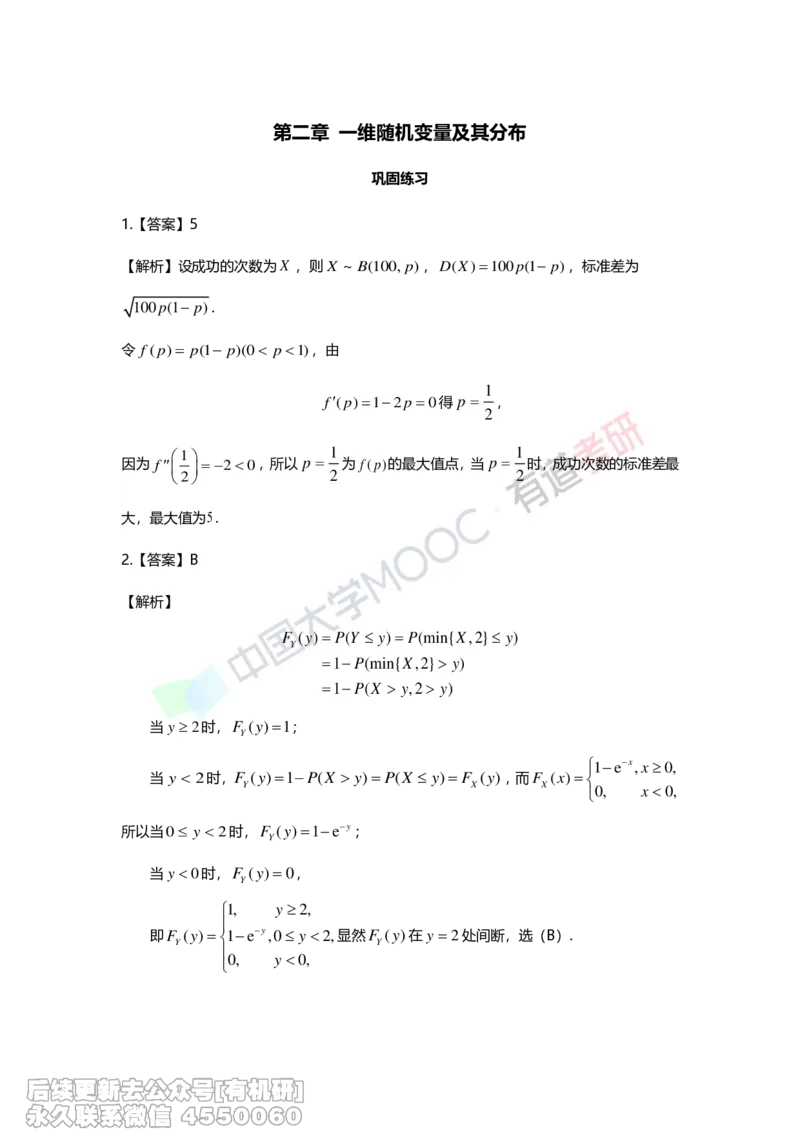
1.【答案】5
【解析】设成功的次数为 X ,则 X ~ B ( 1 0 0 , p ) , D ( X ) 1 0 0 p (1 p ) ,标准差为
100p(1 p).
令 f(p) p(1 p)(0 p1),由
f(p)12p 0得 p
1
2
,
因为 f
1
2
2 0 ,所以 p
1
2
为 f ( p ) 的最大值点,当 p
1
2
时,成功次数的标准差最
大,最大值为5.
2.【答案】B
【解析】
F (y) P(Y y) P(min{X,2} y)
Y
1P(min{X,2} y)
1P(X y,2 y)
当 y 2 时, F
Y
( y ) 1 ;
当 y 2时,F (y)1P(X y)P(X y)F (y),而
Y X
F
X
( x )
1
0
,
e x , x
x
0
0
,
,
所以当0 y 2时,F (y)1ey ;
Y
当 y 0时,F (y)0,
Y
1, y2,
即F (y)1ey,0 y2,显然F (y)在y 2处间断,选(B).
Y Y
0, y0,
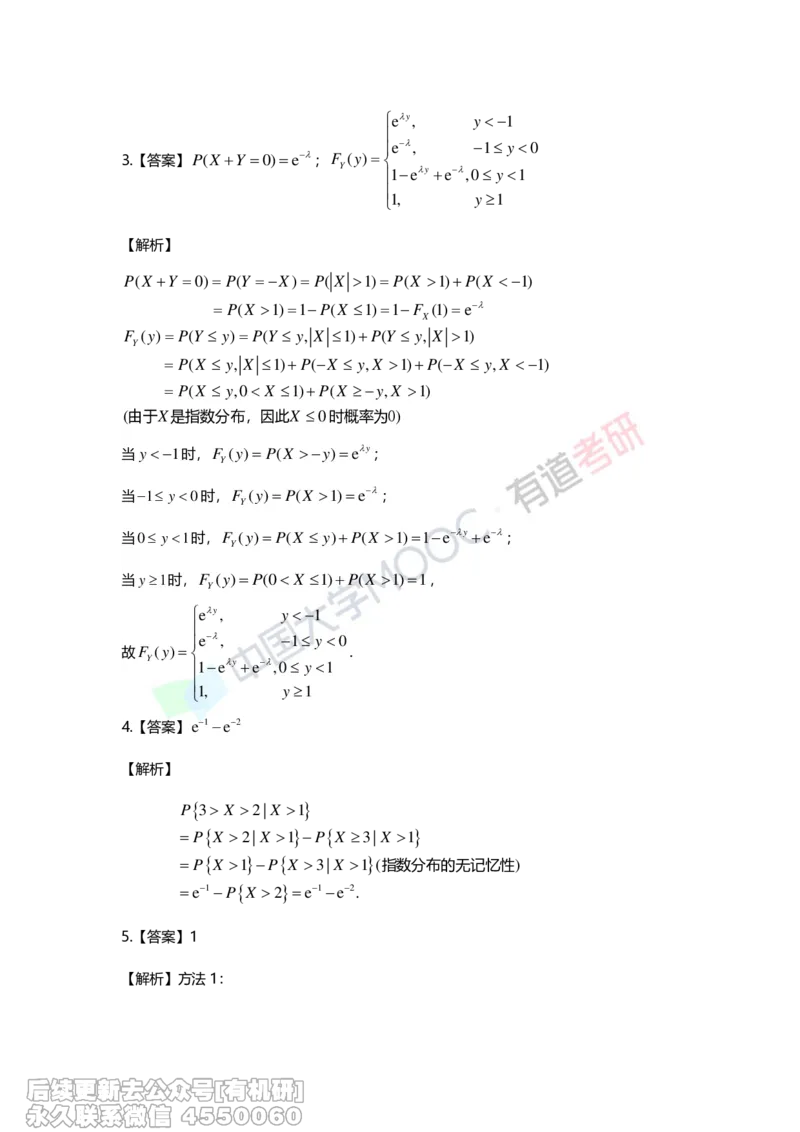
3.【答案】 P ( X Y 0 ) e
ey, y1
e, 1 y0
;F (y)
Y
1ey e,0 y1
1, y1
【解析】
P(X Y 0) P(Y X) P( X 1) P(X 1)P(X 1)
P(X 1)1P(X 1)1F (1)e
X
F (y) P(Y y) P(Y y, X 1)P(Y y, X 1)
Y
P(X y, X 1)P(X y,X 1)P(X y,X 1)
P(X y,0 X 1)P(X y,X 1)
(由于X是指数分布,因此X 0 时概率为0)
当y1时, F
Y
( y ) P ( X y ) e y ;
当1 y0时, F
Y
( y ) P ( X 1 ) e ;
当 0 y 1 时,F (y)P(X y)P(X 1)1ey e ;
Y
当y1时,F (y)P(0 X 1)P(X 1)1,
Y
ey, y1
e, 1 y0
故F (y) .
Y 1ey e,0 y1
1, y1
4.【答案】 e 1 e 2
【解析】
P3 X 2| X 1
PX 2| X 1PX 3| X 1
PX 1PX 3| X 1(指数分布的无记忆性)
e1PX 2e1e2.
5.【答案】1
【解析】方法1:F (
P
P
(
X
X
x )
x )
(
F
x
x
(
x
)
x
P
P
(
x
)
X
X
) [ 1
x
( x
x
)
] 1 .
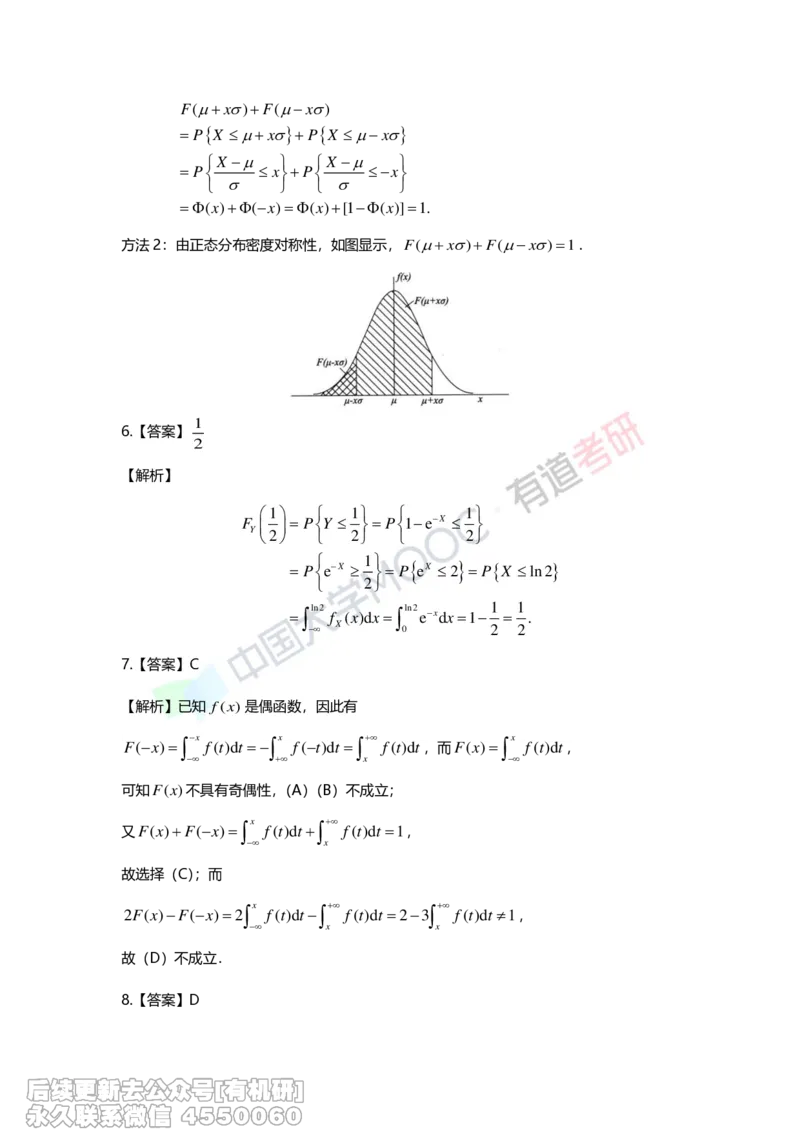
方法2:由正态分布密度对称性,如图显示, F ( x ) F ( x ) 1 .
6.【答案】
1
2
【解析】
1 1 1
F PY P1eX
Y 2 2 2
P eX 1 P eX 2 PX ln2
2
ln2 ln2 1 1
f (x)dx exdx1 .
X 0 2 2
7.【答案】C
【解析】已知 f ( x ) 是偶函数,因此有
F ( x )
x
f ( t ) d t
x
f ( t ) d t
x
f ( t ) d t ,而 F ( x )
x
f ( t ) d t ,
可知F(x)不具有奇偶性,(A)(B)不成立;
又 F ( x ) F ( x )
x
f ( t ) d t
x
f ( t ) d t 1 ,
故选择(C);而
x
2F(x)F(x)2 f(t)dt f(t)dt 23 f(t)dt 1,
x x
故(D)不成立.
8.【答案】D
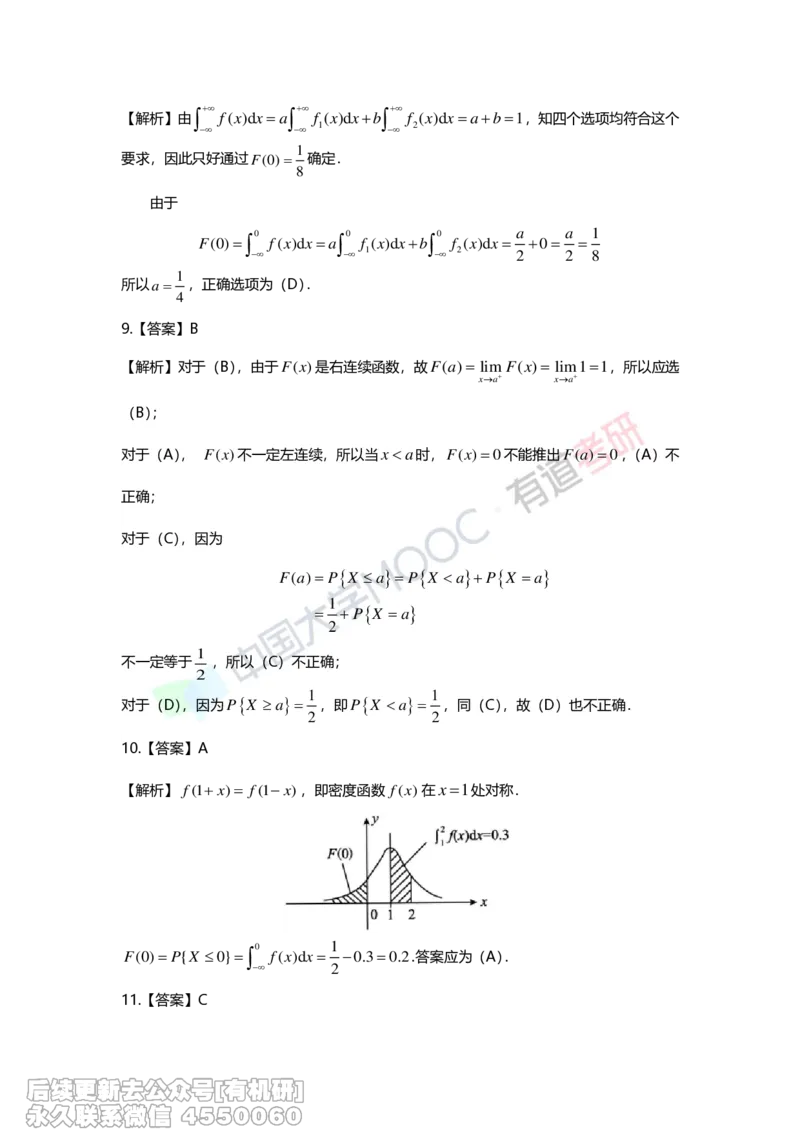
【解析】由 f(x)dxa f (x)dxb f (x)dxab1,知四个选项均符合这个
1 2
要求,因此只好通过 F ( 0 )
1
8
确定.
由于
0 0 0 a a 1
F(0) f(x)dxa f (x)dxb f (x)dx 0
1 2 2 2 8
所以 a
1
4
,正确选项为(D).
9.【答案】B
【解析】对于(B),由于 F ( x ) 是右连续函数,故 F ( a ) l i
x
m
a
F ( x ) l i
x
m
a
1 1 ,所以应选
(B);
对于(A), F ( x ) 不一定左连续,所以当 x a 时, F ( x ) 0 不能推出 F ( a ) 0 ,(A)不
正确;
对于(C),因为
F(a) PX a PX aPX a
1
PX a
2
不一定等于
1
2
,所以(C)不正确;
对于(D),因为 P X a
1
2
,即 P X a
1
2
,同(C),故(D)也不正确.
10.【答案】A
【解析】 f(1x) f(1x),即密度函数 f ( x ) 在 x 1 处对称.
F ( 0 ) P { X 0 }
0
f ( x ) d x
1
2
0 .3 0 .2 .答案应为(A).
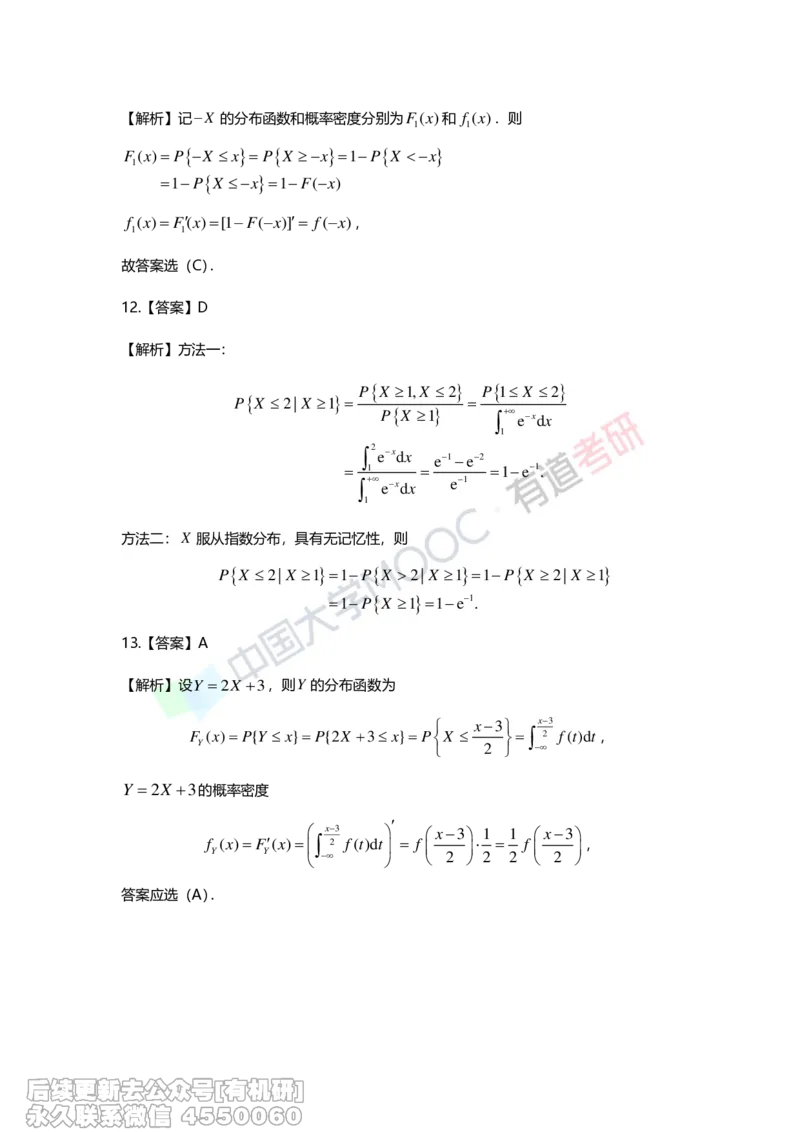
11.【答案】C【解析】记 X 的分布函数和概率密度分别为 F
1
( x ) 和 f
1
( x ) .则
F
1
( x )
P
1
P
X
X
x
x
P
X
1
F
(
x
x
)
1 P X x
f
1
( x ) F (
1
x ) [ 1 F ( x ) ] f ( x ) ,
故答案选(C).
12.【答案】D
【解析】方法一:
P X 2 | X 1
P
2
1
1
X
P
e
e
1
X
x d x
x d x
, X
1
e
2
1
e
e
1
P
2
1
1
1
e
X
e
x d
1 .
x
2
方法二: X 服从指数分布,具有无记忆性,则
PX 2| X 11PX 2| X 11PX 2| X 1
1PX 11e1.
13.【答案】A
【解析】设 Y 2 X 3 ,则 Y 的分布函数为
F
Y
( x ) P { Y x } P { 2 X 3 x } P
X
x
2
3
x 2
3
f ( t ) d t ,
Y 2 X 3 的概率密度
x3 x3 1 1 x3
f (x)F(x) 2 f(t)dt f f ,
Y Y 2 2 2 2
答案应选(A).综合测试
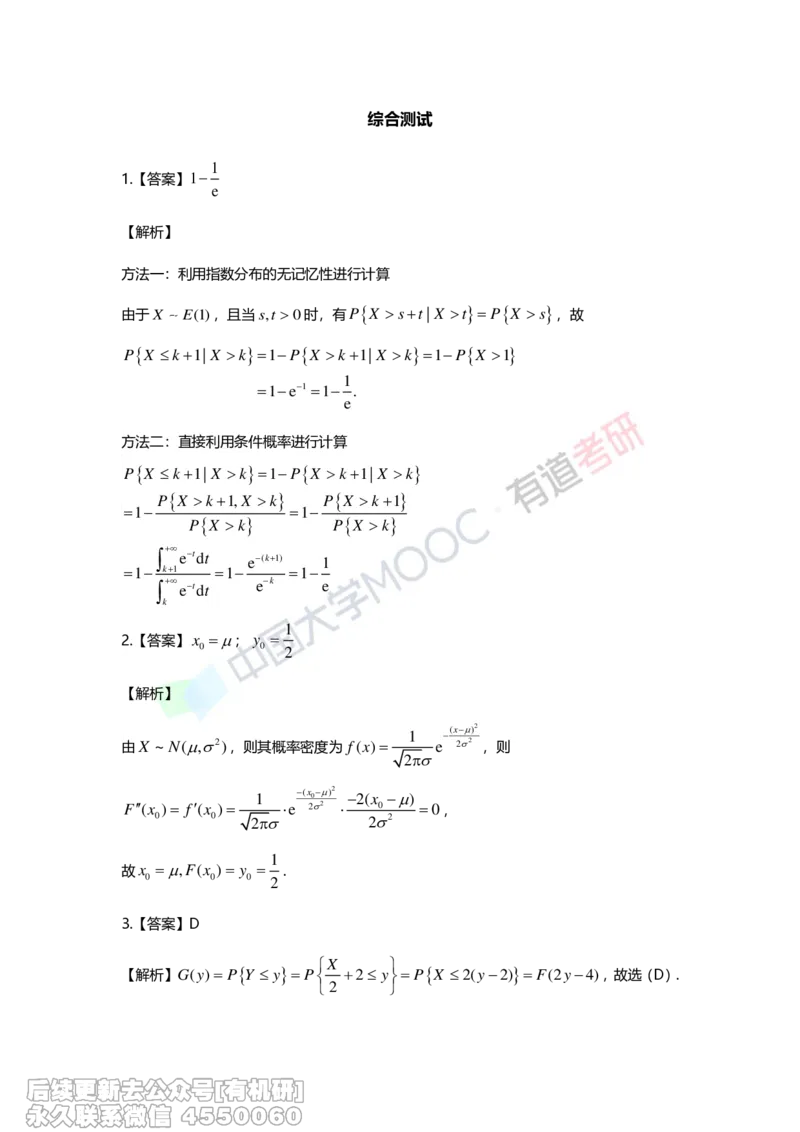
1
1.【答案】1
e
【解析】
方法一:利用指数分布的无记忆性进行计算
由于 X E ( 1 ) ,且当 s , t 0 时,有 P X s t | X t P X s ,故
PX k1| X k1PX k1| X k1PX 1
1
1e1 1 .
e
方法二:直接利用条件概率进行计算
P
1
1
X
k
P
k 1
k
X
e
e
1 | X
k
P X
td t
td t
1
1
k
, X
k
e
1
k
(k
k e
1 )
P
1
1
X
P
1
e
P
k
X
X
1
|
k
X
k
1
k
2.【答案】 x
0
; y
0
1
2
【解析】
由 X ~ N ( , 2 )
1
(x)2
,则其概率密度为 f(x) e 22 ,则
2
1 (x 0 )2 2(x )
F(x ) f(x ) e 22 0 0,
0 0 2 22
1
故x ,F(x ) y .
0 0 0 2
3.【答案】D
X
【解析】G(y) PY y P 2 y PX 2(y2) F(2y4),故选(D).
2 4.【答案】C
【解析】由
f ( x ) d x
(提 指 数 中 常 数 )
( ) 凑 正 态 分 布
C
C
C
C
e
e
e
e
2 x 2 x d
( x 1 e
1
x
2)
2
d x
1
C
1
2
e
e
( x
2
2 ( x 1 )
2 1 )
2 1
2 d
1
x
d x
1
得C ,故选(C).
e
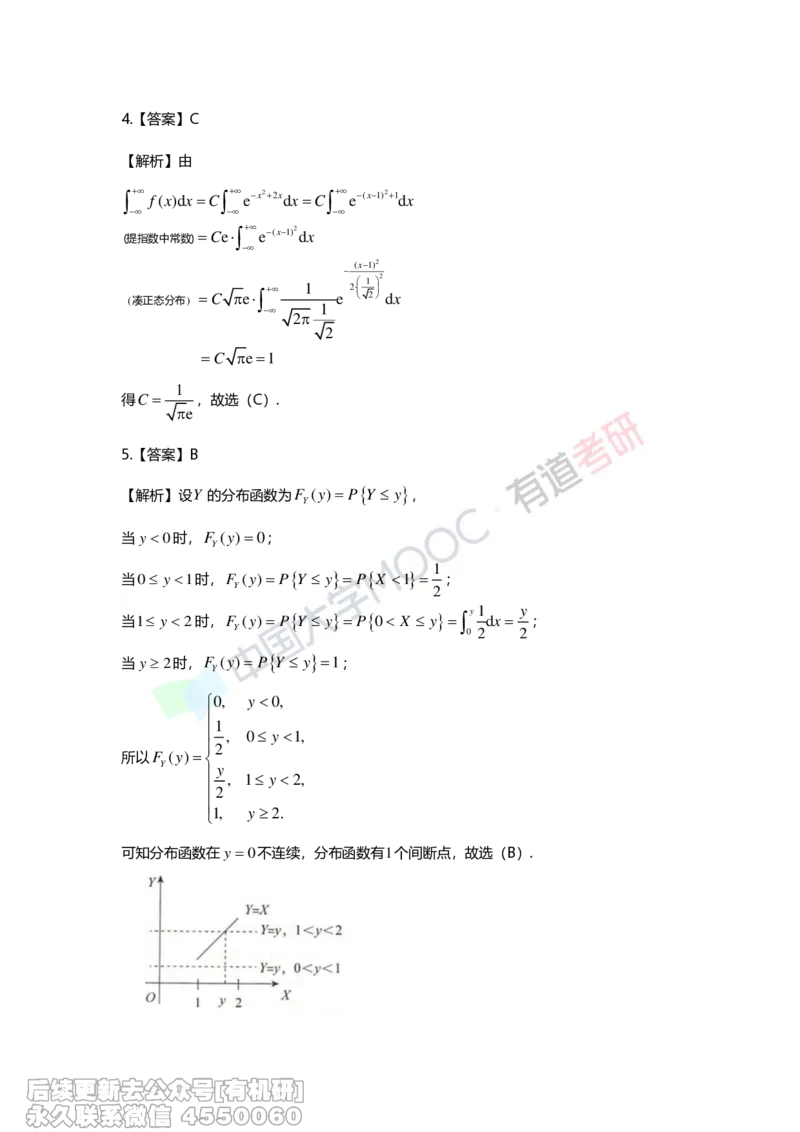
5.【答案】B
【解析】设Y 的分布函数为F (y) PY y ,
Y
当 y 0 时, F
Y
( y ) 0 ;
1
当0 y1时,F (y) PY y PX 1 ;
Y 2
y1 y
当1 y2时,F (y) PY y P0 X y dx ;
Y 0 2 2
当 y 2 时, F
Y
( y ) P Y y 1 ;
所以 F
Y
( y )
0 ,
1
2
y
2
1 ,
,
,
y
0
1
y
0
y
y
2
,
.
1
2
,
,
可知分布函数在y 0不连续,分布函数有 1 个间断点,故选(B).6.【答案】A
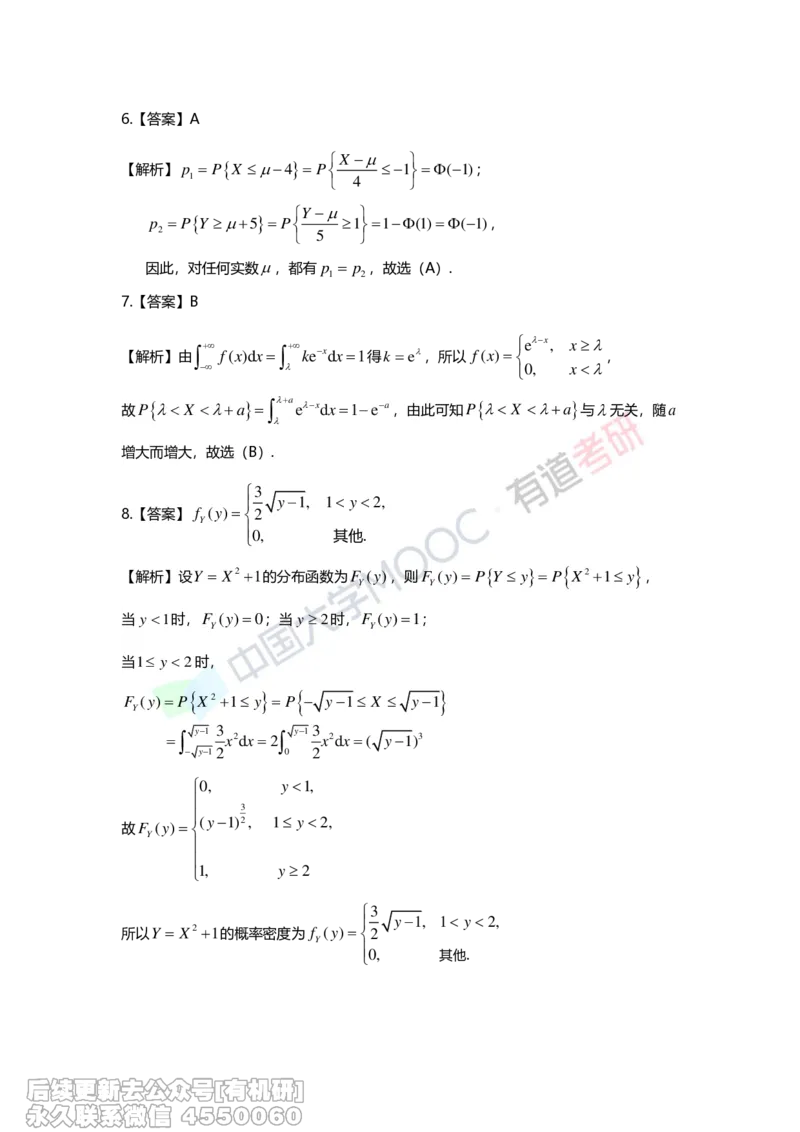
【解析】 p
1
P X 4 P
X
4
1 ( 1 )
;
p
2
P Y 5 P
Y
5
1 1 (1 ) ( 1 )
,
因此,对任何实数,都有 p
1
p
2
,故选(A).
7.【答案】B
【解析】由 f(x)dx kexdx1得
k e
ex, x
,所以 f(x) ,
0, x
故 P X a
a
e x d x 1 e a
,由此可知 P X a 与无关,随 a
增大而增大,故选(B).
3
y1, 1 y2,
8.【答案】 f (y)2
Y
0, 其他.
【解析】设 Y X 2 1 的分布函数为 F
Y
( y ) ,则F (y)PY y P X2 1 y ,
Y
当 y 1时, F
Y
( y ) 0 ;当 y 2 时,F (y)1;
Y
当1 y2时,
F (y) P X2 1 y P y1 X y1
Y
y1 3 y13
x2dx2 x2dx( y1)3
y12 0 2
0, y1,
3
(y1)2, 1 y2,
故F (y)
Y
1, y2
所以 Y X 2 1
3
y1, 1 y 2,
的概率密度为 f (y)2
Y
0, 其他.1 3
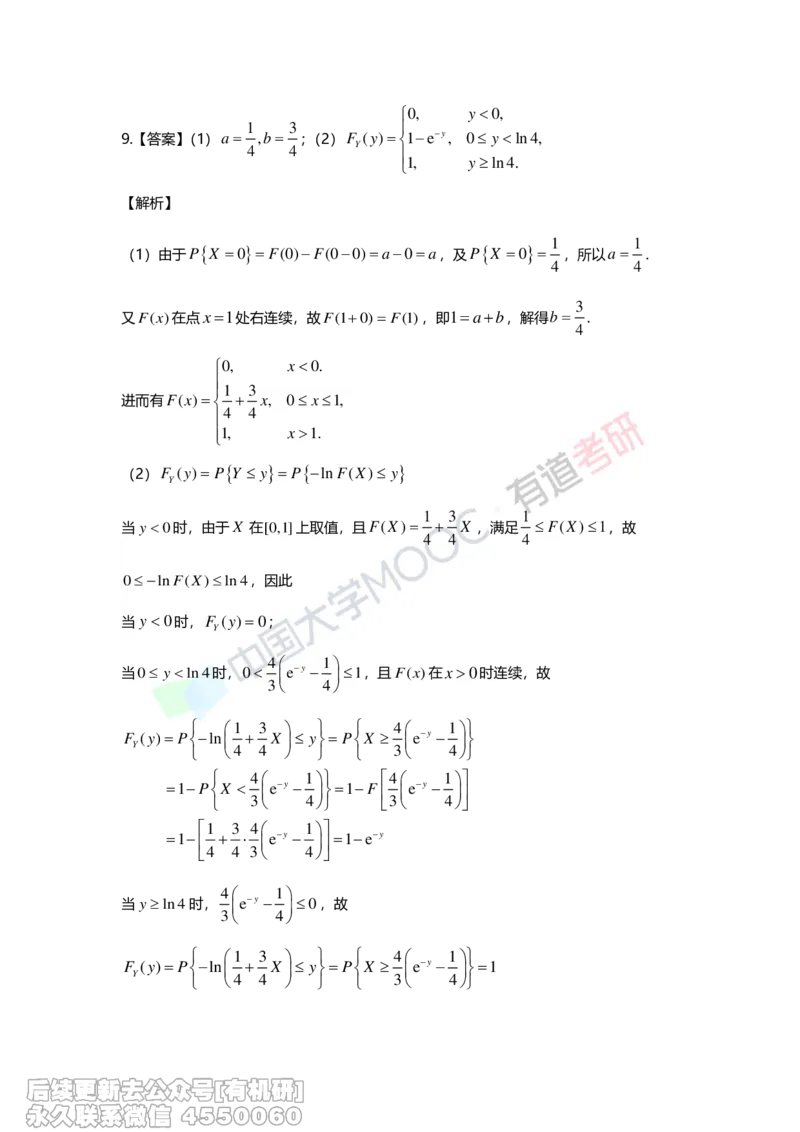
9.【答案】(1)a ,b ;(2)
4 4
F
Y
( y )
0
1
1
,
,
e y ,
y
0
y
0
y
l
,
n 4
l
.
n 4 ,
【解析】
(1)由于 P X 0 F ( 0 ) F ( 0 0 ) a 0 a
1 1
,及PX 0 ,所以a .
4 4
又 F ( x ) 在点 x 1 处右连续,故 F (1 0 ) F (1 ) ,即 1 a b ,解得 b
3
4
.
进而有 F ( x )
0 ,
1
4
1 ,
3
4
x ,
x
0
x
0
x
1
.
.
1 ,
(2) F
Y
( y ) P Y y P l n F ( X ) y
当 y 0 时,由于 X 在[0,1]上取值,且 F ( X )
1
4
3
4
X ,满足
1
4
F ( X ) 1 ,故
0 l n F ( X ) l n 4 ,因此
当 y 0 时, F
Y
( y ) 0 ;
当 0 y l n 4 时, 0
4
3
e y
1
4
1 ,且 F ( x ) 在x0时连续,故
F
Y
( y )
P
1
1
P
l n
1
4
X
1
4
3
4
4
3
4
3
3
4
X
e
e
y
y
y
1
4
1
4
P
1
1
X
F
e
y
4
3
4
3
e
e
y
y
1
4
1
4
当 y l n 4
4 1
时, ey 0,故
3 4
1 3 4 1
F (y)Pln
X
yPX
ey 1
Y 4 4 3 4综上可得 F
Y
( y )
0
1
1
,
,
e y ,
y
0
y
0
y
l
,
n 4
l
.
n 4 ,拓展提升
1.【答案】B
【解析】概率密度的充要条件为① f ( x ) 0 ,②
f ( x ) d x 1 .
(A) f ( 2 x ) 不可以作为概率密度,因为
f ( 2 x ) d x
1
2
f ( 2 x ) d 2 x
1
2
1 ;
(B) f ( 2 x ) 可以作为概率密度,因为 f ( 2 x ) 0 ,且
f ( 2 x ) d x
f ( 2 x ) d ( 2 x )
f ( t ) d t 1 ;
对(C)(D)容易举出反例,使
f 2 ( x ) d x 和
f ( x 2 ) d x 均不为 1 ,例如
f ( x )
1
20
,
, 0
其
x
他
2
可以作为概率密度,
1
, 0 x2
但 f 2(x)4 和
0, 其他
f ( x 2 )
1
20
,
, 2
其
x
他
2
显然都不可以作为概率密度;故
选(B).
2.【答案】C
【解析】 X 落入 ( , x
1
) , ( x
1
, x
2
) , ( x
2
, x
3
) , ( x
3
, x
4
) , ( x
4
, ) 的概率应为
7 24 38 24 7
, , , , ,即
100 100 100 100 100
0 .0 7 , 0 .2 4 , 0 .3 8 , 0 .2 4 , 0 .0 7 ;
P X x
4
1 P X x
4
1 0 .0 7 0 .9 3 (1 .5 ) ,
X 15
而X ~ N(15,4),所以 ~ N(0,1),
2
P X x
4
P
X
2
1 5
x
4
2
1 5
x
4
2
1 5
,
x 15
所以 4 1.5,解得x 18;
2 4
又PX x 1PX x 10.240.070.69(0.5)
3 3X 15 x 15 x 15
PX x P 3
3
3 2 2 2
得
x
3
2
1 5
0 .5 ,故 x
3
1 6 ;
由对称性 x
1
与x ,x 与x 都关于
4 2 3
x 1 5 对称,所以
x
1
1 5 ( x
4
1 5 ) 1 2 , x
2
1 5 ( x
3
1 5 ) 1 4 ,故选(C).
3.【答案】D
【解析】对于(1),是几何分布的无记忆性,正确.
几何分布的无记忆性证明如下:
P X m
代 入 几 何 分
约
分 子 分 母 等
布
去
比
P
n | X m
(
的 分 布 律
k n m 1
( 1
k m 1
( 1 p )
p 1 ( 1
( 1 p
级 数 求 和
1 ( 1
X
1
p
n m
p )
m )
p )
P
p
)
m
X
k 1 ) p
k 1 p
( 1
n
p
,
m
)
X
n
m
k
n
1
( 1
P
P
p
X
k )
X
1
m
p
m
n
P
X n
对于(3),是指数分布的无记忆性,正确.
指数分布的无记忆性证明如下:
P
e
X
e
(s
s
s
t)
t
e
| X
t
s
1
1
( 1
P
1
( 1
e
X
( 1
P
e
t )
e
s
X
(s
P
s
t , X
s
t) )
)
X t
s
P
P
X
X
s
s
+
s+
s
t
t
e
e
x
x
d
d
x
x
代
入 指
数
分
布
的 分
布
函 数
或
利 用 概
率 密 度 计
算
对于(2),P X 2 n | X n
P
1
1
1
1
1
1
X
P
1
1
1
1
1
1
1
2
X
2
1
n , X
n
1
2 3
1
2 2
1 1
2 2
1 1
2 2
1
2 n
1
n
n
3
1
3
1
3
1
2
P
X
P X
( 2 n
( n
2
n
n
1
1
1
1
1
1
2 n
n
) 2
) n
1
1
n
1
2 n
1
n
1
1
P
P
{
{
X
X
2
n
n
}
}
正确;
1 dx 1
对于(4),PX 2t| X t PX 2t,X t PX 2t 2t x2 x 2t 1 ,
PX t PX t 1 1 2
dx
t x2 x
t
正确,故选(D).
4.【答案】C
【解析】
若X 服从正态分布N(,2)(0),则 f ( x )
2
1
e
( x
2
2)2
, x R
,
故 f
m ax
f ( )
2
1
;
选项(A), f
1 m ax
( x )
1
2
1
1
;选项(B), f (x) 1;
2max
2 2
ex, x0
选项(C),X E(1)时,概率密度为 f (x) , f (x)1;
3 0, 其他 3max
1
, 1 x1 1
选项(D), X U(1,1)时,概率密度为 f (x)2 , f (x) 1;
4 4max 2
0, 其他故选(C).
5.【答案】B
【解析】
方法一:
F
Y
( y )
P
P
P
Y
X
2
X
y
X
P
y , X
X
y , X
0
X
0
P
y
y
P
X
0 ,
X
X
0
y , X 0
当 y 0 时,
F
Y
( y )
P
0
y
2
X
1
2
y
2
1
2
P
X
y
2
0
1
故PY 11F (1)1 ,选(B).
Y 2
方法二:
P
P
P
P
P
Y
X
2
X
X
1
X
X
1
1
2
1
2
P
,
,
X
X
X
1 ,
1
X
0
0
X
0
P
0
1
2
1
0
P
X
1 , X
X
0
1 , X 0
故选(B).
2
6.【答案】
3
【解析】
2 1 0
由EA 0 1 0 (1)(2)(Y)0,得矩阵
0 1 Y
A 的特征值为
1, 2, Y ;
1 2 3当Y 1,2时,矩阵 A 一定可以对角化;
当Y 1时, A
200 111 001
, 1 为二重特征值,因为 r ( E A ) 2 ,所以 A 不可对角
化;
当Y 2时, A
200 111 002
,2为二重特征值,因为 r ( 2 E A ) 1 ,所以 A 可对角
化;
故 A 可对角化的概率为 P ( Y 1 , 2 ) P ( Y 2 ) P ( Y 0 ) P ( Y 2 ) P ( Y 3 )
2
3
.
7.【答案】 e ; F
Y
( y )
e
e
1
1 ,
y ,
,
e
y
y e , 0
y
1
y
1
1
y
.
,
1 ,
0 ,
【解析】
P X Y 0 P
P
Y
X 1
X
1
P
P
X
X
1
1
P
1
X
F
X
1
(1
)
P
e
X 1
F
Y
( y )
P
P
P
Y
X
X
y
y
y
,
,
0
X
P
X
Y
1
1
y
P
,
X
P
X
X
1
y ,
P
X
y
Y
, X
1
y
1
,
P
X
X
1
y , X 1
当 y 1 时, F
Y
( y ) P X y e y ;
当1 y0时, F
Y
( y ) P X 1 e ;
当 0 y 1 时, F
Y
( y ) P X y P X 1 1 e y e ;
当 y 1时,F (y) P0 X 1PX 11;
Y
ey, y1,
e, 1 y0,
故F (y)
Y 1ey e, 0 y1,
1, y1.8.【答案】(1) f
X
( x )
2
0
,
,
0
其
x
他
1
2
1
; (2)
6
【解析】(1)如图所示,折点坐标记为 V ,则 V ~ U ( 0 , 1 ) ,于是X minV,1V ,则 X
的分布函数为 F
X
( x ) P X x P m i n V , 1 V x ;
由题意, P
0 X
1
2
1 ,故
① 当 x 0 时, F
X
( x ) 0 ;
② 当 x
1
2
时, F
X
( x ) 1 ;
1
③ 当0 x 时,
2
F
X
( x )
P
1
1
1
1
m
P
P
P
1
i
n
m
V
x
x
1
V
i n
, 1
V
x , 1
V
x
V
, 1
1
2
V
x
x
V
x
x
x
1
2, 0 x ,
于是 f (x) F(x) 2
X X
0, 其他.
(2)方法一:由(1)知, X U
0 ,
1
2
,故 E X
1
4
, D X
1
4 8
,故
E(Z) E[X(1X)] E(X)E(X2)
E(X)[E(X)]2 D(X)
1 1 1 1
4 16 48 6
1
方法二:Z X(1X) X X2 ,由于z(xx2)12x0,x 0, ,
2故z xx2 在
0 ,
1
2
内单调可导,于是由 x 2 x z 0
1 14z 1 1
,解得x z .
2 2 4
1
又x ,故
2
x
1
2
1
4
z ,
d
d
x
z
1
2
1
4
1
z
,所以Z 的概率密度为
f
z
( z )
f
0
X
,
( x )
d
d
x
z
, 0 z
其
他
1
4
,
0 ,
1
4
1
z
, 0
其
z
他
1
4
,
于是 E ( Z )
14
0 1
4
z
z
d z
z
1
4
1
4
z
t
t
2
12
0
1
4
t
t 2
2 t d t 2
1
8
1
2 4
1
6
.