ARTICLE · 1034349
排水小系统的第一个AI助手,应该先帮人做什么
排水行业谈AI助手,容易直接想象一个能够回答所有问题、自动定位缺陷、生成方案甚至派发工单的“大脑”。但在一个真实的小系统里,最耗时间的工作通常更基础:不同数据对不上时间,GIS拓扑与现场不一致,同一异常存在多种解释,下一次监测不知道放在哪里。
第一个真正可用的排水AI助手,不必先替人做决定。它应该先把一次事件组织成可核的证据包,让专业人员更快看清:发生了什么、有哪些竞争解释、还缺哪项信息、下一步做什么最能减少不确定性。
一、它服务的不是聊天,而是一张事件卡
假设一个污水支系统出口在旱天出现流量抬升和电导率下降。助手接收的不是一句“帮我找漏点”,而是五类明确输入:可达出口的拓扑、上下游流量与水质、降雨和地下水位、泵闸及施工工况、历史检查与工单。
第一步是时间和对象对齐。助手把各设备统一到同一时区,标出缺测和漂移,结合旅行时间把上游信号与出口事件配对;同时检查监测点是否真的位于同一水力路径。若拓扑断裂或设备时钟异常,它应先报告“当前不能比较”,而不是强行给出根因。
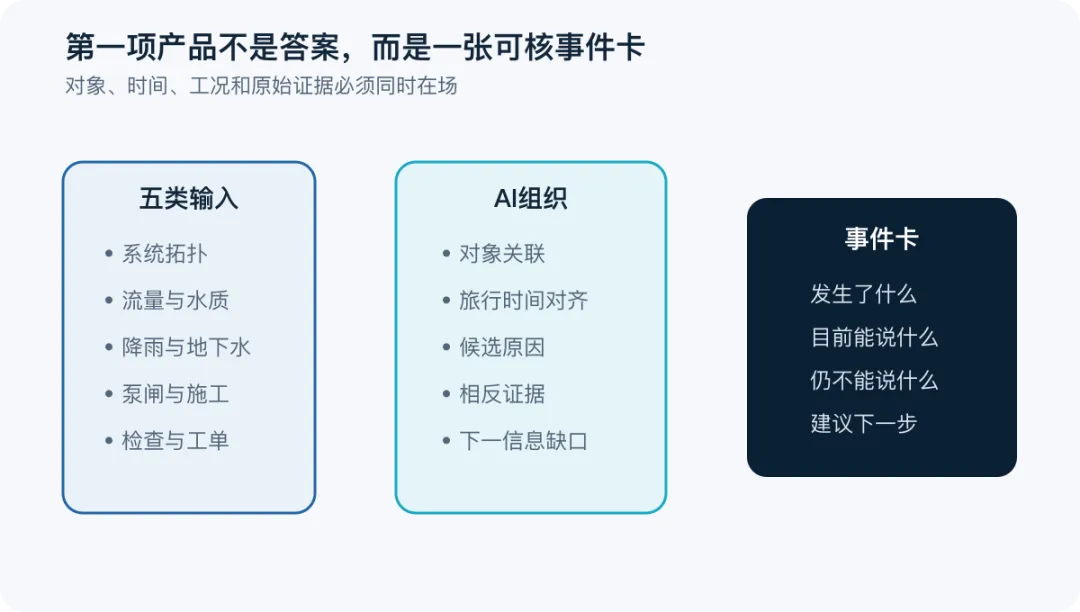
图1结论:助手的第一项产品不是答案,而是一张能够回到原始数据、系统对象和工况记录的事件卡。
二、它必须保留竞争解释
低EC和流量增加可能来自地下水渗入,也可能来自雨水直接流入、工业低盐排水、施工排水、补水、泵站调度、端元漂移或传感器污染。一个稳健的助手不应只输出“最可能原因”,还要同时列出支持证据、相反证据和能够区分候选的下一项信息。
例如:
地下水渗入候选:需要高地下水位期的持续响应和适配工况现场检查。
雨水直接流入候选:需要降雨后的快速响应、错接或入口证据。
运行扰动候选:需要泵启停、闸门、施工和排放台账。
数据错误候选:需要共址比对、校准和端元复核。
这里的“候选排序”不是行政责任认定。模型概率再高,也不能替代CCTV、烟雾、染色、闭水或其他与来源相匹配的现场证据。
三、确定性计算和AI各做什么
水量守恒、单位换算、EC二端元近似、雨水产流初筛和费用临界值,都应该由透明的确定性脚本或水文水力模型完成。它们的输入、公式和输出可以复算,适合进入审查记录。
AI更适合处理四类非结构化工作:从多份资料中提取事件;把工单、投诉和监测曲线关联到拓扑对象;根据现有证据生成竞争解释;提出下一监测点或检测手段,并说明它预计消除哪项不确定性。
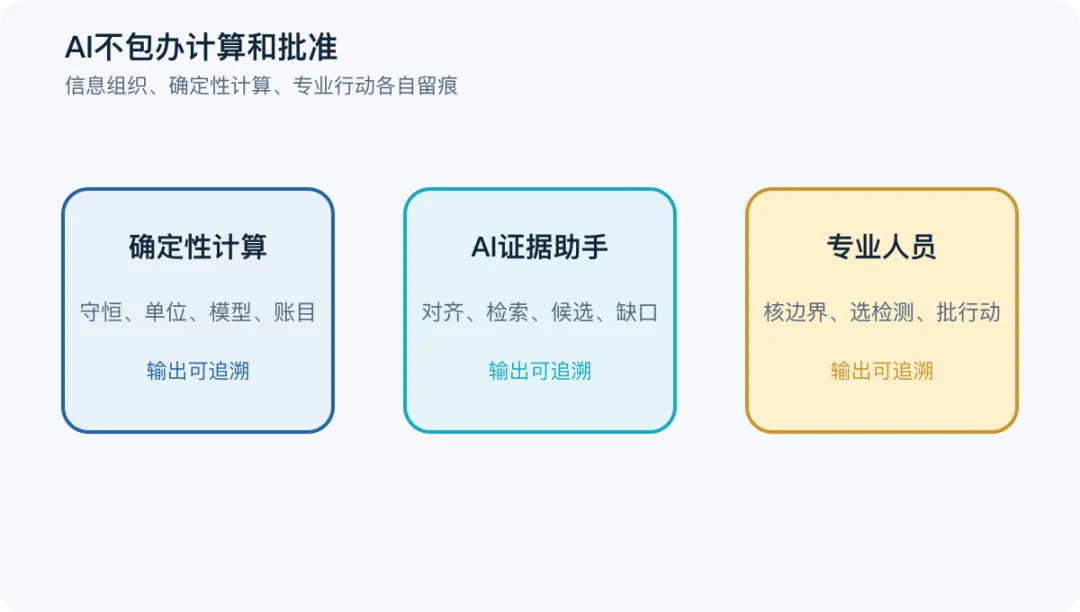
图2结论:确定性计算负责“怎么算”,AI负责“哪些证据值得一起看”,专业人员负责“是否行动”。三者互相校核,而不是由一个模型包办。
四、人工确认不能只剩一个按钮
NIST人工智能风险管理框架强调,应定义人在决策与监督中的角色和责任。落到排水业务,这意味着每个关键节点都要写清谁签认、看见哪些依据、能否否决。
数据管理员确认设备与字段质量;排水专业人员确认系统边界、工况和候选解释;运行人员核对泵闸与现场事件;项目负责人批准新增监测、检测和修复。AI输出旁边必须同时显示引用证据、版本、缺口和反例。只有一个“人工确认”按钮,却不给签认者看依据,不能算有效监督。
还要防止“自动化偏见”:当界面把一个候选排在第一位,人容易把排序当事实。可采用三个简单设计。默认同时展示至少两个竞争解释;把模型信心与证据完整度分开;要求签认者选择同意、否决或需要补证,并留下理由。这样,人工不是替系统背书,而是真正参与判断。
对于可能引发开挖、调度或行政处置的建议,应设置更高权限。助手可以生成工作建议单,但正式工单必须由授权人员确认对象、依据和风险;紧急事件则走既有应急机制,不等待AI完成最优信息分析。
五、下一测点建议应该怎样生成
助手不应机械推荐“异常值最大的点”。它要考虑拓扑分叉、现有监测覆盖、旅行时间、设备可部署性以及不同结果是否会改变行动。
如果在C2和C3布点,无论结果怎样甲方都准备把两条支路全部CCTV,那么新增监测对当前决策的价值有限。如果两点同步结果可以决定只检查其中一条,并且等待代价可接受,这轮监测才真正可能改变下一笔投入。
因此,每条建议至少包含四句话:建议在哪里测;为了区分哪两个候选;出现什么结果将采取什么行动;什么情况下停止继续调查。
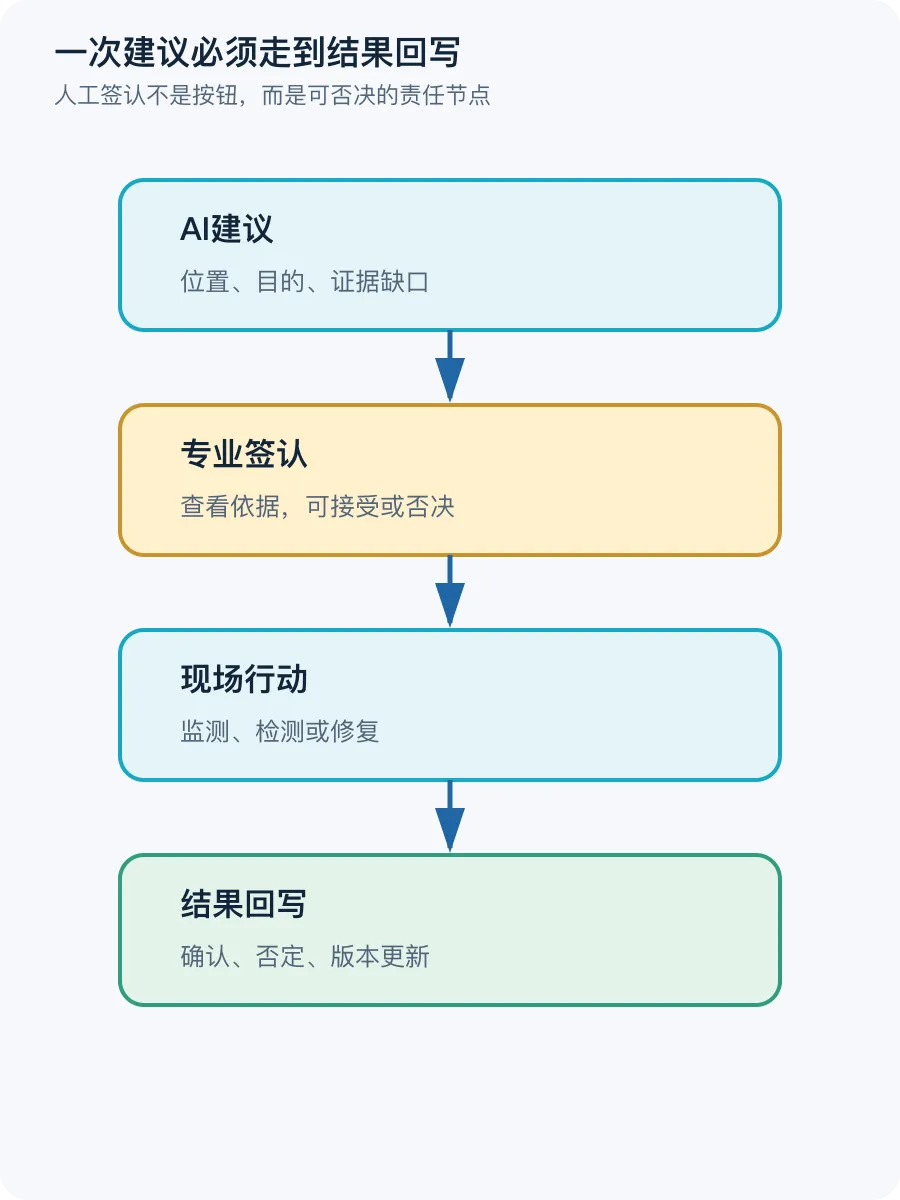
图3结论:AI建议只有进入“人工签认—现场行动—结果回写”的闭环,才会变成组织能力;没有回写,它只是一次漂亮的回答。
六、国内城市怎样做第一个版本
不需要先建设全市级大模型。选择一个边界清楚、有出口监测、有历史工单的小系统,做一个离线助手:只读取已授权的本地资料,不自动控制设备,不自动派发正式工单。
第一个版本只验收五项能力:能否把事件对齐到正确系统;能否引用原始依据;能否保留竞争解释;能否给出可执行的下一证据建议;能否记录人工否决与现场结果。准确率不能只用模型自评,应按留出事件和现场确认检查。
试点可以分三轮。第一轮完全离线,选择过去已经调查结束的事件,让助手重建当时证据链,检查它是否遗漏关键工况。第二轮进入“影子运行”,助手实时给建议,但不影响现场计划,事后比较建议与专业人员决策。第三轮才允许生成待审核工作单,并记录哪些建议被采纳、为什么被否决、是否减少了寻找资料和重复检查的时间。
评价也不只看根因命中率。更适合早期版本的指标包括:原始证据引用是否准确,事件对齐是否正确,关键缺口是否被发现,下一建议是否可执行,人工能否理解并否决,以及结果是否顺利回写。没有真实部署数据时,不应先承诺节省多少人时或提高多少准确率。
数据权限宜从最小集合开始。监测曲线、拓扑和工单可能包含设施安全、项目责任和敏感位置,助手应记录读取范围、数据版本和输出去向。对外部大模型的使用,需要先决定哪些内容可以离开本地环境,哪些必须脱敏或完全本地处理。
当试点扩展到更多系统时,最先标准化的应是事件卡、证据引用、人工签认和反馈字段,而不是把所有城市训练成一个“万能模型”。不同片区的管况、端元和运行方式可以不同,但一次建议如何被复核、否决和回写,应该保持一致。只有工作流可复制,AI能力才可能规模化。
本号综合判断:排水小系统的第一个AI助手,最值得先替人做的是“整理证据和安排下一步”,不是替人签字。它把工程师从找资料、对时间和追版本中解放出来,同时把守恒计算和正式行动留在可复核的专业流程里。
先让一个事件从发现走到回写,再谈覆盖整座城市,往往更容易形成真实可复制的智能化能力。
如果只给AI助手开放一个权限,你更愿意先让它读取监测数据、GIS拓扑,还是历史工单?
主要资料
NIST:AI Risk Management Framework Core
NIST:AI Risk Management and Human-AI Interaction
US EPA:Sewer System Evaluation and Rehabilitation
延伸阅读
📌 关注【给排水智评】
聚焦水务智能化评估|用数据说话,只讲洞察