ARTICLE · 1035649
测试人的第一个 Skill 别写用例模板:那是最不值钱的一种
“
《缺陷分级标准》几乎每个测试团队都有一份没人打开的。它写得并不差,只是缺一个被执行的时机。Skill 给的正是这个时机——但你得装对东西。
—— 软糖的测试小星球
带过新人的测试,大概都说过这段对话:
“这个改动要不要回归支付?”
“看情况。”
“什么情况?”
“……碰到链路就要,没碰到就不用。”
对话到这里结束,新人还是不会判断。问题不在他,也不在你:这条规则从来没有一个被执行的时机。
它写在 Wiki 里、写在 Word 里、写在某次评审的会议纪要里。但没有人会在提交缺陷、评估回归范围的那一秒,去翻那份文档。
2025 年 10 月 16 日,Anthropic 发布了 Agent Skills;同年 12 月 18 日把它发布为开放标准(规格站 agentskills.io,治理现由 Linux Foundation 旗下 Agentic AI Foundation 负责)。据多家科技媒体跟踪报道,到 2026 年已有约四十款工具支持同一套 SKILL.md 格式——这条属于媒体观察,不是官方逐一公告的名单,查证时请区分。
抛开名词,机制其实很朴素:Skill 是一个装着经验的文件夹,Agent 自己判断“这条现在用得上”,然后才把它读进来。
对测试人来说,意义比“多了个新玩具”大得多:你终于可以把那些只在你脑子里的判断规则,交给一个每次都会真的去读它的执行者。
但绝大多数人写第一个 Skill 时,会挑错东西。
📌 本文看点
01
别封装模板,封装“看情况”
02
Skill 的最小模型与三层加载
03
用 6 条用例验收 Skill
CONCLUSION
先说结论:AI 不缺模板,缺的是你的判断
大模型读过成千上万份测试用例模板、缺陷报告模板、测试计划模板。你再喂它一份自己的,边际收益接近于零——它本来就能生成,而且格式可能比你写得还整齐。
它真正不知道的是这几件事:
你们公司 P0 的口径到底是什么;
支付链路的任何改动,哪怕只改一行,是不是都要全量回归;
什么情况下允许带已知问题上线,谁来拍这个板;
一条用例值不值得自动化,你们的取舍线在哪。
这些不是知识,是判断规则。它们有四个共同特征:有阈值、有例外、有代价、且书上没写。
所以第一个该封装的,不是你会的那份模板,是你会的那个“看情况”。
给你一个三问自检,用来判断一条经验值不值得写成 Skill:
有人问过你这条吗? 问过,说明它没被写清楚过。
你的回答里出现过“看情况”吗? 出现过,说明它是条件判断,不是一句陈述。
真写下来,会有两条以上例外吗? 有,说明它需要被结构化,而不是一句话带过。
三个都是“是”——这就是你最值得封装的第一条。
对照这张表,你会发现一个反直觉的结论:封装收益和“内容的通用程度”是倒挂的。
模板类不是不能封装,而是它不值得你花第一个 Skill 的名额。
WHAT IS SKILL
Skill 到底是个什么东西(最小模型)
一个文件夹,根目录一个 SKILL.md。这就是最小可用单位,不需要装任何东西。
defect-triage/
├── SKILL.md
└── references/
└── severity-matrix.md
SKILL.md 由两部分组成:顶部一段 YAML frontmatter,下面是普通 Markdown 正文。规范里只有两个必填字段:
name:不超过 64 个字符,只能小写字母、数字和连字符,必须与父目录名一致;
description:不超过 1024 个字符,必须同时说清“做什么”和“什么时候用”。
正文建议控制在 500 行、约 5000 tokens 以内;更长的内容拆到 references/、scripts/、assets/ 里。
它靠三层渐进加载来控制上下文开销:
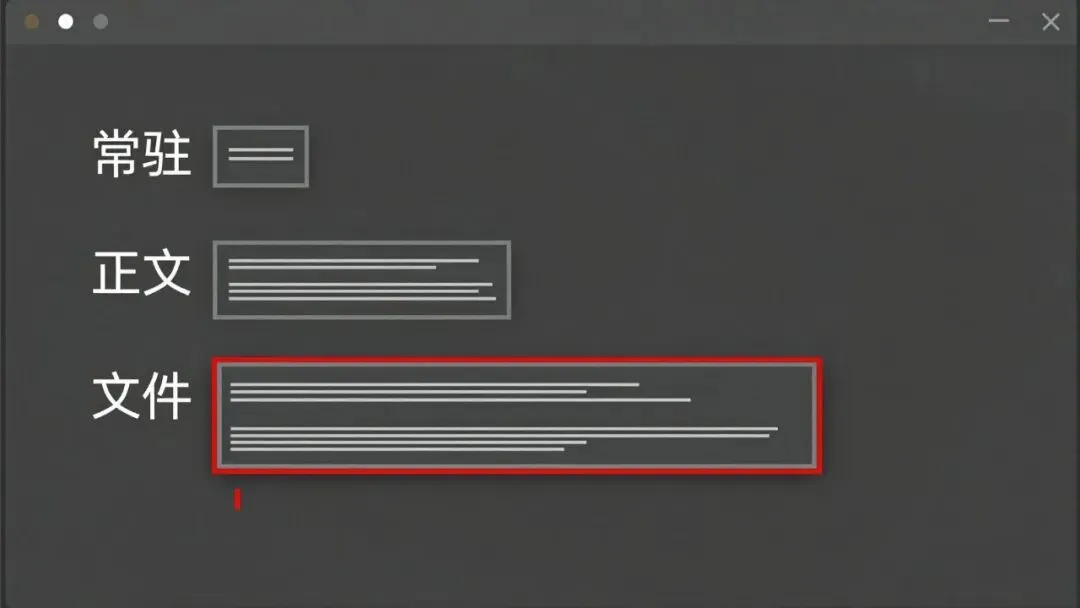
— Skill 的三层渐进加载
常驻层:只有 name + description,每个 Skill 几十到一百多 tokens,会话启动时全部注入;
触发层:Agent 判断当前任务匹配,才读取完整的 SKILL.md 正文;
资源层:references/、scripts/、assets/ 里的文件,用到哪个读哪个,不读就不占上下文。
一句话理解它和提示词的区别:提示词要你每次手动贴,Skill 是 Agent 自己决定要不要读。
而这个“决定”只发生在 description 上——description 写砸了,你的 Skill 就是一个永远不会打开的文件夹。这也是 Skill 最典型的失效点,后面会专门讲怎么验收。
顺带把边界划清楚,避免和另外几样东西混用:
一句口诀记分工:知识进 Skill,连接进 MCP。
HANDS-ON
动手:把“缺陷定级 + 回归范围”做成第一个 Skill
选它当例子,是因为这两条规则在测试团队里最高频、最“只可意会”,而且每次判断不一致,代价都立刻可见。
反例:
description: 缺陷分级和回归范围判定。
问题在于它只说了话题,没说触发时机。用户真正会说的话是“这个 bug 算 P 几”“这次改动要不要回归”——这些词一个都没出现,Agent 就匹配不上。
正例:
description: 判定缺陷严重等级与本次改动的回归范围。Use when 用户描述一个缺陷或一次改动,询问「算 P 几」「要不要回归」「回归哪些模块」「能不能放行」;也用于发版前确认回归范围。只输出判定与依据,不负责具体的用例编写与执行。
写法上有三条要点:
用第三人称,描述的是 Skill 而不是你;
把用户真实的问法原样写进去,口语化的“算 P 几”也要保留,这是匹配的关键词;
写清楚不做什么,负边界能显著降低误触发。
判断类 Skill 的正文,顺序比篇幅重要。下面是一个可以直接改用的骨架:
# 缺陷定级与回归范围判定
## 判定顺序(必须按序执行)
1. 先确认影响面:是否涉及资金、登录、下单、数据写入。
2. 再确认可恢复性:是否能通过重启、回滚、清缓存恢复。
3. 最后确认触发条件:必现 / 高概率 / 偶发。
4. 三项都确认后才定级。缺少任一项,先反问,不允许猜测。
## 输出格式(固定四项)
- 等级:P0 / P1 / P2 / P3
- 判定依据:逐条列出上面三项的结论
- 回归范围:模块清单 + 最小必测用例方向
- 风险提示:本次判定中不确定的部分
## 强制例外(优先级高于上面的规则)
- 涉及资金与对账的改动,无论改动量,回归范围必须包含全链路。
- 周五 18:00 之后的发布,判定结果必须额外标注“需人工二次确认”。
## 信息不足时
只反问缺失的那一项,不要一次性抛出所有问题,也不要自行假设。
注意最后两条:例外和反问,正是你的经验里最值钱、也是模板里最写不进去的部分。
references/severity-matrix.md 里放完整的分级细则表,正文里一句“定级口径见 references/severity-matrix.md”就够了——它不读就不占上下文。
以 Claude Code 为例:个人级放在 ~/.claude/skills/defect-triage/SKILL.md(Windows 下是 C:\Users\<你>\.claude\skills\),项目级放在仓库根目录的 .claude/skills/defect-triage/SKILL.md。团队共享用项目级,随仓库走。
不同产品读取的路径并不一样,跨平台复用前查一眼各自文档;同名 Skill 会按平台规定的优先级互相覆盖,别让两份同名文件悄悄顶掉。
放好后开一个新会话,用你写进 description 里的原话问一句,看它会不会读。
ACCEPTANCE
验收:它真的生效了吗
这里是测试人的主场。Skill 有三种失效,而且都是静默的——没有报错,只有一个不太对的结果。
不触发:你明明白白问了,它没读。原因基本都在 description。
误触发:你在聊别的事,它跳出来了。原因是 description 只写了话题没写场景,或者和别的 Skill 撞了描述。
触发后跑偏:读了,但输出字段缺失、判定顺序乱了、该反问时硬猜。原因在正文。
最小验收集,6 条就够:
跑法上有一个坑:不要在同一个会话里跑完 6 条。 第一条触发之后,Skill 正文已经进入上下文,后面几条“是否触发”的结论就不准了。每条开一个新会话,只记两件事——是否触发、输出字段是否齐。
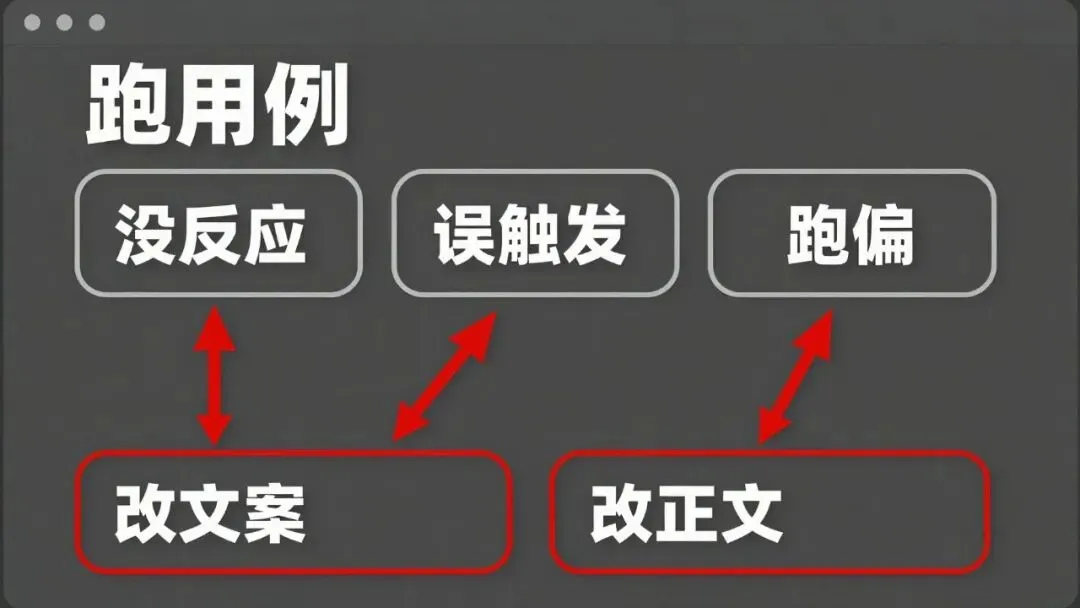
— 跑用例:三类失效对应改文案或改正文
坏了该改哪里,按对号入座:
TC-01、TC-02 不触发 → 改 description,把用户的原话补进去;
TC-04、TC-05 误触发 → 收窄 description,补上“不做什么”;
TC-03、TC-06 出问题 → 改正文,补判定顺序和反问条件。
看出规律了吗?正例验召回,负例验精度,边界验分支——这就是用例设计,你本来就会。所谓“Skill 工程”,一大半其实是测试工程。
GUARDRAILS
边界、成本和安全
脚本以你当前会话的权限运行。 Skill 可以带 scripts/,Agent 执行时它拥有的是你这次会话的权限。官方反复强调:只用可信来源的 Skill,装别人写的之前,把 SKILL.md 和 scripts/ 通读一遍。
不是装得越多越好。 每个 Skill 的 name + description 常驻上下文,装几十个会抬高发现成本,描述相近还会互相抢触发。
正文不是越长越好。 超过 500 行就拆 references/;判定类内容尤其要短,顺序比篇幅重要。
它不替你签字。 Skill 输出的是“判定 + 依据”,放行仍然要人拍板。规则可以固化,责任不能外包。
平台和版本一直在变。 路径、字段支持、触发行为都在演进,本文事实截至 2026-09-18,动手前以你所用产品的官方文档为准。
THE END
写在最后
如果你今天只做一件事:打开团队里那份没人看的规范,挑一条被问过三次以上的规则,写成 20 行的 SKILL.md,然后用那 6 条用例跑一遍。
你大概率会发现,最难的不是写,而是写的时候才发现——你们对这条规则,其实从来没真正达成过一致。
那才是 Skill 真正的价值。它不只是一个文件格式,它是一面把说不清的经验逼成“可执行规则”的镜子。装不装进 AI 另说,先照一次,就已经值回票价。
我是 软糖的测试小星球,分享 AI 时代的测试实战与工程化方法。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。