ARTICLE · 1037925
AI Infra:vcfclick,ClickHouse(chDB)+DuckDB的不同数据库软件协作样本
一个引擎包打天下
ClickHouse 扛队列,DuckDB
两个数据库的协作样本
vcfclick · chDB · 参考层 · Parquet · Wasm
vcfclick
📦 4 Parts + Conclusion
👉 滑动
PART 01
产品在解决什么
WHAT IT SOLVES
PART 02
两个数据库各自站在哪
TWO ENGINES, TWO ROLES
PART 03
协作方式
HOW THEY COLLABORATE
PART 04
为什么要这么用
WHY THIS SPLIT
PART ///
总结
THE TAKEAWAY
ClickHouse + DuckDB 在基因组变异场景里的协同特化样本,ClickHouse(chDB)扛队列主库,DuckDB 扛注释、备选后端和浏览器演示。
很多生物实验室都经历过这样的周五傍晚。VCF 躺在磁盘上,问题在脑中,脚本在管道里生长。你要的不是更多文件,而是一个能回答问题的库。
vcfclick 给出一套清晰回答。它把队列事实交给 ClickHouse 与 chDB,把注释与便携查询交给 DuckDB。它目前是 Apache 2.0 的 research preview,面向探索性研究,不做临床报告。作为产品,它还很早。作为架构样本,这套分工已经值得写清楚。
01
PART
产品在解决什么
WHAT IT SOLVES
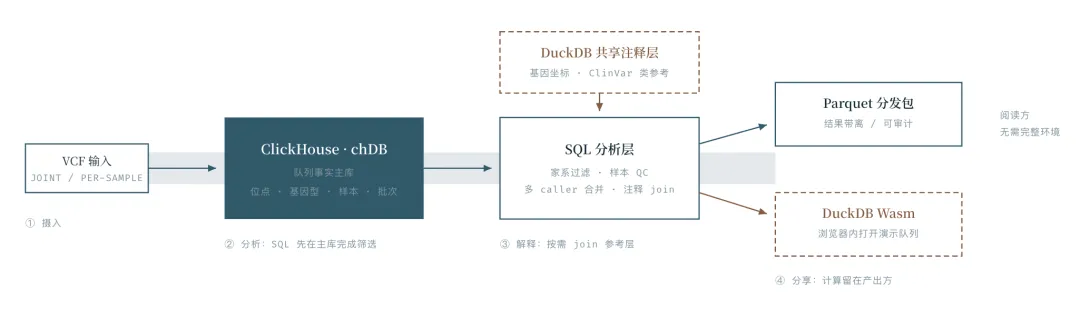
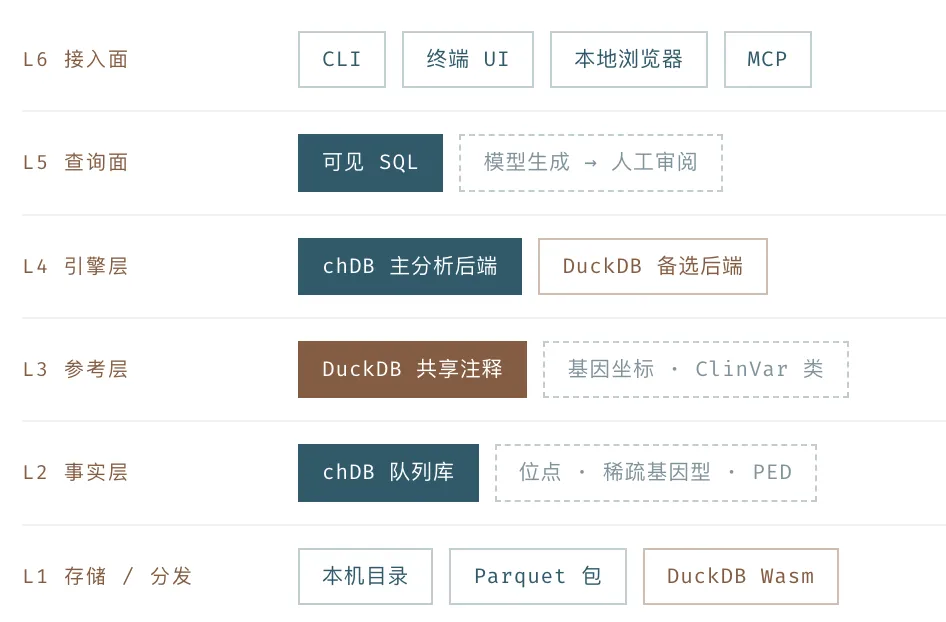
vcfclick 面向研究实验室和生信团队,而不是诊断科室或云上万人队列平台。它做三件核心的事:摄入 joint VCF 或一批 per-sample VCF,用 SQL 查位点、基因型、样本和摄入批次,完成家系过滤、样本 QC、多 caller 合并,并导出 Parquet 包。它提供 CLI、终端 UI、本地浏览器和 MCP,让模型写出的 SQL 可见、可审计。默认分析后端是 chDB,注释走共享 DuckDB,也允许 DuckDB 作为备选主库。数据库落在本机目录,安装走 uv 或 pipx。
边界同样清楚。多等位先分解,家系关系显式加载 PED,DuckDB 主库与 chDB 并不对等。这些限制说明它的产品边界:中小队列、本机优先、科研探索。
02
PART
两个数据库各自站在哪
TWO ENGINES, TWO ROLES
基因组分析里其实有两种表,只是长期被塞进同一种文件。
ClickHouse 与 chDB 是队列主库。它存这批样本里发生了什么:变异位点、稀疏基因型、样本元数据、摄入批次、家系与质控所依赖的工作表。数据私有,随队列变宽,查询以区间过滤、按样本或位点聚合为主。列存与嵌入式 OLAP 适合扫一段染色体,再按基因型条件收窄。
DuckDB 是参考层和分发层。它存这些位点在公共知识里是什么:基因坐标、ClinVar 一类共享注释。表相对小,更新节奏与队列无关,多个研究库可以共用同一份参考。同一套生态还覆盖 Parquet 导出,以及用 DuckDB Wasm 在浏览器里打开 1000 Genomes 演示队列。需要时,它也可以降级成分析后端,但那是兼容路径,不是对等双活。
可以记成:
ClickHouse 回答事实:谁在哪个位置带了什么等位。
DuckDB 回答语境:这个位置落在哪个基因、公共库如何注释,以及表格怎样带走。
队列事实 + 注释语境 = 可审计的答案
03
PART
协作方式
HOW THEY COLLABORATE
协作不是两个库做同一件事再互相同步,而是按生命周期拆开。
摄入:VCF 进入 chDB 成为队列库;注释预先或独立落在 DuckDB,不随每次摄入复制一份。
分析:SQL 先在主库完成位点与基因型的筛选、家系逻辑和 QC,再按需 join 参考层。
分享:计算留在产出方的 ClickHouse 里,阅读方只拿 Parquet,用 DuckDB 或 Wasm 打开。
注释升级只换参考库,不必重写整个队列。工作流可以写成:
文件 VCF → ClickHouse 队列库 → DuckDB 注释解释 → Parquet 或 Wasm 分发
MCP 坐在查询面上。模型生成用户能看见的 SQL,而不是对两个引擎的黑盒调用。对科研来说,可审计比对话即结果更重要。
04
PART
为什么要这么用
WHY THIS SPLIT
因为两类数据的变化率和查询不同。队列会增长,会重跑 caller,会加样本;注释按版本发布,体积稳定,却在几乎每次解释里都要被 join。绑在一个库里,结果往往是更新 ClinVar 却要触碰整库,或为了分享一个小结果而要求对方安装分析集群。拆开之后,更新解耦,存储也对口:宽表过滤给 ClickHouse,小表点查和便携查询给 DuckDB。
这也贴合实验室的真实约束。数据常常不能随手上云,合作者不一定能复现你的计算环境,但能够打开一份 Parquet。嵌入式双引擎让本机算得动和对方看得懂同时成立。DuckDB 作为备选 backend,是对安装现实的让步:chDB 的原生依赖不是每台机器都顺利。
它没有试图成为联邦数仓,也没有把双引擎伪装成对用户透明的单一存储。用户仍然面对 SQL,只是产品自己承认:主分析在 ClickHouse,解释和带走在 DuckDB。这种诚实,比一个引擎包打天下更接近基因组数据的结构。
///
LAST
总结
THE TAKEAWAY
vcfclick 可以看作生物研究工具,但范围是基因组变异,不是生物学全栈库。它也可以看作 DuckDB 案例,但真正完整的叙事是协作:ClickHouse 做队列事实库,DuckDB 做注释库与便携查询层,应用在本地 VCF 科研分析。
作为产品,它仍是早期预览,生态和用户规模都还小。作为范例,它示范的是一种可复用的拆法:把样本里有什么和公共知识怎么解释、结果怎么离开机器分成两个引擎,用 SQL 接起来,用可见的查询保持可重复。对中小队列、家系研究和需要把表交给合作者的实验室,这套分工比追求单一数据库更重要。
https://github.com/nuin/vcfclick