ARTICLE · 1039953
AI Infra Summit释放的信号:AI算力竞争正在变成一场系统交付战
9月15日至17日,AI Infra Summit 2026在美国圣克拉拉举行。主办方把议程分成Data & Models、Compute、Data Movement、AI Data Center和Physical AI五条主线,GPU只占其中一层。会期内,多家公司又分别公布了内存分层、数据互连、光器件扩产和整座AI工厂的优化结果。
NVIDIA给出的一个数字很有代表性:Lambda在相同供电预算下,用DSX MaxLPS将可运行节点从16个增加到19个,集群Token吞吐量从约400万提升至500万Token/s。加速器没有更换,系统通过跨GPU和机架调配电力,把闲置的功率余量转成了24%的吞吐提升。
这场峰会集中回答了一个正在变得具体的问题:GPU到货以后,怎样让内存、数据、网络、供电和冷却共同支撑它持续运行?
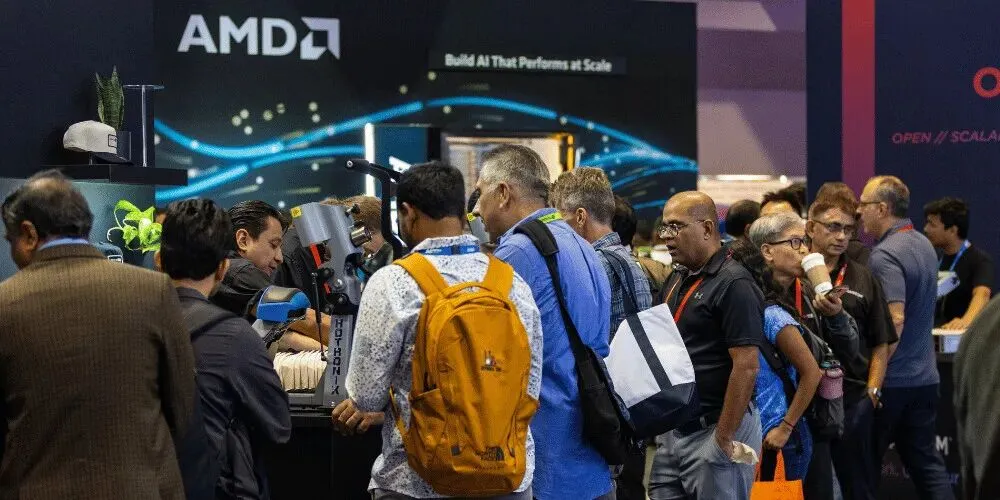
AI Infra Summit 2026展区现场。图源:大会官方Highlights。
五条议程,已经越过单颗芯片
五条议程对应的是一条完整的AI服务链:模型决定工作负载,计算系统执行训练和推理,数据移动把计算、内存和存储连接起来,数据中心提供电力、冷却和运维环境,Physical AI再把这些能力送到真实场景。
这条链路中,任何一层无法跟上,昂贵的GPU都会等待。推理请求在模型之间、Token之间和工具调用之间反复流动;KV Cache持续增长;数据需要在HBM、DRAM、SSD和不同计算节点之间搬运;机架还必须守住功率、温度与故障恢复边界。峰会把这些问题放在同一场会议里,本身就反映出产业的讨论对象已经扩展到系统效率。
推理时代,内存开始按数据价值重新分层
训练阶段主要追求大批量计算与高带宽同步。Agentic AI把压力移向长上下文、持续会话和多轮工具调用,KV Cache的容量、保留时间与复用频率随之上升。GPU等待数据的时间会直接侵蚀利用率,单纯增加HBM容量又会把成本和封装压力推高。
SK hynix在展台上给出了三条不同路径。
HBF(High Bandwidth Flash)被放在HBM与SSD之间。它以NAND提供容量,并采用类似HBM的TSV堆叠思路提高带宽,面向长上下文推理中“容量大、访问又不能太慢”的数据。现场展示的是结构模型和技术方向,说明内存厂商正在尝试增加一个新的数据层级。
PIM把部分计算放进内存侧。SK hynix展示了AiM芯片、AiMX加速卡和搭载AiMX的服务器,目标是减少处理器与内存之间的往返搬运。它更适合数据移动占比高、计算模式相对明确的负载,收益取决于算子适配与软件栈支持。
SALT-KV则从软件与存储分层入手。它按上下文切分KV Cache,再结合复用价值和存储成本,把数据放进HBM、DRAM或SSD。高价值数据留在更快的层级,低频数据下沉,有限的高带宽内存因此可以服务更多会话。
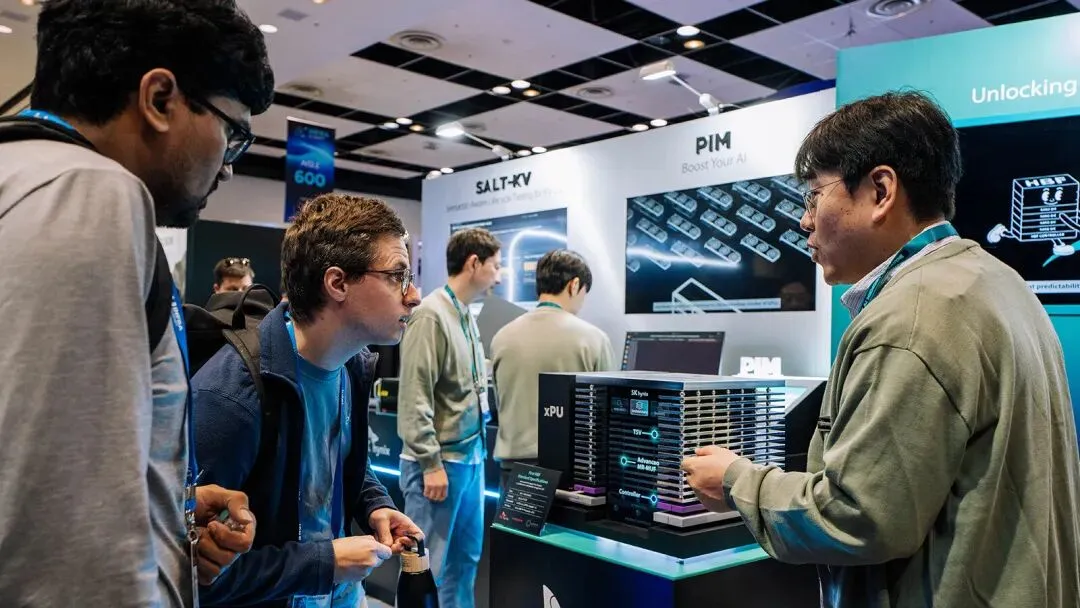
参观者查看SK hynix的HBF结构模型,后方同时展示SALT-KV与PIM。图源:SK hynix官方。
三种方案的共同点很明确:推理系统开始同时管理带宽、容量、计算位置和数据生命周期。内存的价值将越来越多地体现在能否让GPU持续拿到合适的数据。
数据移动,正在获得真实产能与资本
9月17日,GlobalFoundries与Marvell宣布扩展多年合作协议,在美国佛蒙特州Burlington工厂增加高性能SiGe产能。GF明确表示,这些工艺用于下一代可插拔光模块、NPO和CPO;现有技术支持单通道200G,并规划更高速率。
这项合作把“AI需要更多光连接”落到了晶圆产能。SiGe承担高速模拟与光电接口中的关键功能,单通道速率上升后,带宽、信号完整性和功耗需要同时满足。系统架构能画出NPO、CPO或更高速可插拔的方向,规模交付还要经过工艺平台、封装和产能爬坡。
会期内,Delos Data完成了超过1亿美元融资,并发布Nonstop AI参考架构和三种数据接口形态:面向GPU与加速器的30Tbps以上I/O Chiplet、面向光引擎集成的10Tbps以上NPO方案,以及面向CPU、闪存和内存端点的400Gbps以上PCIe卡。产品覆盖芯片内、封装附近和板卡三个位置,目标是让异构计算、内存和存储接入同一数据域。公司同时开放Morpheus开发测试平台,用于部署前的拓扑设计、仿真和验证。
另一家公司Cornelis在峰会前夕宣布2.05亿美元融资,并把业务从Scale-out扩展到Scale-up。其Active Compute Fabric采用开放架构,在Scale-up侧对接UALink、ESUN,在Scale-out侧对接Ultra Ethernet,还计划把集合通信卸载和可编程计算放进网络。现有CN5000已经出货,CN6000正在客户送样,下一代产品获得了明确的资金支持。
把几条动作放在一起看,信号已经很完整:GF—Marvell补制造产能,Delos给出芯片、NPO和板卡形态,Cornelis推进开放式Scale-up网络,两家公司合计获得超过3亿美元融资。数据移动正在从架构讨论进入产能、产品和资本同时投入的阶段。
AI Factory把供电、网络和计算放进同一套控制系统
NVIDIA在峰会上提出,AI基础设施的评价指标正在转向经过验证的“每兆瓦Agentic Token产出”。DSX覆盖整座AI工厂的设计与运行,计算系统、网络、软件和功率管理开始共享一套效率目标。
Lambda公布的验证结果说明了这种系统优化如何发生。DSX MaxLPS持续监控GPU与机架功耗,在训练和推理负载之间动态移动可用功率,并回收静态配置留下的余量。同一供电预算下,节点数从16个增加到19个,Token吞吐量提升24%,每瓦性能提升23%。
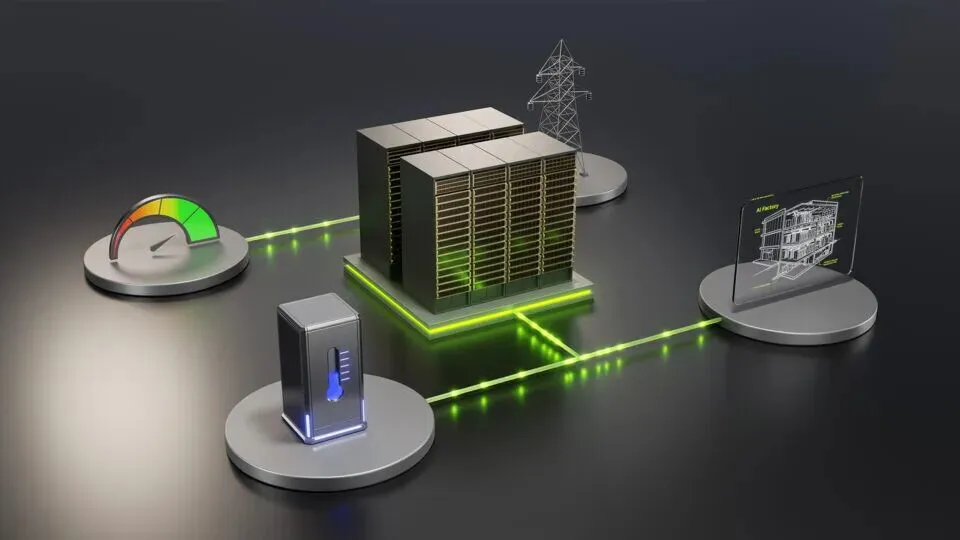
NVIDIA DSX从AI工厂层面连接算力、功率管理与运行控制。图源:NVIDIA官方示意。
Meta基础设施副总裁Manish Kadakia在峰会现场把数据中心拆成四个核心系统:服务器、网络、电力和冷却。他给出的量级变化很直观,传统机架功耗约为10kW,AI机架已经达到100kW以上;同样的功率最终都要变成热量,而许多现有建筑的配电和冷却能力按前一代密度设计。
AI集群还增加了一张处理器之间的后端高速网络,需要大量光纤,并对时延格外敏感。数千颗处理器同步升降负载时,电力需求会突然波动;液冷系统靠近昂贵电子设备后,泄漏、腐蚀、水质和微生物管理也进入日常运维。新一代硬件几个月就可能更新,建筑和基础设施的改造周期却长得多。
因此,机架密度上升之后,供电、冷却、网络和负载调度必须同步设计。功率规划要覆盖持续负载和瞬时波动,冷却系统要具备监测与维护能力,网络拓扑还要控制通信等待和故障域。任何一项跟不上,新增GPU都可能变成无法稳定兑现的账面算力。
一座AI工厂最终交付的是可持续Token产出。芯片峰值决定理论上限,电力接入、液冷系统、网络、软件调度和运维能力共同决定这个上限能够兑现多少。
光互连的边界,正在向Scale-up域移动
传统数据中心里的光连接主要承担交换机之间、机架之间和园区之间的数据传输。AI Scale-up要求大量加速器以更低时延、更高带宽共同工作,连接距离虽短,端口密度和功耗却迅速抬升。铜互连的损耗、均衡功耗和布线复杂度会随着速率与距离增加。
Ayar Labs在本届峰会展示了与Wiwynn共同开发的光连接机架,把TeraPHY光引擎和SuperNova外置光源纳入机架级架构。其演讲进一步提出,设计单元正在向“光连接机箱”和可组合集群演进。这里的光承担AI Scale-up流量,位置已经靠近计算封装和机架内部。
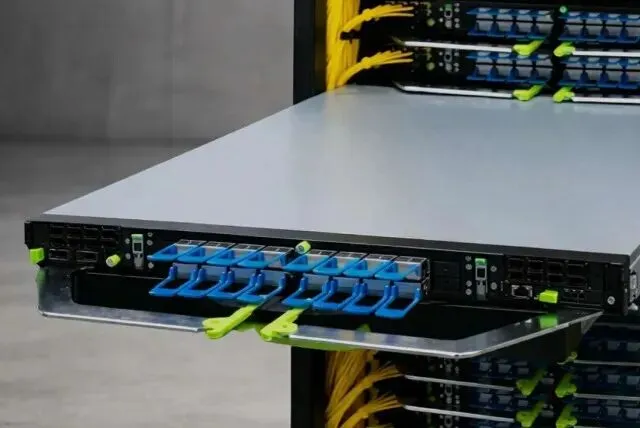
Ayar Labs与Wiwynn的光连接AI机架系统图,面向AI Scale-up。图源:Ayar Labs官方。
会前一周,Ayar Labs又获得1.5亿美元资金,使其2026年获得的一级市场资本总额达到6.5亿美元。资金用途包括产品开发、验证、制造生态扩展、高产量生产准备和班加罗尔设计中心;Wiwynn也披露了战略投资。机架展示回答架构如何连接,融资去向回答这条路线怎样走向规模制造。
OpenAI Jalapeño把当前边界画在“机架内铜、跨机架光”:128颗XPU在本地域通过铜背板连接,16个机架组成的全局域再引入1.6T光模块和OCS。Ayar Labs希望把光继续推向机架和封装。两种架构共同说明,光进入Scale-up域的节奏由距离、端口密度、功耗、时延、可维护性和制造成熟度共同决定。
Lightmatter CEO Nick Harris在峰会现场提醒,光学方案加速导入后,激光器与光纤供应也会影响系统建设。对光通信产业而言,机会来自数据路径的迁移,约束则落在光引擎封装、外置光源可靠性、连接器与光纤管理、测试能力和规模交付。光越靠近计算,制造与供应链波动越容易放大为整机柜的可用性问题。
我的判断:下一轮比较的是系统能否持续交付
GPU数量仍然决定理论算力,但项目成败会越来越多地由四个结果衡量:GPU利用率能否长期维持,Token产出能否守住功率预算,故障能否被隔离并快速恢复,同一套架构能否在更多机架和更多园区复制。
这也会改变产业链的价值分配。内存厂商需要证明数据分层能在真实负载中提高利用率;网络与光器件厂商需要同时交付带宽、功耗、可靠性和产能;服务器与数据中心运营商需要把供电、冷却、网络和软件调度做成可重复的工程方案。芯片交付只是起点,后续还包括机架集成、光纤布线、液冷维护、功率调度和故障恢复。
我的判断是,未来的AI算力竞争仍然会看GPU,但“拥有多少GPU”只能说明投入规模。最终拉开差距的能力,是把GPU持续、高利用率、可复制地投入运行,并把每一兆瓦电力稳定转化为可计费的Token。
感谢您的阅读!如果您觉得还不错,欢迎 关注 / 点赞 / 在看 / 转发;想不漏推送,请给「AI和光」加个星标⭐,如果您觉得有意见和建议,欢迎评论或者留言。我们下一期不见不散。