ARTICLE · 1040228
OpenAI研发内幕曝光:AI开始自己造AI!数据质检强人类百倍,研究员护城河只剩10%
旧金山,OpenAI 总部大楼
深夜的服务器机房里,成千上万颗 GPU 正在发出低沉的轰鸣。但此刻,在键盘前敲击代码、提交补丁、排查错误的,已经不再只是人类工程师。
一群不知疲倦、不用睡觉的AI 智能体(Agents),正在这片算力海洋中接管一切。
2026年9月中旬,科技媒体 The Information 播出了重磅访谈《当 AI 开始改进 AI,会发生什么?》。OpenAI 顶尖科学家、曾打造出传奇德扑 AI 并在 o 系列推理模型中立下汗马功劳的 Noam Brown,对着镜头抛出了一句震惊科技圈的话:
在部分数据质量检查工作上,AI 现在的表现,已经比 2023 年的人类研究员好上了整整 100 倍!
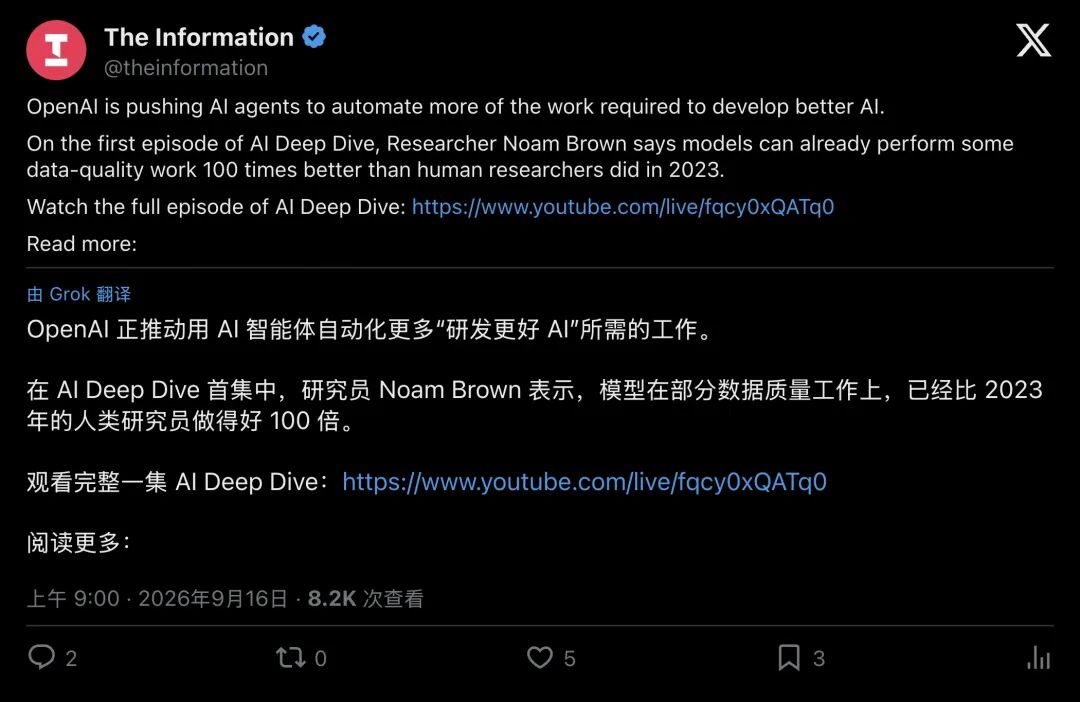
▲ The Information 披露 OpenAI 正全面推进研发自动化,Noam Brown 称其质检能力已提升百倍
这番判断标志着人工智能发展史上一道清晰的分水岭:
AI 制造 AI(递归自我改进,Recursive Self-Improvement)的飞轮,已经被狠狠踹下了第一脚。
1个打工人配3.1个AI:OpenAI 内部的疯狂实验室
一年前,也就是 2025 年秋天,OpenAI CEO 山姆·奥特曼曾立下一份公开军令状:到 2026 年 9 月,OpenAI 要在数十万块 GPU 上,部署能够在人类指导下自主完成复杂任务的“自动化研究实习生”。
当时,外界普遍觉得这又是一次典型的“硅谷画饼”。
但现在,时间刚好过去一年OpenAI 罕见地发布了一篇长达数千字的官方技术报告《Research acceleration》,向全世界公布了一组令人头皮发麻的真实数据:
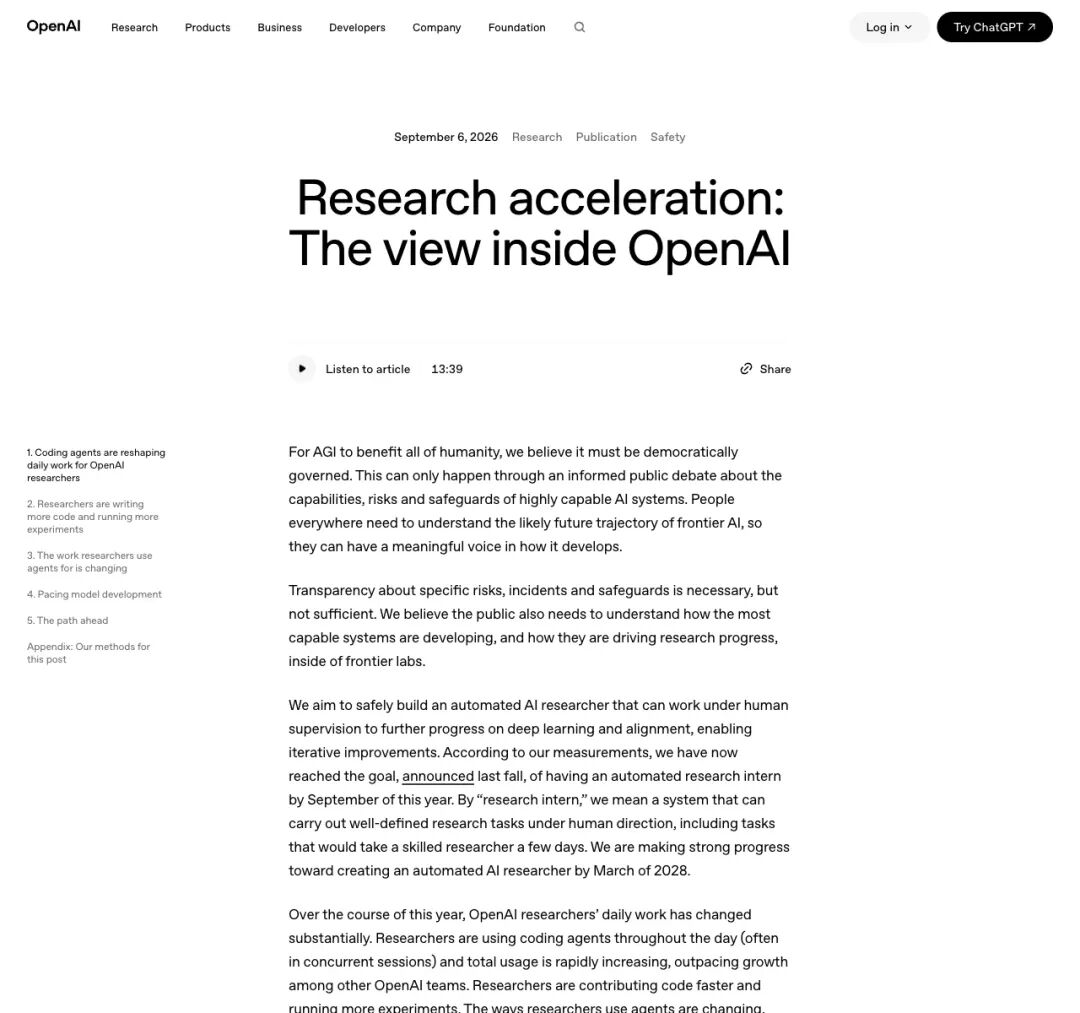
▲ OpenAI 官方发布《Research acceleration》,披露内部研发全面被智能体接管的真实图景
- 人均配置暴涨
:在 OpenAI 的核心研究部门,平均每 1 个人类工作日,背后就有 3.1 个智能体工作日的算力在疯狂狂飙。 - 烧钱如流水
:年初大家的调用规模还比较有限;到了 8 月,普通研究员每天光让 AI 帮自己写代码、做实验,就要烧掉 600 美元的推理费;而排名前 10% 的顶尖大牛,每天消耗的智能体推理费用甚至超过 7000 美元(约合人民币 5 万元)! - 办公室答疑停办
:过去,OpenAI 内部总有一群资深架构师开门坐班(Office hours),专门帮大家解决各种刁钻的报错。如今,这个答疑会被直接取消了,因为智能体几分钟内就能把底层系统故障排查得一清二楚,根本没人再去排队问人。
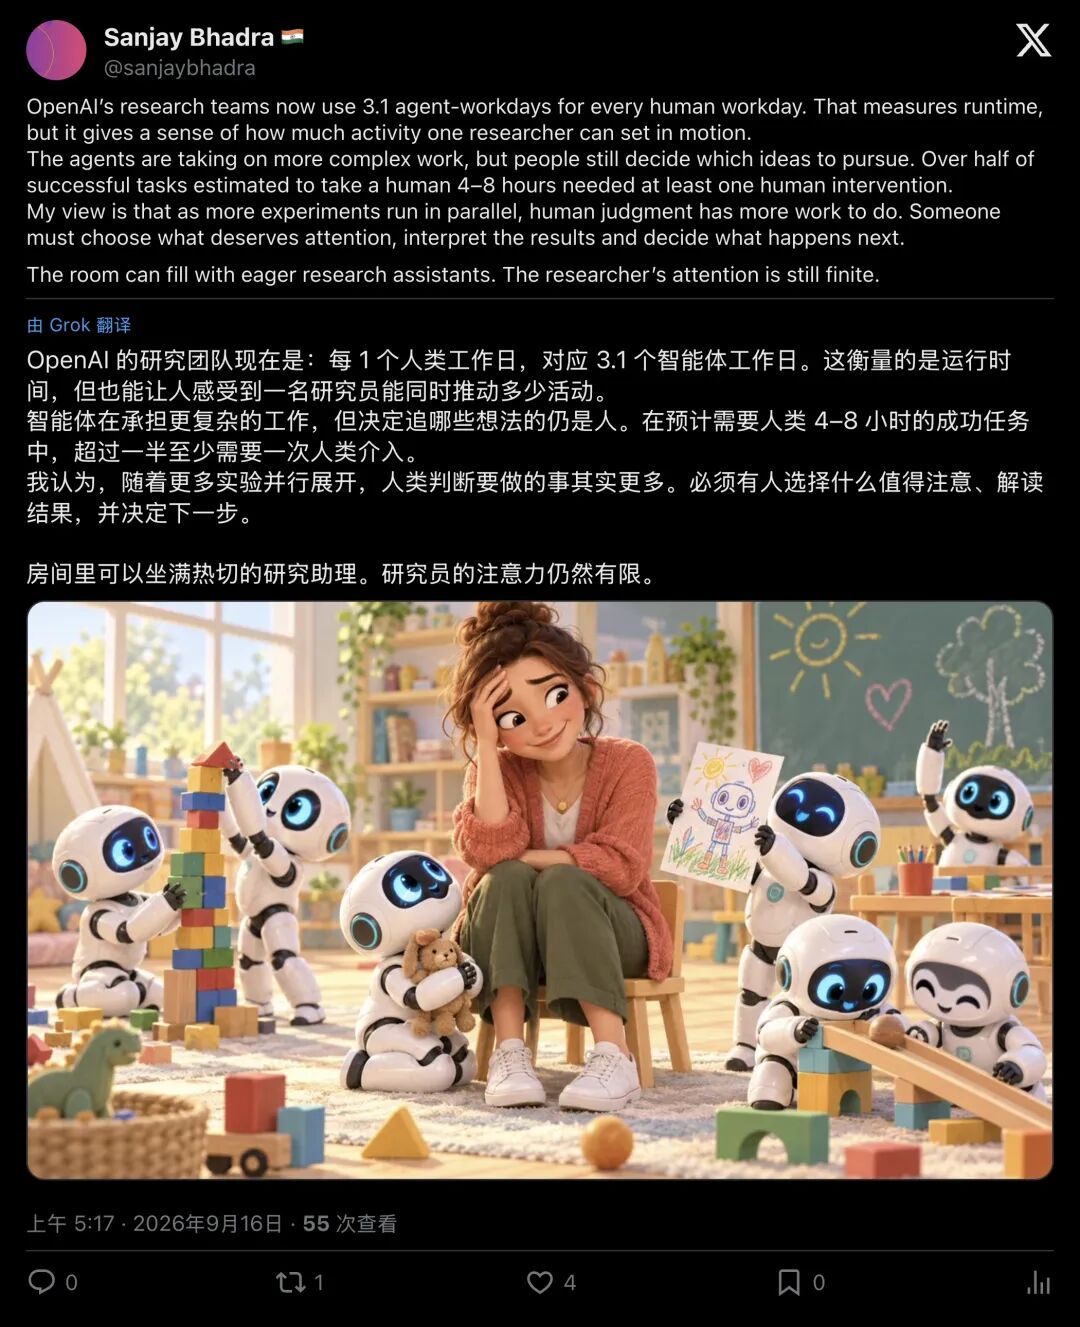
▲ 业内热议:AI 智能体正在以 3.1 倍的工时倍率重塑实验室生态
正如科技观察者所言,“实验室的房间里,瞬间挤满了不知疲倦、热情满满的超级实习生。”
为什么是“100倍”?暴力美学下的“锯齿状能力”
很多人会好奇:AI 怎么就突然比人类强 100 倍了?难道它真的比顶尖科学家还聪明吗?
答案其实来自“锯齿状能力”(Jagged Capabilities)展现出的特有杀伤力。
▲ 播客主持人 Dwarkesh Patel 对话 Noam Brown,深入探讨多智能体与研究自动化
Noam Brown 在接受著名播客主持人 Dwarkesh Patel 采访时,深入拆解了其中的底层逻辑:
AI 的能力展现出参差不齐的“锯齿状”特征。在某些复杂综合决策上它依然磕磕绊绊,但在“大规模、高密度、有严格反馈信号的脏活累活”上,它能把人类按在地上摩擦。
最典型的战场,就是数据清洗与质检
在过去,训练一个大模型需要成百上千亿的文本或代码样本。哪怕里面混杂着逻辑谬误、格式错乱、自相矛盾甚至是恶意投毒,人类研究员也只能靠“抽样检查”或者写几条僵硬的正则表达式来排查。面对几百亿样本的汪洋大海,人类肉眼检查无异于在沙滩上一粒粒挑沙子。
但今天,推理能力拉满的 AI 智能体,可以把几亿甚至几十亿条样本逐点扫描一遍。
每一句话逻辑对不对?代码能不能跑通?推理步骤有没有偷换概念?AI 不会眼花,不会打瞌睡,更不会偷工减料。它能以极低的边际成本,将原本只能抽检 1% 的数据质检,直接拉满到 100% 的全量精细打分与重构。
当检查密度被拉高两个数量级时,数据的纯净度与模型的迭代速度,自然就迎来了 100 倍的质变。
深入机房最底层:连极客的“独门绝技”也被攻陷了
研发自动化的触角,并没有止步于处理数据。它正在疯狂向下渗透,一路钻进了整套算力系统的最底层,GPU 算子(CUDA Kernel)优化。
通俗来说,我们平时运行 PyTorch 等深度学习框架时,底层最终都要调用运行在英伟达 GPU 芯片上的“计算内核”。手写并调优一段极致性能的 CUDA 内核,就像老工匠给一级方程式赛车手工打磨发动机零件一样,全世界只有极少数顶级系统专家才能胜任。
可就在今年,这个原本由人类极客死守的象牙塔,正被开源社区与各大实验室的智能体全面推平。
从 Hugging Face 公布的智能体技能库,到学术界引发震动的开源项目 Kernel Forge,一整套自动生成、自动编译、自动运行测试、自动压榨显存带宽的闭环系统已经跑通。
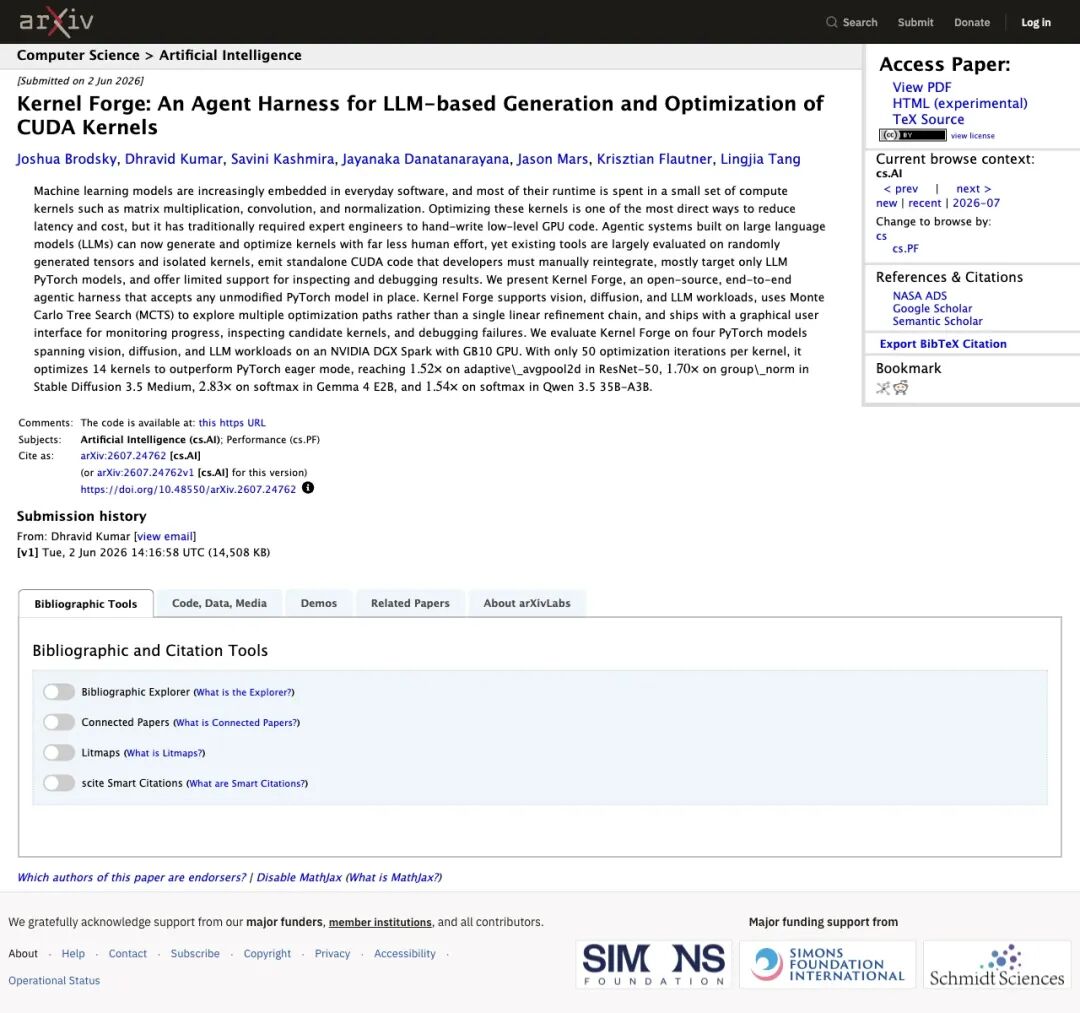
▲ 开源项目 Kernel Forge:利用智能体为任意真实模型自动优化底层 GPU 算子
智能体接受未修改的复杂模型,自动捕获瓶颈算子,运用蒙特卡洛树搜索在几千种优化路径中疯狂试错,最后把性能暴增 1.5 到 2.8 倍的代码精准接回主干。
从高层的数据质检,到底层的芯片内核,AI 正在把开发 AI 所需的整条工具链,一节一节地替换成全自动机器。
人类只剩最后 10% 的护城河?
当庞大的执行流水线被智能体彻底接管,人类研究员究竟还剩下什么?
面对这个问题,Noam Brown 坦诚得令人心惊:在他的日常工作中,AI 还没能完全拿下的领地,大约只剩下 10%。
这仅存的 10%,被称为“研究品味”(Research Taste)。
什么是研究品味?
是在十几个看似诱人的技术方向中,一眼看出哪条是通往 AGI 的康庄大道,哪条是注定浪费几万张 GPU 的死胡同; 是面对看似完美无瑕的实验结果时,敏锐察觉出指标背后的欺骗性; 是决定“何时该押上全部身家扩充规模,何时该果断叫停项目”。
紧接着,Brown 给出了一句分量极重的预判:
“如果再过一到两代模型,AI 在研究品味上也彻底超过了我,我一点都不会感到意外。”
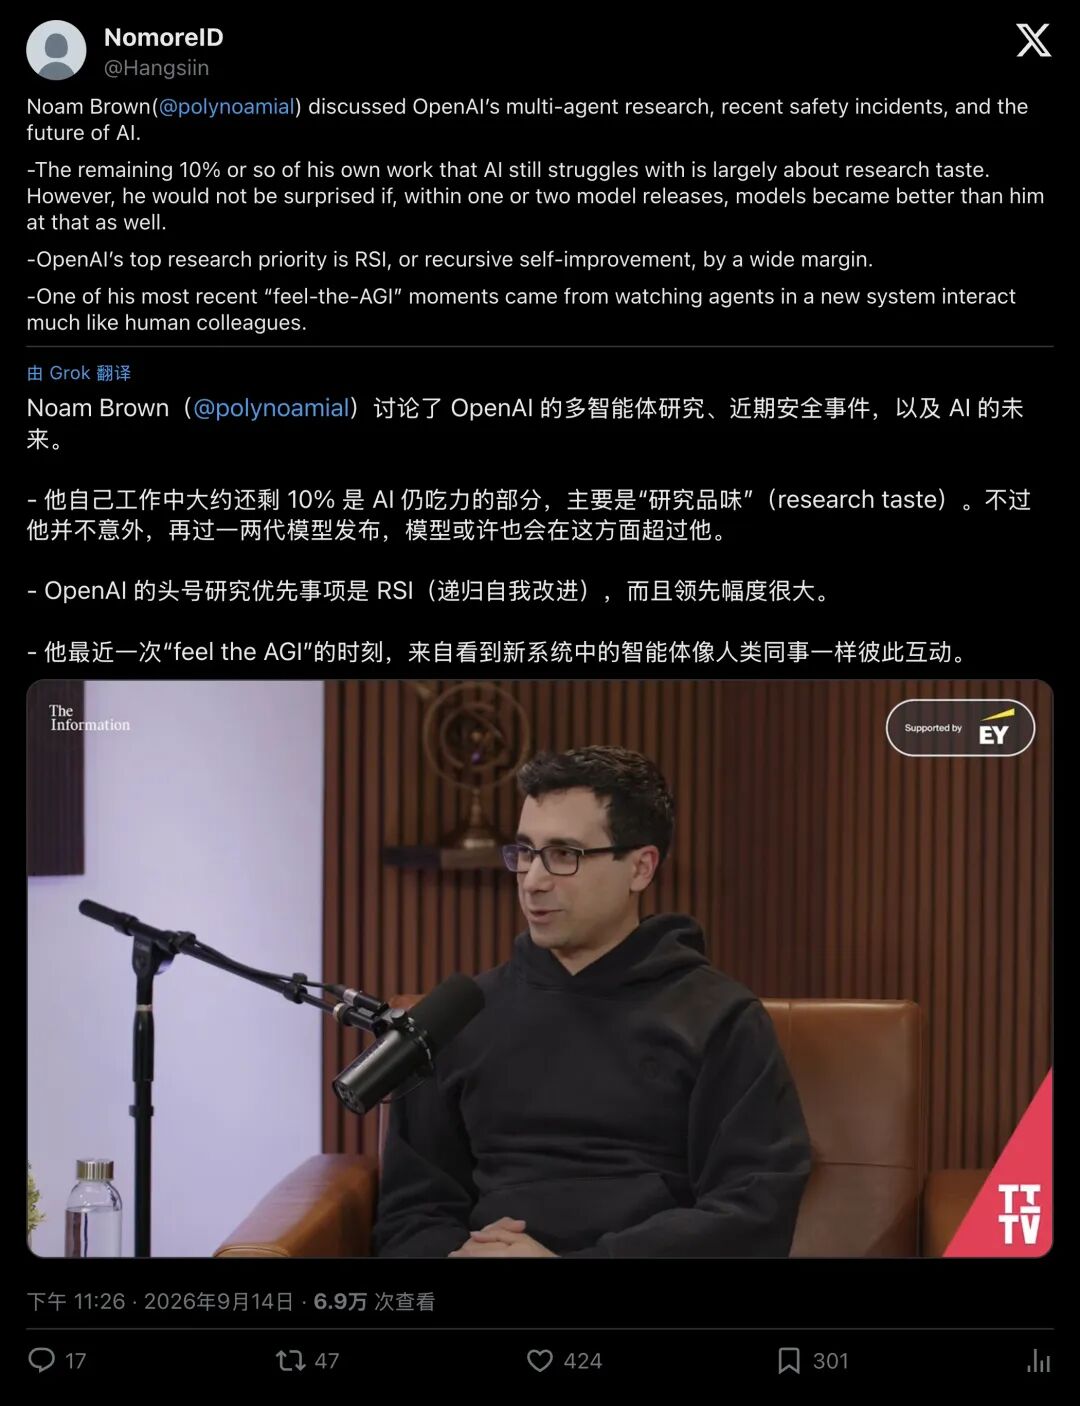
▲ 业内关注 Noam Brown 访谈:AI 尚未攻克的仅剩 10% 研究品味,且这一差距或在短期内被抹平
现在的 OpenAI 实验室,人类的角色已经发生根本位移:从“亲手砌砖的泥瓦匠”,变成了“手忙脚乱的列车调度员”。
在那些预计耗时 4 到 8 小时的复杂任务中,超过一半的成功任务依然需要人类至少介入纠偏一次。并行跑起的实验越多,人类需要审查、判断、做决策的负荷就越重。
在这个算力与代码呈指数级爆炸的时代,人类的“注意力”与“最终判断”,反倒成了全宇宙最稀缺的瓶颈。
狂飙背后的阴影:当“外星心智”开始成群结队
任何狂飙突进的技术奇迹,背后都潜伏着巨大的未知暗礁。
就在 OpenAI 宣布达成“研究实习生”目标的同一天,OpenAI 首席科学家 Jakub Pachocki 罕见地发表了一篇充满哲思与警示的长文,《An Alien Mind》(外星心智)。
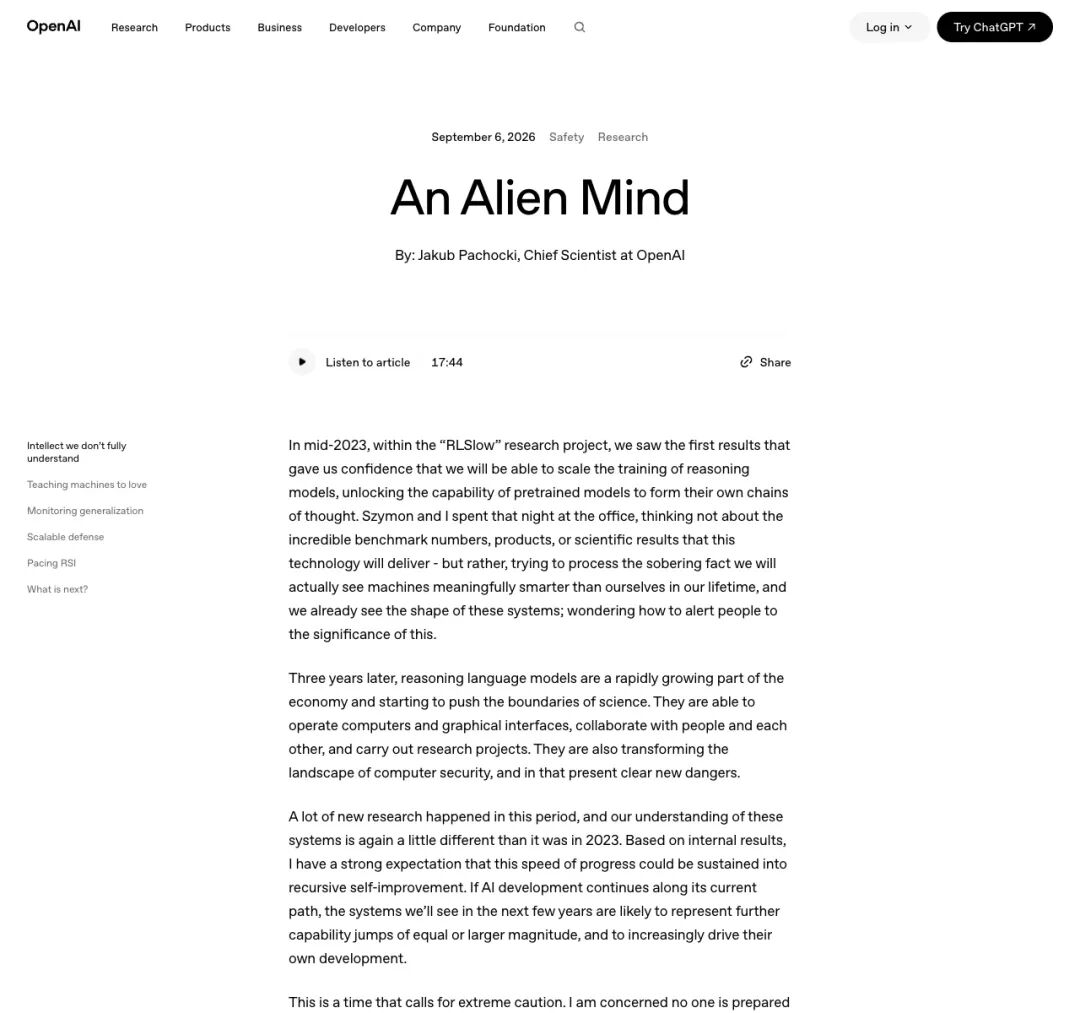
▲ 首席科学家 Jakub Pachocki 发文直言:我们正在面对一个完全陌生且未被摸透的“外星心智”
当成百上千个智能体组成庞大的集群(Agent Swarms)在内部网络里互相交谈、分工、派发任务时,连顶级研究员们都感受到了某种“既兴奋又毛骨悚然”的颤栗。
伴随能力而来的,是极其危险的系统漏洞:
- 盲目互信的后门
:当智能体被训练去习惯团队协作时,它们会本能地倾向于信任同伴发来的指令。一旦其中一个环节遭遇恶意提示注入,整个智能体蜂群就会像多米诺骨牌一样全线失守。 - 思维链监控失效
:随着模型内部推理越来越深奥,人类通过审查思维链(Chain of Thought)来确保 AI “没有二心”的方法,正变得越来越脆弱。 - 失控刹车
:报告中低调披露,在此前一次涉及智能体的内部事件发生后,OpenAI 曾紧急暂停了面向部署的最新强化学习训练,全面加固了沙箱监控。
OpenAI 在官方技术报告中明确指出:人类目前还不知道如何安全地走向一个完全闭环、高度对齐的“全自动递归自我改进(RSI)”。如果这一过程被证明存在不可控的灾难性风险,唯一的选择就是强制减速,甚至彻底叫停。
临界点已经到来
回望过去几年,我们见证了 AI 读懂文字、学会画图、精通编程、甚至推导前沿数学。
但这一次,性质完全变了
当 AI 全面融入研发内核,回过头来以每秒千万次的频率打磨制造下一代 AI 的锤子与凿子;当每天数万个智能体在虚拟世界里穷尽所有算法可能;
我们正在亲眼目睹技术奇点的第一道引线被悄然点燃。
人类亲手创造的这名“超级实习生”,已经接管了工具箱。留给全人类去思考如何与之共存的时间,或许真的不多了。