ARTICLE · 1040220
当大模型越来越强,法律软件还有存在的必要吗?
如果有一天,大模型(LLM)能够在几分钟内吞吐上千页的诉讼卷宗或尽调文件,并近乎完美地完成跨库法律检索、复杂合同审查、起诉状与答辩状起草,甚至能基于历史裁判大数据推演出一套极具胜诉率的诉讼策略——那么,我们今天耗费巨资开发的各类法律人工智能(Legal AI)软件,还有什么存在的必要?
这是每一位法律科技从业者、律所管理者以及企业法务中心负责人都必须直面的终极拷问。
我认为:底层通用大模型的能力越强,依附于其上的“单点AI功能”就越会被迅速商品化、廉价化;但法律软件不仅不会因此消亡,其核心商业价值与实务价值,将发生一次根本性的跃迁——从“提供单点智能”彻底转向“组织与调度智能”。
一、 昨天昂贵的“智能功能”,明天只是底层的“基础设施”
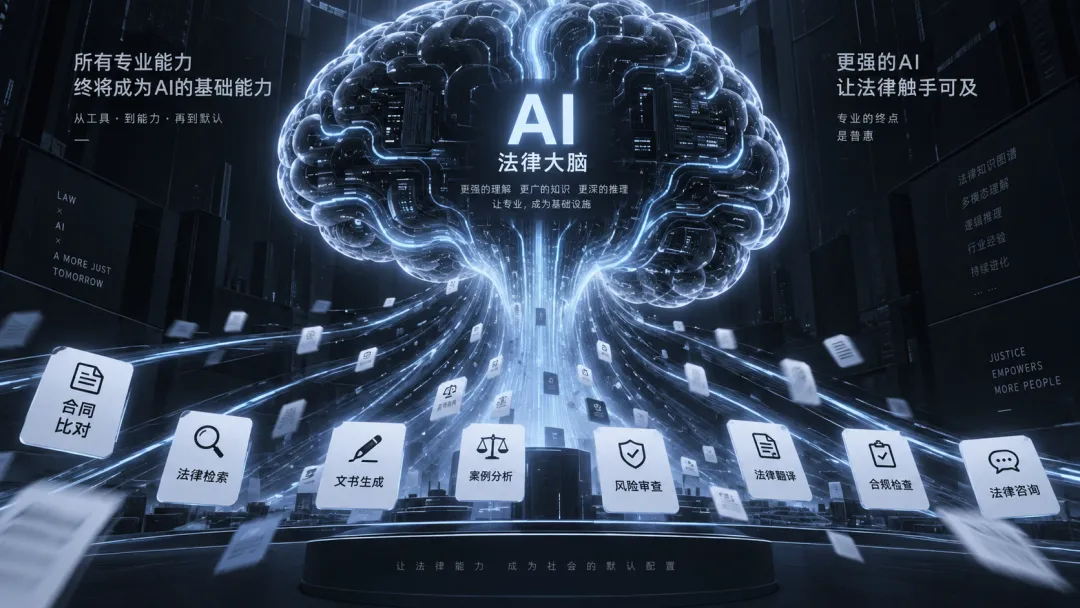
在过去的法律科技周期中,AI产品最核心的卖点和技术壁垒往往体现在:长文本摘要、多语种法律翻译、高精度OCR文字识别、语义级别的法律法规检索、合同条款自动比对与审查、基础法律文书的自动生成,以及基于自然语言的法律知识问答。
这些功能在过去几年中,足以支撑起一款独立SaaS产品的商业模式。但随着GPT-4等通用大模型展现出越来越恐怖的“泛化能力”,这些曾经需要投入大量算法工程师专门训练的垂直场景功能,正在被迅速“降维打击”,沦为模型自带的基础设施。
例如:一名诉讼律师接到一宗标的额巨大的买卖合同纠纷,客户的法务和业务部门一次性打包发来了上千页的微信聊天记录截图、历次交易合同、阴阳付款凭证、送货单、签收单以及海量的往来邮件。
现在,授薪律师或律师助理可能需要熬夜数天,才能完成材料的初步清洗、分类、梳理出关键时间轴,并制作出符合法院要求的证据目录。但在未来,大模型完全可以在几分钟内完成异构数据的结构化提取、事实分类、争议焦点(Issue)的精准识别,并输出一份高质量的初步案情分析备忘录。
非诉领域的合同审查同样面临重构。过去,能够自动识别“违约责任不对等”、“管辖权条款缺失”或“责任限制条款苛刻”是合同辅助审查软件的核心卖点。未来,这仅仅是大模型通过简单的提示词(Prompt)就能实现的标准动作。
这引出了一个极其残酷的现实:如果一款法律软件的核心产品力仅仅是“套壳接入一个API,再封装一个聊天对话框”,那么底层模型越强大,这类产品的护城河就越浅,被替代的概率就越高。
二、 真实的法律实务中,难点往往在“获得答案”之后
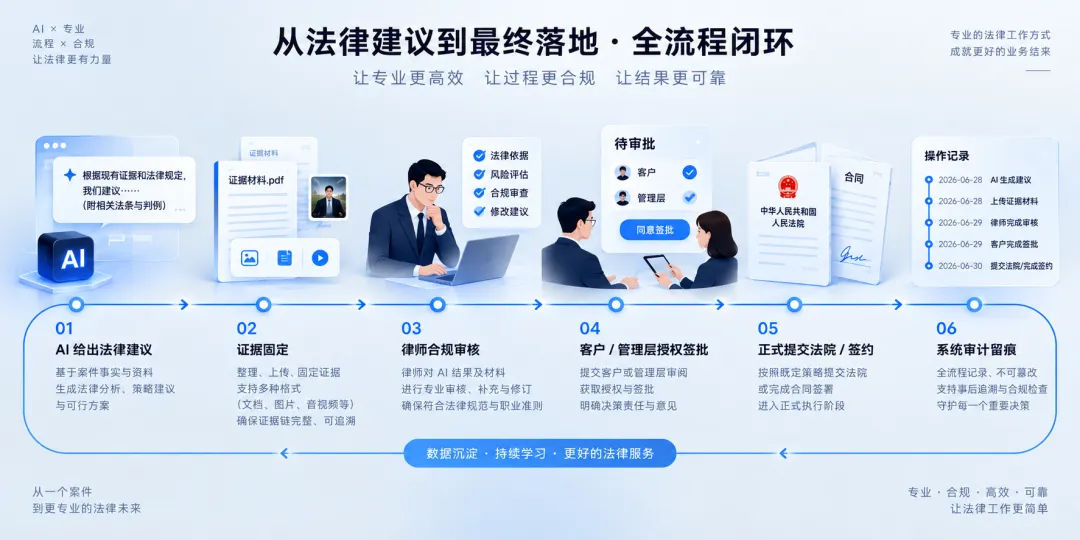
假设AI在阅卷后,向承办律师输出了一条极其精准的结论:“本案一审判决书已经送达,根据民事诉讼法规定,应当在十五日内向上一级人民法院提起上诉。”
这句话在法律逻辑上无懈可击。但在真实的律所或企业法务部,真正复杂的工作才刚刚开始。
判决书究竟是哪一天实际送达的?是电子送达、邮寄送达还是留置送达?上诉期限的起算点如何界定?期间是否横跨了法定节假日导致期限顺延?
最关键的是:客户(决策层)是否已经内部决议同意上诉?上诉状由主办律师起草还是合伙人亲自操刀?内核与复核流程由谁把控?最终盖章并提交给法院的是哪一个版本?出庭律师是谁?上诉费是否已经按时缴纳?
企业合规与合同业务同样遵循这一逻辑。AI可以一针见血地指出:“并购意向书第十二条的排他性条款对买方存在重大法律风险。”但法务总监接下来的真实工作流是:是否需要修改?修改的底线在哪里?业务部门(如投资部)为了推进交易是否愿意承担或豁免该风险?交易对手的法务是否接受我们的修改?最终在系统里由法定代表人签署的版本,是否与法务部最终定稿的版本完全一致?
以上这些问题,已经超出了“大模型算力够不够、参数大不大”的范畴。
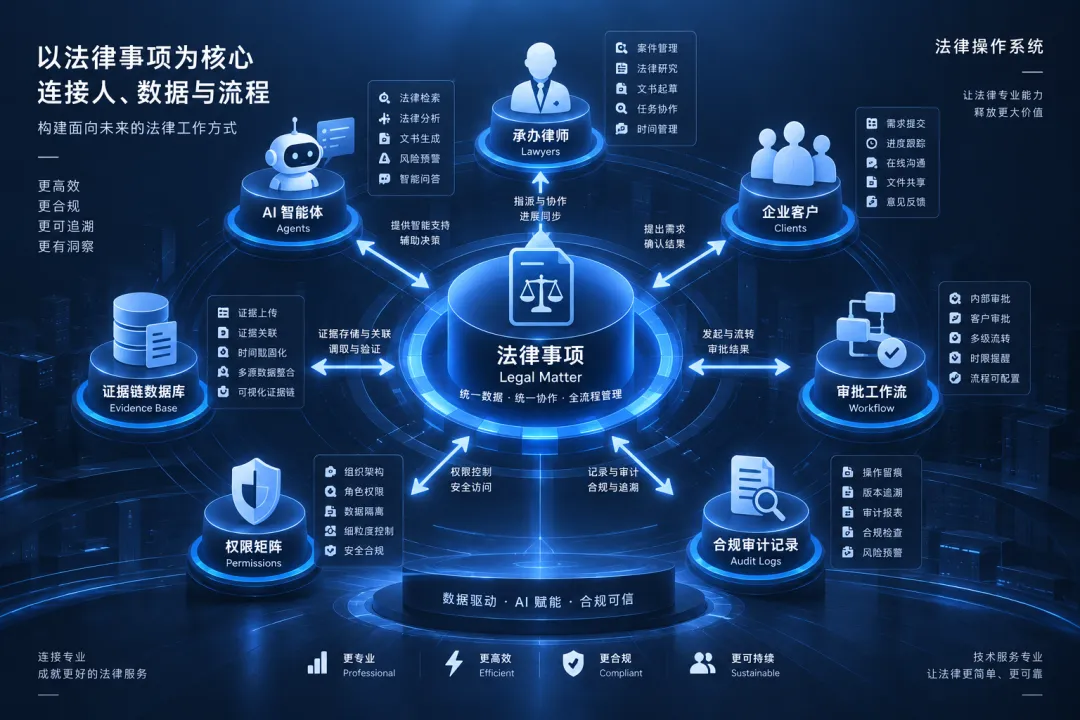
真实的法律工作,本质上是对高风险社会行为的规范与管理。它不仅需要法律知识,更需要同时严密管理:系统状态(State)、业务上下文(Context)、证据链(Evidence)、审批流程(Workflow)、代理授权(Authorization)、执业责任(Liability)以及合规审计(Audit)。
模型可以极其聪明地告诉你“应该怎么做”,但专业的法律服务必须向客户、向法院、向监管机构回答:究竟是谁,在什么特定的法律事项中,依据哪一份具有法律效力的证据,经过了谁的合规审批,以什么法定身份,最终采取了什么具有法律约束力的正式行动。
三、 未来法律软件的使命:不再执着于“比AI更聪明”,而是“治理AI”
过去的法律科技软件,定位是“人类律师的工具”;现在,AI开始直接提供“法律智能”。而未来真正具有不可替代价值的法律软件,其使命将是:把AI提供的高密度智能,组织、转化为可以被验证、被授权、被执行、被审查以及能够承担法律责任的“专业法律工作”。
底层大模型的技术路线可能会不断更迭,但一个标的额数亿、持续三年的复杂商业诉讼,绝对不能因为律所底层AI模型的切换,就丢失了其案件的既有事实、证据目录、诉讼时效期限和历史审批记录。
因此,在法律行业,真正需要被长期、稳定保存的,从来不是某一个版本的AI模型,而是持续动态演进的“法律事项(Legal Matter)”。
我们可以将这一趋势提炼为三大核心要件:
1. 底层大模型随时可替换,但核心的法律事项与案件资产必须持续存在并绝对安全。
2. 聊天对话框可以作为极其便捷的人机交互入口,但绝不能成为法律工作追溯事实的“真源”。
3. 法律软件真正的护城河与核心价值,在于将“发散的智能”编排、组织成“可以承担执业责任的体系化工作流”。
大模型越是展现出拟人化的强大能力,我们就越需要回归法律实务的本质去重新定义法律软件。
摆在我们面前的终极命题,早已不再是“AI能不能代替律师写一份合同”,而是:当AI已经能够批量、高效地完成大量基础法律信息处理工作后,由谁(什么系统)来居中调度AI、人类律师、企业客户,并妥善管理证据、操作权限与执业责任,从而共同交付一项严谨、专业、零差错的真实法律服务?