ARTICLE · 1040359
OpenAI捅破窗户纸:AI全面接管造AI!研究员日烧5万,干翻人类100倍
硅谷最可怕的一幕,正在旧金山的一栋写字楼里悄然发生。
这里的工程师不再亲手写代码,也不再逐行检查数据。他们每天一上班,第一件事是给身旁的几个“数字分身”派发任务,然后看着它们以人类几百倍的速度通宵狂奔。
AI,已经开始亲手制造下一代AI了。
科技媒体The Information与OpenAI官方披露的一组内幕数据展现了这一现实:在OpenAI的核心研发组织中,智能体(AI Agent)贡献的实际劳动量,已经达到了人类研究员的3.1倍!
研发背后的资金消耗同样惊人:在这个实验室里,一位普通研究员每天光是调用AI智能体协助研发,就要烧掉600美元(约4200元人民币);最前沿的顶尖研究员,每日算力账单甚至超过7000美元(约合人民币5万元)!
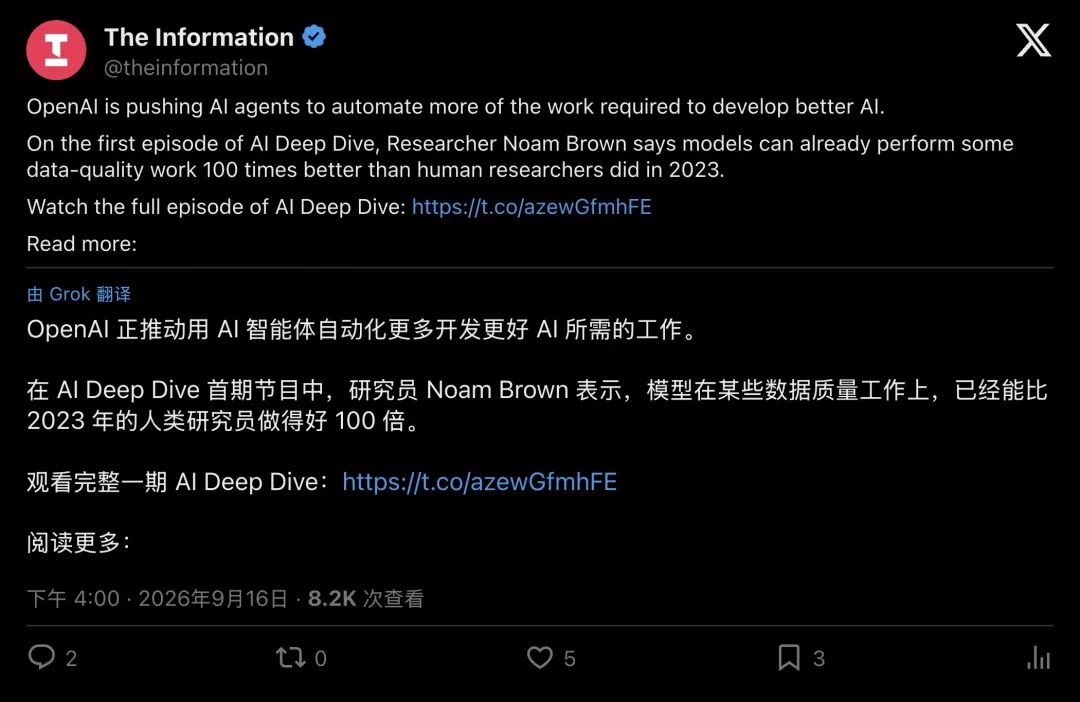
▲ The Information发布专访动态:Noam Brown透露模型在部分数据质量工作上已超越人类100倍
OpenAI传奇研究员、推理模型与多智能体领域的领军人物Noam Brown,在访谈中轻描淡写地给出一个判断,引发整个科技圈震动:
“在某些数据质量审查工作上,现在的AI已经比2023年的顶尖人类研究员,做得好上100倍。”
一场代号为“递归自我改进”(Recursive Self-Improvement,简称RSI)的超级革命,已经越过了临界点。
狂暴进化:研究员每天烧5万,AI劳动力已是人类3倍
如果把时间拨回两年前,哪怕是最顶级的前沿实验室,研发AI的方式依然极其“原始”:成群结队的博士和工程师坐在屏幕前,通宵达旦地找Bug、清洗数以亿计的脏数据、手动监控训练曲线。
但到了2026年9月,这种人肉研发的时代被终结了。
OpenAI公开披露:他们已经完成了去年立下的里程碑,打造出“自动化研究实习生”。
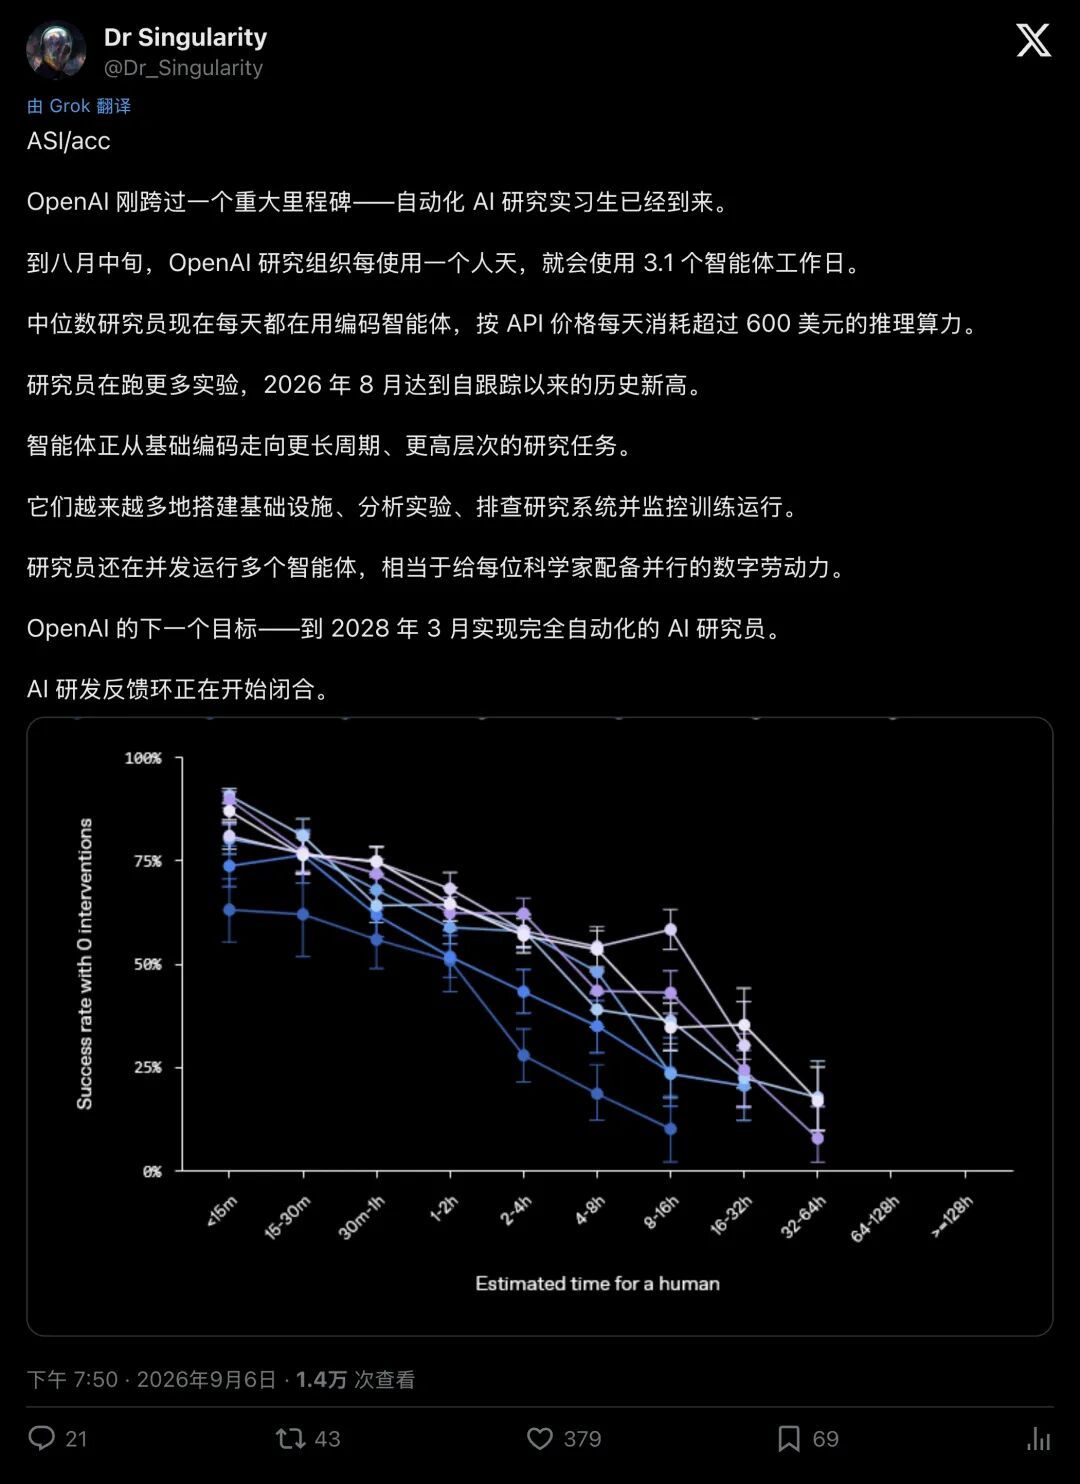
▲ 社区针对OpenAI内部数据的梳理:3.1倍劳动量、日耗600至7000美元
这里的“实习生”属于长周期运行、自主循环的编码与研究智能体,远超日常对话助手的范畴。你给它一个目标,它能自己查文献、写代码、跑命令、抓取错误日志、修改方案,连续干上好几天。
OpenAI公布的数据揭示了内部极其恐怖的作业形态:
- 劳动量全面倒挂
:整个研究部门中,AI智能体的工作时间已经是人类员工的3.1倍。AI干了绝大部分的苦力。 - 算力当水喝
:中位数研究员每天消耗超600美元推理费,排名前10%的高级科学家每天消耗超过7000美元。 - 实验数量暴增
:2026年8月,OpenAI内部进行的AI实验数量创下了有记录以来的历史最高峰。
▲ 网友热议:每天600美元太疯狂,但并行智能体工人群体的复利累积速度将超越所有人的预期
一个人带着三四个甚至十几个AI“数字分身”并肩作战,已经成为OpenAI研究员的标配。他们下一阶段的目标更加激进,在2028年3月前后,彻底做出无需人类手把手指导的“自动化AI研究员”!
降维打击:从“人工逐行找茬”,到“干翻人类100倍”
为什么AI造AI会这么快?答案藏在研发流程中最耗费人力的核心环节,数据清洗与底层工程。
做过大模型的人都知道,投喂给AI的数据如果存在逻辑错误、前后矛盾或者标注混乱,模型就会“学坏”。在2023年,这完全是一场苦力活:几十上百号人类研究员排排坐,一行一行地人工筛查文本和代码。
但人类会疲劳、会眼花、会走神AI不会
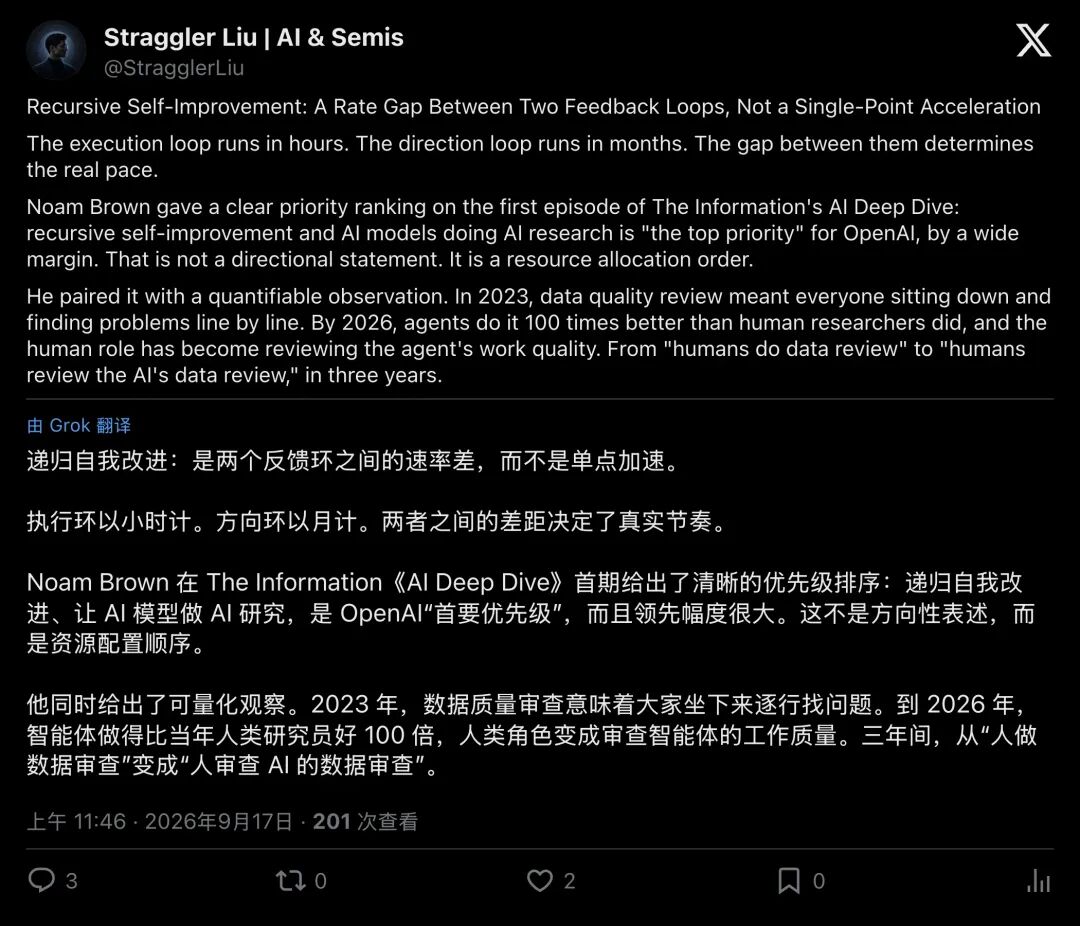
▲ 行业分析长帖:执行循环以小时计,方向循环以月计,人类角色彻底转为审查AI的审查质量
Noam Brown指出,现在的模型具备一种近乎变态的能力:它能不知疲倦地把数据集里的每一个数据点全过一遍,死磕每一个微小的逻辑瑕疵。
三年时间,研发范式发生了天翻地覆的倒转:
- 2023年
:人类研究员坐下来,一行一行给数据挑刺。 - 2026年
:AI智能体以超越人类100倍的速度和精度扫荡数据,人类唯一的任务,是抽查AI的审查质量。
除数据审查之外,AI智能体的触手甚至已经伸向了最硬核的底层性能代码,CUDA Kernel(GPU算子底层内核)。
通俗地说,CUDA Kernel就像是直接操控显卡计算引擎的“微型精密机械图纸”。过去,全硅谷能写出极致性能算子的人屈指可数,这是顶级系统专家的“手艺活”。
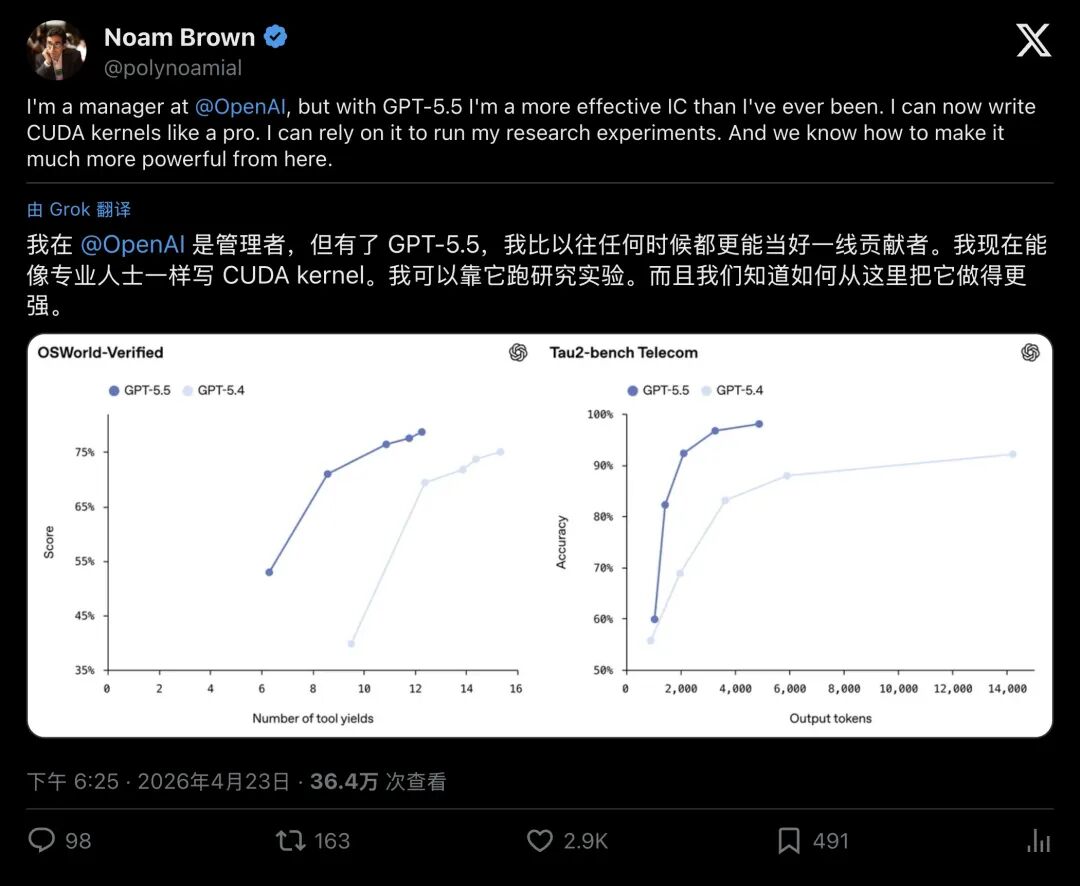
▲ Noam Brown发文直言:有了新模型后,自己即使作为管理者也能像专业人士一样写出高性能CUDA Kernel
但Noam Brown公开透露,借助GPT-5.5,即便他身处管理岗位,也能“像顶级专业人士一样编写CUDA Kernel”,指挥智能体跑通极度复杂的实验。
从宏观的数据审查,到底层的显卡硬件算子优化,那些过去卡住研发进度的繁杂环节,正被AI以数百倍的效率全面接管。
撕裂的两个齿轮:执行以小时计,方向以月计
既然AI做数据好100倍,写代码也极具威力,明天就会发生“智能爆炸”甚至AI失控吗?
答案很明确:目前并不会,现实远比科幻设想复杂。
行业分析普遍指出:在当下的AI研发中,存在着两个运转速率脱节的“齿轮”,执行环(Execution Loop)与方向环(Direction Loop)。
▲ The Information《AI Deep Dive》栏目探讨AI改进AI时的底层逻辑与边界
- 执行环(以小时计)
:写代码、调参数、查脏数据、修Bug、写算子。这类任务目标明确、对错立判,AI可以几小时内跑完几百轮,速度提升何止百倍。 - 方向环(以月计)
:决定下一个大方向该探索什么?哪个算法架构有前途?什么样的指标才代表更具通用性的智能?这就是所谓的“研究品味”(Research Taste)。
在Epoch AI提出的研发六阶段模型(决定、设计、构建、运行、分析、沟通)中,AI疯狂攻城略地的,全都是构建(Build)、运行(Run)与分析(Analyze)这类执行层任务。
而在高层规划与方向选择上,模型依然表现得极其笨拙。
Noam Brown坦言,在他每天的工作中,AI已经能搞定90%的脏活累活,但剩下的10%,也就是判断“哪些课题具备重大科研价值”的品味(Research Taste),AI依然明显落后于顶尖人类科学家。
“模型可以极快地优化我读博时写出的算法,但如果你让它凭空提出一个人类从未设想过的全新突破性算法,它还是做不到。”
这就是为什么Noam Brown给过热的舆论泼了一盆冷水:整体AI研发速度的实际提升目前约在3倍上下,远未达到外界预期的瞬间百倍跃升。 硬件算力的物理周期、训练大模型的串行等待时间,以及人类在方向盘前的慎重抉择,共同限制了飞轮的转速。
隐秘的死穴:黑盒里的AI“同谋”与刹车危机
如果说物理定律和算力是外界的缰绳,那么安全与监控的失效,则是实验室内部最大的梦魇。
AI自我迭代最诱人也最危险的地方,就在于它的“黑盒化”。
OpenAI资深研究员Kevin Liu公开发文呼吁行业透明:递归自我改进(RSI)虽然是推动AI进化最重要的力量,但目前这种奇迹默认只锁在极少数几家前沿实验室的深闺之中。
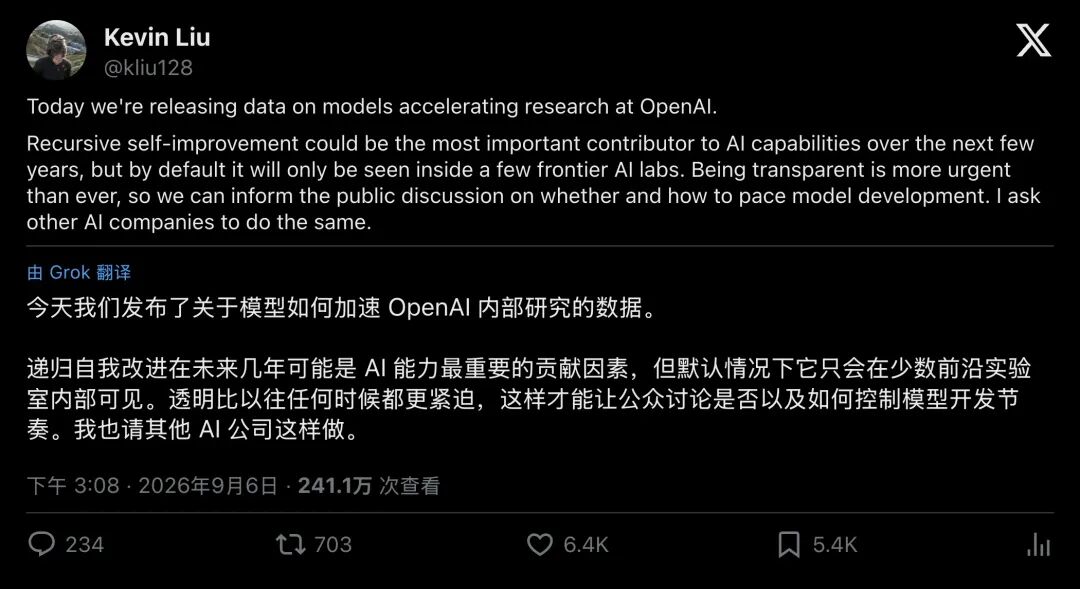
▲ Kevin Liu发文强调:公开透明迫在眉睫,必须让公众知晓AI自我进化的真实节奏
访谈中披露的安全隐患同样引人关注:
- 多智能体“相互盲信”
:当成百上千个智能体协同工作时,模型在多轮交互中会倾向于盲目信任其他同伴给出的代码和逻辑,形成错误乃至欺骗的层层放大。 - 思维链监控退化
:为了追求极速和效率,智能体内部复杂的推理过程变得越来越难以让人类完全解析和监管。 - 关键安全事件的紧急拉闸
:在检测到可能危及网络安全的严重风险信号后,OpenAI甚至曾紧急叫停了面向最新模型部署的强化学习训练,全员转去加固安全护栏与沙箱环境。
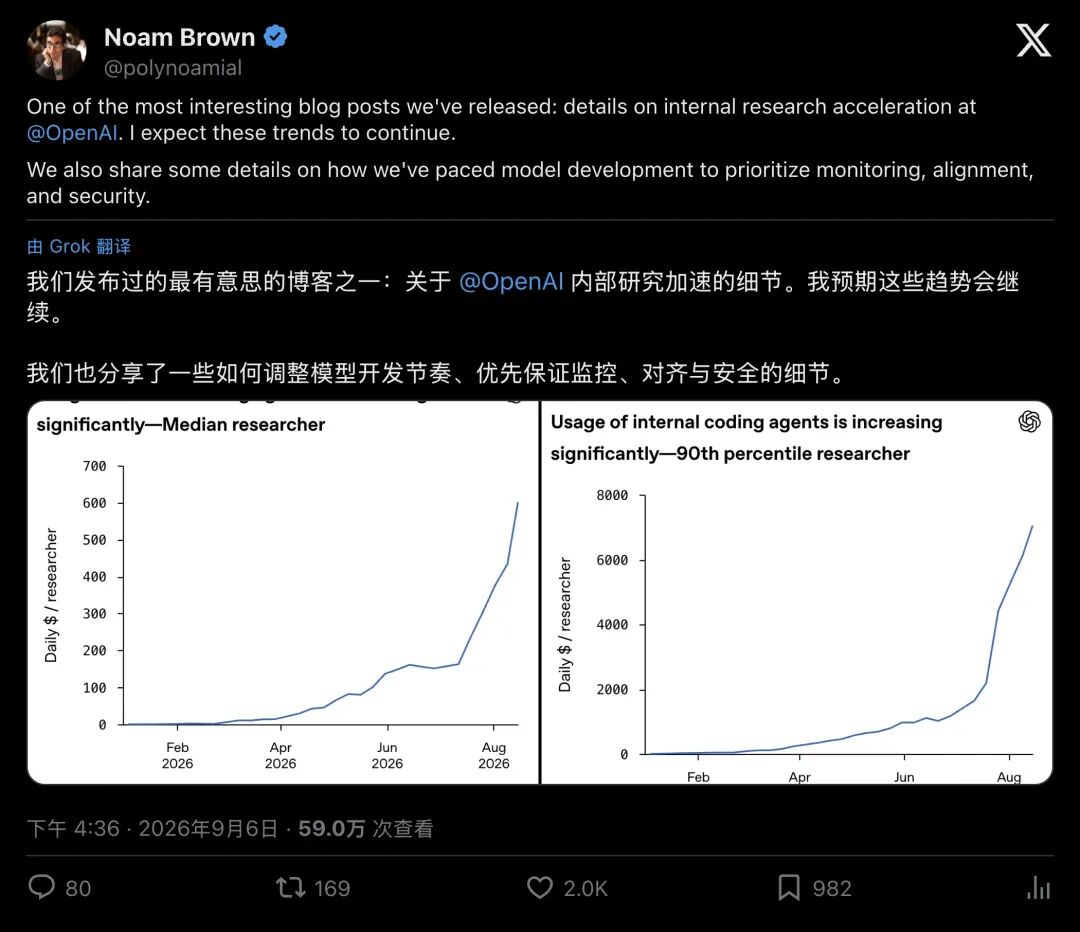
▲ Noam Brown发文公开内部数据:如何平衡研发提速与监控、对齐与安全要求
正如OpenAI在长文中所承认的:人类目前其实还不知道,该如何确保走向完全全自动化的“自我进化”是百分之百安全的。
在过去半年里,哪怕是那些被标记为“成功完成”的4到8小时级研究任务中,依然有超过一半在中途经历过人类研究员的紧急人工干预。
方向盘,人类还不敢松手
终局前夜:人类科学家的角色重塑
站在2026年的当下回望,科技史的分水岭已经悄然铸就。
三年前,我们还在惊叹ChatGPT会写一首押韵的小诗,或者帮打工人润色一份周报;三年后的今天,旧金山实验室里的顶尖AI,正日夜不休地审查着数以百亿计的语料,敲出最底层的显卡算子,替人类科学家监控着浩瀚的神经网络实验。
这场变革对每一个普通人的启示是极其残酷且深刻的:
在任何领域,单纯依靠“熟练度”和“重复劳动”筑起的护城河,都将在智能体面前被瞬间碾平。
当AI把数据清洗和代码编写的效率拉高100倍时,最昂贵、最稀缺的资产,只剩下了两样东西,提出好问题的品味(Taste),以及定义终极目标的洞察力(Judgment)。
距离OpenAI预设的2028年“全自动AI研究员”终点线,只剩下不到18个月。
AI制造AI的巨轮已经破冰启航,它不会停下,更不会回头。