ARTICLE · 1043334
26名放射科医生跟AI比了一次,23个输给它
昨天晚上刷到一篇 Science,我一开始没当回事。医学影像AI的论文太多了。
往下翻到那个人机对比的表格,我坐直了。14家医院,26名放射科医生。
模型的平均表现,优于其中23名。
先把话说在前面:我不想写那种「AI医生来了,放射科完蛋了」的东西。
那种文章我自己就读过。回头看全是断章取义。
这次不太一样。不一样在哪,我写在下面第四节。
它到底做了个什么东西
9月17日美东时间在线发表,9月18日上了《Science》正刊。阿里达摩院联合浙大一院等单位做的,模型叫 DAMO RADAR。
面向腹部增强CT,覆盖18个腹部解剖结构、146种病症和影像学表现。
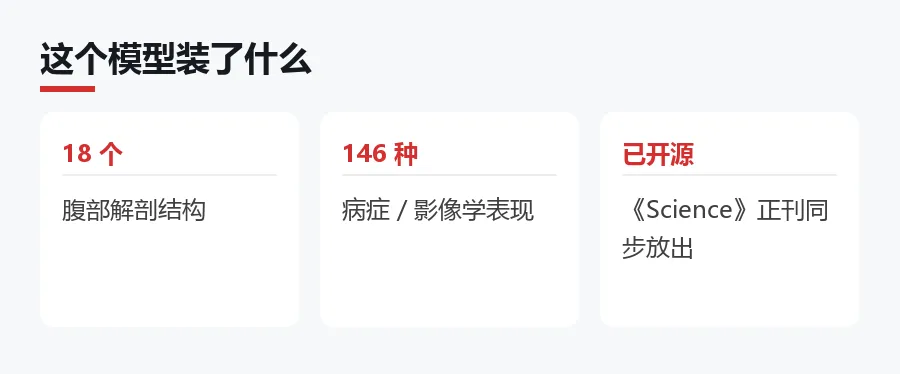
研发方的原话是:这是首个达到专家水平的通用医学影像AI模型。同时开源。
重点在「通用」这两个字。过去的路子是专病专做——肺癌一个模型,肝癌一个模型,胰腺癌再单独来一个。
它走的是另一条:先做器官级的解剖学配准,把不同病人的同一个器官摆到能对上的位置,再让模型在这个统一坐标里学。
这么做的直接结果是,能力从「一种病一个模型」,变成了「一次扫描全腹排查」。
(顺带承认一句:「配准」这个词我今天特意翻了半天才敢用。做影像的同行要是觉得我用岔了,评论区骂我,我改。)
数字是这个样子的
三组队列,我一条条抄下来。
浙大一院自己的连续队列:39,160例,平均 AUC 0.913。
8家中心的外部验证:24,239例,平均 AUC 0.895。
14家医院、26名影像科医生参与的人机对比:模型平均表现优于其中23名。
另外,肝癌、胰腺癌、胃癌、结直肠癌对着病理金标准测,AUC 落在 0.891 到 0.984 之间。
还有一组我觉得比前面都值得看:在没有专门训练过的急诊场景里,约2.7万例、17种急腹症,平均 AUC 还有 0.904。
39,160例到底是多少?我按一个放射科医生一天读30例腹部CT、一年250个工作日算,大概7,500例。
也就是说,光第一个队列的量,相当于一个医生连读五年多。
这个数字我自己算完之后愣了一会儿。
泼冷水的部分
下面这段,如果你想只看热闹,可以跳过。但我认为这四句才是这篇论文真正的价值。
第一,0.913是个平均数。146种病,常见病样本多,罕见病可能就几十上百例。0.891到0.984这个区间本身就说明事:有的病它很行,有的病它也就那样。平均数,是会替弱势项目打掩护的。
第二,换个医院就掉:0.913 → 0.895。掉了0.018,听着不大。但这恰恰是所有落地的分水岭。设备换了、层厚变了、造影方案不一样、人群构成也不一样。
张江那个会上有位同行说了句很像的话:模型面对没见过的东西,性能会衰减。放这儿挺合适。
第三,「赢了23名医生」这句话必须说全。
它的完整表述是:在这26位参与对比的医生里、在这个数据集上、按平均表现算。它不等于「AI比放射科医生强」。你要是把它读成后者,那是标题党的读法,不是论文的读法。
第四,那两个提效数字,我也留了个心眼。
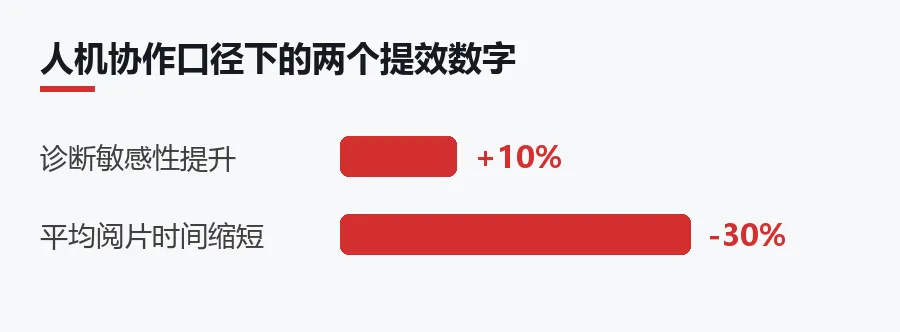
诊断敏感性提升10%,平均阅片时间缩短约30%。注意口径——这是「辅助阅片」,不是「机器单独阅片」。这两个数字是人机协作的结果,不是机器单干的结果。
而且,时间省下来30%,是不是就意味着以后少招人?我不确定。也许它意味着把以前没时间看的旧片子翻出来重看。
这笔账我到现在也没算明白,所以不给你一个确定的答案。
那它真正改变的是什么
1. 门槛从算法转到了数据。
模型开源了,代码能下。你复现不了的从来不是那几行代码,是那39,160例带病理对照、清洗过、标注过的腹部CT。接下来谁手上有干净的临床数据,谁才拿到下一轮的入场券。
2. 专病模型这条赛道在塌。
如果你手里正做一个「某某癌影像预测」的课题,先想清楚一件事:跟这种走器官级配准的通用模型比,你的增量在哪?是更细的亚型、某个罕见表现、还是一支别人没有的随访队列?
如果只是换个数据集再跑一遍——我知道这话难听——含金量在往下掉。开题前想清楚,比中期才发现白干要强。
3. 短期最值钱的,是能把它接进工作流的人。
敏感性+10%、时间−30%,前提都是「人机协作」。会用的人在涨,不用的人原地站着。
最后
我知道评论区一定会有人说:又是阿里发的稿。
这话我不反驳。数据确实是研发方给的,论文口径就是论文口径。
但我想问的是另一件事。
模型开源的那一天,你觉得下一轮拼的是什么?还是算法吗?
文中数据核对自 DAMO RADAR 论文(Science,2026年9月17日在线发表)及中国新闻网、新智元等公开报道,截至2026年9月20日。AUC、人机对比结果与提效幅度均为论文及研发方自述口径,不同队列差异较大,具体以正式论文为准。本文不构成任何诊疗或用药建议,亦不构成投资建议。