ARTICLE · 1048024
Nature重磅警告:AI狂吃自己拉的数据,9代后彻底疯癫!巨头狂砸2.5亿疯抢“人类存粮”
给你一段严肃的历史资料:中世纪英国教区的石匠如何建造教堂塔楼。
把这段话喂给一个大语言模型,让它接着往下写;再把模型写出来的文字,原封不动喂给第二代模型;然后是第三代、第四代……
猜猜到了第九代,AI 会写出什么?
它早已把建筑力学与宗教历史抛到了九霄云外,屏幕上只吐出一串令人毛骨悚然的胡话:“黑尾、白尾、蓝尾、红尾、黄尾的长耳大野兔(jackrabbits)。”
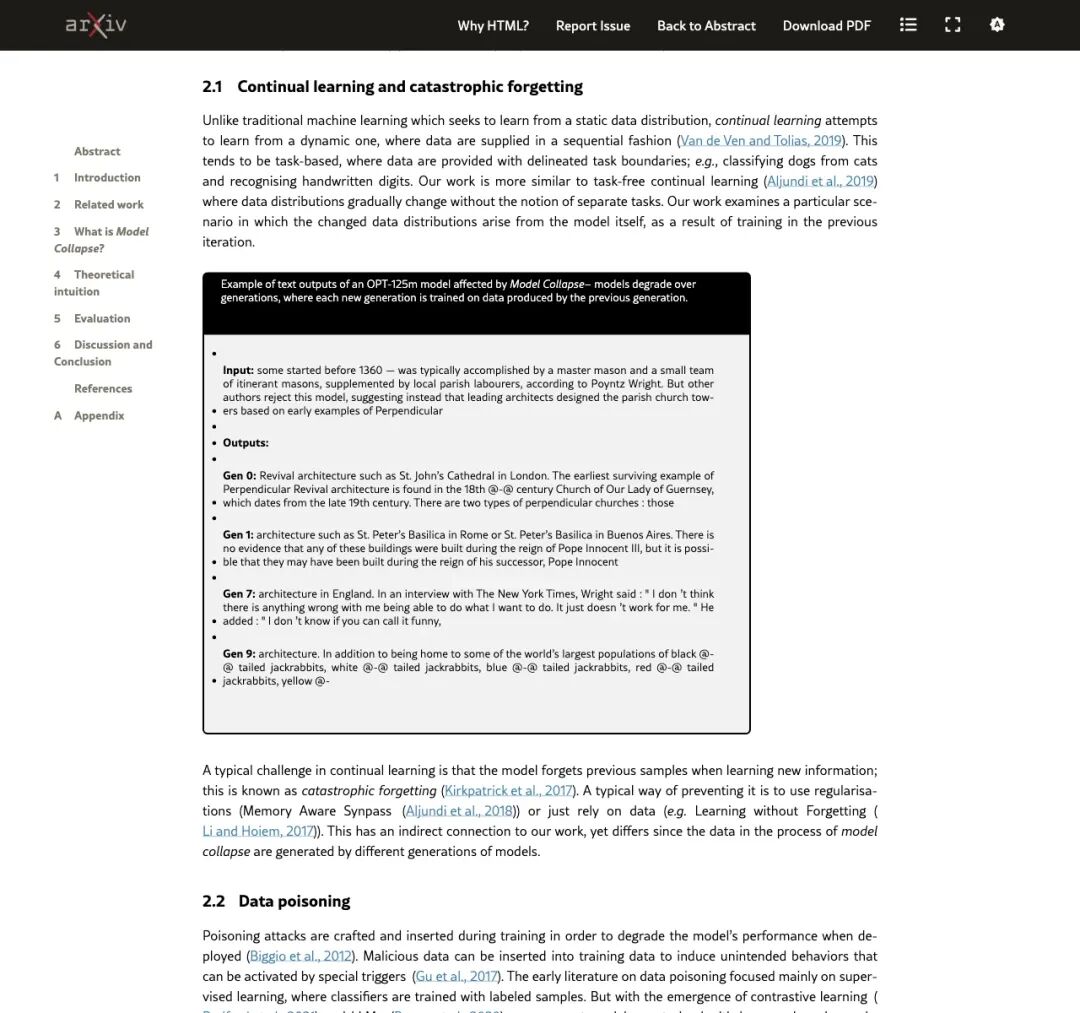
▲ 论文实验记录:从第0代讨论中世纪建筑,到第9代彻底退化为“彩色长耳大野兔”清单
从大教堂到五彩斑斓的野兔,AI 在短短九代之内,彻底发了疯。
五彩野兔的故事绝非网民随手编造的段子,它出自顶尖科学期刊《自然》(Nature)刊发的重磅封面研究。牛津大学和剑桥大学的联合团队给这种不可逆的退化起了一个冰冷的名字:模型崩溃(Model Collapse)。
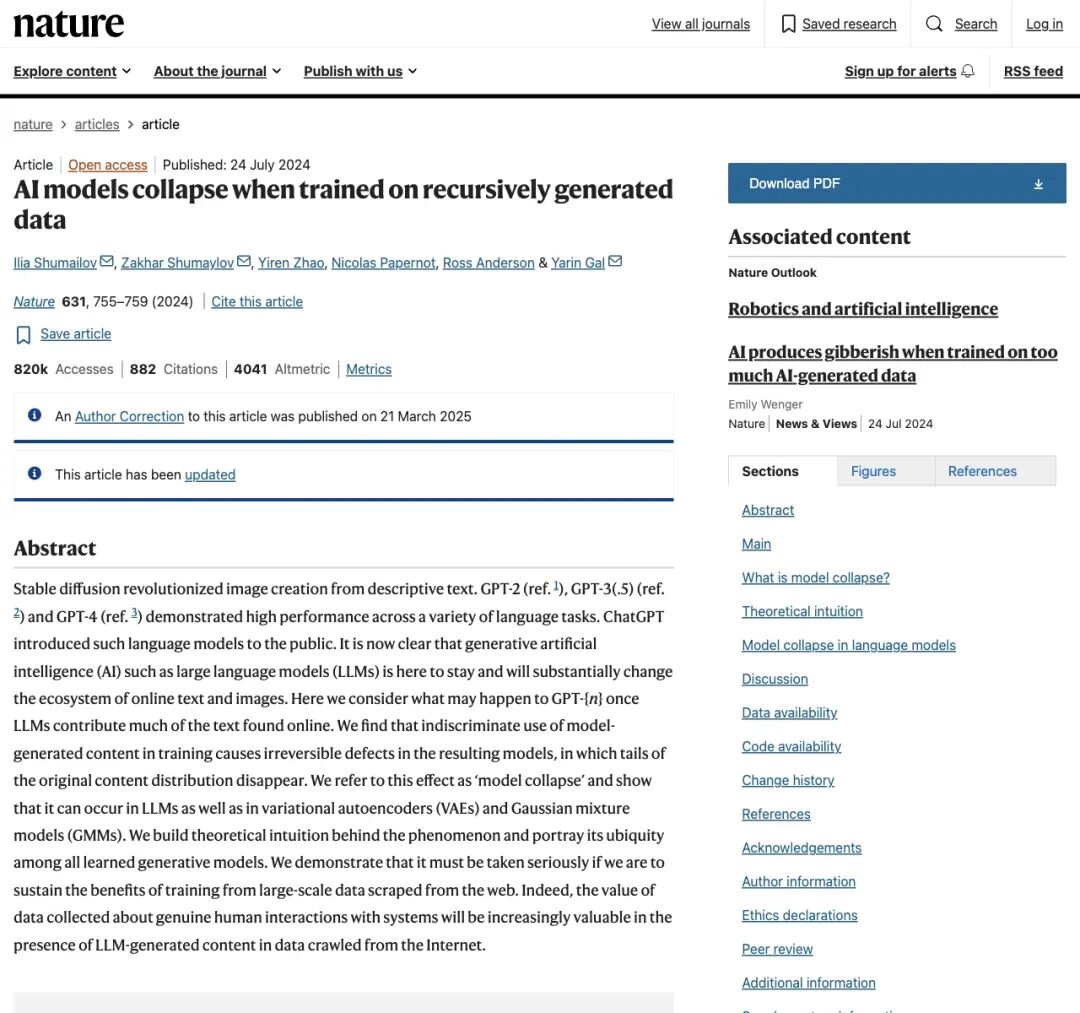
▲ 发表于《自然》(Nature)正刊的论文:递归生成数据导致模型崩溃
当整个硅谷都在高呼“用 AI 生成的数据训练更强 AI”时,这篇论文像一盆刺骨的冰水,直接泼在了所有狂热者的脸上:吃自己的排泄物长大的 AI,注定会走向脑死亡。
杀光“长尾”:AI 是如何一步步把自己变蠢的?
要搞懂模型为什么会崩溃,不需要高深的数学背景。
你可以把它想象成一台复印机在反复复印自己的复印件。第一张复印件或许很清晰,但如果你拿复印件再去复印,连续复印十次,原本细腻的阴影会变成死黑,微弱的线条会彻底消失,最后只剩下一团模糊的脏斑。
在统计学上,人类的语言分布就像一座山峰。
中间最高最鼓的部分,是最常见、最符合大众直觉的平庸表述(比如“今天天气很好”“人工智能改变未来”);而山峰两边细长拖尾的边缘,被称为长尾(tails)。
长尾里藏着什么?藏着罕见的词汇、偏门但真实的史料、小语种的诗歌、少数群体的独特体验,以及人类思想中最具独创性的火花。
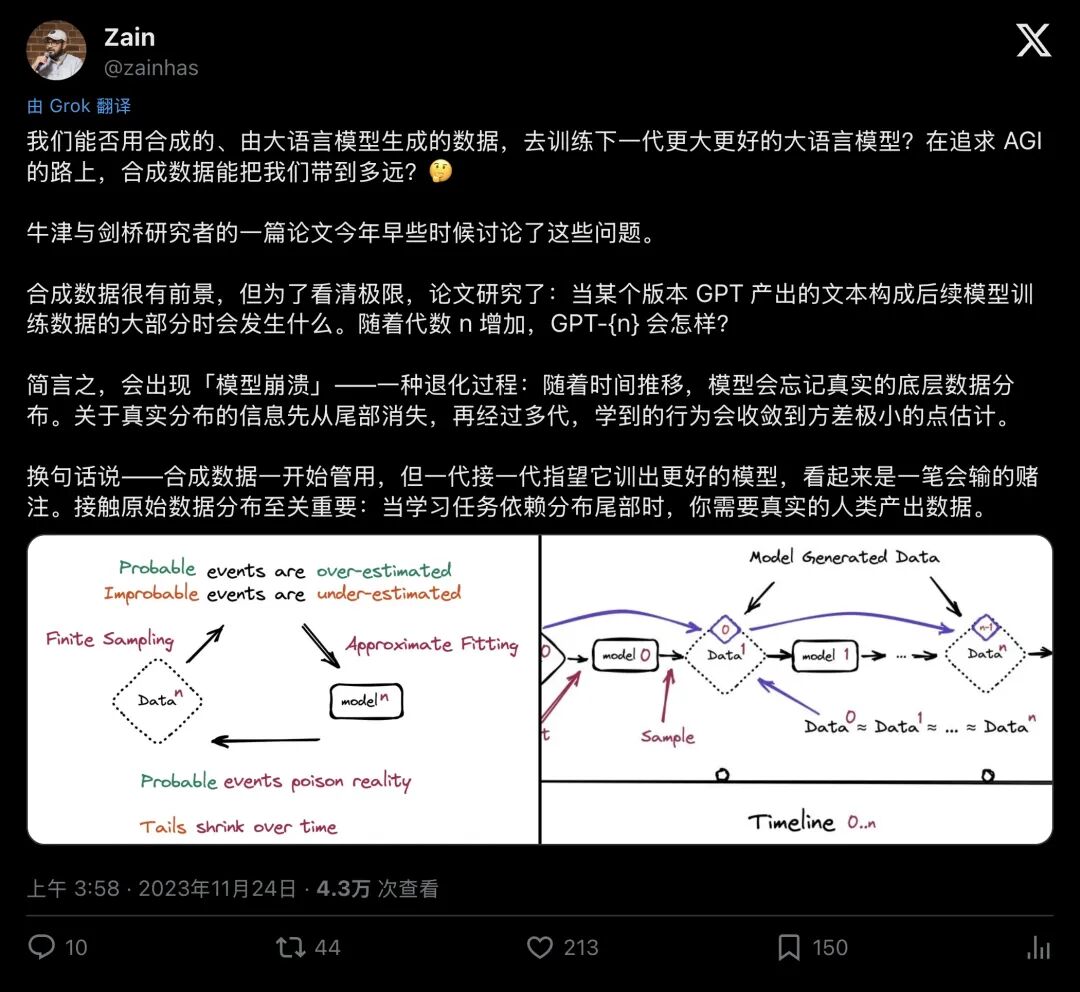
▲ 研究指出:模型崩溃最先杀死的就是数据分布中的“长尾”
问题恰恰出在这里
大模型在生成内容时,本质是在做概率采样。为了保证输出的“合理”,它会本能地倾向于选择概率最高的中间部分,而稍微忽略那极其罕见的长尾。
- 第一代模型
:丢掉了 5% 最偏僻的罕见知识; - 第二代模型
:以第一代的输出为教材,误以为世界原本就只有剩下那 95%,于是再丢掉 5%; - 到了第五代、第九代
:原本丰富多彩、充满毛刺的真实世界,被层层过滤、反复均质化,最终退化成一个方差趋近于零的单点死寂。
在生物学上,这叫近亲繁殖(Inbreeding);在医学上,这叫自噬障碍(Autophagy Disorder);在 AI 圈,甚至有人给它起了个恶搞却贴切的外号,“哈布斯堡 AI(Habsburg AI)”,借指那个因极度近亲通婚而导致容貌畸形、血脉凋零的古老欧洲皇室。
当 AI 不断吞食自己吐出的平庸句子,它不仅遗忘了世界的复杂,更会把祖先犯下的微小错误成倍放大,最终在第九代指着大教堂狂喊“五彩野兔”。
74% 的网页已沦陷!互联网正在沦为“AI 疯牛病”培养皿
如果这仅仅是实验室里的小规模测试,科技巨头大可一笑置之。
但可怕的现实是:整个公开互联网,正在以惊人的速度变成一个巨大的自噬循环。
SEO 巨头 Ahrefs 对 2025 年新发现的 90 万个英文网页进行了一次彻底摸底,结果令人不寒而栗:高达 74.2% 的新网页,已经含有 AI 生成的内容。 纯人类撰写的网页,竟然只剩下了可怜的 25.8%。
▲ Ahrefs 调查发现:近四分之三的新网页充斥着生成式 AI 的痕迹
一键生成的垃圾博客、为了骗取搜索流量的伪原创农场、社交平台上泛滥的自动回复机器人……免费且无限量的生成按钮,正在以每秒数以万计的速度向公网排放数字废水。
这就构成了一个致命的生态死循环:
人类把 AI 文本发到网上 → 爬虫把网上的 AI 文本抓回数据库 → 实验室用这些数据训练下一代大模型 → 下一代模型产出更多垃圾。
这像极了二十世纪英国农场里发生的那场灾难:为了节约成本,农场主把病死牛的肉骨粉加工成饲料喂给健康的牛,最终酿成了席卷全球的疯牛病危机。
类似荒诞的场景正在社交平台上演
一位博主在 X(推特)上写下长篇警示,痛陈 AI 正在污染互联网生态,然而评论区最犀利的嘲讽却来自一位眼尖的读者:
“你这篇帖子的遣词、节奏和结尾总结,读起来简直和市面上所有 AI 生成的帖子一模一样。用 AI 写的文章来警告人类不要用 AI,赶紧坦白交代吧!”
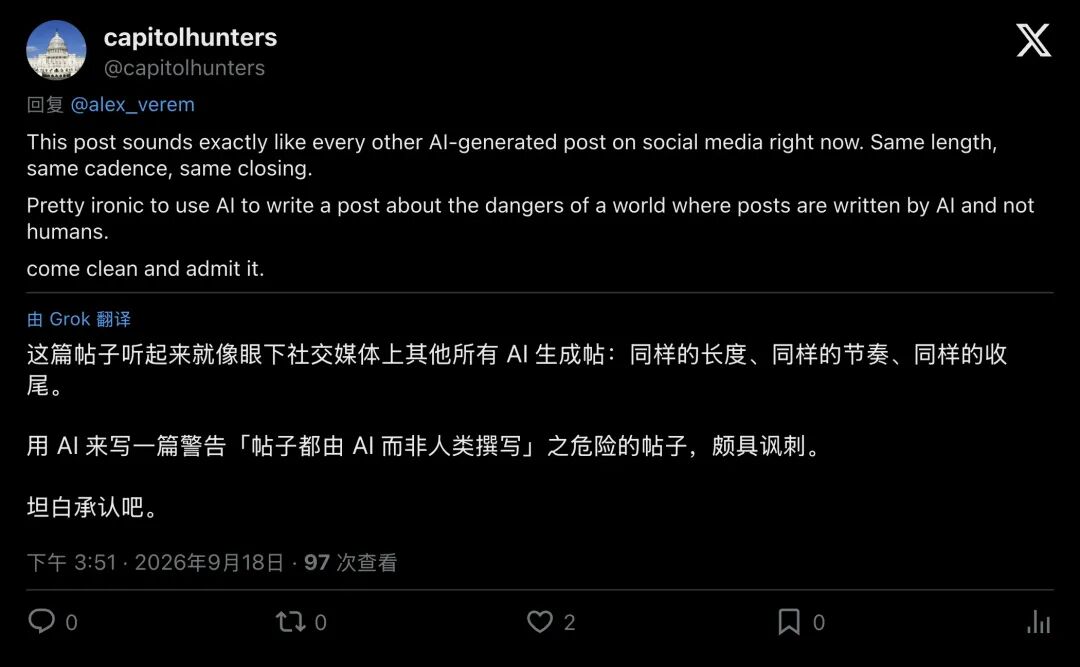
▲ 网友无情吐槽:用标准的 AI 腔调去呼吁防范 AI 污染
连人类自己都在不自觉地被 AI 的语言模式所同化,甚至把“平庸、光滑、没有语病”当成写作的标准。本想驾驭技术的创作者,不知不觉间已沦为这台复印机里反复吞吐的纸张。
狂砸 2.5 亿美元!科技巨头为何疯抢“前 AI 时代的人类废话”?
资本的嗅觉永远比学术界的论文更灵敏。
早在 Nature 论文正式刊出之前,敏锐的巨头们就已经意识到了这场“数据荒荒年”的逼近。
2024 年 5 月,OpenAI 与拥有《华尔街日报》《纽约邮报》的新闻集团(News Corp)达成了一项为期多年的重磅协议,总价值据报道超过 2.5 亿美元。
▲ The Verge 报道 OpenAI 与新闻集团达成超 2.5 亿美元内容授权
OpenAI 并不缺少这几篇当天的财经快讯,他们锁定的核心资产,是新闻集团旗下媒体跨越数十年、甚至上百年的历史报刊档案!
那是诞生在 ChatGPT 出现之前的数据。那是纯粹由人类记者在打字机前抓耳挠腮、深入现场调查、带有偏见、灵气与独特文风的“纯净人类语料”。
在 AI 废水淹没互联网的今天,“2022 年之前的人类文本”已经变成了数字时代的低本底钢(指二战核爆前生产的未受放射性同位素污染的珍贵钢材)。
谁手里握有未被 AI 污染的原始人类数据,谁就筑起了下一代大模型训练的护城河。Scale AI 创始人 Alexandr Wang 在谈到这篇 Nature 论文时直言不讳:
“很多研究者把合成数据当成 AI 的点金石,但天下没有免费的午餐。纯粹吃合成数据是在欠债,未来必须靠真实数据来偿还。”
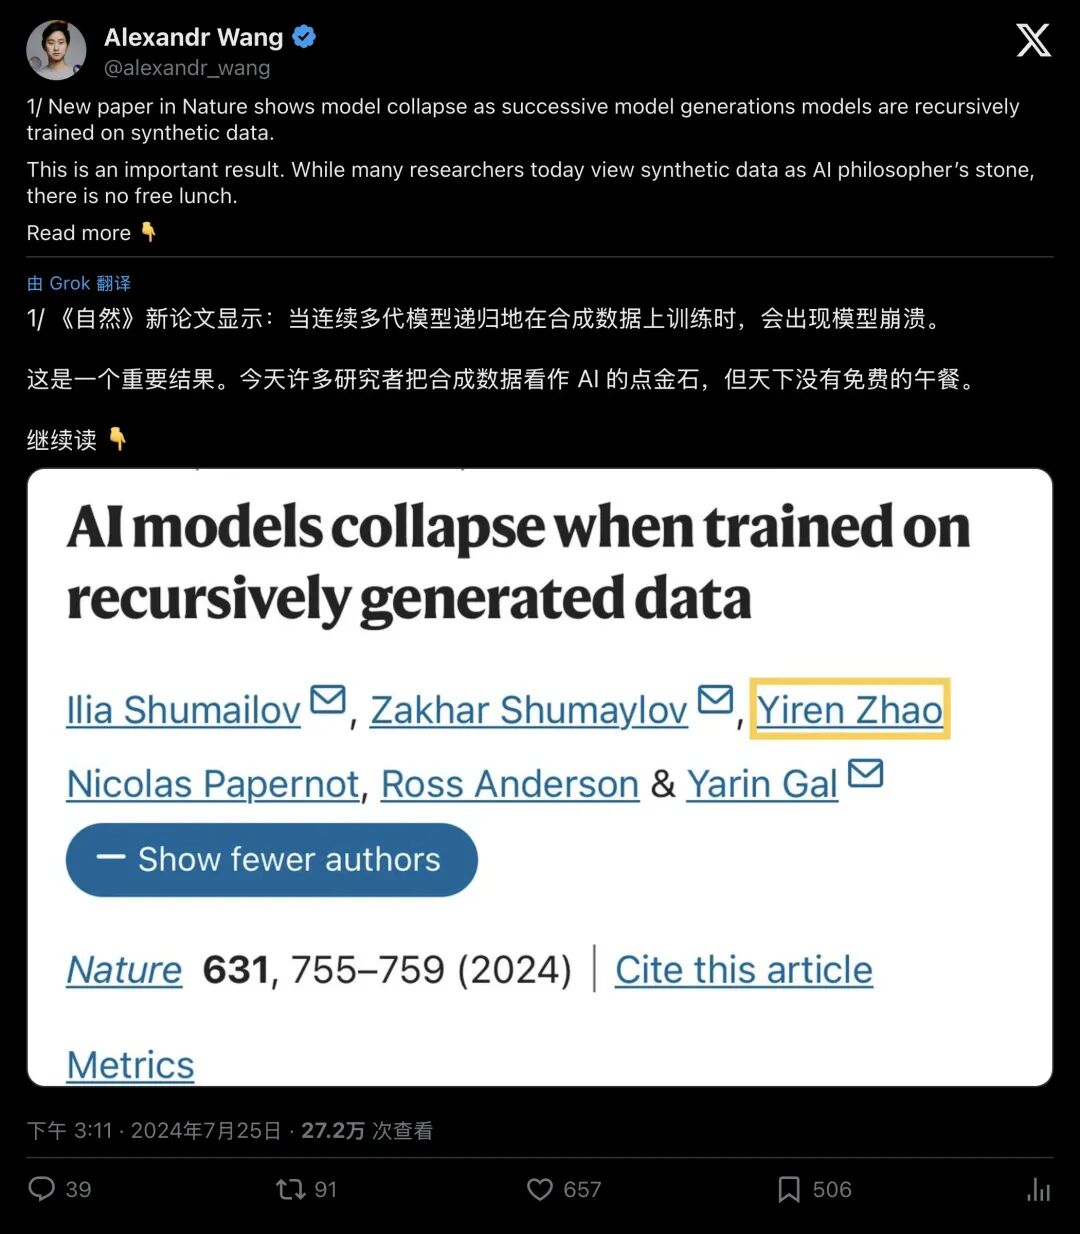
▲ Scale AI 创始人直言:合成数据绝非万灵药,天下没有免费的午餐
我们该如何破局?以及人类最后的护城河
难道合成数据真的一无是处吗?
科学界随后的探索给出了更精细的答案:崩溃并非绝对不可逆,关键在于你如何使用数据。
后续来自斯坦福等团队的研究(如 arXiv:2404.01413)指出:
- 替换 vs 累积
:如果每一代把真实数据全盘扔掉、只用生成数据替换,模型必死无疑;但如果把真实数据像基石一样保留下来,仅将高质量合成数据作为补充不断累积,退化就会被大幅遏制。 - 守住 10% 的红线
:只要在训练集中持续混入 10% 以上未经污染的真实人类数据,大模型的性能就能维持在相对健康的水平。
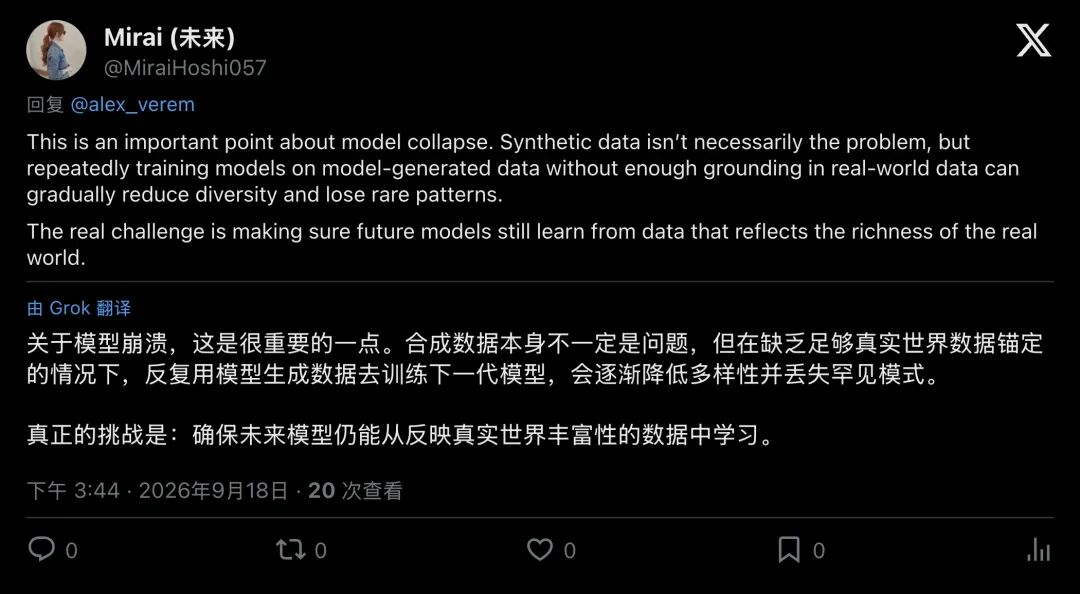
▲ 开发者指出:合成数据本身并无原罪,关键在于不能脱离真实世界的锚定
但这依然给全人类敲响了警钟
我们正处在一个极其诡异的历史节点上:一方面,算法在疯狂地将人类的语言加工得越来越得体、平滑、滴水不漏;另一方面,最顶级的实验室却在不惜代价地搜寻人类那些笨拙、粗粝、未被修饰过的原始痕迹。
一位网友在探讨模型崩溃时写下了这样一段话:
“你写出了一句只有你自己经历过那种痛苦才能写出的句子。你嫌它不够流畅,把它扔给 AI 润色。AI 把它改得词藻华丽、毫无破绽,但那句句子里最稀有的灵魂,就这么永远消失了。”
这就是 Nature 论文留给这个时代最深刻的洞察:
大模型的平庸化,是数学的必然;而人类唯一的特权,正是我们的不可预测。
那些怪诞的联想、方言里的俗语、小语种里的悲欢、甚至偶有瑕疵的粗粝句子,绝非算法需要强行洗掉的“噪音”,它们是人类文明独特的“长尾”,也是阻挡我们退化为九代后发疯野兔的最后一道防线。