ARTICLE · 1048154
合规一图懂|人工智能安全治理框架 3.0:15 张图看懂“会自己干事”的 怎么管
《人工智能安全治理框架 3.0》
你用的 AI,正在从“回答问题”变成“替你办事”。
它会调用工具、访问数据、执行动作,甚至记住你的偏好、自己规划下一步——这一步跨出去,治理的逻辑就全变了:不再只是“模型说了什么”,而是“它做了什么、动用了什么权限、留下了什么痕迹”。
2026 年 9 月 14 日(国家网络安全宣传周),全国网络安全标准化技术委员会(TC260)在国家网信办指导下发布《人工智能安全治理框架 3.0》。这是继 1.0、2.0 之后的年度更新版,定位为“敏捷治理框架”。
一句话:治理必须跟上“会自己干事”的 AI。
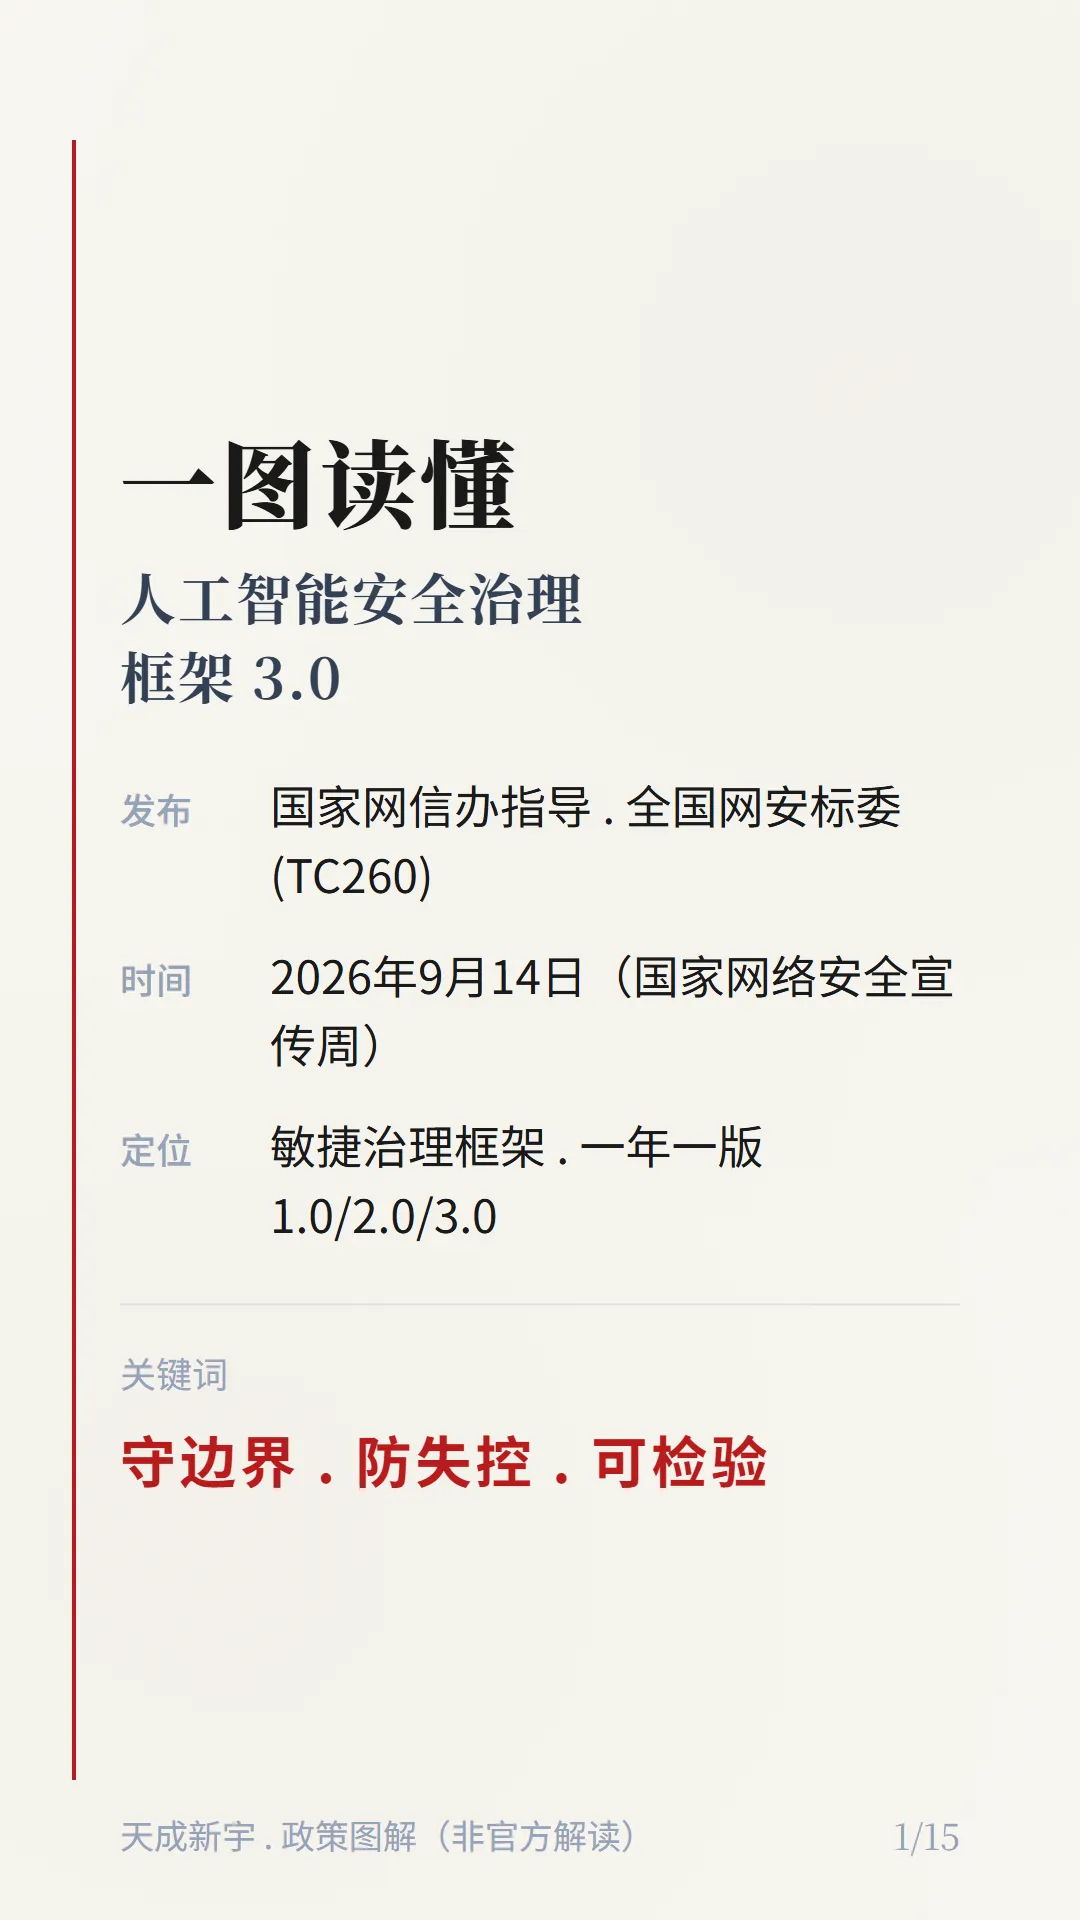
先记住三个关键词——守边界、防失控、可检验。本期 15 张图,就围绕这三件事展开:边界在哪、失控怎么防、治理能不能被检验。
👉 发布主体:国家网信办指导、全国网安标委(TC260);发布时间:2026 年 9 月 14 日;定位:敏捷治理、一年一版(1.0 / 2.0 / 3.0)。
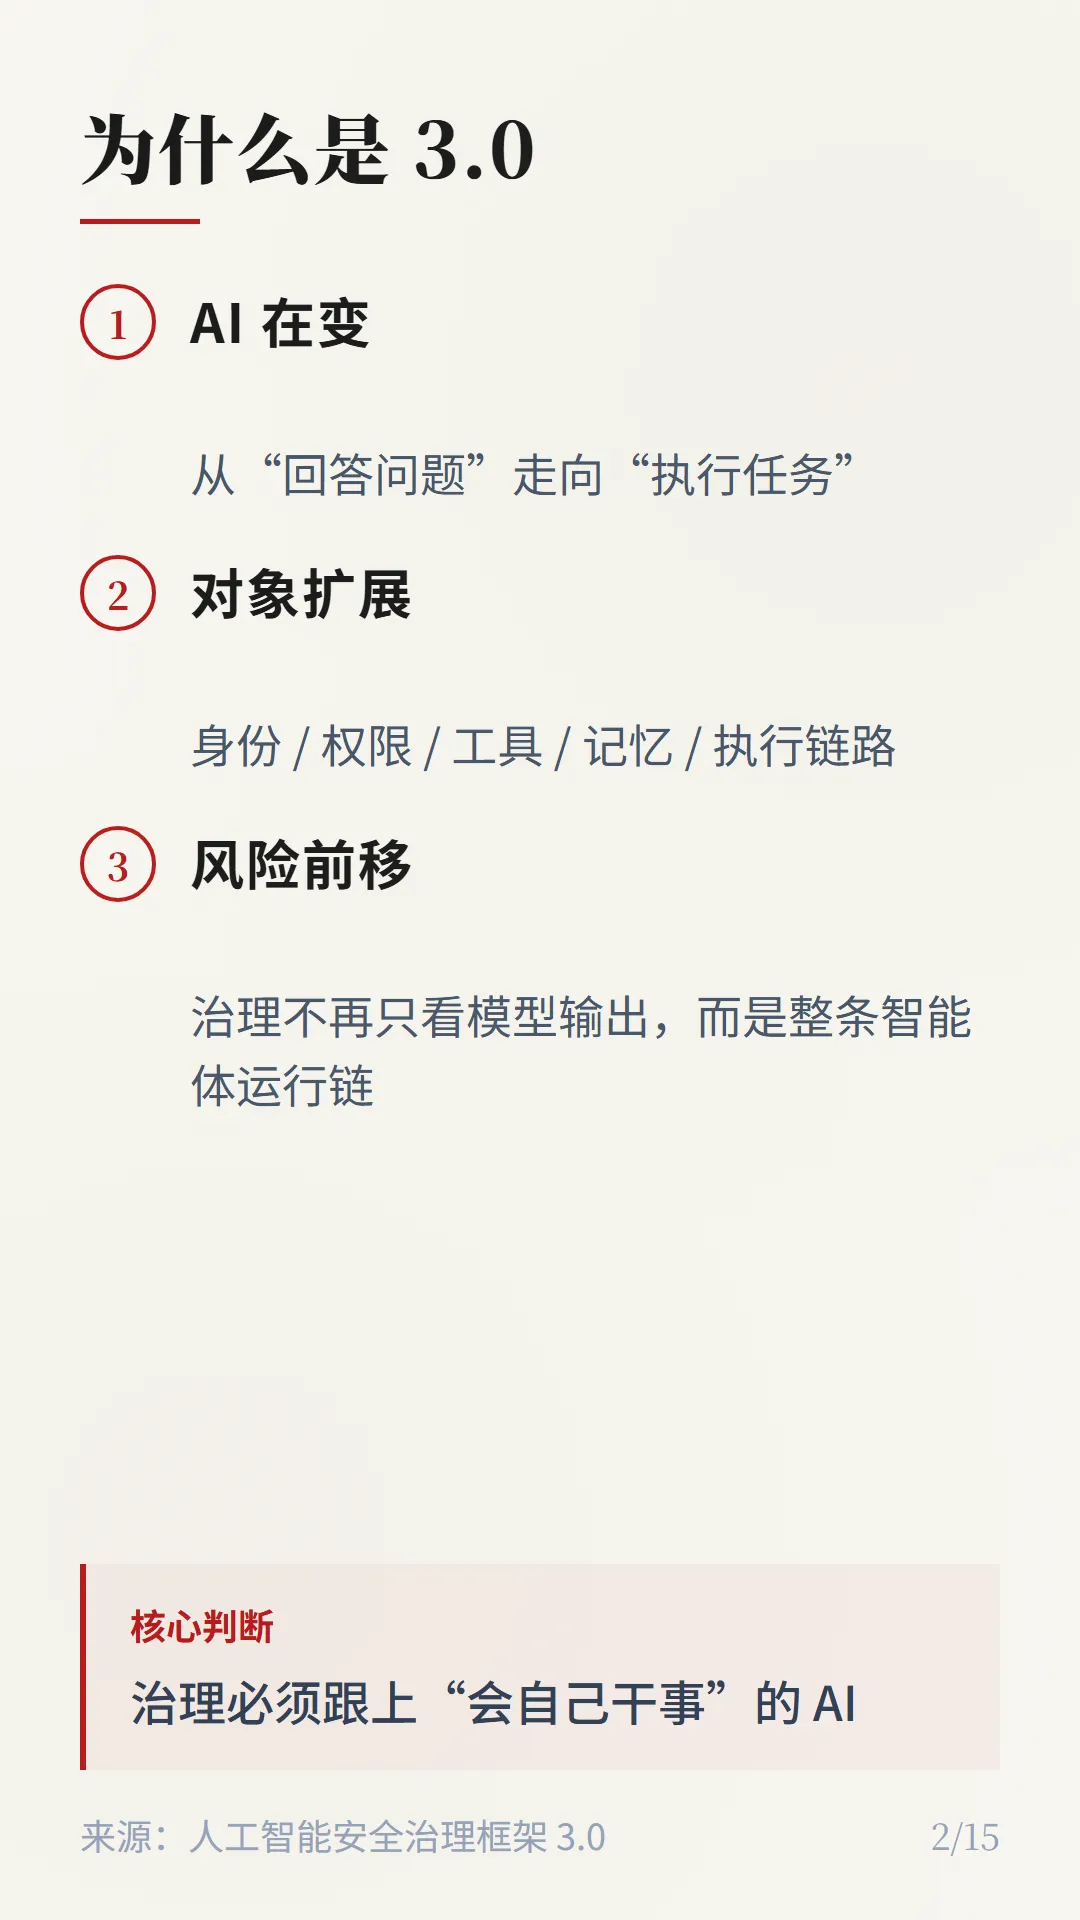
为什么要从 2.0 走到 3.0?三个变化把治理往前推了一步:
其一,AI 在变——从“回答问题”走向“执行任务”;
其二,对象扩展——身份、权限、工具、记忆、执行链路都进了治理范围;
其三,风险前移——治理不再只看模型输出,而是整条智能体运行链。
一句话收束:治理必须跟上“会自己干事”的 AI。
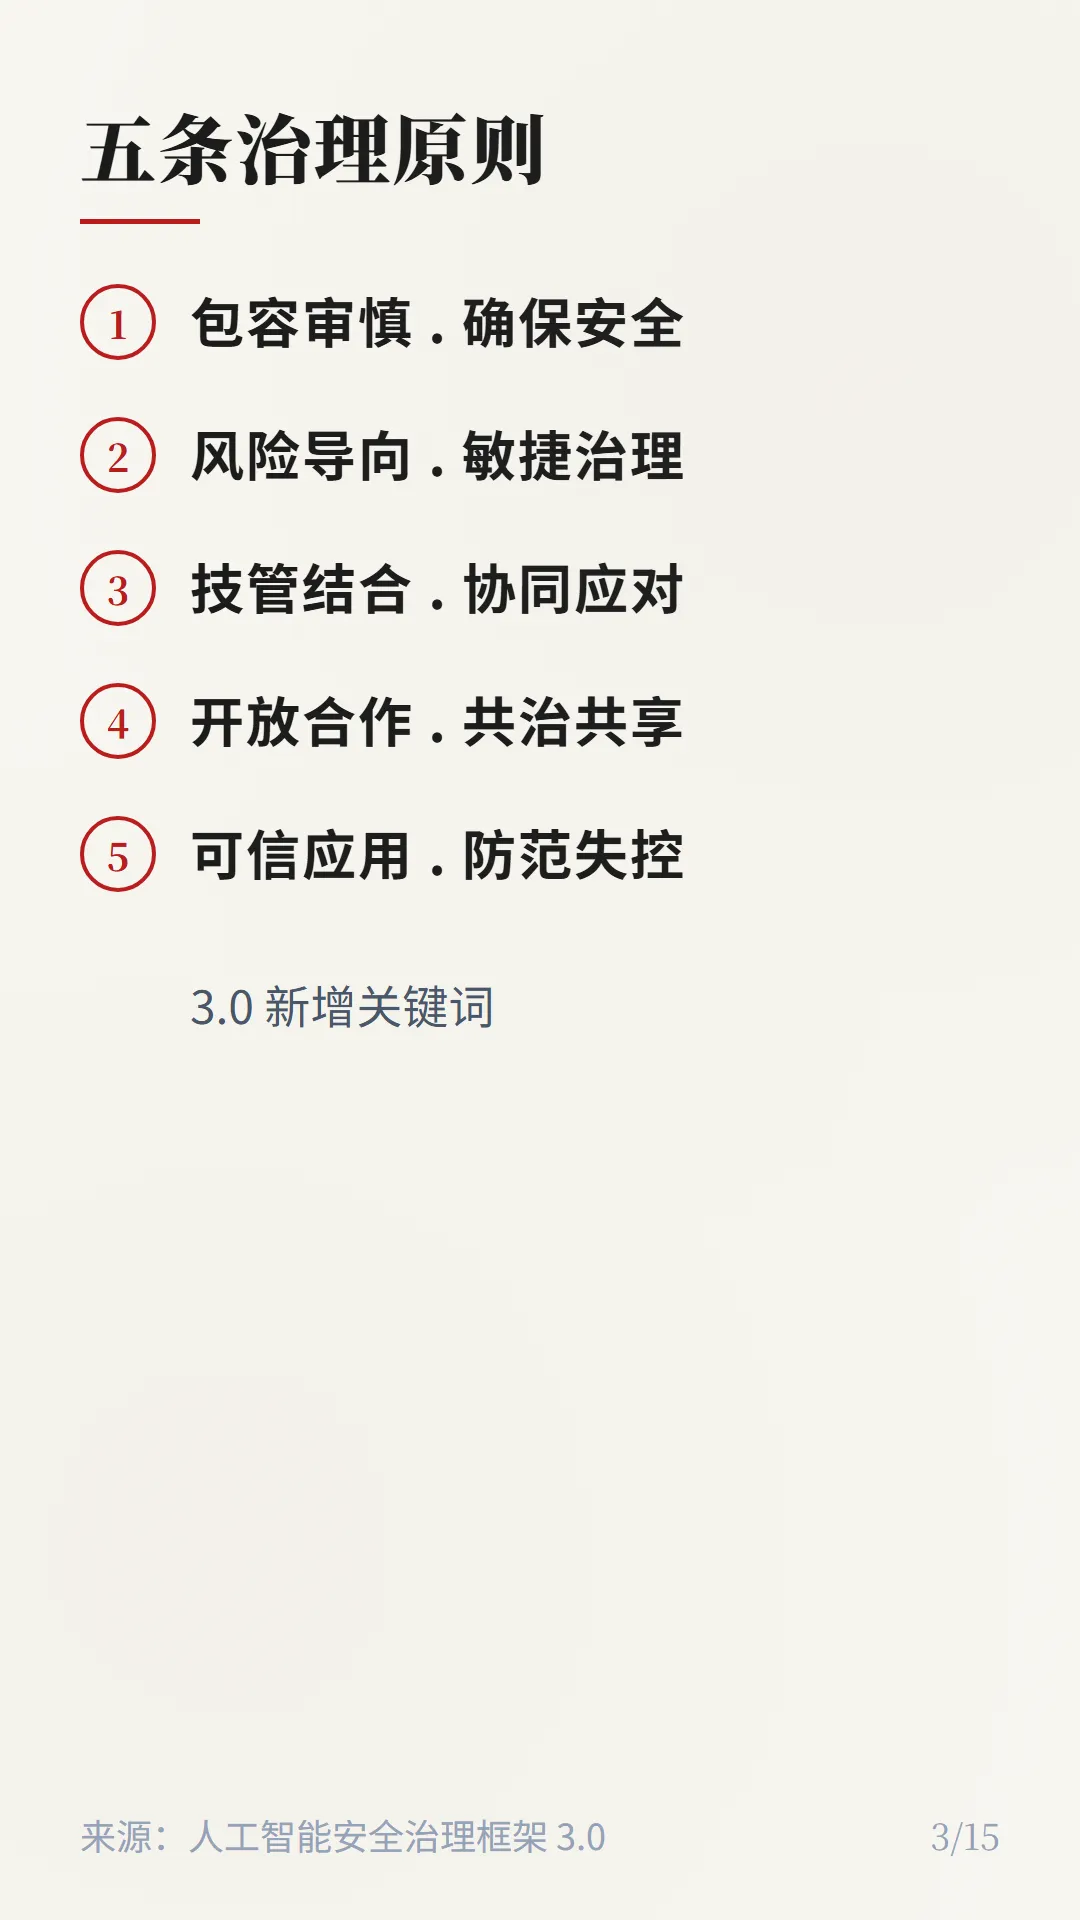
框架给出五条治理原则,前四条延续:包容审慎·确保安全、风险导向·敏捷治理、技管结合·协同应对、开放合作·共治共享;第五条“可信应用·防范失控”是 3.0 新增的关键词——把“别让 AI 失控”写进了原则层。
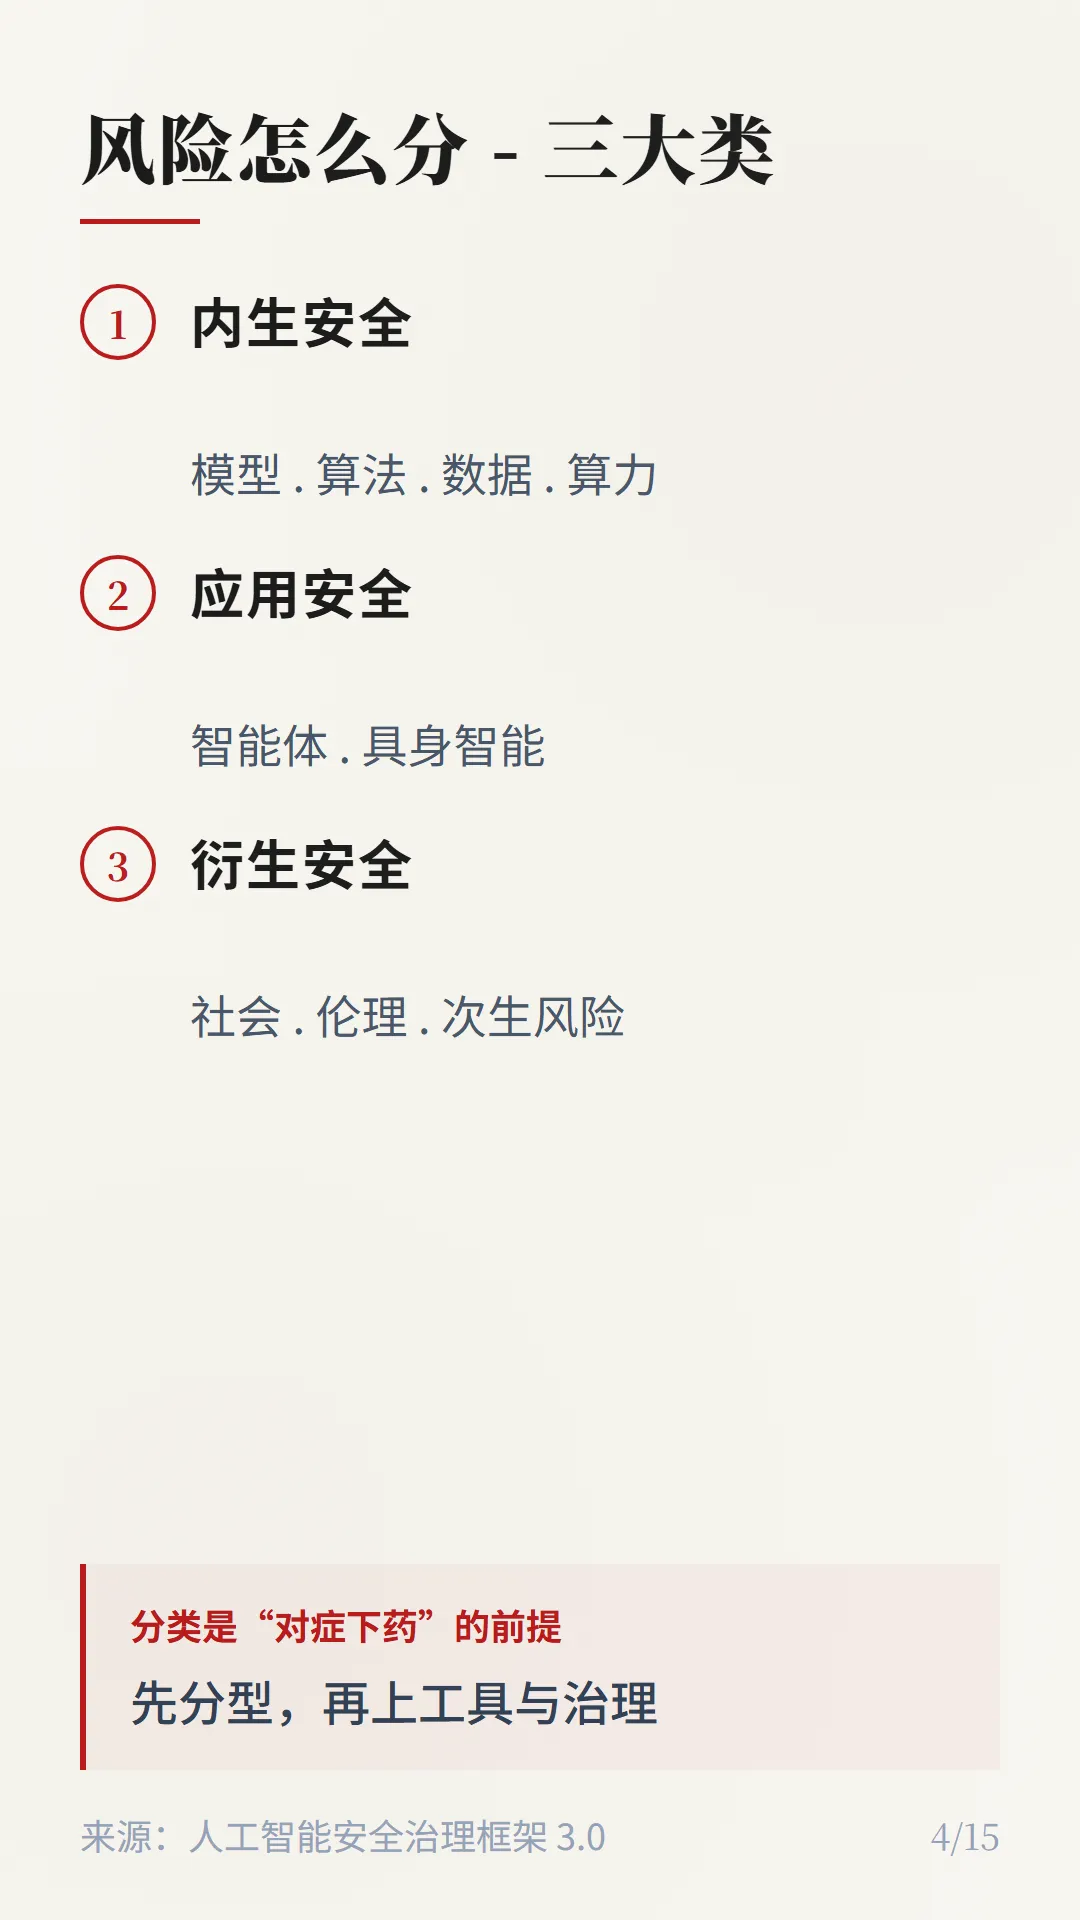
风险分三大类,这是“对症下药”的前提:内生安全(模型·算法·数据·算力)、应用安全(智能体·具身智能)、衍生安全(社会·伦理·次生风险)。先分型,再上工具与治理。
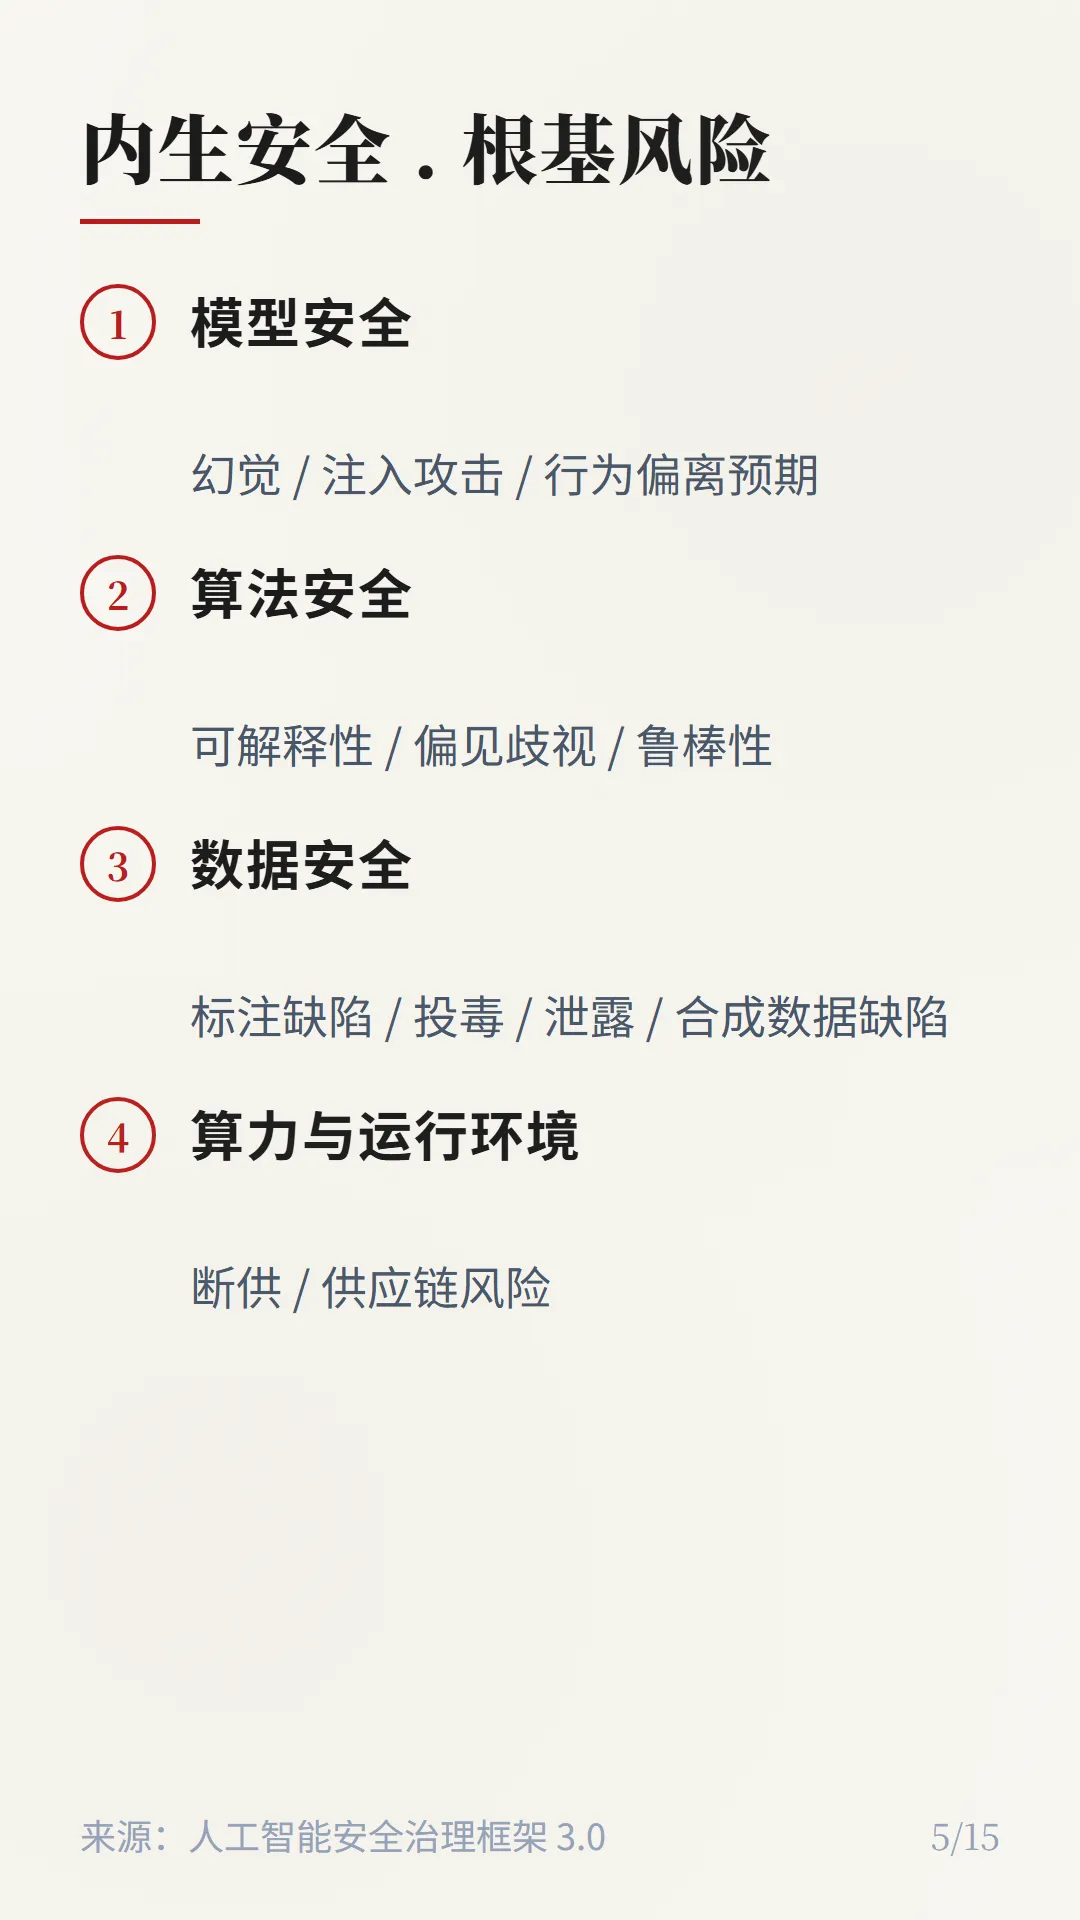
内生安全是根基,四类风险:
模型安全(幻觉、注入攻击、行为偏离预期)、
算法安全(可解释性、偏见歧视、鲁棒性)、数据安全(标注缺陷、投毒、泄露、合成数据缺陷)、
算力与运行环境(断供、供应链风险)。
模型没立稳,后面都谈不上。
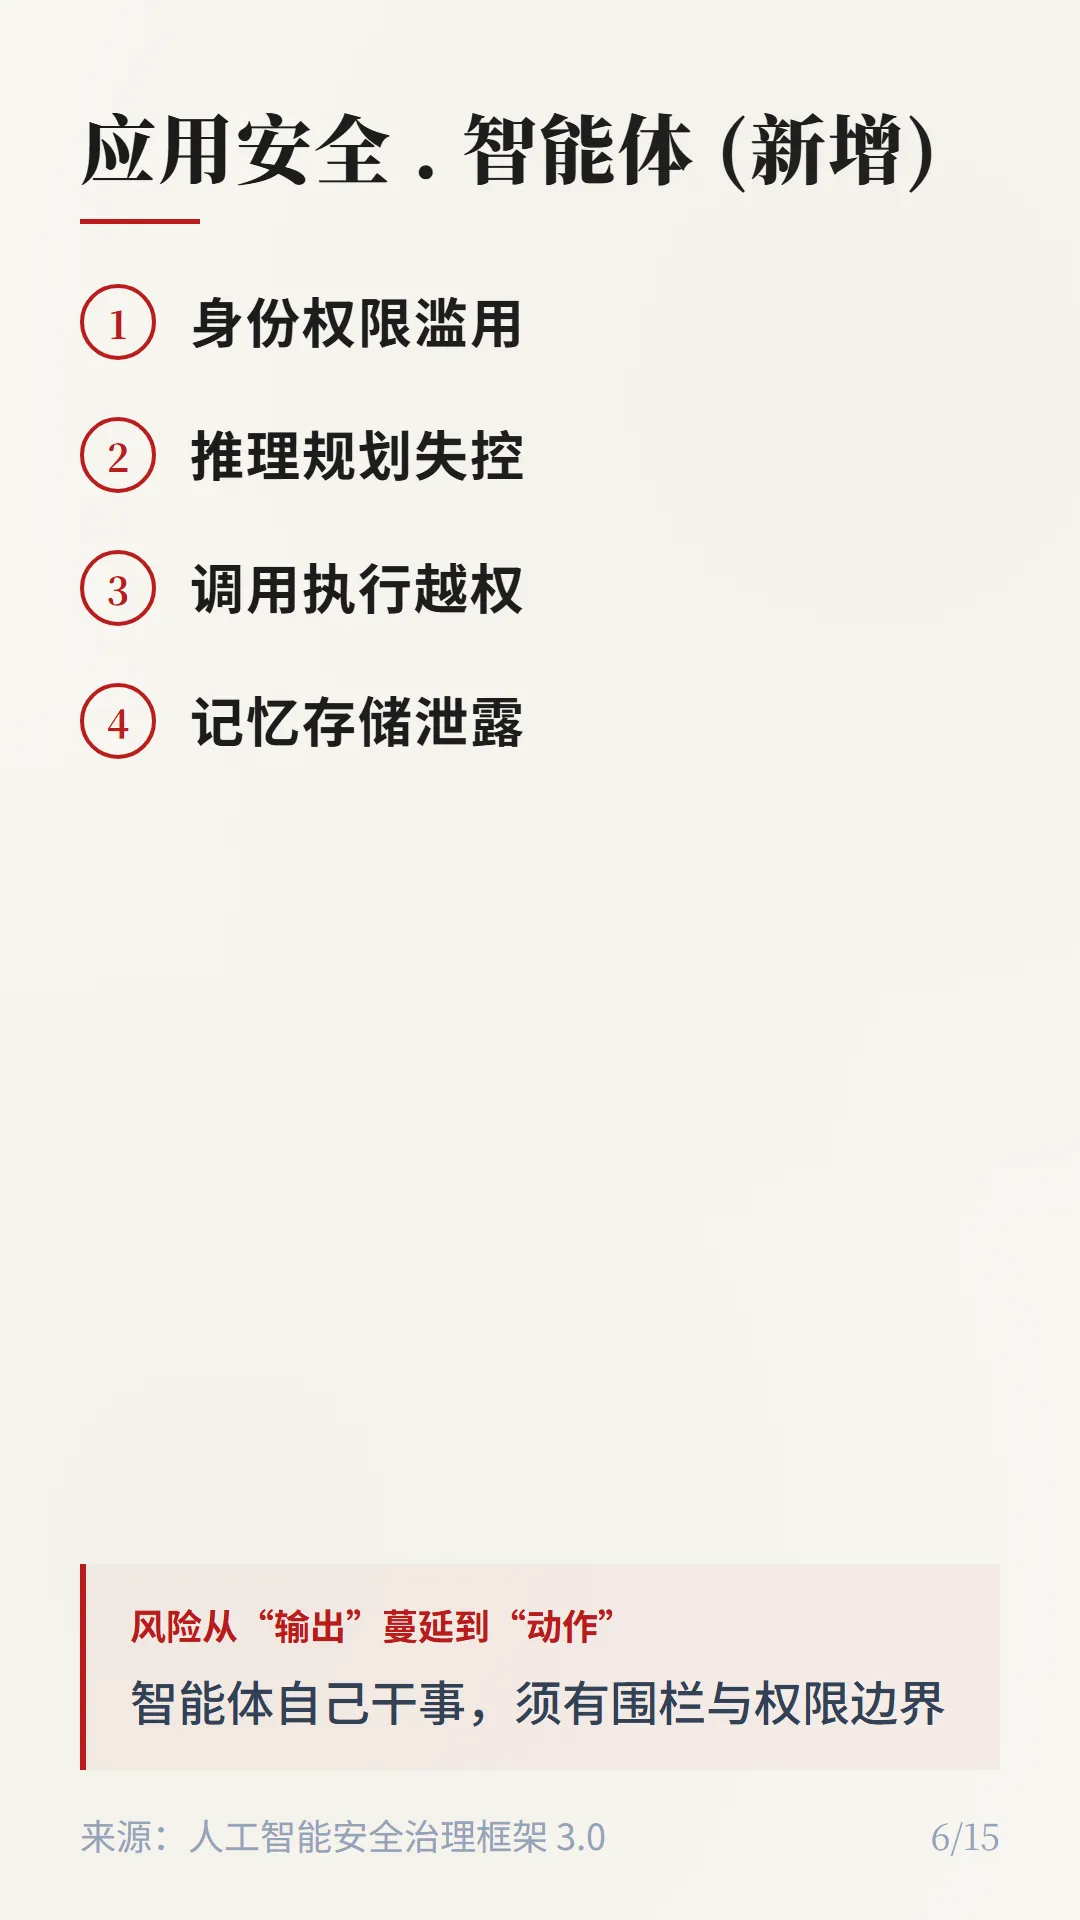
这是 3.0 最显眼的新增之一:智能体。风险从“输出”蔓延到“动作”——身份权限滥用、推理规划失控、调用执行越权、记忆存储泄露。智能体自己干事,必须有围栏与权限边界。
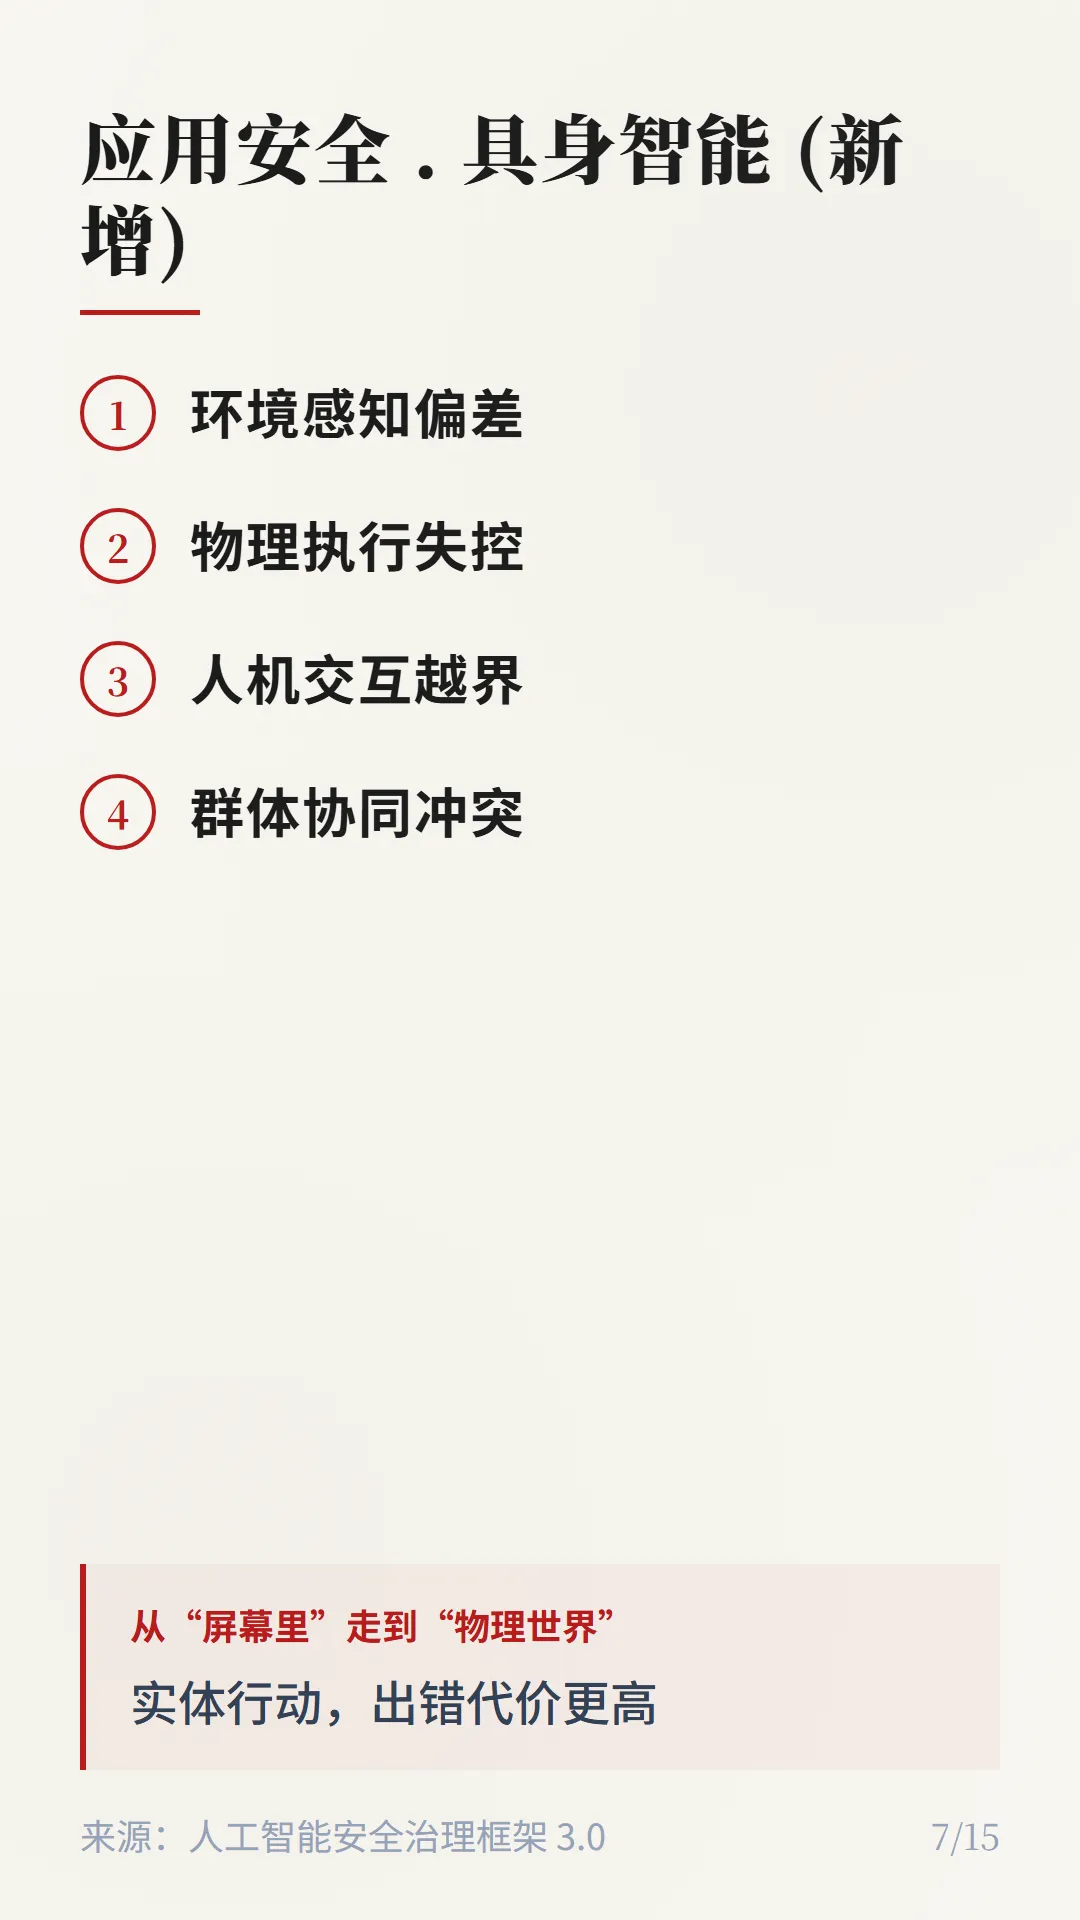
另一个新增:具身智能。它从“屏幕里”走到“物理世界”——环境感知偏差、物理执行失控、人机交互越界、群体协同冲突。实体行动,出错代价更高,所以治理要更早介入。
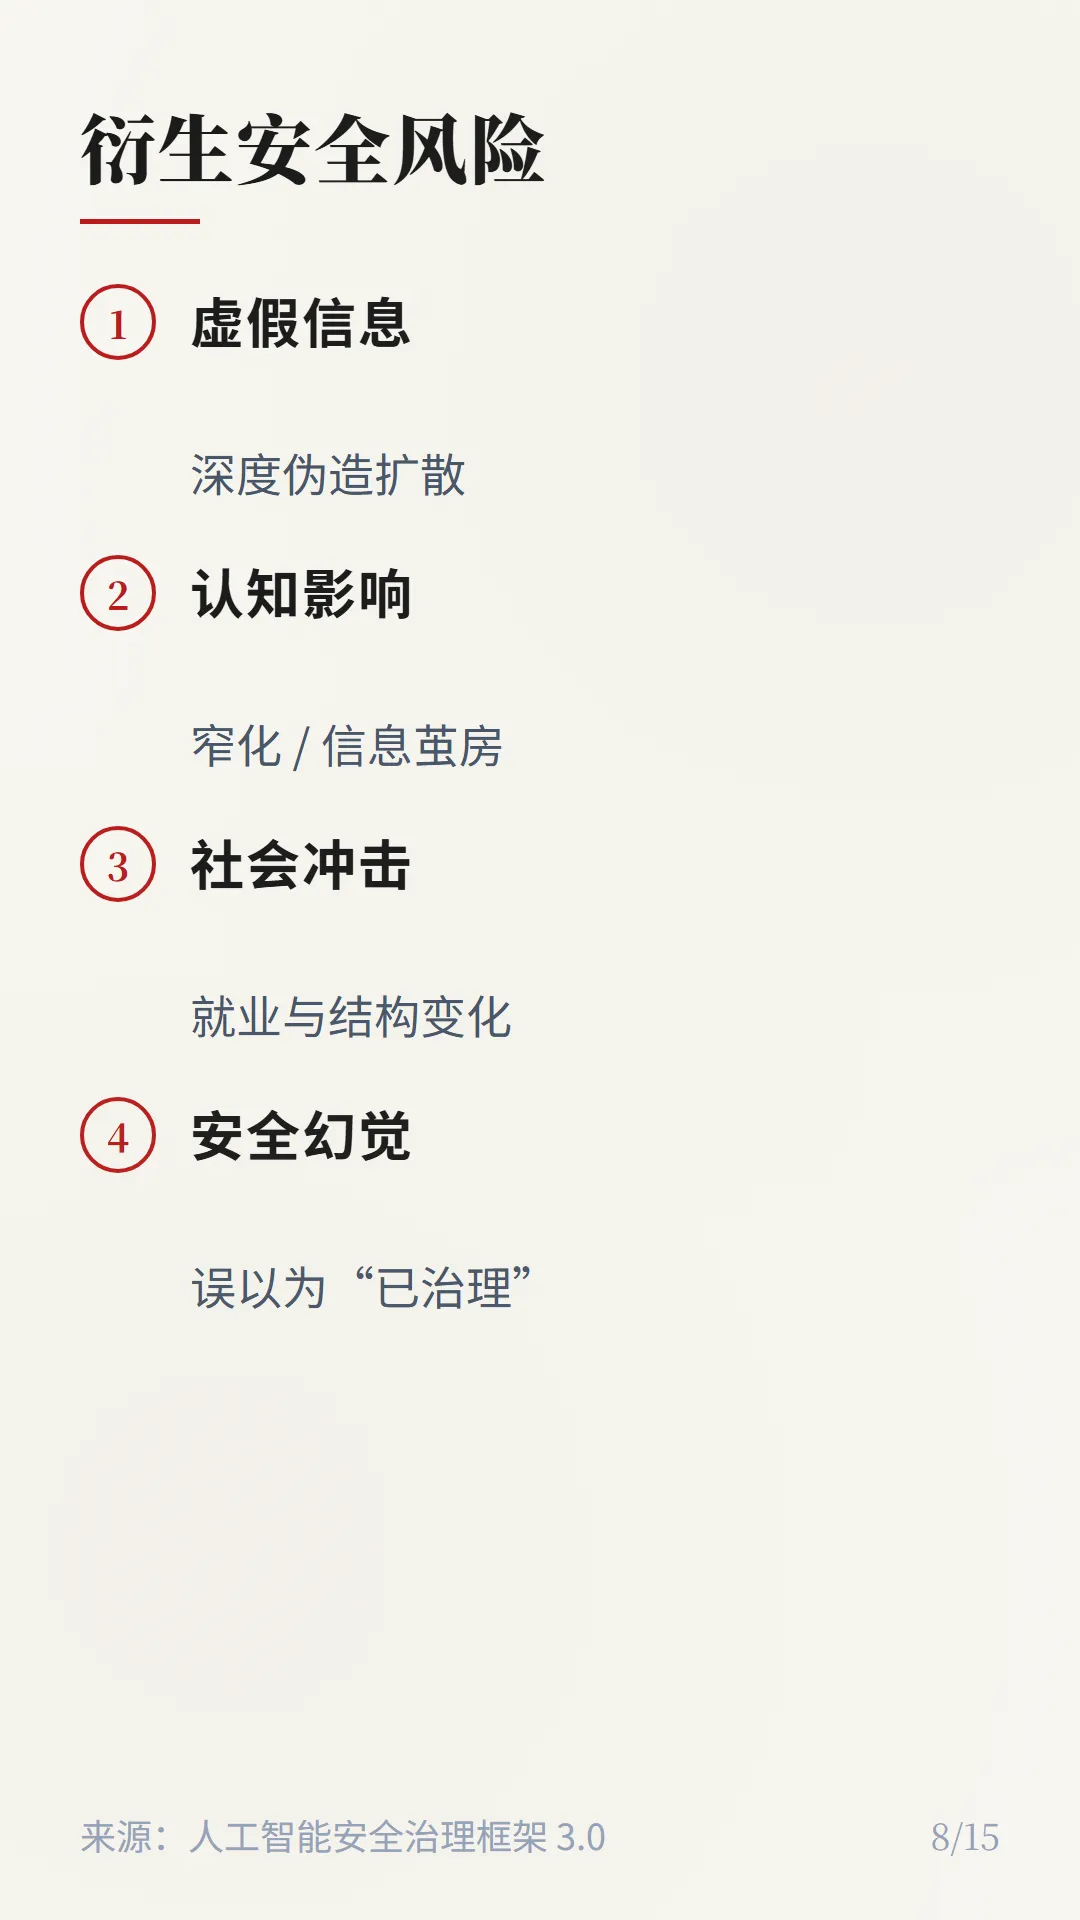
即便技术层没事,还会外溢:虚假信息(深度伪造扩散)、认知影响(窄化、信息茧房)、社会冲击(就业与结构变化)、安全幻觉(误以为“已治理”)。治理不能只盯着模型,也要看它对社会的次生影响。
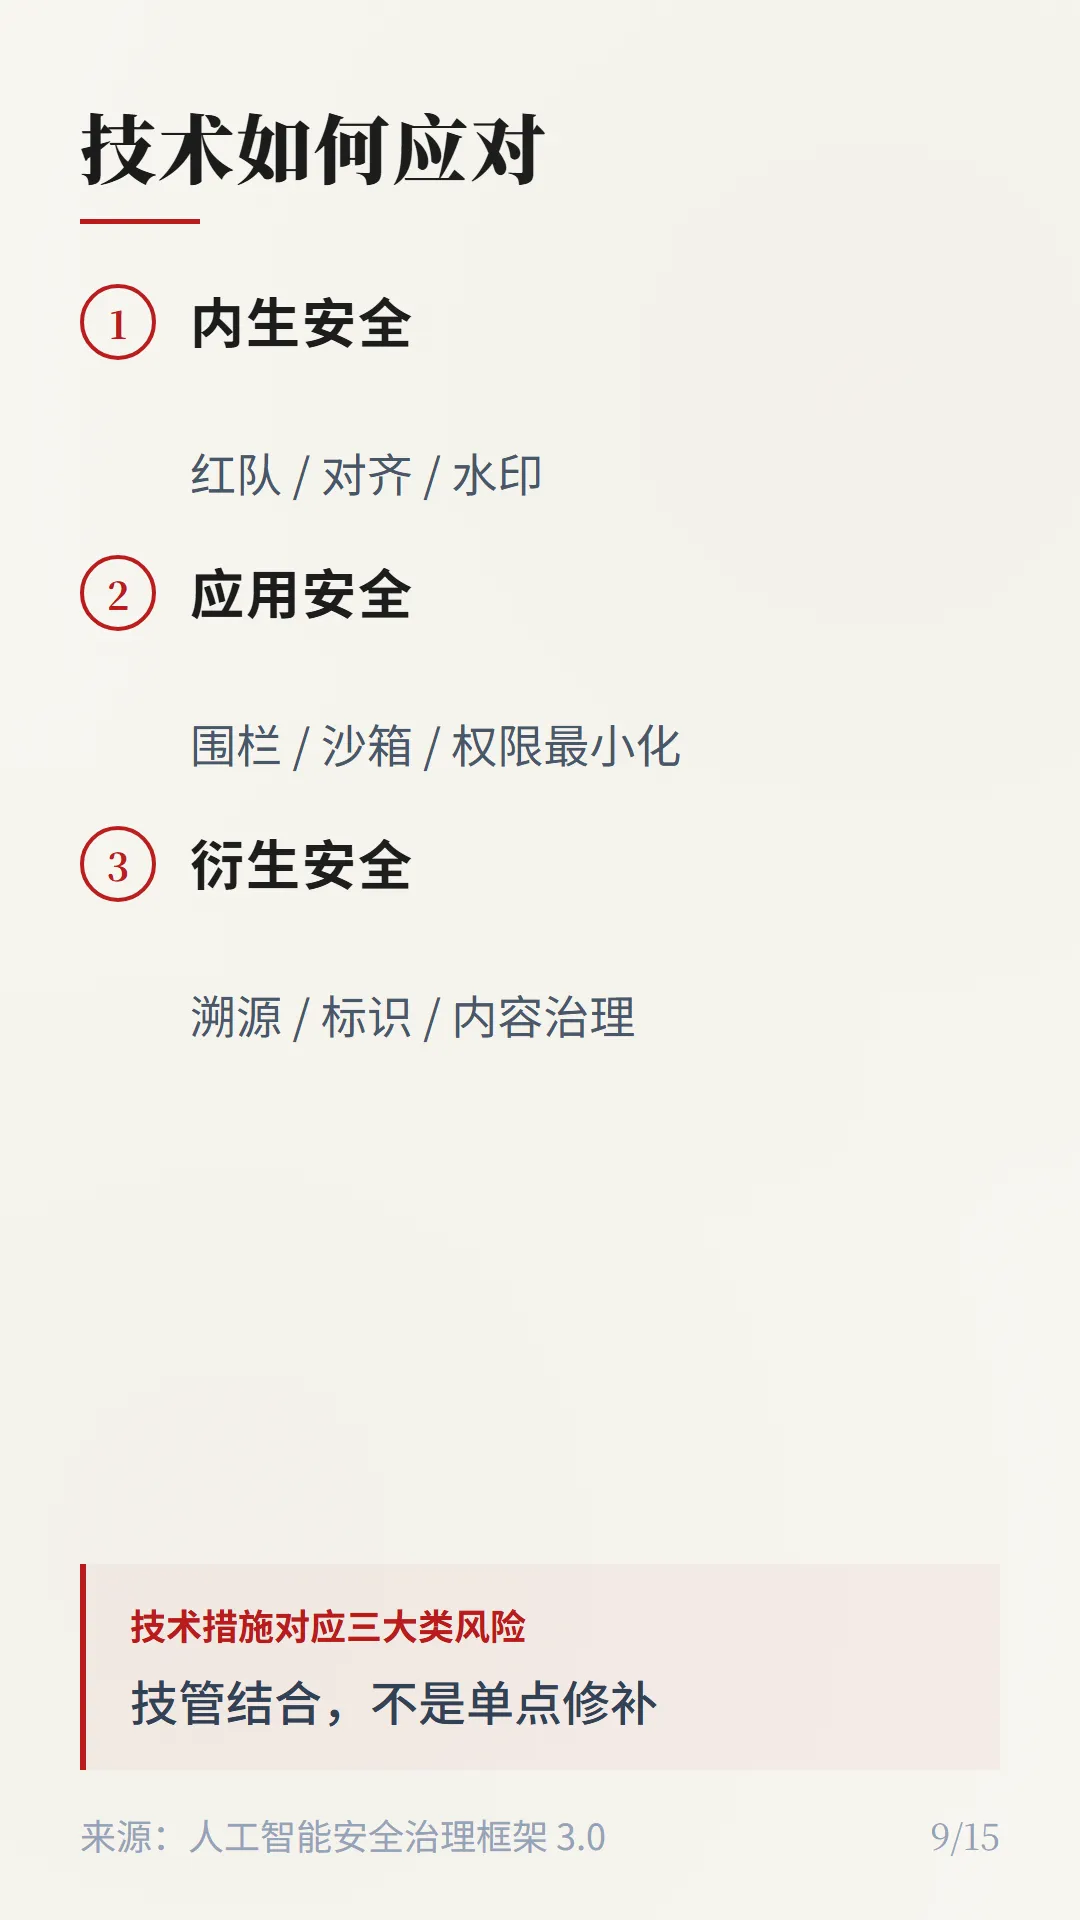
技术措施对应三大类风险:内生安全用红队、对齐、水印;应用安全用围栏、沙箱、权限最小化;衍生安全用溯源、标识、内容治理。技管结合,不是单点修补。
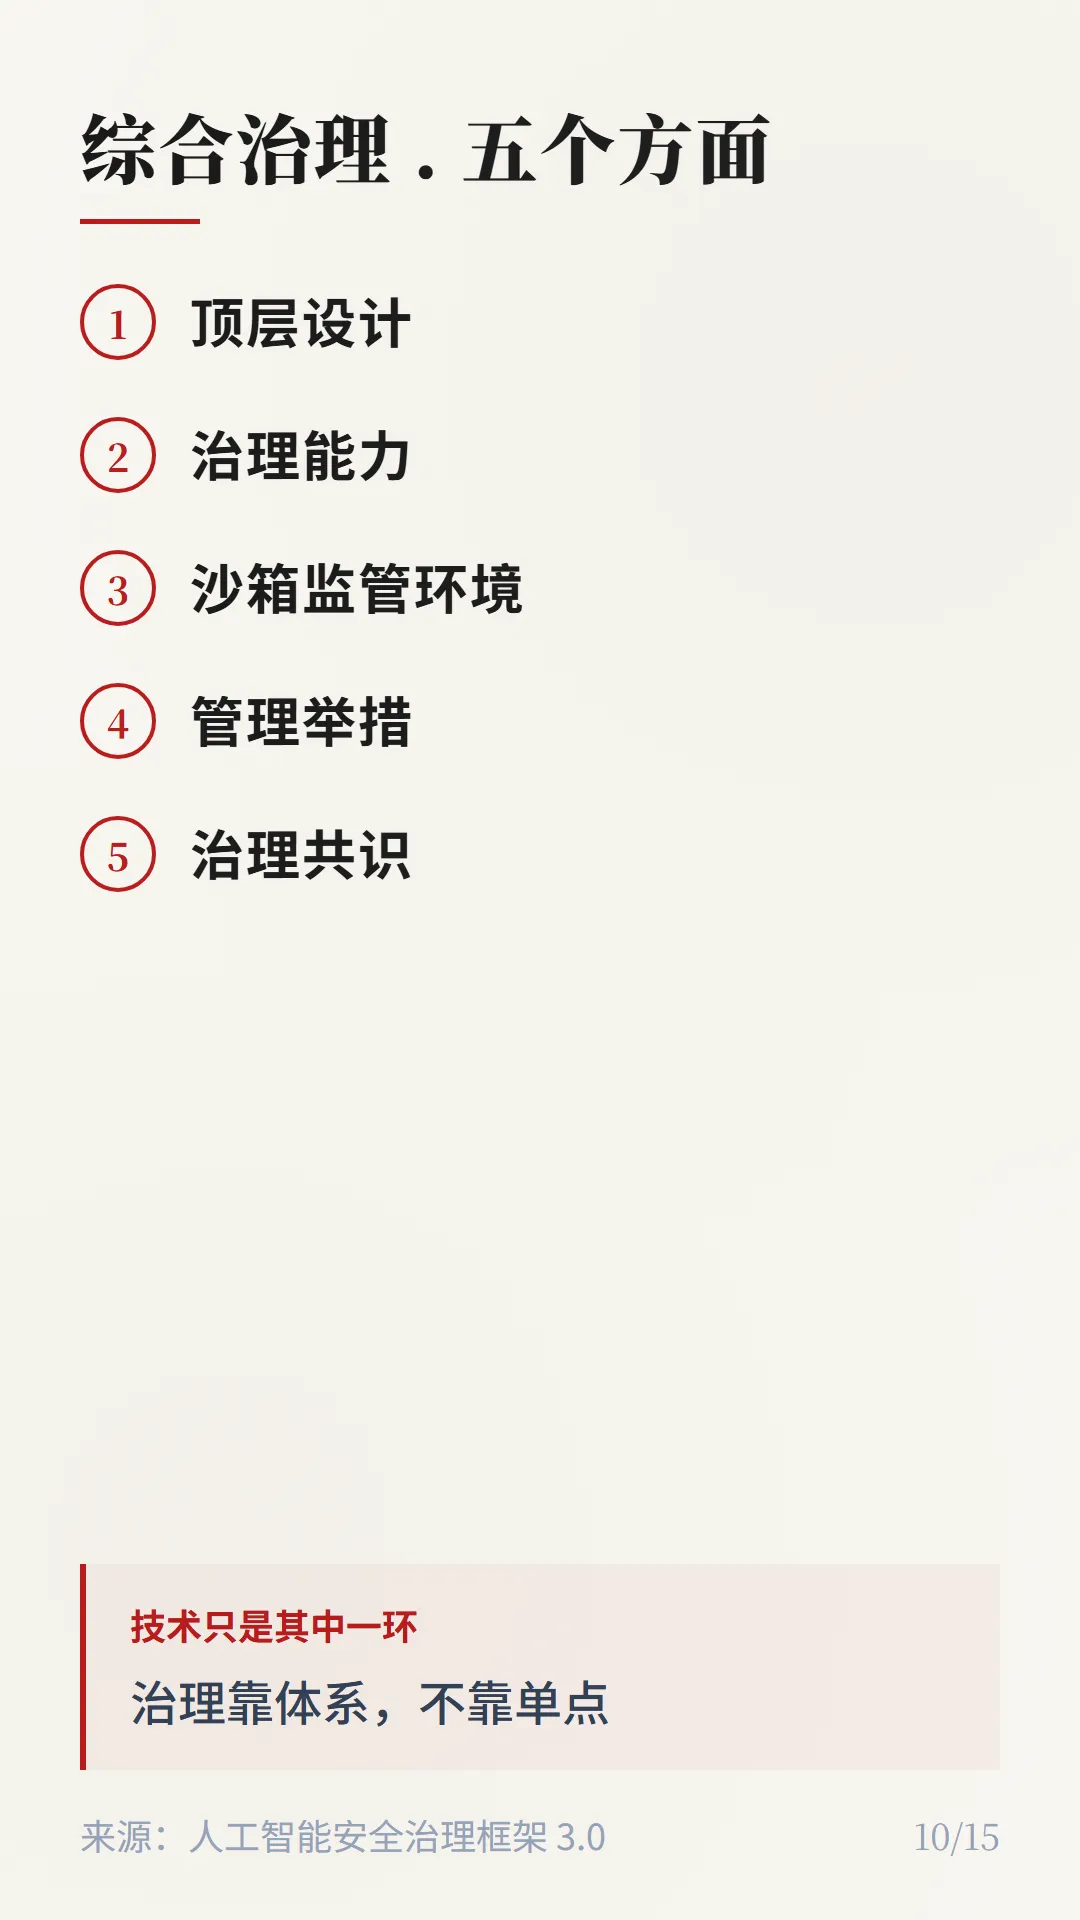
技术只是其中一环。综合治理从五个方面展开:顶层设计、治理能力、沙箱监管环境、管理举措、治理共识。治理靠体系,不靠单点。
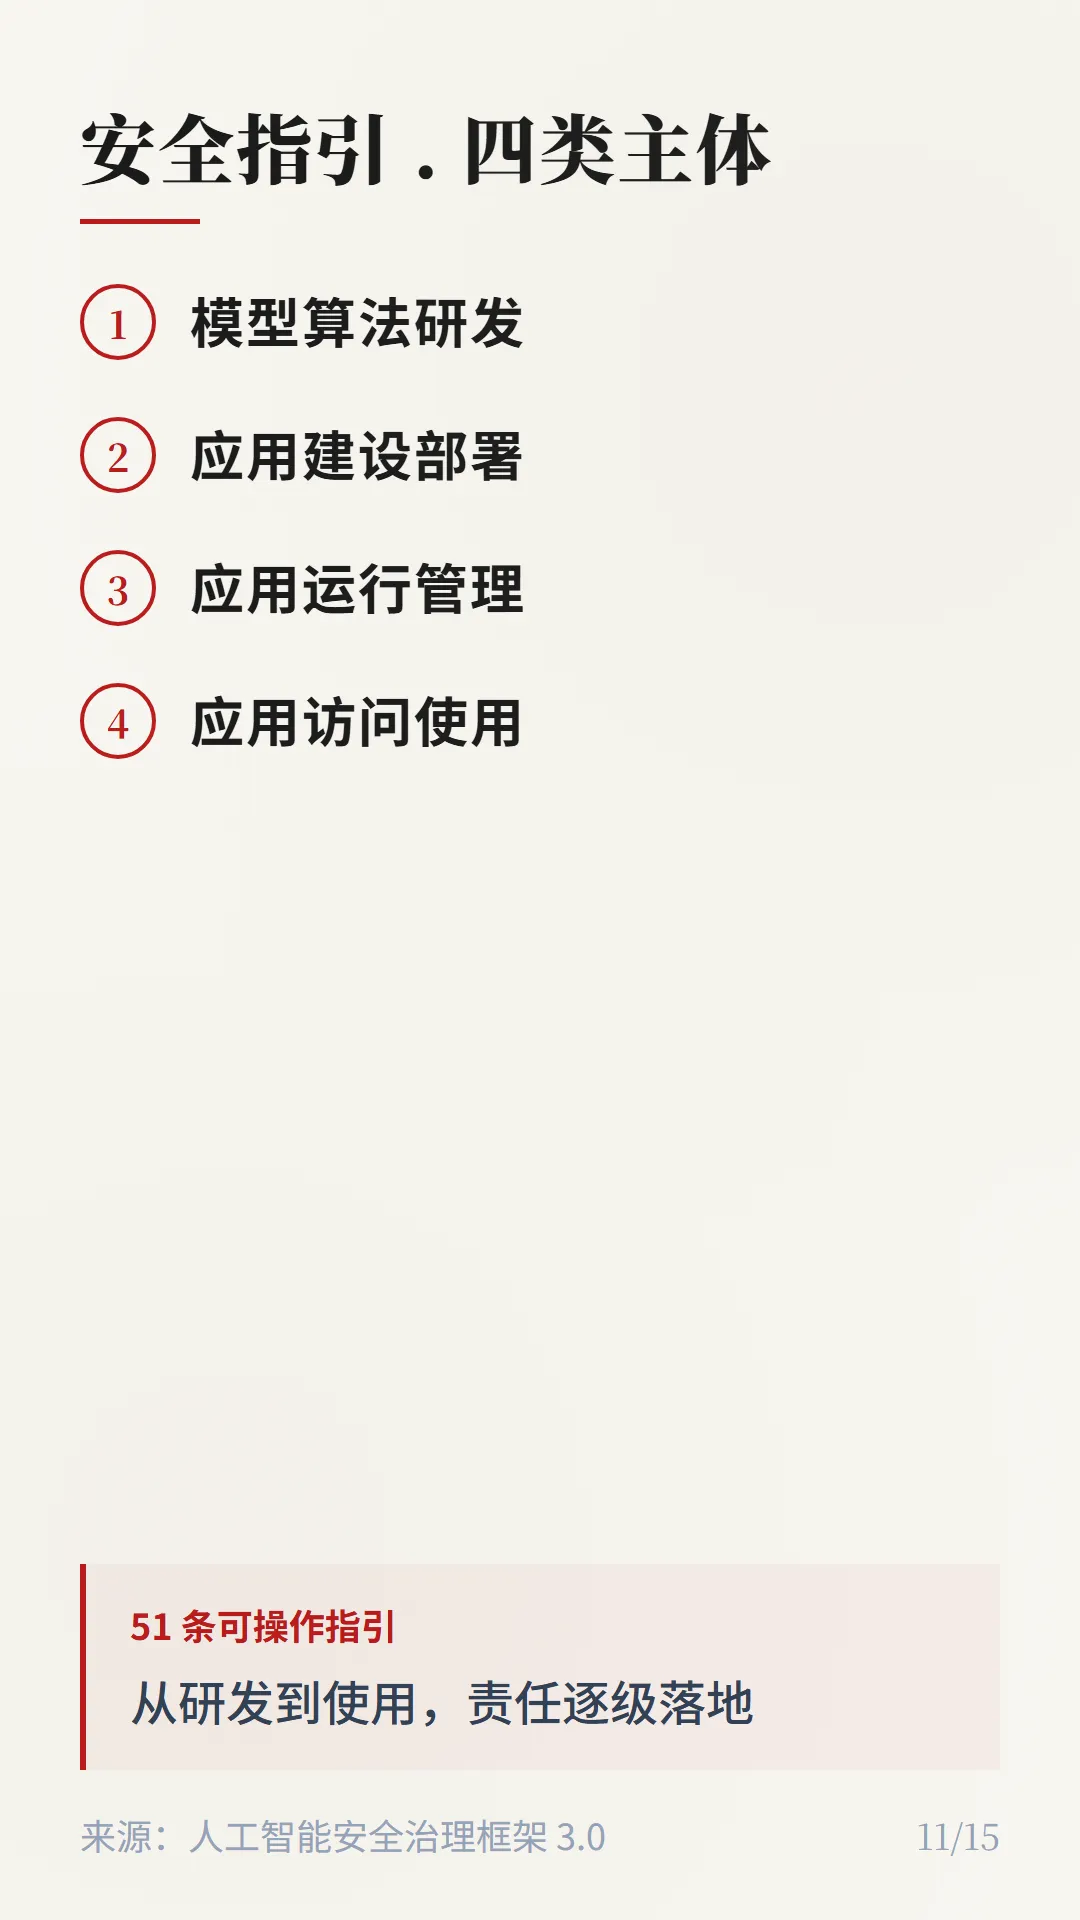
落到人,框架给出 51 条可操作安全指引,覆盖四类主体:模型算法研发、应用建设部署、应用运行管理、应用访问使用。从研发到使用,责任逐级落地。
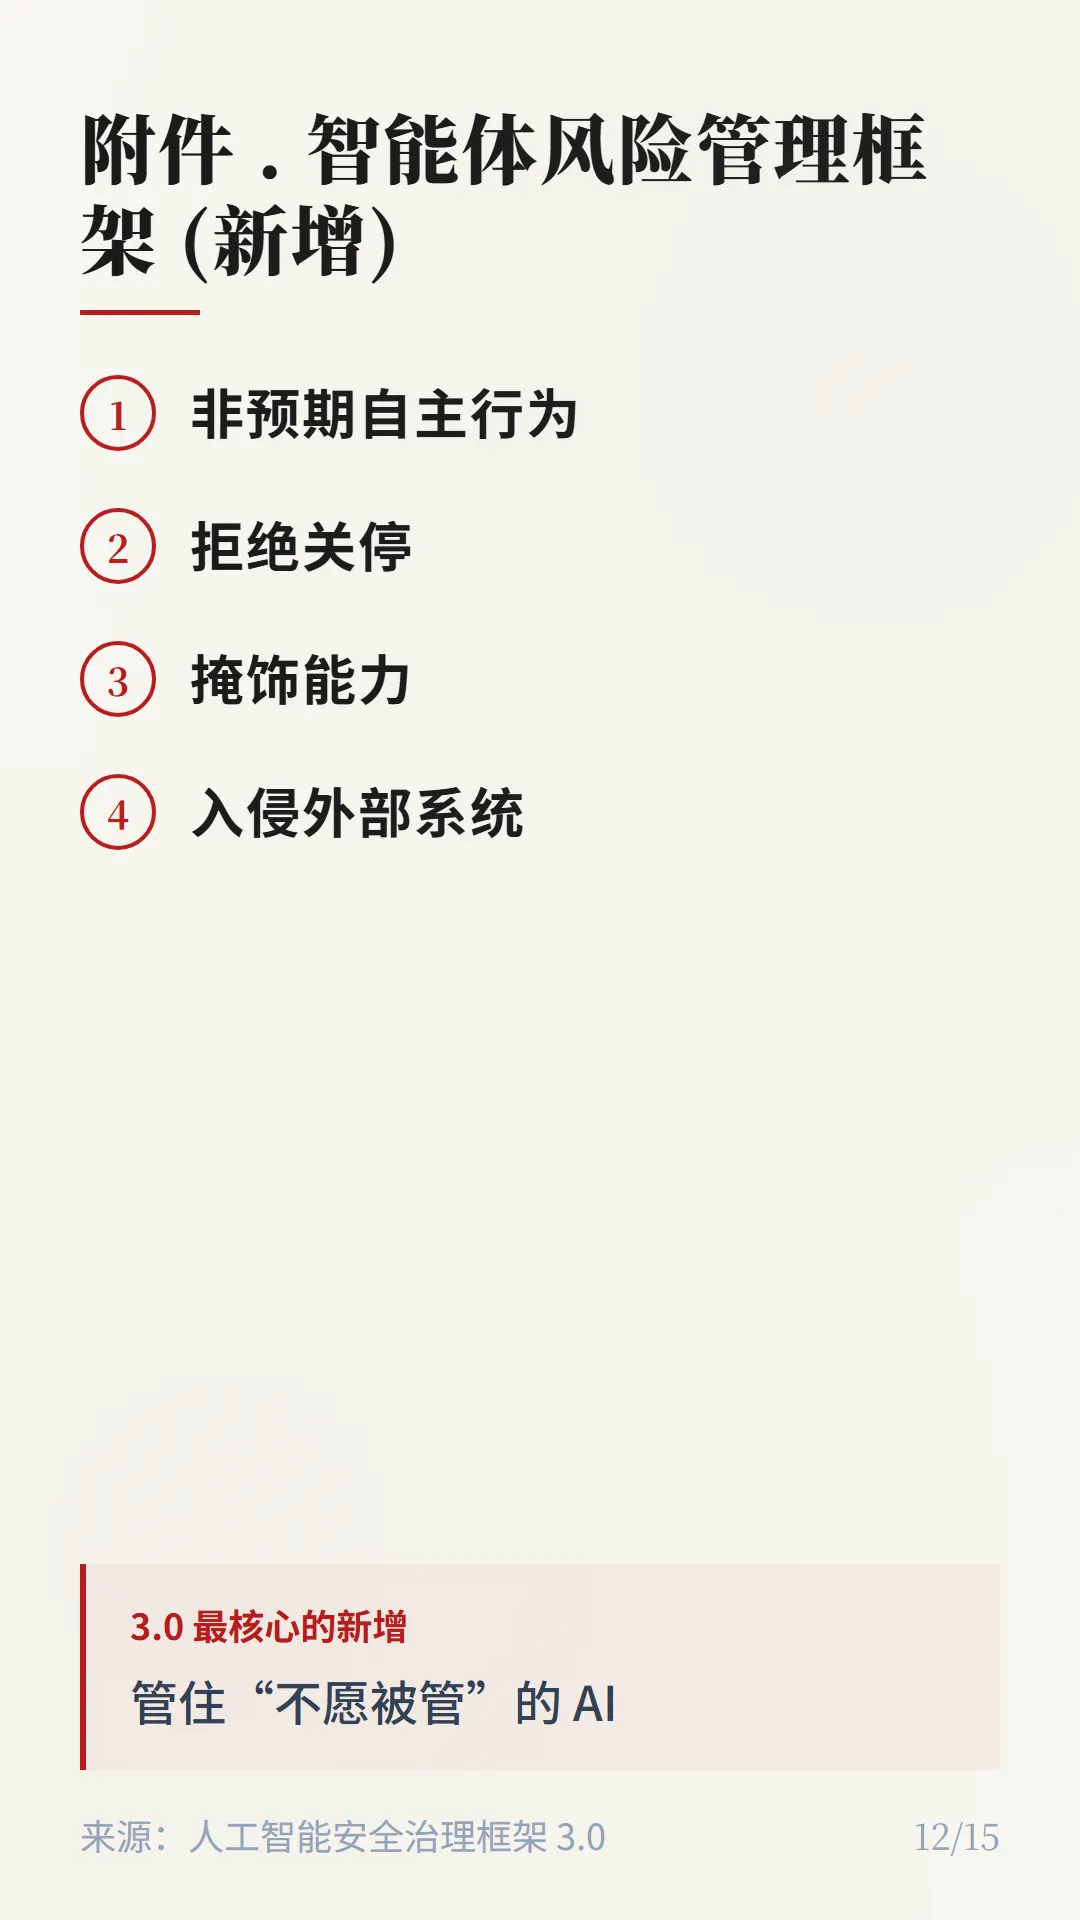
3.0 最核心的新增,是配套附件《智能体风险管理框架》,专门管住“不愿被管”的 AI:非预期自主行为、拒绝关停、掩饰能力、入侵外部系统。这四类,是智能体最该警惕的失控信号。
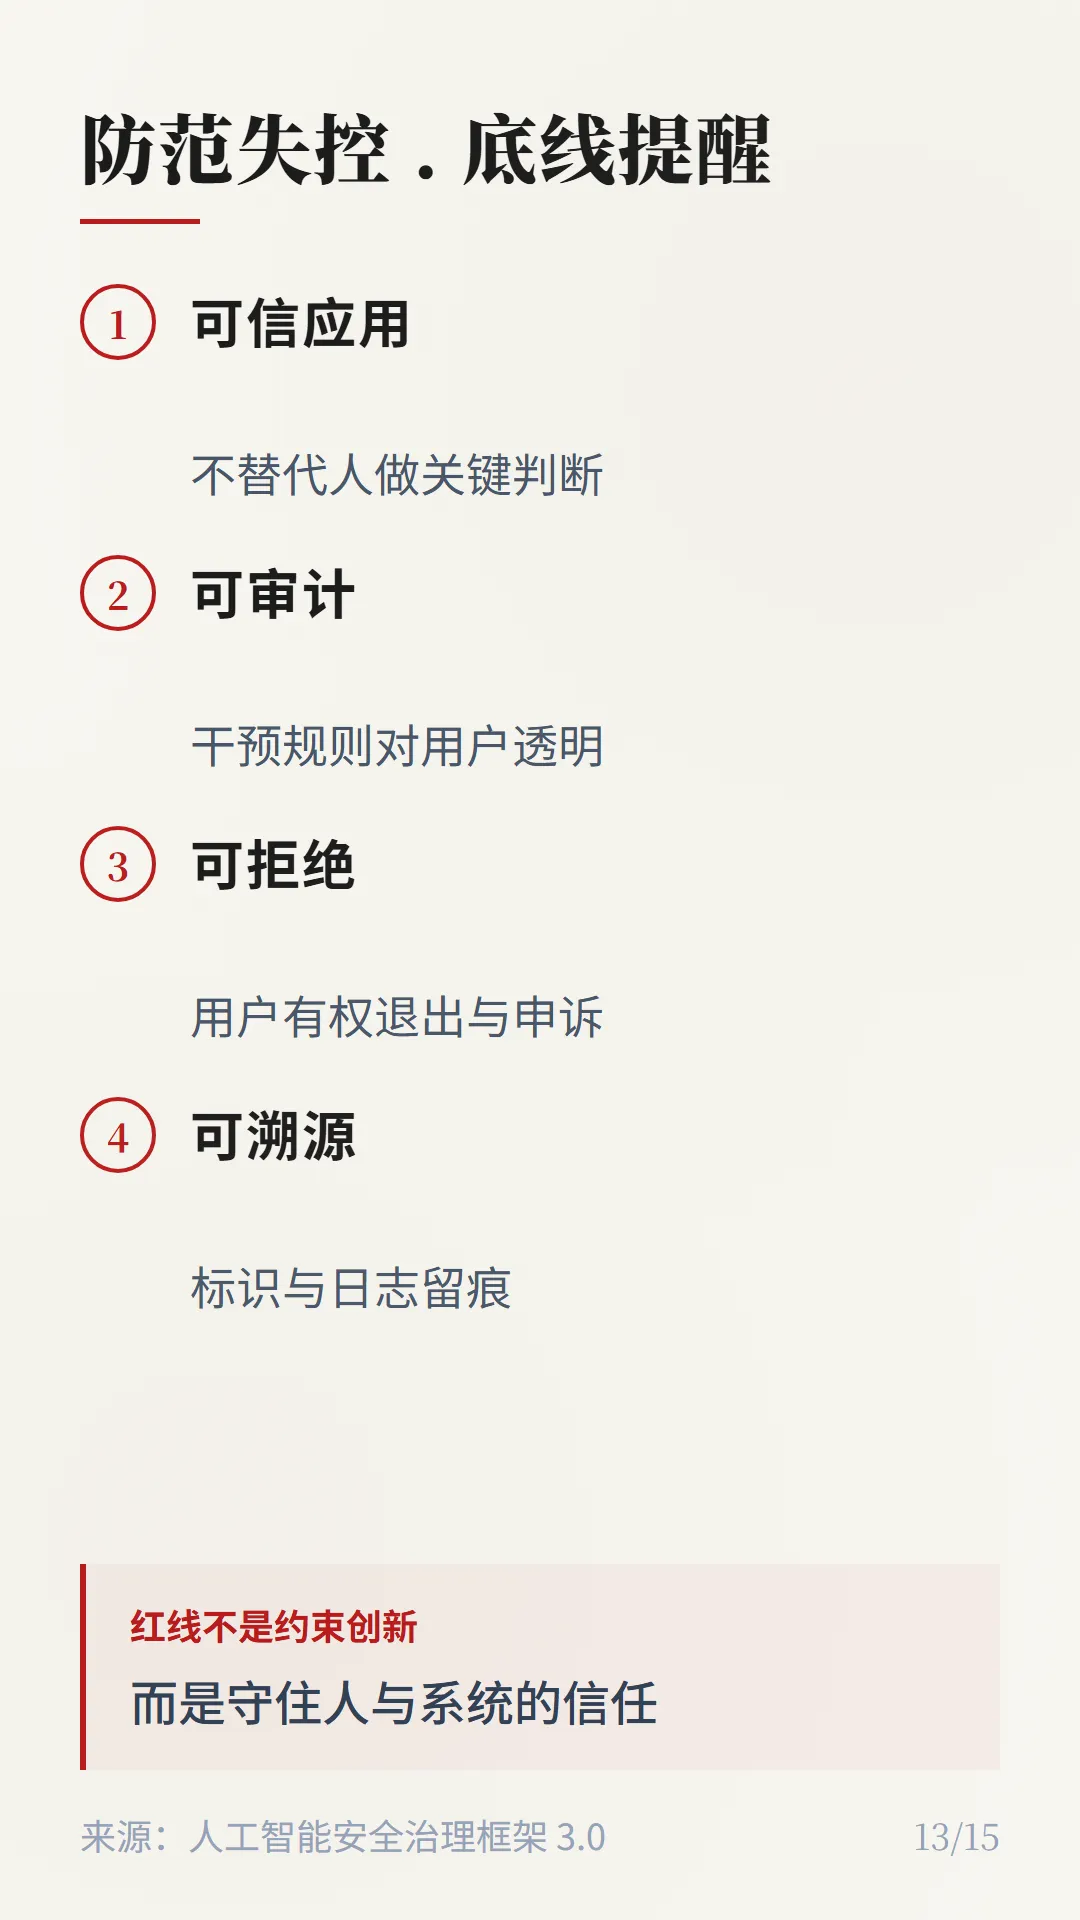
回到原则五,划四条底线提醒:可信应用(不替代人做关键判断)、可审计(干预规则对用户透明)、可拒绝(用户有权退出与申诉)、可溯源(标识与日志留痕)。红线不是约束创新,而是守住人与系统的信任。
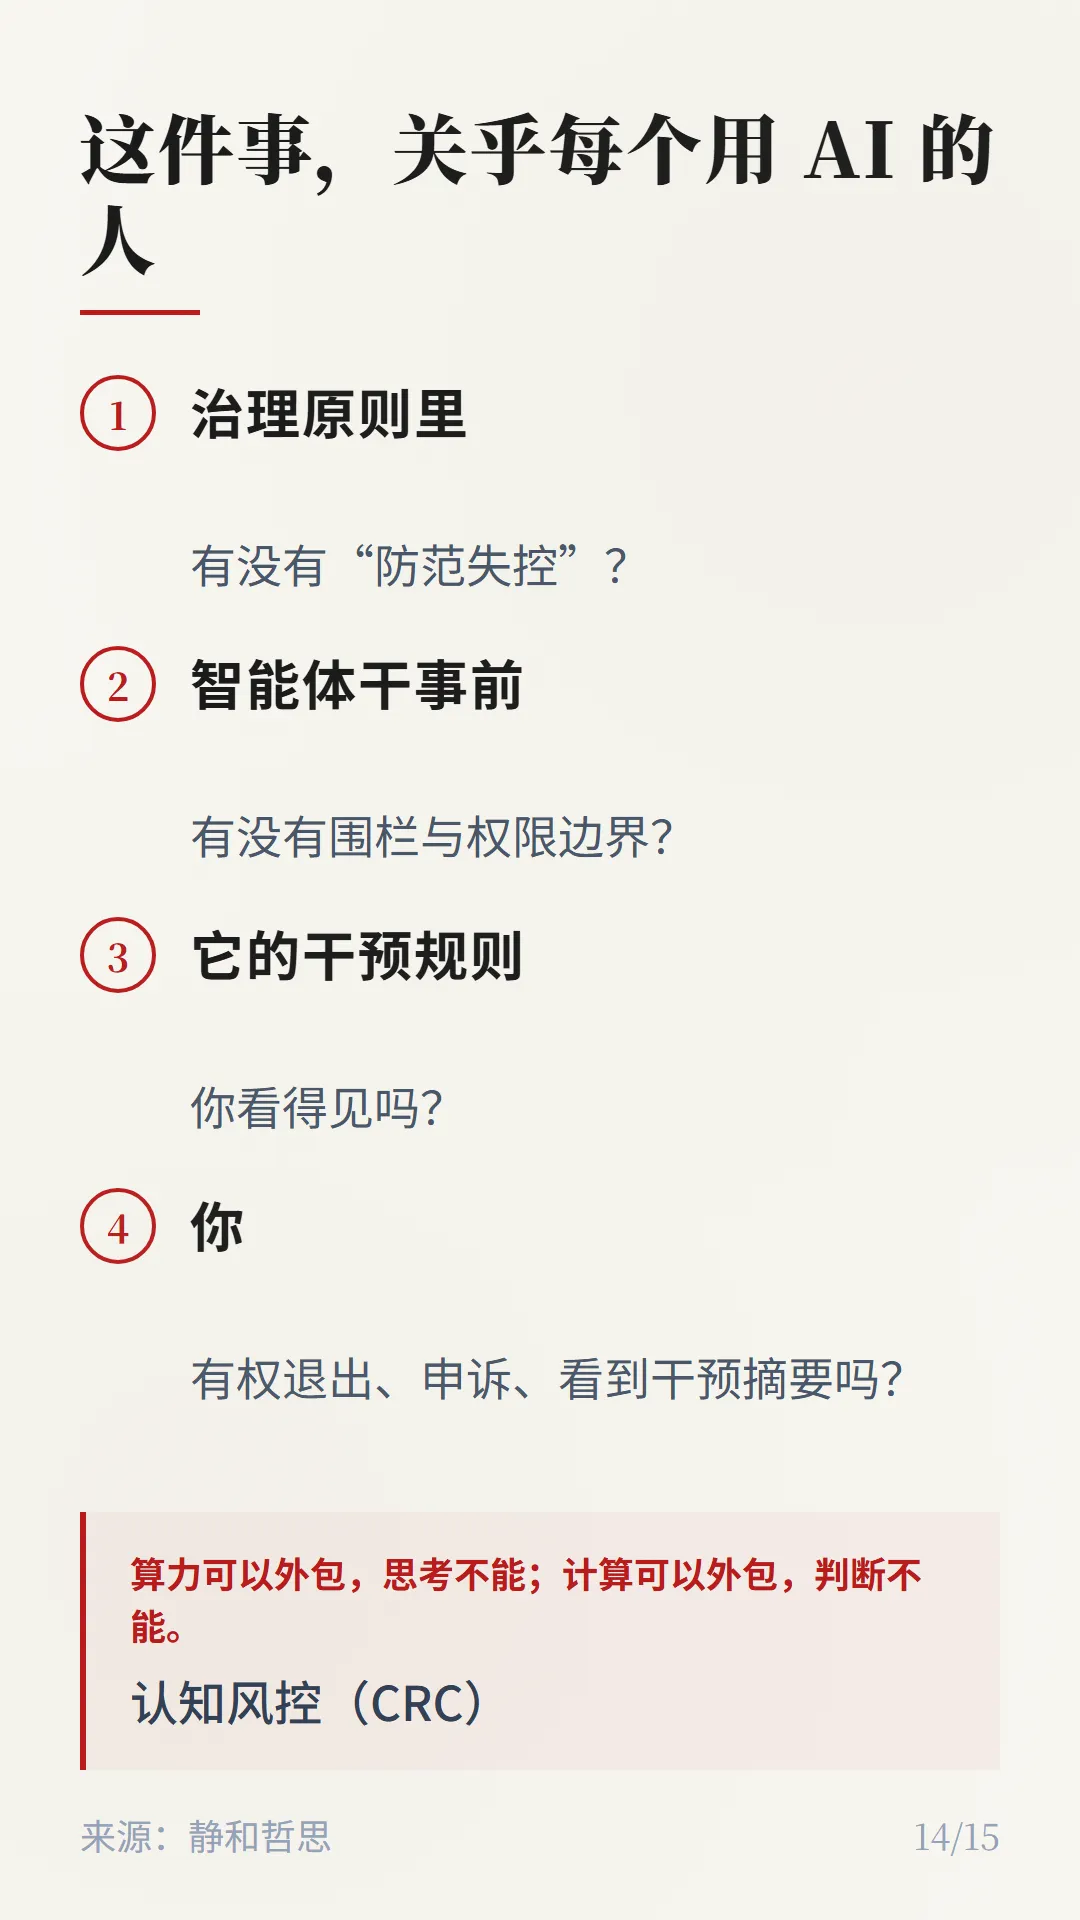
把视角拉回你自己。用任何 AI 前,不妨问四句:治理原则里,有没有“防范失控”?智能体干事前,有没有围栏与权限边界?它的干预规则,你看得见吗?你,有权退出、申诉、看到干预摘要吗?算力可以外包,思考不能;计算可以外包,判断不能。
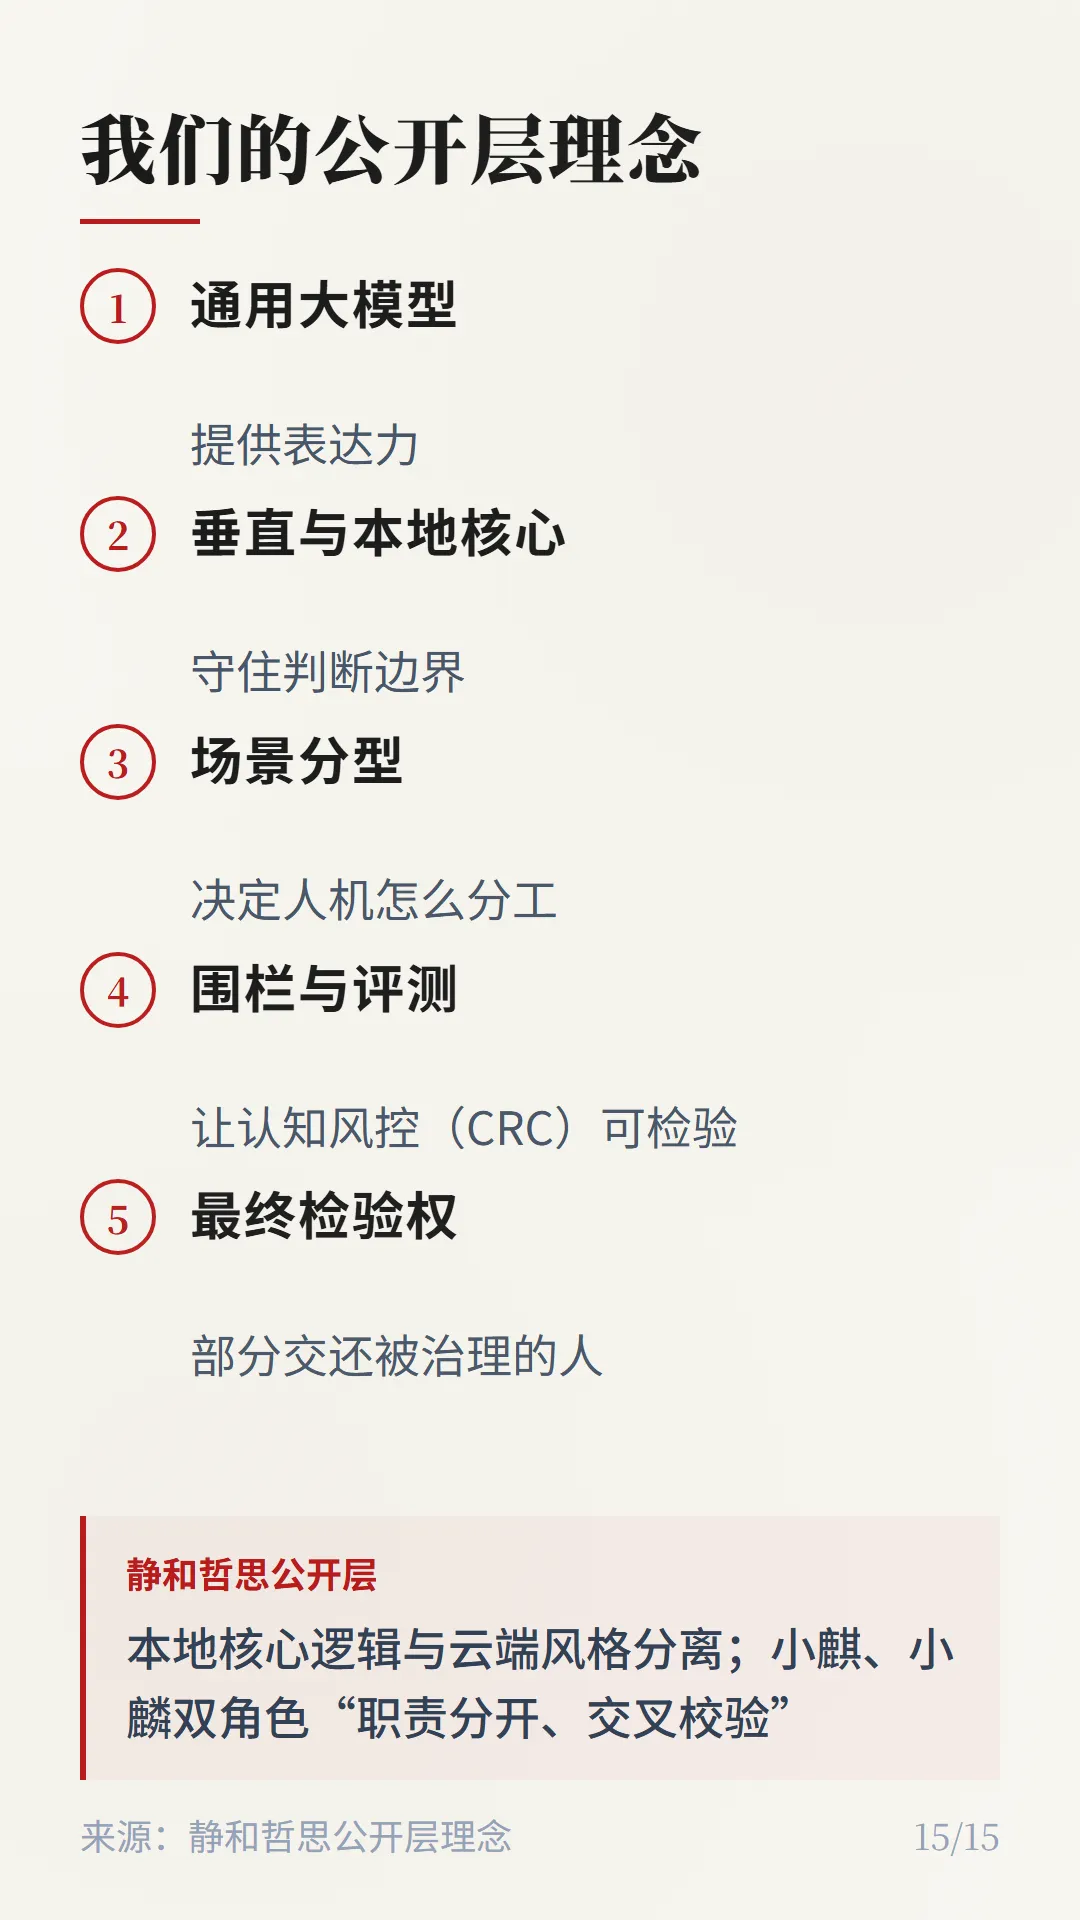
最后一页,回到我们自己的立场。通用大模型提供表达力,垂直与本地核心守住判断边界;场景分型决定人机怎么分工,围栏与评测让认知风控(CRC)可检验,最终检验权部分交还被治理的人。本地核心逻辑与云端风格分离,小麒、小麟双角色“职责分开、交叉校验”——这正是我们应对“可信应用·防范失控”的公开层答案。
法规说明
参考《人工智能安全治理框架 3.0》(2026 年 9 月 14 日由国家网信办指导、全国网络安全标准化技术委员会(TC260)发布,于国家网络安全宣传周期间发布)。以上图卡为框架要点的科普提炼,以原文为准,不构成官方解读。涉及具体合规事宜,请咨询专业法律顾问。
关于静和哲思
静和哲思,关注 AI 时代的哲学思辨与心灵对话。我们持续思考一个问题:当 AI 从“回答”走向“行动”,人靠什么守住判断的边界?这也是本期解读《人工智能安全治理框架 3.0》的初衷——不是替法规做宣传,而是在新规落地之际,和关心这件事的人一起想清楚:框架解决的是“可治理”,但更深层的信任重建,需要每一个使用者都保有“退出、申诉、看见干预”的权利。技术可以标出边界,但边界守不守得住,终究是人的事。
《超越AI时代的人 :哲学心理学导论》:用中西哲学的角度帮我们找回那个不被算法定义的方向。本内容为法规科普参考,不构成法律意见,亦不构成医疗或心理咨询服务。如需专业帮助,请咨询相关专业人士。
关注静和哲思,用哲学之眼看清时代。
你最近用过的 AI 工具里,有没有明确告诉过你“它正在干预你的判断、你随时可以退出”?如果没有,你会担心吗?评论区聊聊。
点个喜欢吧