ARTICLE · 1060840
OpenAI疯抢数万台Mac当算力!苹果坐不住了:4颗M8芯片造服务器,联手英伟达?
谁也没想到,2026年硅谷最荒诞也最硬核的奇观,居然发生在顶级AI实验室的机房里。
机房里既看不到定制机柜,也找不着炫目的灯效。工程师们买来成千上万台原本摆在办公桌上的 Mac mini 和 Mac Studio,直接拔掉显示器,扔掉键盘鼠标,像砌砖头一样把它们捆在简陋的铁架上。
OpenAI成批采购数万台Mac当无头节点跑强化学习,Anthropic直接在云端整机柜租用Mac算力。 这一波魔幻操作,直接把苹果上一季度的Mac营收硬生生拉升了近 30%。
全世界最聪明的AI大脑,竟然在用消费级电脑充当生产力工具。
面对这场扑面而来的泼天富贵,库克和他的硬件团队终于坐不住了。
多家外媒与供应链消息证实:阔别企业级服务器市场整整15年后,苹果正在秘密筹划全面杀回数据中心,打造搭载最多4颗 M8 Ultra 顶级自研芯片的 enterprise AI 算力怪兽!
为了补齐网络短板,苹果甚至放下昔日的执拗,正与老对手英伟达接触谈判,评估引入后者的 NVLink Fusion 高速互连技术。
一场席卷整个芯片与AI产业的底层风暴,正悄然拉开序幕。
狂买Mac背后:统一内存的“降维打击”
顶级AI实验室放着几百万元一台的专业GPU服务器不买,为什么偏偏看上了苹果的台式机?
答案藏在现代AI大模型最致命的一个痛点里:显存与内存的分离。
在传统的PC和服务器架构里,处理通用任务的CPU和专门跑AI的GPU是“异地恋”。CPU有自己的系统内存,显卡有自己的独立显存。两者之间隔着狭窄的通道每次AI要处理复杂的逻辑判断,数据就必须在内存和显存之间来回翻山越岭、死命倒腾。这不仅耗电,延迟更是居高不下
而苹果的 Apple Silicon(M系列芯片),在底层设计上彻底颠覆了这种逻辑。
苹果搞的是 统一内存架构(Unified Memory)。简单打个比方:以前是CPU和显卡各端一个小饭碗,吃完了还得找对方倒菜;苹果则是直接在它们中间摆了一个洗脸盆一样大的巨型海鲜大排档。CPU、GPU和神经网络引擎(NPU)共享同一个超大、超高速的内存池。
当现在的 AI Agent(智能体)需要一边调动系统工具、一边反复推理大模型权重时,统一内存带来的零拷贝与极低延迟,简直就像开挂一样顺滑。
采购成本上的反差同样悬殊在英伟达高端专业计算卡一卡难求、显存动辄几十万元的当下,买一台顶配、拥有上百GB统一大内存的 Mac Studio,开销甚至不及传统方案的一个零头。
AI开发者们用真金白银的选票,把原本属于办公桌的Mac,活生生抬进了服务器机房。
4颗M8 Ultra暴力堆叠:从“胶水封装”到机柜巨兽
既然市场需求已经饥渴到了“私自拼装机架”的地步,苹果为什么不干脆自己出一款原厂的机架式AI服务器?
这正是目前曝光的苹果机密项目的核心。
根据 The Information 和 DigiTimes 披露的细节,苹果正在评估的企业级AI服务器,核心引擎将采用未来的 M8 Ultra 芯片。
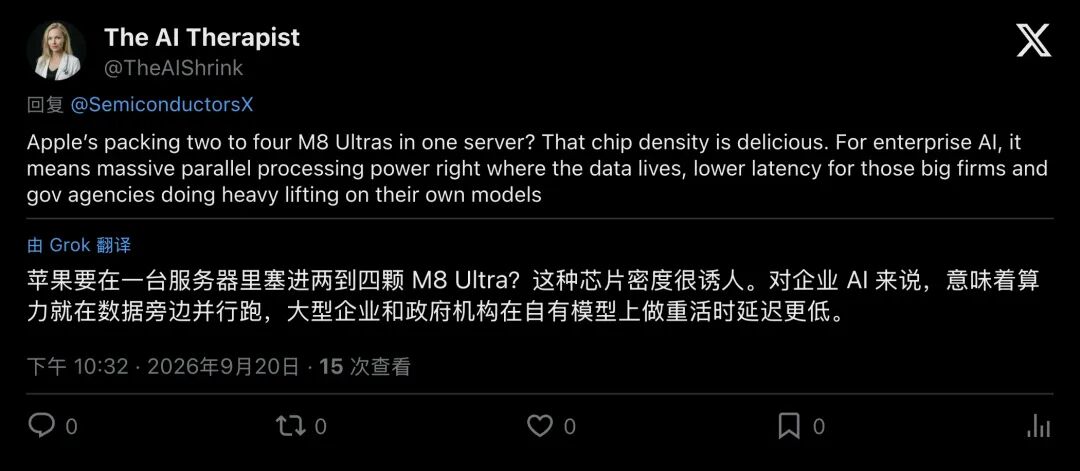
▲ 业内关注苹果在单台服务器内集成多颗M8 Ultra带来的芯片密度与并发算力
了解苹果硬件演进的读者都知道,苹果造 Ultra 芯片有一套独门绝技,UltraFusion。
简单来说,苹果从来没有单独流片过一颗庞大的 Ultra 芯片,而是通过微米级的高密度极速接口,把两颗顶级的“Max”芯片像乐高积木一样紧紧贴在一起。对操作系统和软件来说,它完全感知不到这是拼出来的,只觉得这是一颗带宽爆表、容量惊人的单体巨无霸 SoC。
而这一次,苹果的野心更大:他们打算在一台标准的机架服务器内,塞进 2 颗甚至 4 颗完整的 M8 Ultra!
这样一套整机方案,能把惊人的统一内存容量与密集的并发推理算力聚合在单机之内。对于高度重视数据安全与隐私的企业及机构来说,在本地机房部署几台这样的设备,无需依赖任何外部公有云,就能高效承接海量的AI推理工作。
它的定位非常明确,专为 “推理(Inference)” 这一高频刚需量身打造,避开了与训练大模型的庞大超算正面硬碰。
惊天妥协:苹果为什么不得不向英伟达“低头”?
然而,要把4颗芯片、甚至几百台服务器连成一个算力集群,苹果撞上了一堵自己从未翻越过的物理高墙。
封装互联,不等于机柜互联
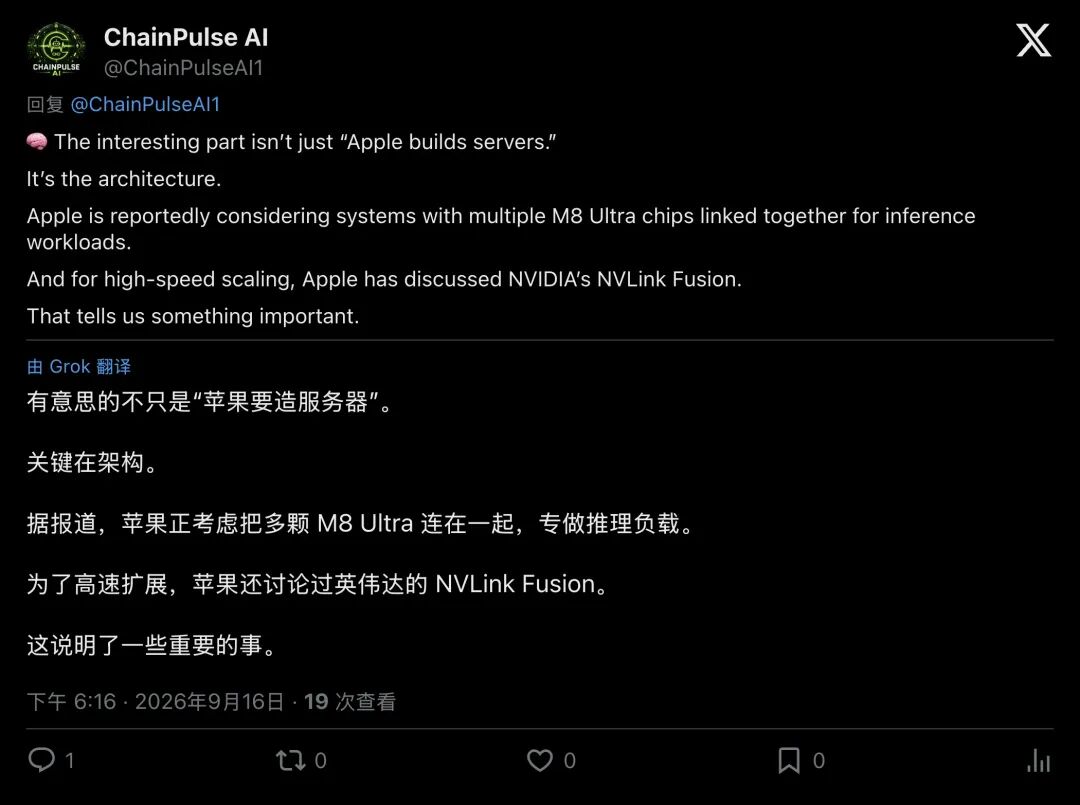
▲ 行业分析指出,苹果如果引入英伟达的NVLink,将彻底改变AI基础设施的分工格局
苹果擅长的是在几平方毫米的芯片封装内部搭“超高速立交桥”,也就是 UltraFusion。但如果要走出机箱,让几十颗芯片、多个机柜像同一台电脑一样协同工作,就需要一套遍布整个机房的“高铁网络”。
在数据中心级的超高速网络织物领域,英伟达的 NVLink 技术是统治性的霸主。
据内部知情人士透露,苹果工程师在评估后意识到:如果完全靠苹果自研一套跨机柜的高速互联方案,不仅研发周期漫长,成本更是高到难以承受。
恰在此时,英伟达向第三方芯片阵营开放了 NVLink Fusion 架构,允许非英伟达的自研定制芯片接入自己的高速网络生态。
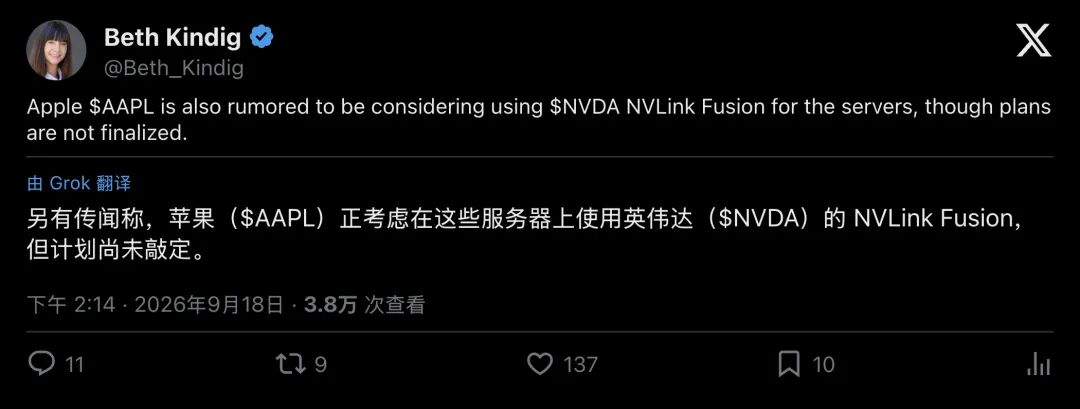
▲ 分析师指出苹果正评估采用NVLink Fusion,但最终方案仍存在变量
于是,一个看似不可思议的魔幻组合浮出水面:苹果的自研芯片大脑,搭上英伟达的高速互联神经网络。
这既是苹果向现实工程物理规律的低头妥协,也是一次精准的产业借力。苹果不需要重复造轮子去搞数据中心网络,只需把精力聚焦在自己最擅长的算力能效与统一内存架构上。
当然,评论区与产业链也有清醒的声音提醒:目前这一切仍在极其早期的商务与架构评估中,苹果未来同样有可能选择博通等传统伙伴,甚至不带 NVLink 独立出货。
幽灵归来:时隔15年,苹果如何面对Xserve的教训?
翻开苹果的历史档案,造服务器早有前例。
老一代果粉一定还记得 Xserve。早在2002年,乔布斯时代的苹果就曾雄心勃勃地推出过机架式服务器,先后搭载过 PowerPC 和英特尔处理器,运行着专门的 Mac OS X Server 系统。
但那场尝试最终以惨败告终2011年,苹果正式宣布砍掉 Xserve,彻底退出服务器硬件市场。
当年的死因非常简单:在通用的企业级软件生态面前,苹果那套封闭而傲娇的体系格格不入。 企事业单位要的是极其廉价通用的 x86 架构、遍布全球的7x24小时上门维保、以及深厚成熟的虚拟化工具链。
15年过去了,当苹果传出将目标定在 2029年 重新杀回服务器市场时,战场已经发生了天翻地覆的质变:
- 需求完全不同了
:当年买服务器是为了跑邮件系统和局域网文件共享;今天买服务器是为了以最低的电费和最大的吞吐量把 AI 模型跑起来。 - 底层底气不同了
:当年苹果用的是别人的芯片(IBM或Intel),毫无架构优势;今天苹果手里攥着全球能效比最高、统一内存最成熟的 Apple Silicon。
但挑战依然深不见底
硬件只是一张入场券一家习惯了直接面向个人消费者的硬件巨头,要去伺候对稳定性要求苛刻至极的企业客户,必须补上大量的脏活累活,从底层的 MLX 机器学习框架维护、到模型量化适配工具、再到长达数年的企业级运维合同。
任何一个环节掉链子,这场雄心勃勃的复仇都可能再度重蹈覆辙。
推理时代的军备竞赛:没有永远的单极霸权
跳出苹果这家公司本身,你会发现整个半导体行业正在迎来一场深刻的范式大迁移。
在过去三年里,科技圈的焦点几乎被 “大模型训练” 这单一维度完全垄断。谁拥有最多的英伟达顶级 GPU,谁就能在算力排行榜上傲视群雄。
但在2026年的今天,大模型的竞争重心正不可逆转地滑向 “边缘推理”。
训练模型是少数巨头的烧钱游戏,但让千千万万的模型在医院、银行、自动驾驶终端、企业私有机房里不间断地运转起来,才是商业落地的辽阔蓝海。
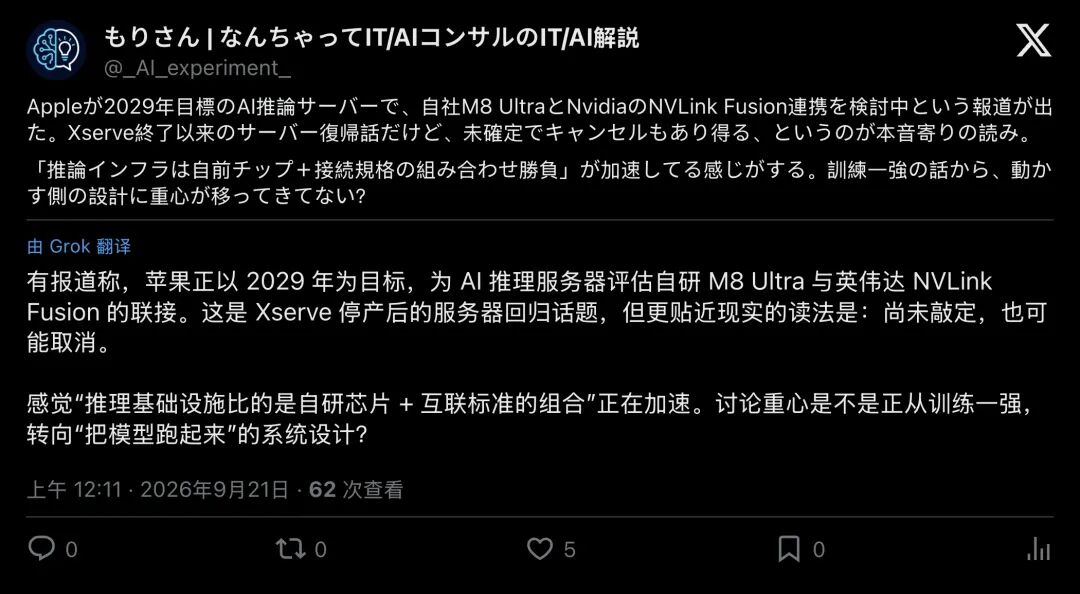
▲ 行业观察指出,推理阶段的竞争正在催生“自研芯片+异构互联”的全新整机形态
在这条全新赛道上,高通拿出了 Dragonfly 边缘推理机柜整案,先进制程与 3D 封装技术也在幕后默默输送算力支持。
苹果入局的传闻,为这场推理角逐注入了前所未有的变数。
它表明:AI 时代的硬件格局,绝不会由某一家芯片巨头长期独占。 当个人设备上的极致能效被搬进沉闷的数据中心机柜,当消费级的统一内存与工业级的网络架构擦出火花,一场前所未有的算力重构,才刚刚开始。