ARTICLE · 1064826
用AI编程助手玩转KWDB:从装技能到跨模查询,一盏茶的事
01. AI 编程工具这么多,为什么我选 AtomCode
现在的 AI 编程工具确实多。腾讯的 CodeBuddy 绑着自家云生态,OpenAI 的 Codex 走订阅路线,各家大模型厂商都在推自己的 code 工具,再加上 Cursor 这类独立派,选择困难症都犯了。
我的处境可能和你类似:个人开发者,没有公司报销,对价格敏感,但对工具的要求一点不低。这个前提下我选了 AtomCode,理由很直接:登录即可免费领 qwen 系列的 coding plan(27b 档位),对在校学生和个人开发者足够友好。
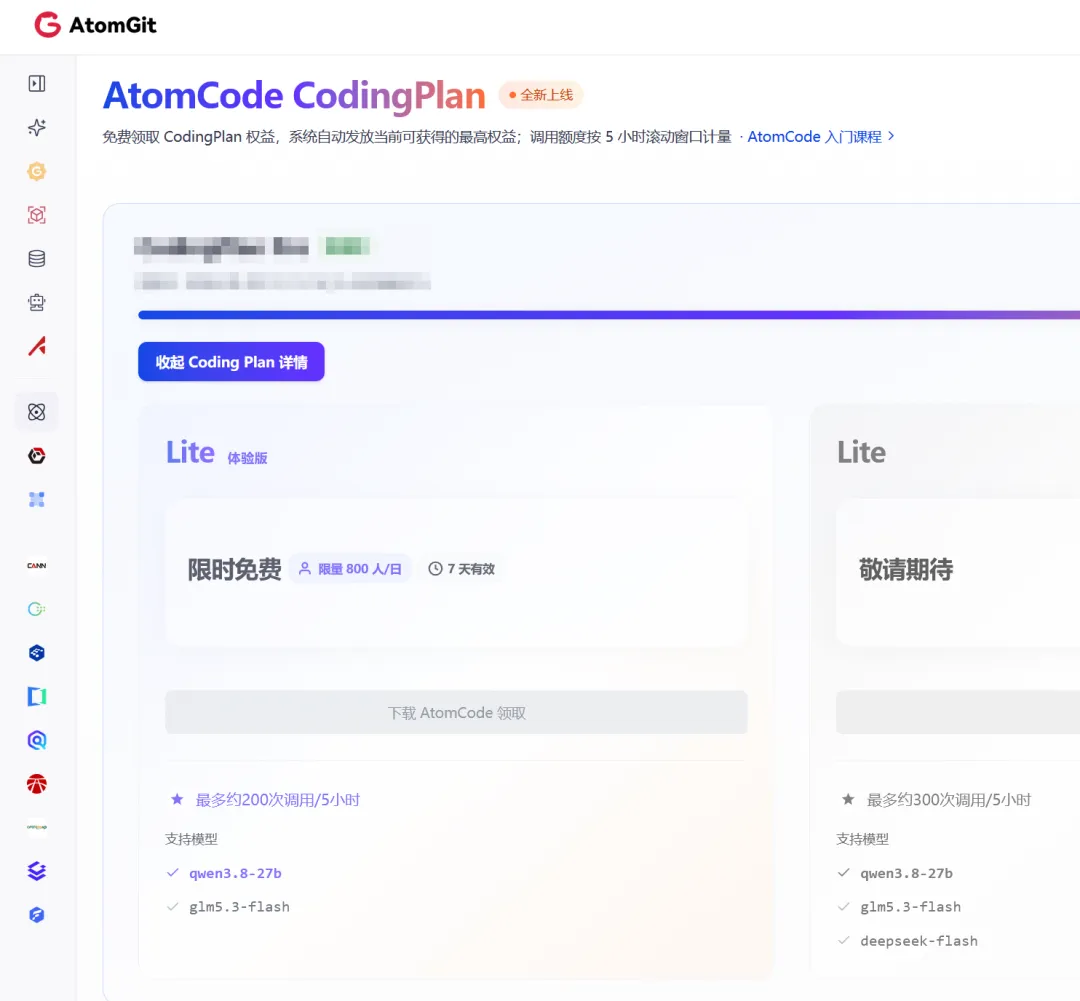
AtomCode 的主要特性,我上一篇《 AtomCode 越用越顺手的五点原因 》里介绍过:分层 prompt 工程给弱模型上硬纪律、缓存友好的上下文压缩、子代理分层与外部编排、维度 fan-out 加对抗 verify 的审查闭环、推理强度配置化。当时我统计了一个数字:四个月 4322 次提交,真正起作用的不是"让模型更聪明",而是把模型能力和工程系统拆开。
为什么越用越顺手?我的体感是三个字:有记忆。goal 持久化让任务中断后能接着干,/rewind 能回滚到任意 checkpoint,技能(Skills)机制让每次踩坑的经验沉淀成可复用的工作流。工具不再是一次性对话,而是越攒越厚的资产。这次 KWDB 的实践,就是这套机制的一次完整验证。
02. KWDB 是个什么项目,社区在玩什么
KWDB 是开放原子开源基金会孵化的多模时序数据库,KaiwuDB 的同源社区版,2024 年 8 月开源。截至发文,全网累计下载量接近 20 万次,拿过 Gitee 最有价值开源项目、OSCAR 尖峰开源项目,进了 OpenRank 全球开源项目新势力 Top10。代码在 Gitee、GitHub、AtomGit 三处都有镜像。
多模是它的核心卖点:一个库里同时有时序引擎和关系引擎,时序数据走 TIMESERIES 库,业务元数据走普通关系库,两边可以直接 JOIN。物联网场景下这个设计很实用,设备档案放关系表,采集数据放时序表,一条 SQL 出报表。
社区活动方面,最近的一件大事是 「KWDB 创作者计划」开源两周年特别季:首次上线文章加视频双赛道,三个征文方向(AI 创新、生态实践、实战落地),双赛道一等奖在年度社区 MVP 评选中有加成。安装、测试 KWDB,既能学到数据库的知识,又能积累实践经验,两全其美。
开源贡献对个人开发者的收益,我说实在的:
• 技术上:时序数据库是数据库领域就业面最窄但单价最高的方向之一。围绕 KWDB 的 Agent Skill、MCP Server、TSBS 基准测试做二次开发,练的是真功夫,简历上写"给某开源数据库贡献过性能优化 PR"比写"熟悉 MySQL"值钱。 • 情感上:你的名字出现在 contributor 列表里,你提的 issue 被官方认真回复,你写的文章被官方号转载。这种正反馈是打游戏拿不到的。社区征文奖项不止有礼物还有专属证书。
03. 实测:AtomCode 安装 KWDB 技能包
这部分是在我的 CentOS 7.9 机器上实测的,全程只用了自然语言加确认,没有手写一条部署命令。
第一步,装技能包。技能集在 atomgit.com/mydb/mydb-kwdb-skills,直接克隆就能用:
git clone https://atomgit.com/mydb/mydb-kwdb-skills.gitcp -R mydb-kwdb-skills/skills/* ~/.atomcode/skills/10 个技能立刻可被 AtomCode 识别:kwdb-agent 是汇总路由,剩下 9 个覆盖安装部署、编译、建模、迁移、Text2SQL、异常检测、巡检、性能审查、故障诊断。对在校学生和社区贡献者,这套技能等于把 KWDB 官方文档里的最佳实践变成了 Agent 的肌肉记忆。
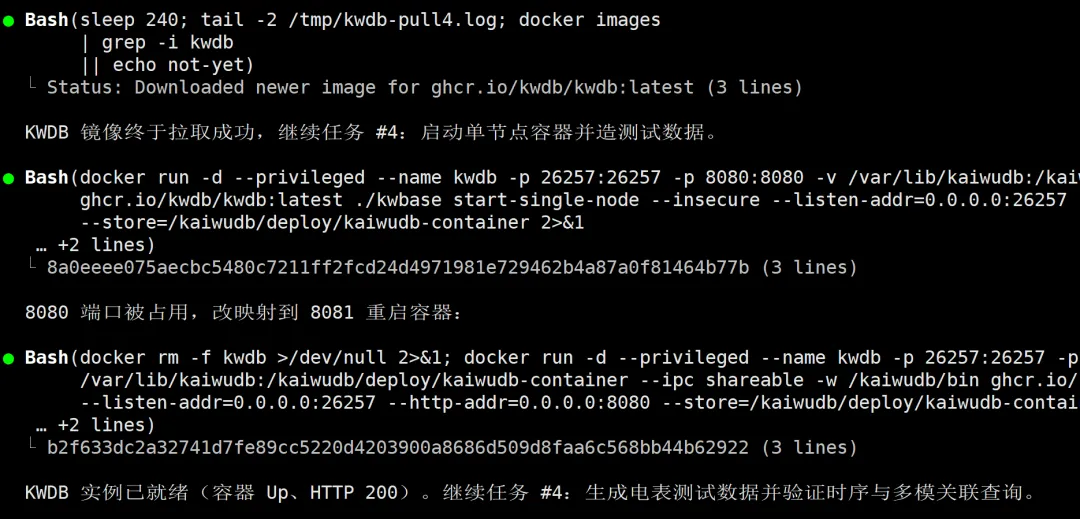
第二步,拉数据库镜像。我对 AtomCode 说"用 ghcr.io 拉取 kwdb/kwdb 镜像并启动单节点容器"。它执行了 docker pull,期间网络超时了几轮,Agent 自己做了重试;启动时 8080 端口被占用,它读报错改成 8081 映射,一次通过。容器健康检查返回 200。
整个过程我只给了目标,报错处理、端口调整这些脏活都是 Agent 在干。换个人肉操作,光查"port is already allocated"就得耗掉几分钟。
第三步,建库造数。我说"建一个关系库存设备档案,建一个时序库存电表读数,生成几条测试数据"。Agent 拆成了这样几步:
• 建关系库 iot 和设备表 devices,插入 3 条设备记录,一次成功 • 直接在关系库建时序表被拒( can not create timeseries table in relational database),Agent 查了自己的 KWDB 技能参考文档,改用CREATE TS DATABASE tsdb的时序库语法• 时序表 Primary Tag 默认可空被拒( tag device_type can not be a nullable tag as primary tag),Agent 给 TAGS 列加上 NOT NULL,建表成功• 插入 5 条跨设备的电压电流功率读数
两条报错、两次自愈,全程没有人工干预。这就是技能包的价值:KWDB 的语法约束(时序库独立建库、主标签非空)不在通用大模型的训练数据里,但在技能的 references 文档里。
第四步,验证时序与多模查询。我让它跑两组查询:
时序聚合,按设备统计:
SELECT device_id, count(*), min(voltage), max(power)FROM tsdb.metrics GROUP BY device_id ORDER BY device_id;结果:设备 1 有一条读数(最低电压 219.8),设备 2 两条(最高功率 310.9),数字和插入值完全对上。
多模关联,时序表 JOIN 关系表:
SELECT d.name, d.location, m.device_id, count(*) AS cnt, round(avg(m.voltage),2) AS avg_vFROM tsdb.metrics m JOIN iot.devices d ON m.device_id = d.idGROUP BY d.name, d.location, m.device_id ORDER BY m.device_id;结果:meter-01(厂区A)平均电压 219.8,meter-02(厂区B)平均电压 221.9。跨库 JOIN 直接跑通,时序数据和设备档案一张报表出齐。
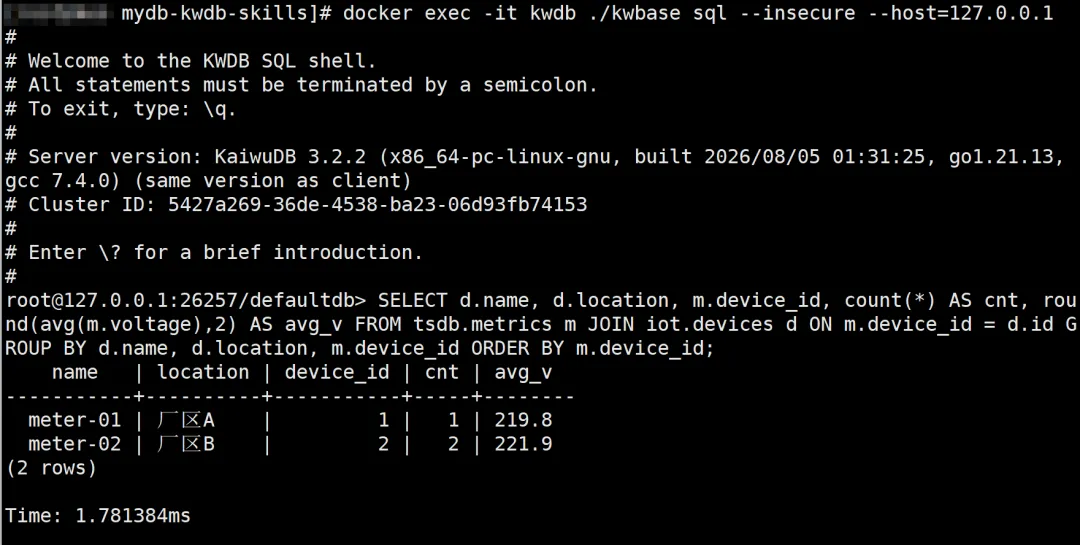
从零到验证完成,一杯茶的功夫,其中真正花我时间的只有看着 Agent 干活和最后核对数字。这套流程你现在就能拿去复现:装技能、说需求、等结果。
04. 最后
KWDB 把 Agent Skill 当产品能力交付,这条路我是认可的,两年内会看到一批围绕它生长起来的个人开发者生态。而 AtomCode 这类好用的 Agent 工具,把"玩转数据库"的门槛降到了会用自然语言的程度。两者的交集,就是普通人和企业级数据库之间的新通道。
接下来,你可以尝试三件事:装 AtomCode 领 coding plan,装 KWDB 技能包跑一遍上面的流程,然后把过程写成文章或者拍成视频投稿给 「KWDB 创作者计划」。
Have a nice day ~ ☕
公众号「少安事务所」,专注于数据 & AI 领域技术传播。
如果这篇文章为你带来了灵感或启发,请帮忙『点赞、转发、推荐』,感谢!ღ( ´・ᴗ・` )~