ARTICLE · 1069870
为什么蓝海产品没办法参考选品软件数据
很多人找蓝海产品时,会先打开选品软件,把月销量、销售额、BSR、评论数全部拉出来。只要看到销量是 0,或者整个细分类目都没有几个像样的数据,第一反应就是:这个方向没有需求。
这个判断放在成熟类目里有一定道理,但放到蓝海产品上,经常会把真正有机会的方向提前删掉。原因并不复杂:亚马逊从来没有把每个 ASIN 的真实销量公开给第三方。选品软件展示的销量,基本都是根据公开信号估算出来的。
蓝海产品的问题恰好在这里。它的搜索量可能不大,销量分散,关键词不统一,甚至还没有一个被市场广泛接受的产品形态。模型需要稳定、重复、可归类的数据,而蓝海在早期提供的偏偏都是零散信号。于是软件里的 0,很多时候不是没有人买,而是模型没有足够把握把这部分需求算出来。
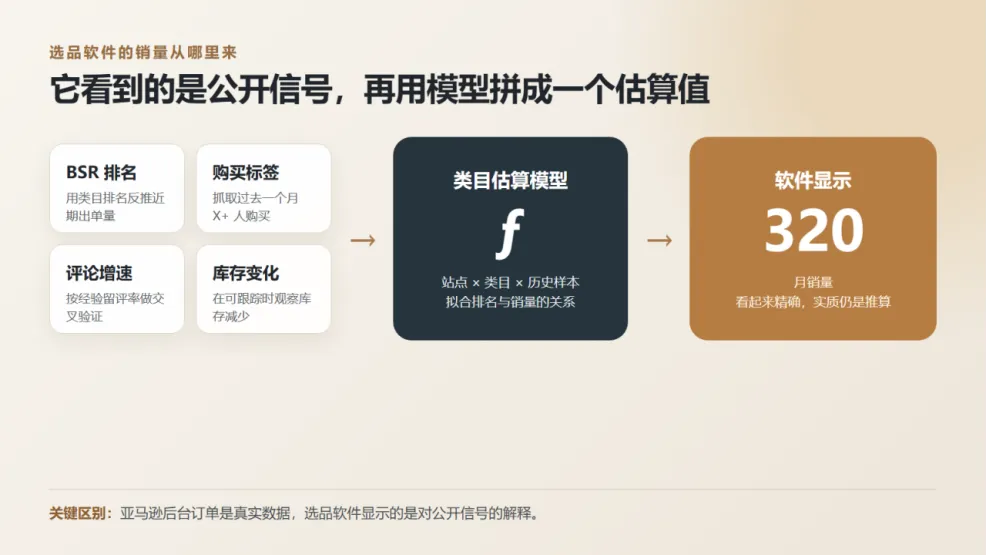
图 1 选品软件把公开信号输入类目模型,最终得到估算销量
选品软件看到的并不是真实销量
选品软件最核心的估算方法,是用 BSR 排名反推销量。每个商品页面都可能显示 Best Sellers Rank,也就是类目销售排名。软件持续抓取大量 ASIN 的排名,再用部分已知真实销量的样本,拟合出一条排名和日销量之间的关系。已知样本可能来自授权接入后台的卖家,也可能来自工具公司自己的运营数据。
但这条曲线不是全亚马逊通用的。美国站和日本站不同,家居类和电子类也不同。即使都是类目第 1000 名,对应的实际销量也可能差很多。只要站点样本少、类目划分不准,或者商品的排名不稳定,最后显示出来的数字就会明显偏离真实情况。
除了 BSR,软件还会拼接库存变化、评论增速、过去一个月 X+ 人购买标签,以及品牌分析里能够拿到的搜索和转化信息。这些信号都能帮助模型缩小范围,却没有一个等于卖家后台订单。软件显示 187 单,并不代表亚马逊向它开放了 187 条订单记录,只代表模型认为这个 ASIN 大约处在这个量级。
为什么软件明明能估成熟产品却看不清蓝海
成熟产品的数据像一条修好的公路。类目明确,关键词集中,头部 ASIN 长期有稳定销量,软件只要沿着已有关系继续推算,通常不会离谱到完全失真。蓝海产品更像一片没有路标的区域。用户的需求存在,但它还没有稳定地集中到某个类目、某个关键词和某种标准产品上。
比如用户需要一个能解决特殊收纳问题的产品,但市场上暂时没有直接对应的商品。有人买普通收纳盒回来改,有人搜索另一套说法,有人干脆在其他品类里找替代品。真实需求被分散在多个关键词和多个 ASIN 里。选品软件逐个看时,每个商品的销量都不高,甚至显示为 0;但这些零散行为背后,可能是同一个还没有被完整满足的问题。
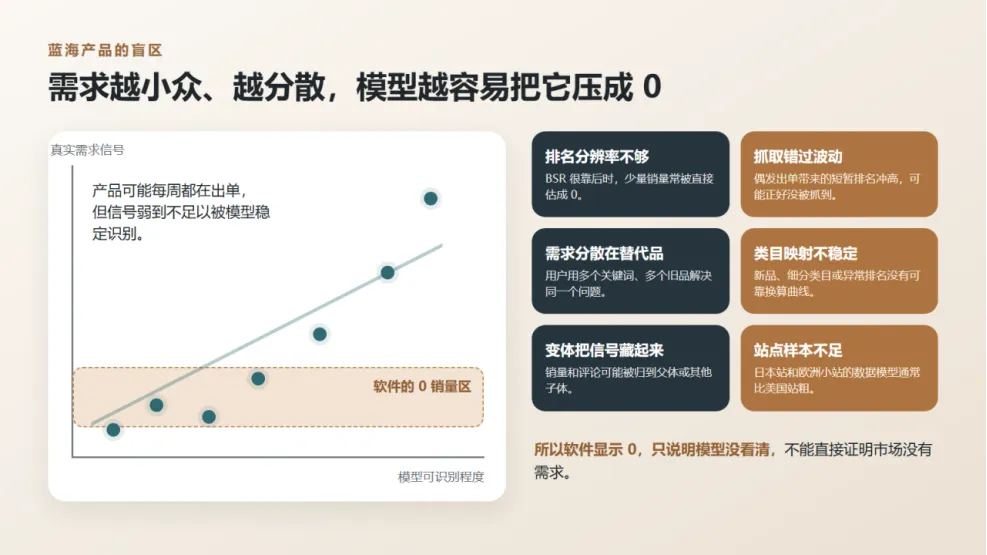
图 2 低频但持续的真实需求,可能长期落在软件的 0 销量区
蓝海产品最容易在哪些地方被算成 0
销量低于模型的分辨率
BSR 排到几十万名以后,排名和销量的换算关系会变得很模糊。一个产品每周卖一两单,真实世界里当然不是零,但模型为了避免给出过度精确的假数字,可能直接把它压成 0。对成熟卖家来说,这种销量没有研究价值;对寻找蓝海的人来说,低频需求却可能正是早期信号。
抓取频率错过了出单波动
低销量产品卖出一单后,BSR 可能短时间冲高,之后再慢慢回落。如果软件一天只抓一两次,正好错过排名变化,就会认为这个 ASIN 一直没有销量。销量越低、出单越不连续,这种误差越明显。
父子变体把销量藏到了别处
父子 ASIN 可能共享排名或评论,软件还需要判断销量应该分给父体、某个子体,还是按比例拆分。蓝海小类目的样本本来就少,只要变体结构稍微复杂,你看到的具体子体就可能显示 0,而实际订单被算到了父体或另一个子体上。
新品和细分类目没有可靠排名
新品、排名异常的商品,或者只挂在很细分节点下的商品,可能没有有效的大类排名。软件失去最关键的 BSR 输入后,只能依赖更弱的信号。数据库尚未收录、ASIN 刚合并、类目刚调整,也都会造成同样的问题。
小站点缺少训练样本
美国站通常拥有最多的商品样本和卖家授权数据,估算曲线相对成熟。日本站和欧洲较小的站点,类目样本少,模型会更粗。拿美国站的使用经验直接套到日本站,很容易把本来就微弱的蓝海信号进一步压低。
蓝海产品和成熟产品需要两套判断逻辑
判断对象 | 成熟产品 | 蓝海产品 |
核心信号 | 稳定 BSR、集中关键词、明确类目 | 分散搜索、替代方案、未满足问题 |
软件价值 | 估算市场容量和竞品量级 | 观察趋势和竞争,只能作为旁证 |
常见误判 | 把估算值当成精确销量 | 把 0 销量当成 0 需求 |
验证方式 | 多工具交叉和历史排名 | 用户证据、小批量测试和真实转化 |
选品软件擅长回答的是:市场上已经存在的商品,大概卖到了什么量级。蓝海选品真正要回答的是:用户有没有一个尚未被现有产品妥善解决的问题,以及这个问题是否值得付费。两件事相关,但不是同一个问题。
图 3 蓝海判断应从问题证据出发,并用真实市场测试收尾
没有软件销量时蓝海到底该看什么
先看需求怎么表达。搜索联想、问答区、差评、论坛和社交媒体里,用户是否反复描述同一种不方便。这里重要的不是某个关键词有多大搜索量,而是同一个问题有没有以不同说法持续出现。
再看用户现在怎么凑合。真正有价值的蓝海需求,往往已经产生替代行为。用户可能买两个产品组合使用,自己改装,接受明显缺点,或者花高价购买一个并不完全匹配的方案。这些行为比软件显示的 0 更接近真实付费意愿。
接着看竞争结构。头部是否被少数品牌垄断,评论门槛是否高,广告位是否拥挤,现有产品是不是只在颜色和尺寸上重复。蓝海并不等于完全没有竞品,更常见的情况是有需求、有替代品,但还没有把问题解决到位的直接产品。
最后必须回到小规模验证。小批量上架、低预算广告、独立站落地页、询盘和预售,都可以让真实用户投票。蓝海早期没有足够历史数据可供回看,只能用成本可控的测试创造新的数据。
选品软件仍然有用但要放对位置
这并不是说做蓝海就完全不用选品软件。它仍然适合看 BSR 历史趋势、头部集中度、价格带、评论门槛、关键词变化和竞品上新速度。你还可以结合过去一个月 X+ 人购买标签、评论增速和多个工具的估算,判断市场的大致量级。
真正需要放弃的,是对单一月销量数字的迷信。尤其当软件显示 0 时,先去检查它有没有有效 BSR、是不是父子变体、近期排名是否波动、站点覆盖是否足够,再决定这个 0 有没有意义。
如果你已经在同一个类目卖产品,最有价值的校准方法仍然是拿自己的真实销量和软件估算值对照。只有知道工具在这个站点、这个类目里通常偏高还是偏低,竞品数字才会变得可解释。
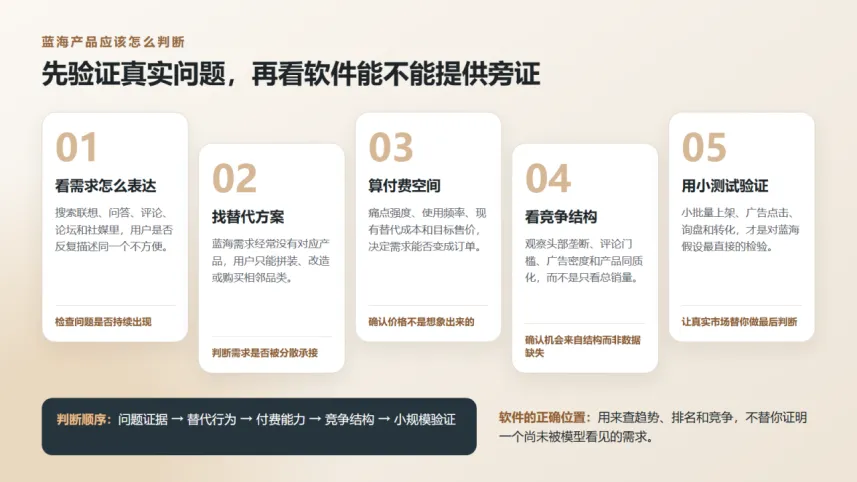
图 4 软件显示 0 时,需要先判断数据为何缺失,再决定是否放弃方向
软件看见的是过去蓝海要验证的是未来
成熟市场的优势,是数据多,比较容易算;蓝海的机会,恰恰来自数据还没有被充分积累。你不能一边要求产品足够新、竞争足够小,一边又要求软件提供像成熟红海那样完整、稳定、漂亮的销量曲线。
所以,为什么蓝海产品没办法参考选品软件数据?更准确地说,不是完全不能参考,而是不能把估算销量当成主要依据。软件可以帮你排除明显不合理的方向,也可以帮助你理解竞争,但它无法替你发现一个尚未被标准化、尚未被类目模型看清的需求。
当软件显示 0 时,真正要问的不是有没有销量,而是有没有真实问题、有没有替代行为、有没有付费空间,以及能不能用一个小测试把这些判断变成自己的数据。做到这一步,选品软件才会从裁判变回工具。