ARTICLE · 1070820
知识库从几份到几千份 PDF,你的向量化流程还高效吗
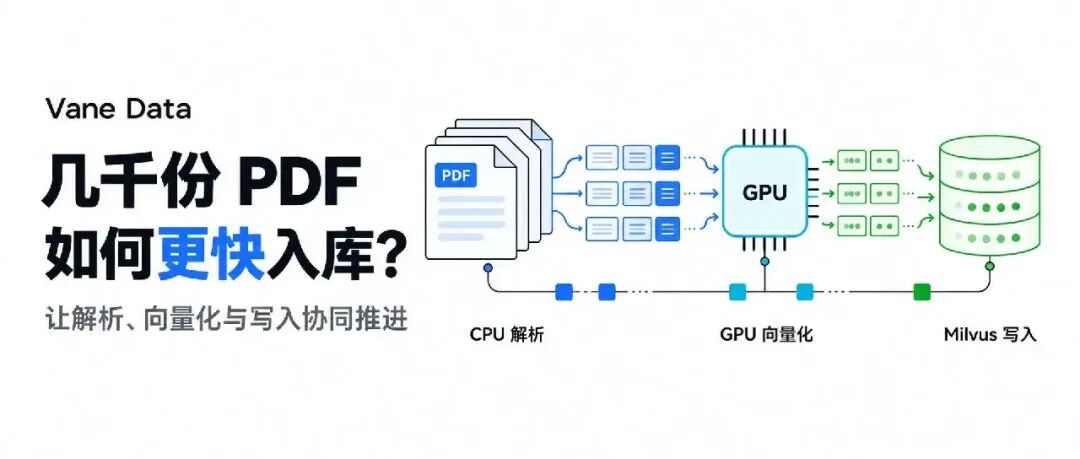
知识库刚起步时,你可能只需要导入几份产品手册,验证 AI 能不能回答业务问题。等效果得到认可,更多资料陆续接入:历史报告、操作指南、业务制度……几份 PDF,逐渐变成几千份。
原来很快就能跑完的程序,开始需要更长时间。新增资料要等多久才能检索?模型已经支持批处理,为什么处理任务还是慢?当知识库规模增长,值得重新审视的,就是从 PDF 到向量的这条流程。
几份 PDF,几行代码就能开始
PDF 进入知识库,通常要先提取文本、切成片段,再生成用于检索的向量,最后写入向量数据库。借助 LangChain、LlamaIndex 等工具,团队可以很快搭起这条流程。下面的 LangChain 示例,就把 PDF 读取、切分、本地 GPU 向量化和 Milvus 写入串了起来:
# 省略 imports、模型初始化和 Milvus 集合创建。# splitter:RecursiveCharacterTextSplitter;model:HuggingFaceEmbeddings。client = MilvusClient(uri="http://localhost:19530")for pdf in pdf_files:# 1. 读取 PDF 页面for page in PyMuPDFLoader(pdf).lazy_load():# 2. 切分文本 chunks = splitter.split_documents([page])# 3. 分批生成向量for start in range(0, len(chunks), 512): batch = chunks[start:start + 512] vectors = model.embed_documents([c.page_content for c in batch])# 4. 将片段和向量组成 rows,再写入 Milvus# 省略 rows 构造:每条包含 id、source、page、text、vector。 client.upsert(collection_name="pdf_chunks", data=rows)代码仅展示关键调用,省略 imports、初始化、记录组装与异常处理;model 内部配置推理批次为 32。Milvus 集合需提前创建。
对于少量文档,这样的起点直观、易于检查:一页文本切成了哪些片段、向量有没有生成、结果有没有写入,都容易追踪。示例也已经使用了批处理,一次向模型提交多段文本,并成批写入 Milvus。
但批处理解决了“一次处理多少”,还需要考虑“各个步骤能否同时推进”。 上面的写法会先处理当前页,再继续读取下一页。文档增加后,各环节之间的等待就值得关注。
上千份 PDF,光有批处理还不够
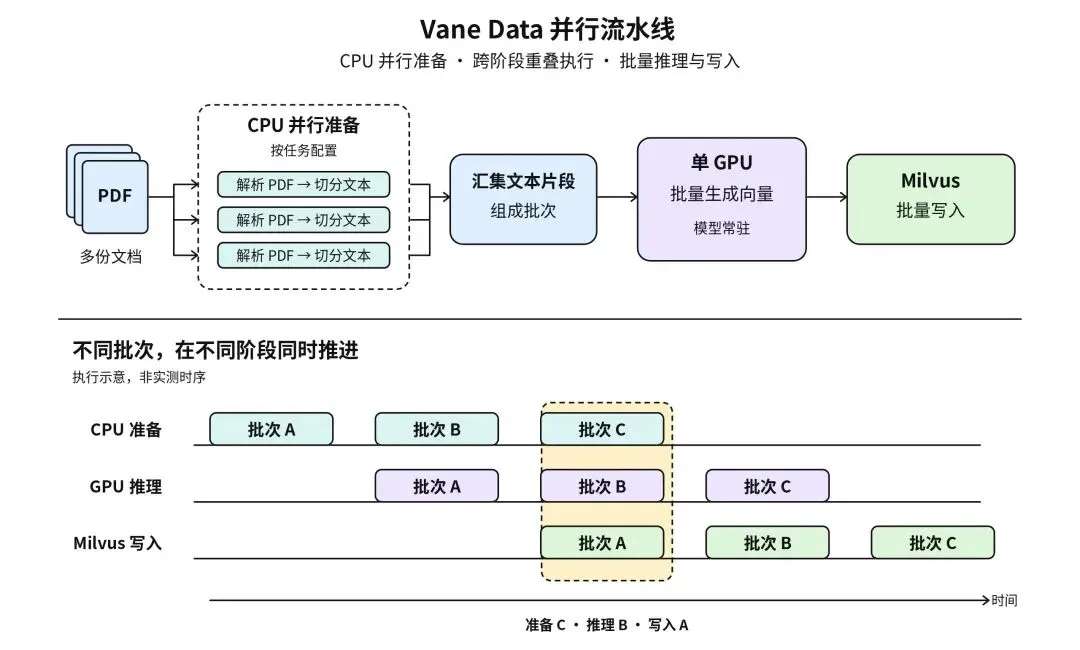
几千份 PDF 并不是几千个大小相同的任务。有的只有两页,有的接近百页;解析时间不同,切分后产生的片段数量也不同。文本提取和切分主要使用 CPU,向量模型则使用 GPU。如果 GPU 处理当前批次时,CPU 能准备下一批文本,就有机会减少等待。
单纯增加并发或调大批次,也不一定更快。文本供给不足,GPU 会等数据;准备得过多,中间片段会占用内存;写入跟不上,结果又会积压。高效处理大量文档,需要让解析、切分、推理和写入的速度相互配合。
让 CPU 持续准备文本、GPU 成批生成向量,再及时写出结果,流程可以这样组织:
LangChain、LlamaIndex 本身也提供了并发和批处理能力,团队可以继续在现有实现上优化。当你开始频繁调整进程数、批次和中间数据的暂存方式时,就值得考虑使用专门的数据处理引擎,统一组织这条流程。
用 Vane Data,让整条向量化流程高效运转
Vane Data 让你继续使用熟悉的 PDF 解析工具、文本切分器和向量模型,同时将它们接入统一的执行流程。把具体的解析和推理逻辑封装为处理函数后,通过下面几个公开 API,就能组织从 PDF 到 Milvus 的流程:
import vane# 省略文件清单 files(Arrow 表)与输出字段 schema 的定义。# 自定义 pdf_chunks:解析 PDF,切分文本,逐条 yield 片段。# 自定义 Embedder:初始化模型,将一批片段转为带向量的 Arrow 表。con = vane.connect()# 1. 读取文件清单,将 PDF 展开为文本片段chunks = con.from_arrow(files).flat_map(pdf_chunks, schema=chunk_schema)# 2. 由 GPU 工作进程批量生成向量vectors = chunks.map_batches( Embedder, schema=vector_schema, batch_size=2560, actor_number=1, gpus=1.0,)# 3. 通过 Vane 的 MilvusSink 批量写入vectors.write_datasink(vane.MilvusSink("pdf_chunks", uri="http://localhost:19530", primary_key="id", max_batch_rows=512,))pdf_chunks 和 Embedder 是用户定义的处理函数与类;此处省略实现。两段示例均写入包含 id 主键、source、page、text 和 384 维 vector 的 Milvus 集合,关闭 AutoID 和动态字段。Vane 引擎批次、模型推理批次与 Milvus 写入批次可分别配置。
代码中,flat_map() 将一份 PDF 展开为多个文本片段;map_batches() 将片段成批交给常驻模型处理;write_datasink() 通过 MilvusSink 批量写入向量和原文。每一步的业务逻辑清楚可见,执行工作交给 Vane Data 组织。
从几份文档扩展到更大的处理任务,团队可以围绕同一条流程配置推理资源和写入批次。解析工具、切分规则、模型选择仍由你决定,也可以继续沿用 LangChain 的文本切分器。Vane Data 的价值,是把这些处理步骤连接起来,让团队能够针对完整任务优化执行效率。
对于知识库团队,最终关心的是一批资料多久能准备好。为检验文档处理阶段的实际效率,我们进一步对比了 Vane Data、Ray Data 和 Daft 三种引擎。
同一任务,从近 7 分钟缩短到 86 秒
我们在同一台机器上,让三个引擎完成同一个 PDF 处理任务:提取文本、切分片段、生成向量并保存结果。三者使用相同的文本提取工具、切分规则和向量模型,并分别调优批次大小,比较完整流程的耗时。
以下性能数据来自 benchmark[1]:计时覆盖从读取输入到将向量结果保存为 Parquet 的完整处理流程,不包含上方示例中的 Milvus 写入及建索引耗时。结果如下:
Vane Data 在本次测试中完成最快:相比 Ray Data,耗时减少 32.2%;相比 Daft,耗时减少 79.2%。
这里的“近 7 分钟到 86 秒”,对应的是 Daft 与 Vane Data 在本次测试中的比较。它展示了同一项文档准备任务在不同引擎下的耗时差异;上方两段 Milvus 示例用于说明入库方式,未纳入这组性能对比。
几份 PDF 时,先把知识库跑通;几千份 PDF 时,让每一批资料更快准备好。如果你的团队正在集中导入历史文档,或需要缩短新增资料的处理时间,可以从现有的解析工具和模型出发,用 Vane 组织处理流程,接入 Milvus,并在自己的数据上检验加速效果。
测试说明:结果适用于本次单机测试及对应实现。硬件为 36 核 CPU、64 GB 内存、NVIDIA 2080 Ti(22 GB 显存),输入文件位于本地。
查看完整测试结果:https://vane.astrovela.ai/zh-CN/benchmarks
查看测试代码与复现说明:https://github.com/AstroVela/vane/tree/main/multimodal_inference_benchmarks