ARTICLE · 1072675
一张眼底照片,AI就能判出近视分级:准确率91%
"你家孩子多少度?"——这是家长之间最常见的问法,但在眼科医生眼里,"多少度"其实不是最有信息量的那个数字。
真正决定后续方案的是"分级"。临床按照屈光不正程度把近视分成四档:
• 轻度:−0.50 D −3.00 D(50300 度) • 中度:−3.00 D −6.00 D(300600 度) • 高度:−6.00 D −9.00 D(600900 度) • 超高度:低于 −9.00 D(900 度以上)
分级的差别不是"换厚一点的眼镜"这么简单。高度近视往往伴随眼轴拉长带来的不可逆解剖改变,视网膜脱离、黄斑变性的风险显著上升,需要更有针对性的并发症筛查;而不同程度的近视,对应的干预策略也完全不同。
问题是:准确分级依赖验光,而验光需要设备、需要配合、需要专业人员。 在学校、社区、基层医院这类大规模筛查场景里,验光资源恰恰是最紧缺的一环。
2025 年,中国科学院合肥物质科学研究院的团队在 BioMedical Engineering OnLine 发表了一项研究,给出了另一条路径:只用一张眼底照片,让 AI 直接判出近视属于哪一级。 他们提出的轻量化模型 X-ENet,在五折交叉验证下准确率达到 91.04%,比表现最好的经典卷积网络(Xception,85.79%)高出 5.25 个百分点;而且模型足够轻,可以跑在普通个人电脑上,还配了一个可视化操作界面。
下面把这项研究完整讲清楚。
一、为什么一张眼底照片,能看出近视程度?
先解释一个容易被忽略的生理事实:近视不只是"屈光度"这一个数字,它会在眼底留下可见的结构改变。
眼轴持续拉长,会伴随一系列不可逆的解剖变化——视网膜变薄、视盘扩大等。这些变化正是区分不同屈光状态的重要指标,也意味着眼底照片不只是"查眼病"的工具,它同样携带了判断近视程度的结构信息。
这个思路并不新。2018 年,Varadarajan 等人首次用深度学习从眼底照片预测屈光误差,证明了可行性;2021 年 Shi 等人的 MDNet 在 Optos 广角眼底图上做到平均绝对误差 1.1150 D;2024 年 Qi 等人的 DeepMyopia 用 160 万张眼底图预测儿童近视发生,AUC 超过 0.90。
但研究者在梳理已有工作时,指出了四个反复出现的共性问题:
(1)模型普遍偏重。 多数研究用 CNN,有些还叠加注意力机制或 LSTM 时序结构,设计复杂、算力需求高,专门做轻量化设计的研究相当稀少——而"能不能部署到基层设备上"恰恰决定了它能不能真的用起来。
(2)预处理不当会丢细节。 有些研究在预处理阶段过度损失图像细节,反而伤害了模型的泛化能力和稳定性。
(3)精度不够且缺乏可解释性。 模型给出结论,但说不清依据。
(4)对设备和环境过于敏感。 换个相机、换种光照,性能就明显下滑。
X-ENet 就是冲着这四个问题来的。
二、数据集:863 人、1637 张眼底照,四个等级几乎均衡
研究采集了 863 例近视患者(18~60 岁)的 1726 张眼底照片,经筛选后保留 1637 张作为最终数据集(剔除率 5.16%)。
采集设备是一台 FS-C1 数字眼底摄影与荧光检查仪:外接 2410 万像素专业单反相机,50° 广角视野(能覆盖视网膜结构、尽量减少拼接需求),采用两点对齐与自动眼位识别机制,成像时间小于 1 秒,并支持数字化存储。
数据分布如下:
值得注意的是,超高度近视组的剔除比例高达 14.01%,远高于其他三组。这很合理——度数越高,眼底病变和成像质量问题的概率越大,合格图像越难拿到。这也提示了一个现实约束:越是需要筛查的高危人群,图像质量反而越难保证。
四个等级最终样本量在 405~415 之间,分布相当均衡。这一点很重要:多分类任务里,类别不均衡会让"准确率"这个指标严重失真(模型只要全部猜多数类就能拿到高准确率),而这里不存在这个问题。
三、预处理三板斧:先把"没用的部分"去掉
原始眼底照片里有大量干扰:睫毛、眼睑造成的阴影与高光遮挡,以及眼底区域之外的大片黑色背景。这些都会拖累特征提取。
研究用了三步处理:
第一步,霍夫圆检测自动定位眼底区域。 输出圆心坐标与半径,再据此计算最小外接正方形进行裁剪,把边缘无关背景彻底去掉。
第二步,改良版 Sobel 边缘检测。 传统 Sobel 算子只能在 x 和 y 两个方向计算梯度,团队额外引入了 45° 和 −45° 两个卷积核,提高对对角方向边缘的敏感度。这样血管边界和视盘的提取精度明显提升。
第三步,傅里叶变换提取高频信息。 有意义的高频成分能增强特征表达与多样性,帮助模型抵抗噪声;把高频与低频成分结合起来,模型就能在多个频率尺度上分析图像,收敛更快、泛化更好。
最后统一归一化到 [0, 1]。
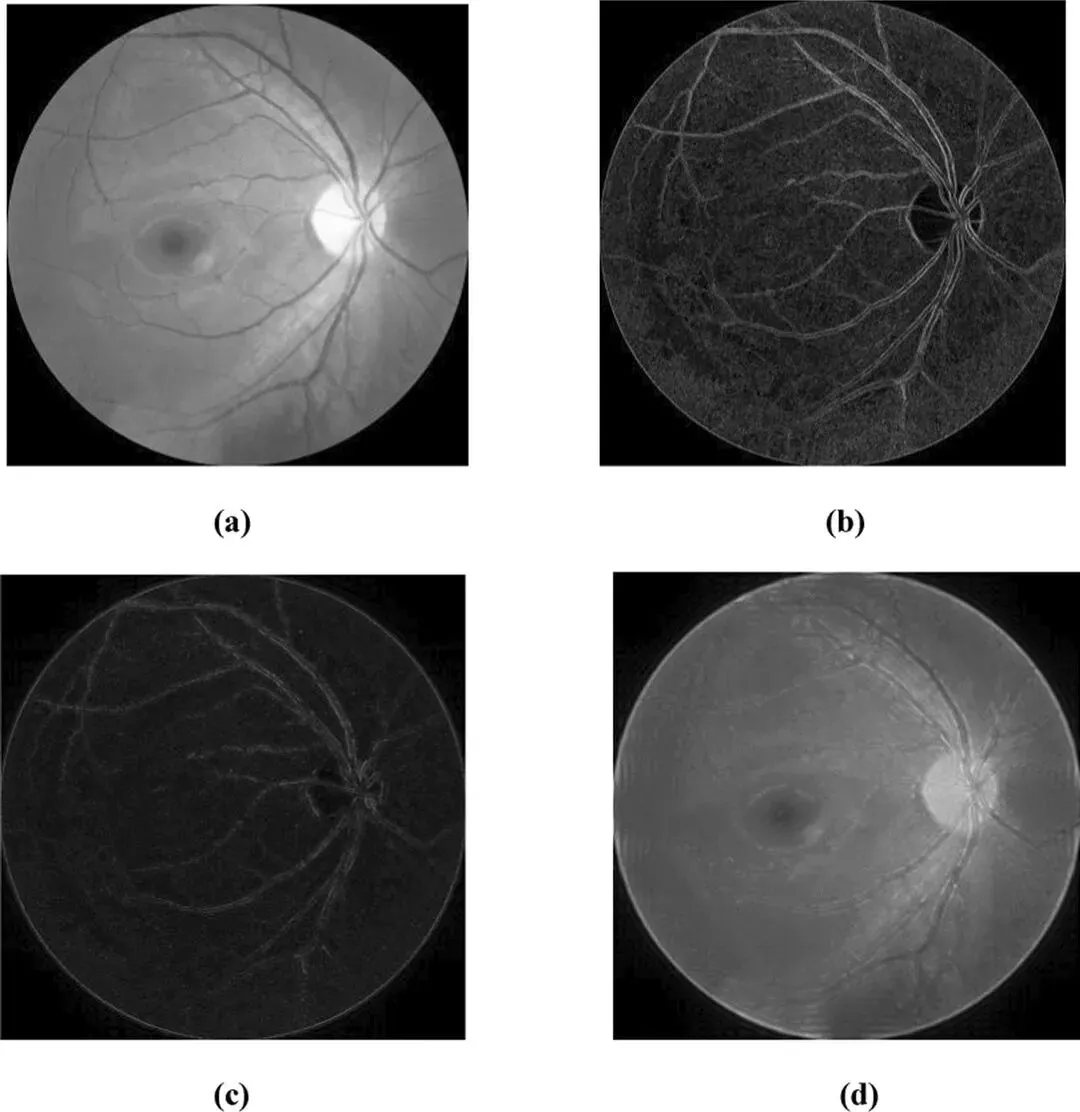
▲ 图 3:眼底图像预处理结果。(a) 裁剪后的图像;(b) 改良 Sobel 算子生成的梯度图;(c) 高频成分;(d) 高低频结合后的图像。
预处理到底有多大用?研究做了消融对比:
| Sobel + 傅里叶(本研究) | 0.9104 | 0.8154 | 0.8177 | 0.8147 |
结论很清晰:两种方法各自单独用都有提升,结合起来效果最好——相比完全不预处理,准确率提高了 2.3 个百分点。这个提升幅度看似不大,但考虑到 91% 这个基数,每一点都很珍贵。
另外,为了在小样本条件下抑制过拟合,研究还用了六种图像增强手段:随机旋转、水平/垂直翻转、随机比例缩放、加入均值 0 方差 0.5 的高斯噪声、CLAHE 对比度受限自适应直方图均衡化、以及基于梯度幅值的二值化。
四、X-ENet 的三件"轻量化利器"
X-ENet 的架构设计围绕一个核心矛盾展开:眼底图像个体差异大、需要足够强的特征提取能力;但要能部署在基层设备上,又必须足够轻。 研究用三个关键组件来平衡这一矛盾。
(1)动态卷积(Dynamic Convolution)。
传统卷积的卷积核是训练完就固定的。动态卷积则通过注意力机制自适应地聚合多组卷积核——每组核的权重由输入特征决定,模型能针对当前图像动态生成最合适的核组合。
为什么这对眼底图特别重要?因为患者的年龄和眼部健康状况不同,眼底图像差异很大,而不同近视等级下视网膜血管的结构和形态模式也各不相同。动态卷积让模型能灵活适应这些变化,从而更好地区分视觉上非常相似的类别——比如中度和高度近视。代价是额外的计算开销和参数优化复杂度。
(2)深度可分离卷积(Depthwise Separable Convolution)。
用来抵消动态卷积的开销。它把标准卷积拆成两步:深度卷积在每个通道上独立做空间特征提取(计算复杂度随输入通道数线性增长,而不是平方级),再用 1×1 的点卷积融合通道间信息、调整特征维度。
(3)ECA 通道注意力。
ECA(Efficient Channel Attention)用一维卷积替代了传统 SE 模块里的全连接层,大幅降低计算量和参数量,同时无需全局交互就能捕捉通道间依赖。对于结构复杂、特征细碎的眼底图像,这个设计尤其合适;相比 CBAM 和非局部注意力机制,ECA 引入的额外计算几乎可以忽略。
此外,网络还引入了残差连接与密集连接,保证梯度稳定流动、促进特征复用——这在小样本学习场景下对泛化能力至关重要。
整个网络分四个阶段:
1. 动态卷积特征提取:两个 3×3 动态卷积层,输出 64 通道,输入尺寸 224×224×3; 2. Basic block1(残差 + 深度可分离):3 个 Main module1 加 1×1 卷积跳跃连接,输出 728 通道、28×28; 3. Basic block2(密集连接 + 深度可分离):4 个密集连接块,增长率 k = 12,输出保持 728 通道、28×28; 4. Basic block3(深层卷积堆叠):输出提升到 2048 通道、尺寸降到 14×14,整合多尺度全局特征。
两个阶段之间各插入一个 ECA 注意力模块。最后经 1×1 全局平均池化与全连接层输出分类结果。
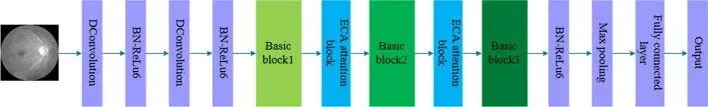
▲ 图 7:X-ENet 整体架构:动态卷积层 → BN-ReLU6 → Basic block1 → ECA 注意力 → Basic block2 → ECA 注意力 → Basic block3 → BN-ReLU6 → 最大池化 → 全连接层 → 输出。
训练配置:PyTorch 框架,Intel i5-12400F + RTX 3070 + 32 GB 内存;Adam 优化器,初始学习率 0.001,自适应学习率调度,交叉熵损失,批量大小 32,早停防止过拟合。
五、结果:91.04% 准确率,领先最强基线 5.25 个百分点
研究把 X-ENet 与 11 个经典网络做了横向对比,全部在同一数据集上以五折交叉验证方式训练评估:
| X-ENet(本研究) | 0.9104 | 0.9376 | 0.8154 | 0.8177 | 0.8147 |
X-ENet 在所有指标上都排第一。相比最强的基线 Xception,准确率高出 5.25 个百分点;相比表现最弱的 ConvNeXt,高出 36.37 个百分点。特异度 0.9376 意味着模型识别"非目标类别"的能力很强——在临床上,这直接对应更低的假阳性率。
研究者特别指出:AlexNet 和 DenseNet201 在识别高度近视时表现很差,原因很可能是它们捕捉视网膜图像中细微结构变化的能力不足。而 X-ENet 在相邻类别之间(比如中度与高度)的区分能力更强,这一点在混淆矩阵里可以直接看到。
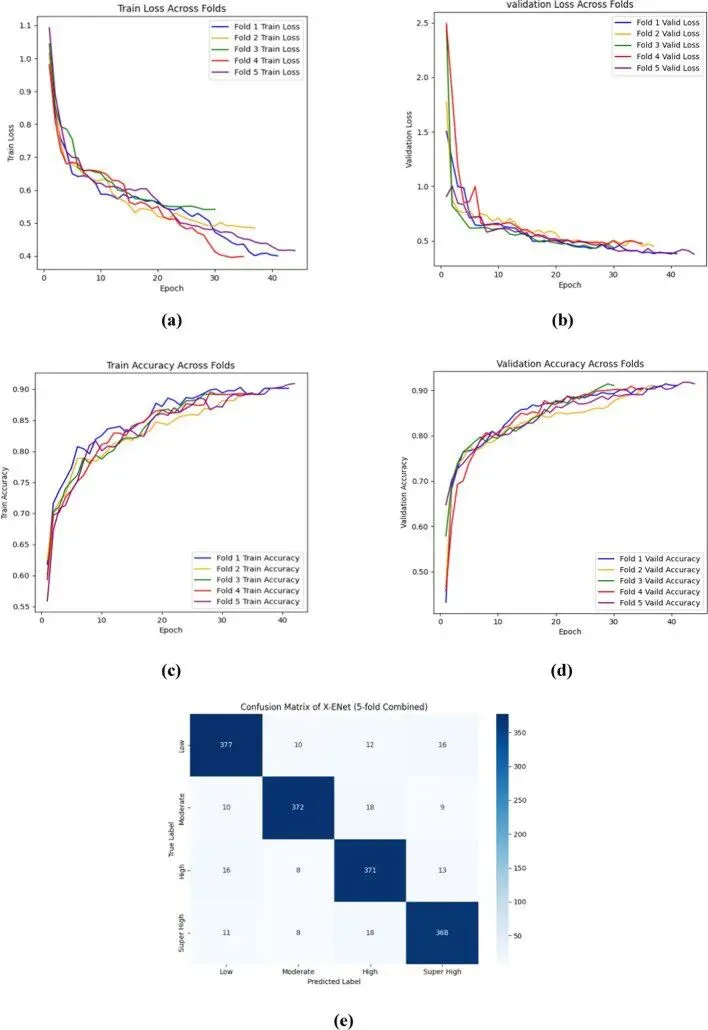
▲图 4:X-ENet 的训练过程与评估结果。(a) 训练损失曲线;(b) 验证损失曲线;(c) 训练准确率曲线;(d) 验证准确率曲线;(e) 五折合并后的混淆矩阵。五折曲线高度一致,说明训练稳定。
六、混淆矩阵里更细的答案(以及一处需要留意的不一致)
把图 4e 的混淆矩阵逐格数出来,能得到比单一准确率更有信息量的画面:
| 377 | |||||
| 372 | |||||
| 371 | |||||
| 368 |
对角线合计 1488 张,总数 1637 张,总体准确率 90.9%,与论文报告的 91.04%(五折平均)一致。
更值得关注的是四类的召回率高度接近(90.8%~91.0%),没有任何一类被"牺牲"。这说明均衡的数据集确实起到了作用——模型没有偏向多数类。
错误则主要落在相邻等级之间(例如高度被判为超高度 13 张、低度被判为超高度 16 张),这也符合预期:相邻等级的眼底特征本就更接近,而跨级误判相对更少。研究者也把"针对边界病例做进一步优化"列为了未来方向。
不过这里有一处必须指出来的问题。
论文报告的精确率 0.8154、召回率 0.8177、F1 0.8147,与它自己报告的准确率 0.9104、以及图 4e 的混淆矩阵在数学上难以自洽:在四类样本量基本均衡(405~415 张)的情况下,91% 的准确率必然对应约 91% 的宏平均召回率,不可能只有 81.8%。按混淆矩阵反推,四类的精确率分别约为 91.1%、93.5%、88.5%、90.6%,宏平均约 90.9%。
也就是说,0.8154 这组数字大概率来自某种不同的计算口径(或统计环节出错),而不是模型真实的类别级表现。引用这组指标时,建议以混淆矩阵反算的结果为准,或直接引用 0.9104 这个准确率。这不影响"X-ENet 优于基线模型"的结论——因为表 3 中所有模型用的是同一套口径,横向比较仍然成立。
七、模型"看"的是哪里?Grad-CAM 给出了答案
医疗 AI 最常被质疑的是"黑箱"。研究用 Grad-CAM 从高层特征层提取梯度信息,生成了类别激活热力图。
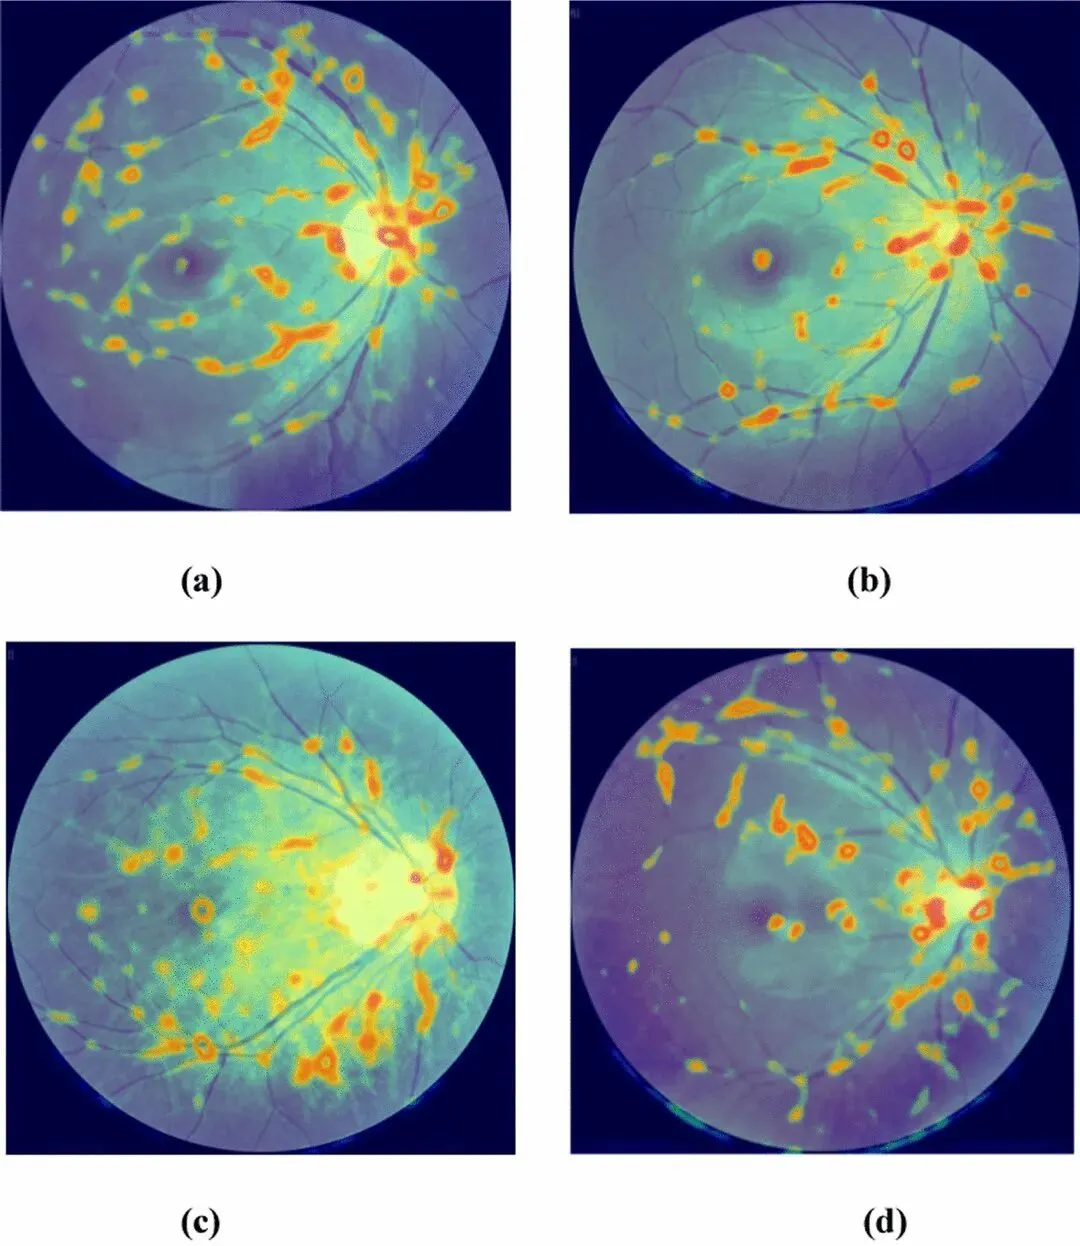
▲ 图 5:不同近视等级的类别激活热力图。(a) 低度;(b) 中度;(c) 高度;(d) 超高度。
结果相当有意思:
• 模型主要关注视盘、黄斑和血管分布等关键解剖结构,而不是眉毛、睫毛或图像边缘; • 随严重程度上升,关注区域逐步扩大:低度和中度近视的激活区域主要集中在视盘及其邻近血管;到了高度和超高度近视,激活区域显著扩大、强度增强,覆盖黄斑、视盘和更广泛的周边血管。
研究者认为,这与近视进展相关的生理改变相符,从而验证了模型特征提取过程的有效性和合理性。换句话说,模型不是靠"猜",它盯住的确实是会随近视进展而改变的结构。
八、不只停在论文里:一个能直接用的桌面工具
研究团队用 PyQt5 和 Python 把 X-ENet 集成成了一个可视化平台,包含五个功能模块:
1. 图像上传:支持常见格式的眼底图像; 2. 图像预处理:标准化处理并可视化类别激活热力图,标出模型关注区域; 3. 分类:用预训练的 X-ENet 给出近视等级; 4. 结果分析:通过交互界面显示分类结果与置信度; 5. 历史记录:保存图像名称、分类结果与置信度,支持回顾分析。
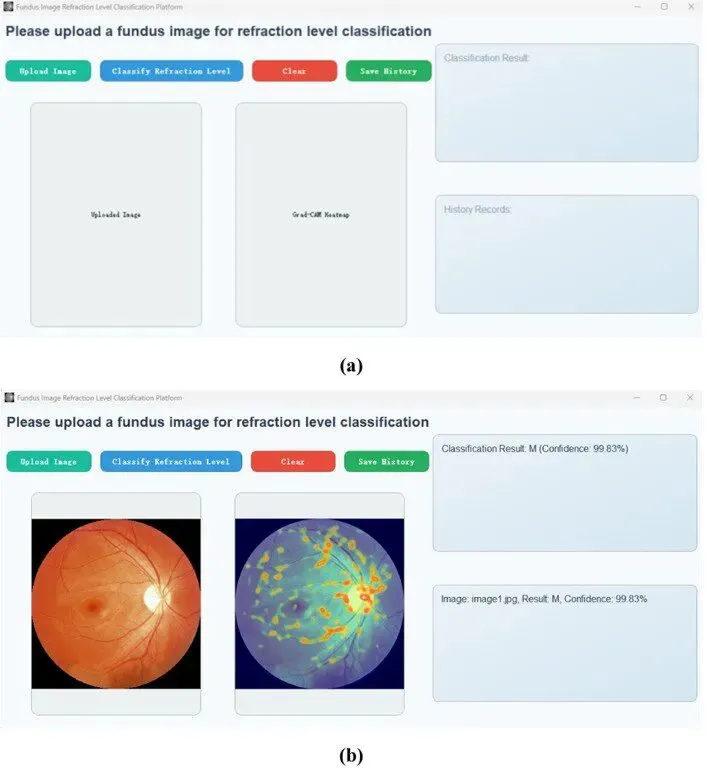
▲ 图 6:近视等级分类 GUI 平台。(a) 用户界面;(b) 分类结果与热力图显示(示例结果:M,置信度 99.83%)。
从"论文里的模型"到"医生能点开用的工具",这一步经常被跳过。这项研究把它做了出来,也是它区别于多数同类工作的实际价值之一。
九、局限:三点作者提到的,和三点需要你自己留意的
作者明确列出的改进方向:
• 数据集规模有限、来源单一。计划与医疗机构合作,纳入不同地区、不同设备、不同人群的眼底图像,提高数据多样性和模型适应性; • 图像质量干扰尚未彻底解决。后续将引入自适应滤波与去噪技术,去除睫毛阴影、反光等伪影,同时保留关键结构细节; • 单模态信息不足。计划构建融合眼底图像与关键临床参数的多模态框架,并开展前瞻性临床试验,用眼科医生的反馈检验模型的解释性、可用性和临床价值。
另外三点,读者自己需要留意的:
第一,这项研究没有做外部验证。 全部结果都来自同一数据集上的五折交叉验证。五折交叉验证能反映模型在"同源数据"上的稳定性(图 4 中五折曲线确实高度一致),但它无法回答"换一家医院、换一台相机还准不准"。
第二,部分对照模型的成绩异常偏低。
第三,数据集年龄是 18~60 岁,不含儿童青少年。
十、这项研究的位置:把"能不能做"推进到"能不能用"
把 X-ENet 放回已有的研究脉络里看,它的差异化定位很清楚:
• 2018 年 Varadarajan 等证明了可行性; • 2021 年 MDNet 把误差压到 1.1150 D,2024 年 DeepMyopia 把规模做到 160 万张图、AUC > 0.90——证明了精度可以很高; • 2023 年 Linde 等用手持眼底相机做到 75% 准确率,但受光照、手机硬件一致性和可解释性限制——暴露了落地难题。
X-ENet 选择了另一条路:不做最复杂的模型,而做最能落地的那一个。
它的三个选择都指向"可用":分类而非回归(直接输出临床需要的等级)、轻量化设计(能在普通电脑上跑)、可解释 + 有界面(医生看得懂、点得开)。
这条路线的价值不该被低估。在视力损伤的防控链条上,最大的瓶颈往往不是"顶尖医院能不能做对诊断",而是"资源有限的地方能不能做到初步筛查"。一个 91% 准确率、能在普通 PC 上运行的分类工具,和一篇 SOTA 论文相比,前者能覆盖的人可能多出几个数量级。
当然,它距离真正的临床部署还有几步要走——外部验证、儿童人群验证、指标口径的澄清。但方向是清楚的:让 AI 眼科筛查,从实验室走到诊室和校园里。
文献信息
Xing WM, Li XN, Ni JS, Zhang YZ, Li ZS, Liu Y, Wang YK, Huang Y. Deep learning for predicting myopia severity classification method. BioMedical Engineering OnLine, 2025, 24: 85. DOI: 10.1186/s12938-025-01416-2