ARTICLE · 1072666
AI 是怎么学会捏 3D 模型的
生成式 3D AI · 2020 → 2026
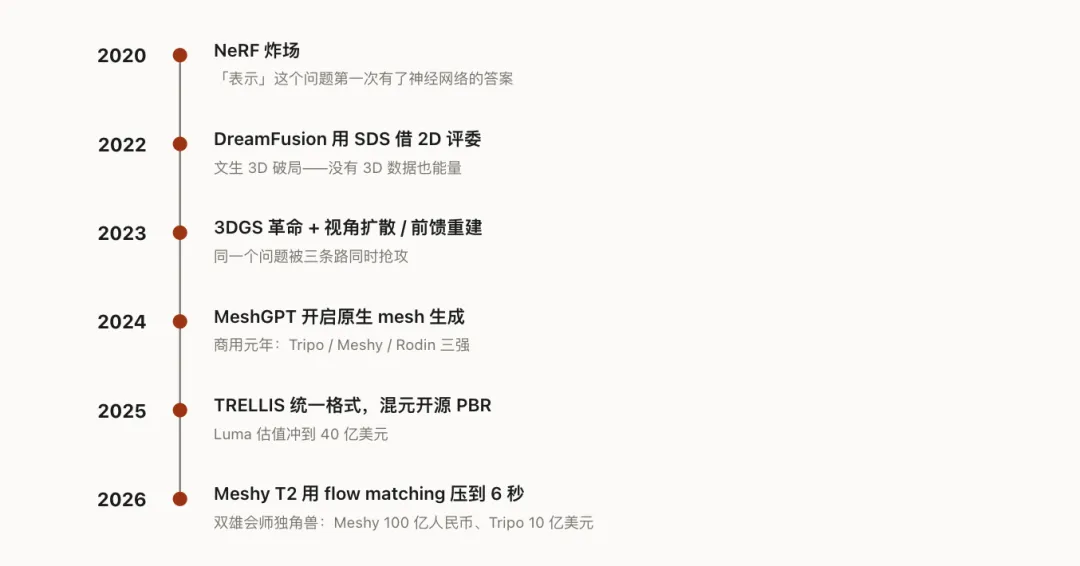
2020 年,一个角色资产的建模、材质、绑骨报价是 18000;2026 年,同一张需求图丢给 AI,十秒出一个。 这中间发生了六年的技术混战。这篇不讲「AI 好厉害」,只顺着一条线讲清楚: 每一步都是被上一步的毛病逼出来的——从隐式表示到显式表示,从借 2D 评委到自己长出手艺, 以及为什么最后的胜负手落在「布线干不干净」这种听起来很小的事情上。
三代范式8 张机制图3DGS 快约 100 倍Meshy T2:6 秒出网格
3D 的表示换了三代:SDF / NeRF(隐式)→ 3DGS(显式椭球)→ mesh(原生多边形)。表示一变,生成范式就跟着变一次。 没有 3D 数据怎么办:DreamFusion 借冻结的 2D 扩散模型当评委(SDS),代价是 Janus 多面脸——评委这辈子只见过照片。 直接生成 mesh 的主流是自回归,死穴是「串行」;2026 年 Meshy T2 改用 flow matching 并行解码,压到 6 秒、100% 成功率。 大厂发论文做基建,创业公司做产品抢用户——所以一开源,砸的是所有订阅制玩家的定价权。
一、3D 该怎么「存」:从 mesh 到 NeRF
想让模型生成一个 3D 物体,第一件事就卡住了:在神经网络眼里,3D 物体长什么样?
游戏行业早有标准答案——mesh,一堆顶点连线围成面。听起来很自然,但它有个要命的毛病: 拓扑太乱。顶点怎么连、连几个,毫无规律。而神经网络最讨厌没规律的东西。
换个角度:别存形状了,存「空间里每个点离表面有多远」。 在物体外面为正,在里面为负,整个物体就变成一张连续的距离地图。这叫 SDF(Signed Distance Function,符号距离函数)。 可以想象成把一座雕塑泡进果冻,然后记录果冻里每一个点离雕塑表面的距离。
2019 年,DeepSDF 第一个把它喂进神经网络:输入一个坐标,输出一个距离。 百万个模型压进去,它就成了张「3D 形状的压缩表」。神经网络第一次被当成 3D 数据库用。
一年后,另一群人走得更远——不存表面了,干脆把整个空间都存下来。 这伙人叫 NeRF(Neural Radiance Fields,神经辐射场,2020,UC Berkeley)。
做法是:给网络一对输入(一个坐标 + 一个观察方向),它回两样东西——这个位置 是什么颜色、有多实(密度)。然后从相机位置往场景里射一条线, 沿线一路采样、每个点问一遍网络,再把颜色一层层叠起来。一张照片就这么「算」出来了。
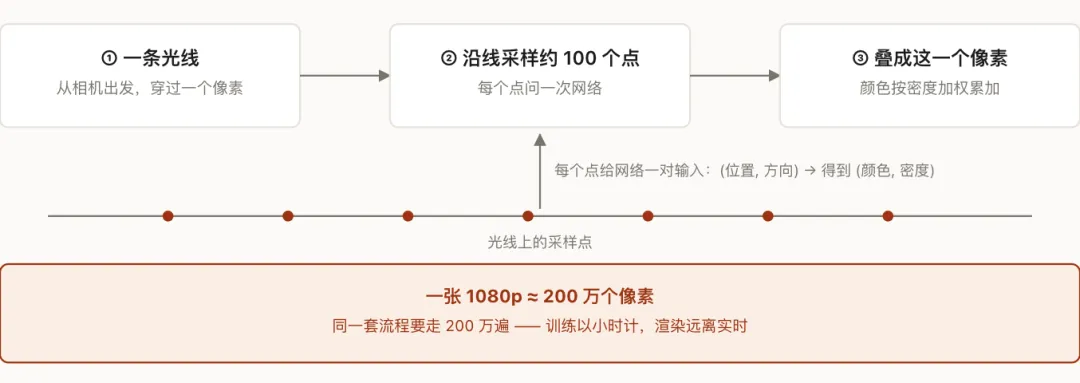
二、NeRF 的致命伤:太慢
渲染一个像素要沿线采样几十上百个点,每个点都得跑一遍神经网络。 而一张 1080p 的画面有 200 万个像素。训练一个场景几个小时起步,训完还只能渲染这 一个场景——想换个东西?从头再来。
于是开始打补丁:
- pixelNeRF
(2021):给一张照片直接推理出 NeRF,终于不用一个场景训一次。 - Instant-NGP
(NVIDIA,2022):把那个大 MLP 换成一堆多分辨率哈希表,训练时间从小时砍到秒。
但真正的革命在 2023 年。SIGGRAPH 2023,法国 INRIA 的一群人甩出一篇 3D Gaussian Splatting(3DGS),思路清奇到:神经网络?扔了。
改用几百万个带颜色的小椭圆(高斯椭球),直接把场景「堆」出来。 每个椭球有自己的位置、大小、朝向、颜色、透明度;渲染时按远近排个序,一层层叠上去—— 纯光栅化,一次神经网络推理都不用。 结果是 1080p 实时 100+ FPS,画质不输 NeRF,快约 100 倍。
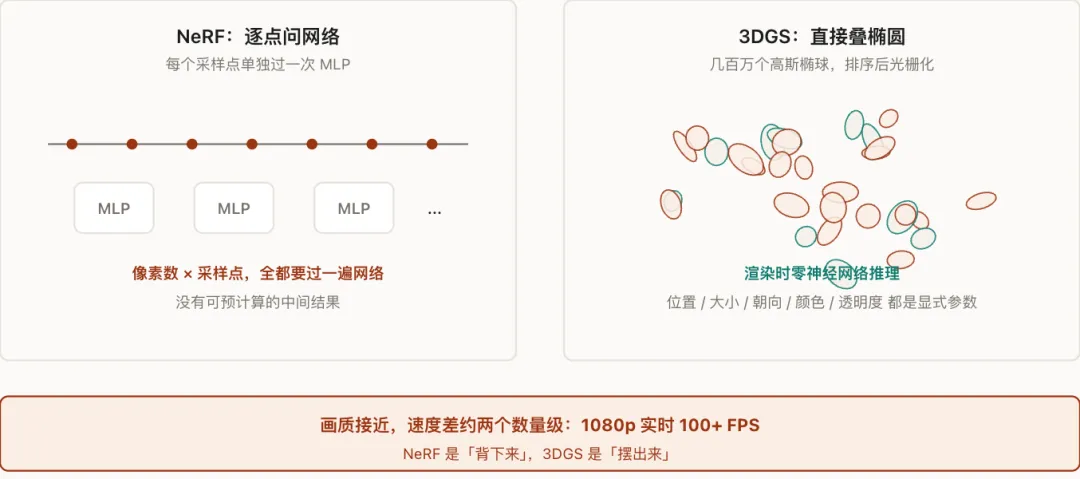
一个不严谨但好记的比方:NeRF 像「一个记性超群的人,把每个角落死死背在脑子里,你问他一句他答一句」; 3DGS 像「直接往空中撒几百万颗珠子,你从哪个角度看,都是珠子拼出来的画」。
表示的问题到这儿告一段落。接下来才是正题:生成。
三、没有 3D 数据,怎么生成:借一个 2D 评委
2022 年,目标变成「输入一句话,输出一个 3D 模型」。然后撞上第二堵墙: 没有 3D 训练数据。 互联网上有几十亿张带文字的图片,文生图扩散模型就是吃这个长大的;但高质量 3D 模型全网翻个底朝天也就百万级, 还都是椅子、桌子、汽车这种。数据量差着三个数量级,硬训喂不饱。
Google 的 DreamFusion(2022.9)给了一个天才到离谱的答案: 没有 3D 评委,那就借 2D 的用。
四步:随便初始化一个 3D 表示(一开始就是一坨糊);从它身上渲染出一张图;故意往图上加噪声, 请一个冻结的、已经看过几十亿张图的 2D 扩散模型来猜「这坨东西里面加的噪声长什么样」; 它猜出来的噪声和实际加的噪声之间的差,就是「这张图哪里不像真的」——把这个差当成梯度, 回头去改 3D 参数。
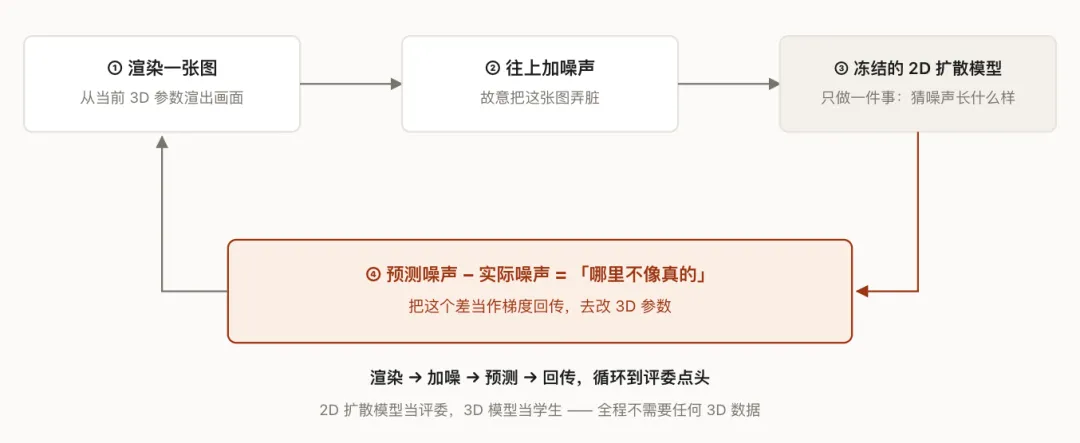
这套路叫 SDS(Score Distillation Sampling,分数蒸馏采样),是整个文生 3D 的奠基技术。 后续就卷疯了:
- Magic3D
(NVIDIA,2023):粗、细两阶段走,快 2 倍、分辨率高 8 倍,第一次直接吐出带纹理的 mesh。 - ProlificDreamer
(清华,2023):升级蒸馏算法(VSD),治好了过饱和,质量起飞。
但 SDS 有三个毛病,怎么治都治不好:
- 慢
——优化一个模型几十分钟。 - 糊
——出来的东西像被水泡过,过于平滑。 - 多面脸。
第三个值得单独讲,它有个专有名词叫 Janus 问题(雅努斯,罗马神话里前后面各一张脸的神)。
为什么会长出多面脸?想想那个 2D 评委——它这辈子只见过照片, 而照片永远只是一个面。你问它「这个物体的背面长什么样」,它真不知道。 于是它一脸笃定地指导学生:「正面,应该长这样。」学生就傻乎乎地把物体的 每一个面都做成了正面。结果就是:一个模型,三张脸。
四、换个思路:先看懂图,再重建
Janus 的根子在于「评委没有 3D 概念」。那换一个懂多视角的评委呢?2023 年,三条路同时爆发。
路线 A · 视角扩散
Zero-1-to-3(Columbia,2023)训一个扩散模型,输入单张图 + 一句「从左边 30 度看」, 吐出那个角度下的新画面——绕开 3D,只学「视角变换」这一件事。 后来的 Zero123++、InstantMesh(腾讯,2024)都走这条路:单图 → 脑补 6 个视角 → 重建 3D,全程 10 秒。
路线 B · 前馈重建
LRM(Adobe,2023)把 LLM 那套 scaling 直接搬进 3D:5 亿参数 Transformer, 100 万 3D 资产喂下去,单图 5 秒吐出一个 3D——不优化、不迭代,一次前向传播搞定。 Stability AI 和 Tripo 拿它改成 TripoSR(2024):A100 上 0.5 秒出模型,还开源了。
路线 C · 3D 原生扩散
OpenAI 的 Shap-E(2023)不借 2D 了,直接在 3D 空间里做扩散,几秒生成。 质量一般,但思路很关键:让 3D 数据自己学自己。
三条路的共识
别再用 2D 评委打分了,直接生成 3D。这一步之后,「能不能秒出 3D」不再是问题, 新问题是「秒出来的东西,美术能不能直接用」。
五、终点站:直接生成 mesh
到这儿,AI 已经能「秒出」3D 了。但游戏公司拿到手一看,还是摇头—— 因为吐出来的是一坨「密集三角化网格」,几万个乱糟糟的小三角形密密麻麻糊在表面上。
人类美术做的模型恰恰相反:几千个面,布线干干净净,一条环线顺着肌肉走势绕过去—— 行话叫 artist-like mesh。为什么非要讲究布线?因为模型做出来是要动的,要绑骨骼、要做动画。 布线一乱,模型一动就烂:该弯的地方不弯,该转的地方卡死。
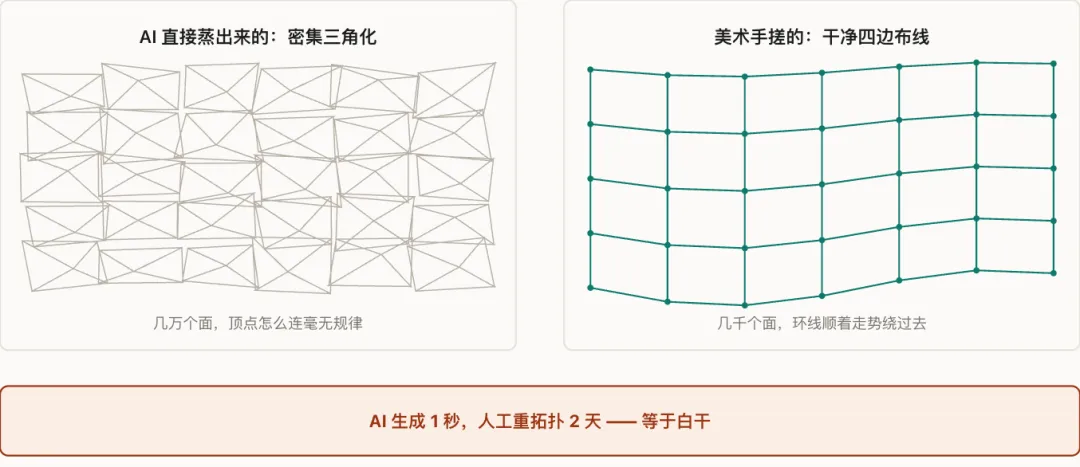
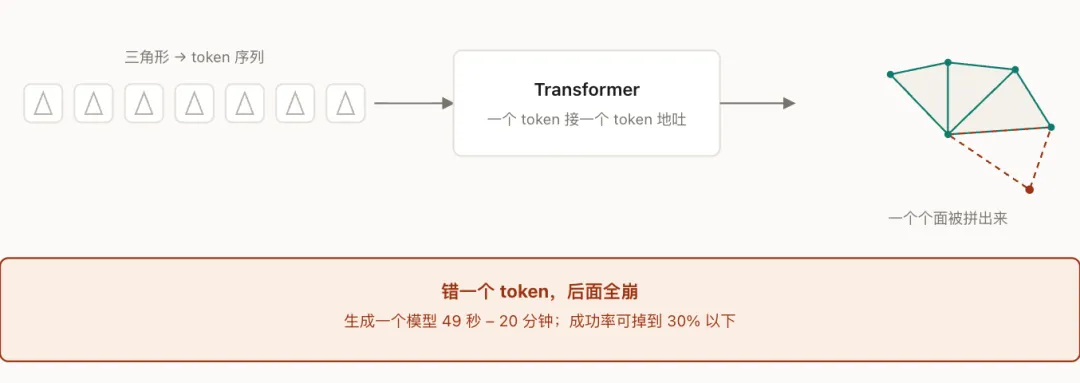
于是 2024 年,最硬核的路线登场:把 mesh 当成一门语言,让 Transformer 一个 token、一个 token 地「写」出来。
这个脑洞其实 2020 年就有人开过:DeepMind 的 PolyGen,先自回归生成顶点序列,再生成面, 只是当时没人当回事。到 2024 年这条线彻底爆发:
- MeshGPT
(TU Munich,CVPR 2024):先用 VQ-VAE 把三角形编码成 token,再让 GPT 式模型自回归生成。第一次生成出紧凑、布线像人做的网格。
- MeshAnything V2
(2024):让相邻三角形共享顶点,序列长度直接减半,能撑到 1600 面。 - MeshXL
(复旦 + 腾讯,NeurIPS 2024):250 万 mesh 预训练,参数干到 1.3B——第一次验证了 3D 也有 Scaling Law。 - Meshtron
(NVIDIA,2024.12):沙漏结构 Transformer + 滑窗推理,一口气支持 64K 面,比此前最好结果高一个数量级。
但这条自回归的路有个绕不开的死穴:它是串行的。 一个 token 接一个 token 地吐,中间错一个,后面全跟着崩。代价直接写在数字里: 生成一个模型要 49 秒到 20 分钟,成功率能掉到 30% 以下。 想拿它搭流水线?一个三次里失败一次的工具,没法用。
于是 2026 年 7 月,Meshy 甩出 Meshy T2,把「逐 token 串行」整个扔掉, 改用 flow matching——就是现在图像生成模型背后那套快速生成的数学。 两阶段走:第一阶段看着你的图,先框出一个粗糙的 64³ 体素脚手架; 第二阶段拿这个脚手架当底,把每一个顶点、每一条边、每一个面的绕序,一次性并行解码出来。
核心是一个 vertex-set VAE:一个顶点 = 一个连续 latent token,顶点和连接关系一起生成, 所以多部件物体(一辆车 + 四个轮子)会自己裂成干净的连通块,不用单独做部件切分。三个数字说明差别:
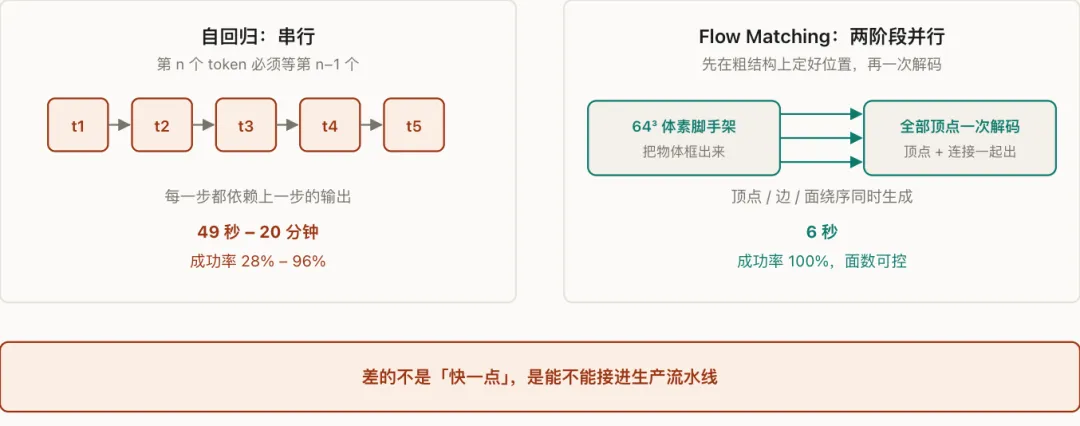
| 6 秒中位耗时,比自回归快一个数量级以上 | 100%重拓扑测试里的合法网格成功率(老方法 28%–96%) | 可控生成前告诉它要多少顶点,就按这个预算建 |
代码和权重已经放到 GitHub,不过许可写的是 CC BY-NC-SA 4.0——非商用, 所以「开源 = 白嫖」在这条线上暂时不成立。
与此同时,另一条线在解决「表示不统一」的问题,终极形态叫 TRELLIS(清华 + 微软,2024.12 开源): 搞了个统一潜在表示(SLAT),一个模型同时输出 mesh / NeRF / 3DGS 三种格式,2B 参数,CVPR 2025 Spotlight。 一年后 TRELLIS 2(2025.12)参数翻到 4B,新的 O-Voxel 表示把数据压 16 倍,3 秒生成。
还有一个绕不开的名字:腾讯混元 Hunyuan3D。2.0(2025.01)一开源就登顶 HuggingFace; 2.1(2025.06)是第一个开源的 PBR 材质方案,6GB 显存就能在本地跑。
到这儿,学术侧的三代范式齐了:
第一代(2019–2021):表示学习 —— NeRF 一统神经渲染 第二代(2022–2023):借 2D 评委 —— SDS 蒸馏凭空长出 3D 第三代(2024–2026):原生生成 —— 直接吐 artist-like mesh + PBR学术讲完了。接下来是商业战场——比论文精彩多了。
六、创业公司的生死簿
Luma AI:最优雅的叛逃
Luma(2021,Palo Alto)起点好得不像话:创始人 Alex Yu 是 UC Berkeley 搞 NeRF 的, 做了个「iPhone 拍段视频就能重建 3D」的 App,融资一路绿灯。 2023 年 11 月发布文生 3D 产品 Genie,Discord 上线首日几万人涌进来。 所有人都以为:Luma 要做 3D 界的 Midjourney 了。
然后他们掉头,做了视频。 2024 年 6 月 Dream Machine 上线,4 天用户破百万;这家「3D 公司」彻底转行做视频生成。 2025 年 11 月拿下 9 亿美元 C 轮,估值 40 亿,沙特 HUMAIN 领投,Amazon、AMD 跟投。 顺带一提,他们首席科学家宋佳铭是 DDIM 算法的发明者——Stable Diffusion 的底层技术之一。 人家不是跑路,是本来就有这本事。
他们的说法很文艺:「要做好 3D,必须先理解世界怎么动。视频,是通往 4D 的必经之路。」信不信由你,反正钱是真的。
Kaedim:AI 界的「机械土耳其人」
1769 年,欧洲展出过一台「会下棋的自动机器」,全欧洲震惊。多年后真相泄露: 机器肚子里,藏着一个真人棋手。这段典故后来有了个名字,叫「机械土耳其人」。
2023 年,404 Media 扒了 Kaedim——一家对外宣称「AI 自动把 2D 图转成 3D」的创业公司。 真相是:他们雇了阿根廷、印尼、埃塞俄比亚的 3D 艺术家,一个模型付 1–4 美元,有时候压根没用 AI,是从零手画的。 CEO 出来辩解:那不是外包,那是「质量控制团队」。更讽刺的是——2024 年 a16z Games 还是给他们领投了 1500 万 A 轮。
Meshy vs Tripo:两个 90 后的对决
这是中国 AI 3D 赛道的双雄会,人设工整得像编剧安排的。
胡渊鸣,1994 年生,Meshy 创始人。清华姚班 → MIT 博士(导师 Frédo Durand), 博士期间发了 6 篇 SIGGRAPH / NeurIPS,还独立写了 25k Star 的开源物理模拟框架「太极」—— 技术天才型。上面那个 Meshy T2 的论文,他就在作者名单里:产品在卖,论文在发,两头都抓。
宋亚宸,1997 年生,VAST(Tripo)创始人。Johns Hopkins 毕业(学的还不是 CS), 前商汤、MiniMax 联合创始人,重度游戏玩家——商业玩家型。
2026 年战报:
- Meshy
:近 4 亿美元 B 轮,估值 100 亿人民币,1200 万用户——AI 3D 赛道最高估值。 - Tripo
:2 亿美元 A+/A++ 轮,估值破 10 亿美元,2000 万用户——中国最快 AI 独角兽。
一个从技术深度打,一个从产品生态打,两家都赢了。这个赛道大到容得下两种活法。
大厂众生相
- NVIDIA
:不发 C 端产品,只发论文(Magic3D、Meshtron)+ 做基建(Omniverse)。翻译成人话:我卖铲子,你们去淘金。 - Microsoft
:开源 TRELLIS 一击必杀,然后 Azure 收租。经典微软打法。 - 腾讯
:混元 3D 全家桶开源。自媒体标题都是「暴击国外建模行业」——夸张,但定价权是真被砸了。 - OpenAI
:Point-E、Shap-E 起了个大早,然后资源全押 Sora。3D 先驱,变先烈。 - Meta
:3D Gen 论文一发就走,不给产品。人家做 3D 是为了给自家元宇宙补内容。 - Stability AI
:开源神话的代价——估值 10 亿 → 欠云厂商 1 亿 → 创始人跑路。开源一个模型,不等于跑通一个商业模式。
七、复盘:四条能带走的东西
一、这条技术路线是「缺陷驱动」的。 每一步都是上一步的毛病逼出来的:SDF 存不下细节 → 那就 NeRF;NeRF 太慢 → 那就 3DGS; SDS 有 Janus 问题 → 那就前馈重建;密集三角化没法用 → 那就原生 mesh 生成。 没有一步是拍脑袋想出来的。
二、表示和生成是绑在一起的。 NeRF 时代生成靠「优化」;3DGS 时代生成靠「蒸馏」;mesh 时代生成靠「自回归」; 到了 flow matching 阶段,生成靠「并行去噪」。表示一变,整个生成范式就跟着变一次。
三、大厂和创业公司根本不在同一个维度打架。 大厂发论文、做基建;创业公司做产品、抢用户。 所以腾讯和微软一开源,砸的其实是所有订阅制玩家的定价权。
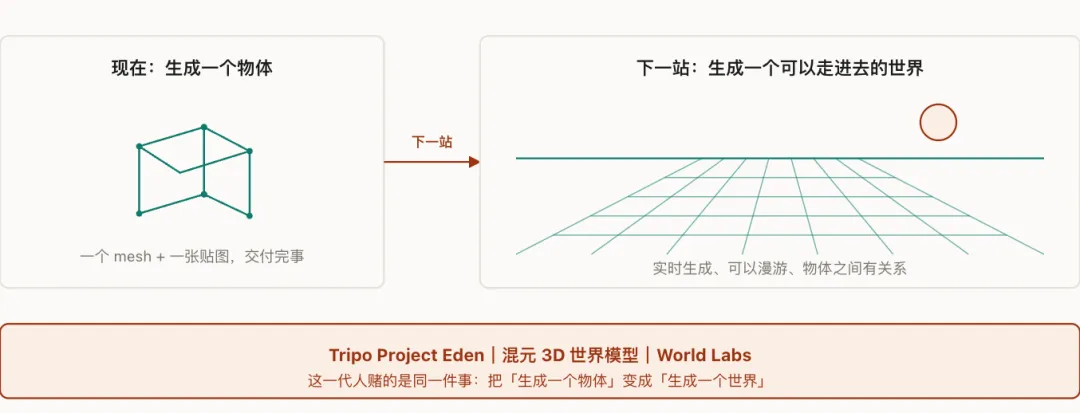
四、最后的瓶颈不在「能不能生成」,在「能不能生产级」。 今天所有模型吐出来的 3D,美术都得二次编辑。谁能把「70% 自动 + 30% 手动」变成「95% 自动」,谁就通吃。 这就是为什么 Tripo Studio、Meshy Agent 都在拼命做一站式工作台—— 生成只是门票,工作流才是护城河。
回到开头那个报价员。他 2020 年报价 18000 的活,2026 年 AI 十秒生成、成本 1 美元。 但他没有失业——他现在的工作变成了:从 AI 生成的 20 个方案里挑出最好的那一个,然后改布线、调材质、绑骨骼。
AI 干掉的不是人,是「从零开始」这四个字。
八、关键论文速查
整理自公开论文与产品资料,年份以会议 / 预印本首次公开为准; 商业数据(估值、轮次、用户量)来自公开报道,口径可能不一致,引用前请回原文核对。