ARTICLE · 1078226
软件本体论,同一个程序究竟存在在哪里|第13篇
两个人从相同源代码构建软件,得到的文件可能不同。即使得到了逐比特一致的文件,运行时也可能出现不同结果。
我查看可复现构建项目的定义时,发现它把条件写得很明确。相同源代码、构建环境和构建指令,应该让任何参与者重建指定的逐比特一致产物。依赖版本和环境变量等,也可能属于相关环境条件。[1]
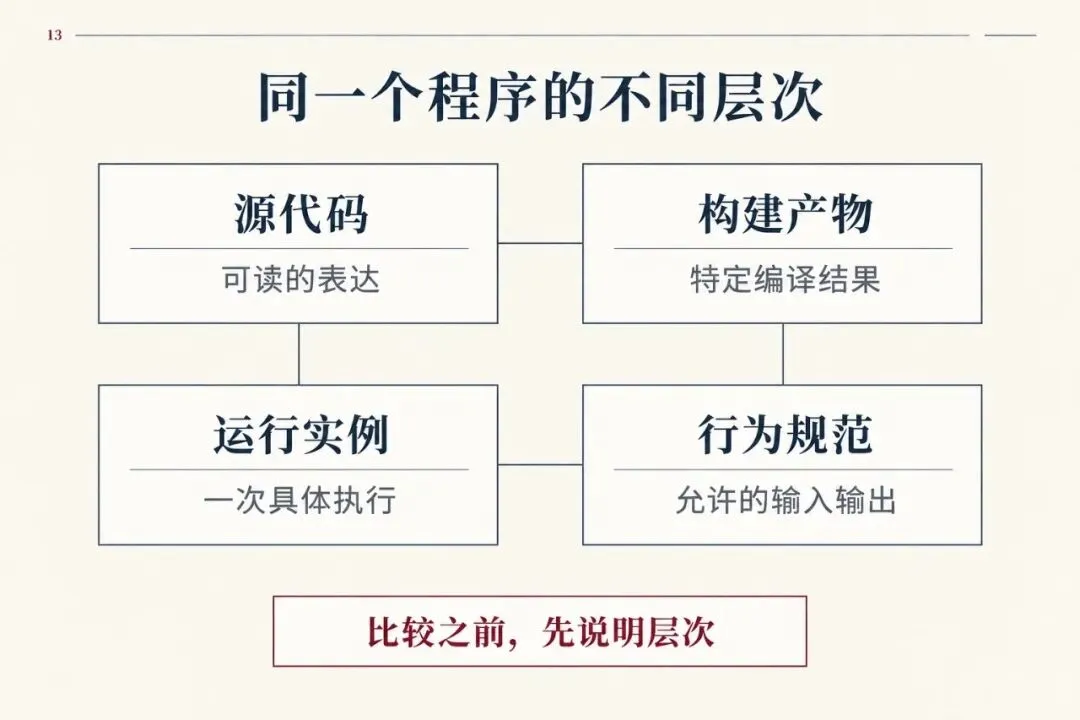
“同一个程序”需要先说明比较的层次。
源代码相同,还不够说明产物
源代码是一种表达。构建工具按照语言规则与配置处理它,产生特定产物。编译器和依赖变化,即使源文件没有改变,结果也未必相同。
可复现构建通过明确输入与过程,让产物一致性变得可检查。它还要求说明哪些产物属于验证范围,日志等辅助输出不一定包含在里面。[1]
这给本体论一个具体例子。选择对象之前,得决定包含什么。一个发布包、一个可执行文件和一次完整构建过程,有不同的边界。
不能只因为它们在同一个目录里,就当作同一种对象。
内容一致,实例仍然可以不同
假设把同一个可执行文件复制到两台机器,同时运行。一个进程收到输入甲,另一个收到输入乙。它们可以分别退出,也可以占用不同资源。
内容相同没有让两次运行合成一次。第3篇的质的相同与数值同一,在这里又能帮助我们。
Kubernetes 明确区分工作负载与具体 Pod 生命周期,替换实例也不能只靠名称相同来认作原实例。[2]
对软件资产管理而言,产品版本可以相同,部署实例仍需要分别追踪。漏洞修复覆盖了哪个实例、哪个实例还在接收流量,都不能只用产品名回答。
因此,至少要区分表达、构建产物和运行实例。它们相互联系,也各有独立的身份条件。
行为相同,又是哪一种相同
再做一个思想实验。两个程序在现有测试集上返回完全相同的结果,一个采用排序,另一个采用查表。我们可以把它们当作可互换的吗?
如果任务只限定那些输入,也许足够。输入范围扩大,或开始要求不同的时间与资源消耗,就需要重新比较。
测试通过表达的是有限观察。关于全部允许输入的行为等价,是更强的主张。若规范还包含错误处理和状态变化,只比较成功结果又会省略重要部分。
第8篇讨论过保证的范围。软件等价同样要说明允许哪些输入、观察哪些输出,以及忽略哪些实现细节。
这也解释了为何重写可以保留某些身份。业务可能把满足同一规范的新实现继续当作同一产品,但源码对象和二进制产物已经改变。不同层次的连续,不必同步开始和结束。
Git 的对象模型把内容、目录组织和提交历史分开,正好提供一个可以检查的技术参照。[3]
软件是否是抽象对象
哲学中的软件讨论经常涉及抽象与具体的关系。算法、程序文本和执行过程是否属于同一种存在者,以及程序如何被物理实现,都存在不同解释。[4]
一种有吸引力的理解是,把某些程序结构看作可以被多次实现的模式。它能够解释,为什么不同机器可以执行同一算法。接着仍要说明,怎样的实现才算实现了这个模式。
随意把机器状态对应到符号上,可能过于宽松。有效解释还要考虑状态变化是否按规则持续,面对不同输入时能否保持所声称的行为。
因此,“任何东西都能被解释成计算机”并不是工程上可以直接接受的结论。计算描述需要约束,否则它将失去区分正确实现与偶然相似的能力。
给软件身份分开记账
实践中可以为软件保存几种不同标识。源代码版本说明取了哪份表达,产物摘要帮助核对文件,部署标识追踪具体运行。行为规范则说明系统应该做什么。
这些信息不必合成一个万能版本号。合在一起反而容易掩盖变化发生在哪层。
迁移系统时也一样。保留服务名称,并不能说明运行实例未变。保留二进制文件,也不能保证外围配置与权限不变。每项连续性都应该有自己的检查办法。
软件的存在问题于是变得具体。它可以在不同层次被识别,但这些识别必须彼此对应,不能在论证中随意切换。
接下来,大模型把问题推得更远。一个程序内部形成了稳定结构,这个结构什么时候值得称为“世界模型”?
第14篇用可检查的研究证据来讨论。
资料来源
[1] 可复现构建的定义https://reproducible-builds.org/docs/definition/
[2] Pod 的身份与生命周期https://kubernetes.io/docs/concepts/workloads/pods/pod-lifecycle/
[3] Git 对象模型https://git-scm.com/book/en/v2/Git-Internals-Git-Objects
[4] 计算机科学哲学中的程序问题https://plato.stanford.edu/entries/computer-science/