ARTICLE · 1081936
华为昇腾960和阿里真武V900,国产AI芯片路线对决,谁更接近英伟达
华为昇腾960和阿里真武V900,国产AI芯片路线对决,谁更接近英伟达英伟达的一台搭载B300的服务器,在国内黑市已经炒到100万美元。在美国,同样的机器只要25万到35万美元。 高达3到4倍的溢价,还不是你想买就能随便买到的,这就是过去一年国产算力面对的现实。 在被逼到墙角之后,国产算力的反攻,正式开始了。 从9月17日到22日,五天之内,华为和阿里先后亮出了自己的底牌:昇腾960超节点和真武V900。两款芯片都锁定了2027年一季度量产,都号称面向十万亿级大模型。 这一次,华为和阿里走的是两条完全不同的路,目标都指向替代英伟达,那么谁离答案最近? 9月17日,华为全联接大会在上海开幕,轮值董事长汪涛发布了昇腾960超节点。 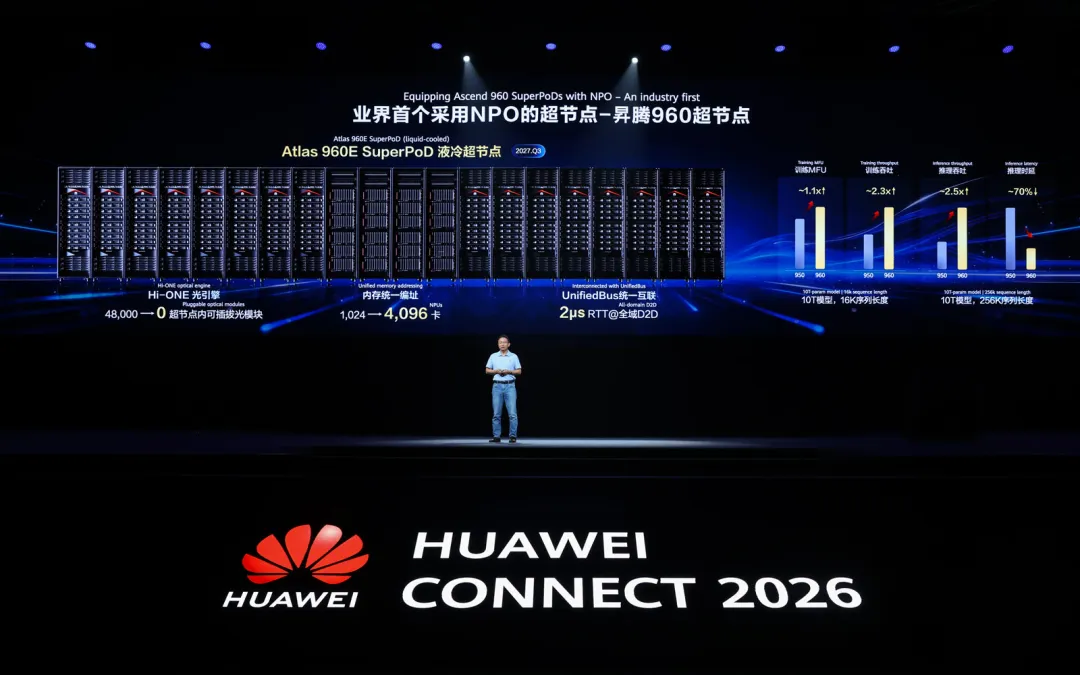
什么叫超节点?你可以把它理解成:把几千张卡用高速互联“焊”成一台超级计算机,逻辑上像一台机器一样工作。 上一代昇腾950可互联1024张卡,昇腾960超节点,一个单节点互联4096张算力卡,翻了四倍,总算力8EFLOPS(FP8精度),HBM内存高达1PB。这个体量,就是奔着十万亿参数大模型去的。 但华为这次最狠的,不是卡的数量,而是连接的方式。 过去大规模集群用光模块互联,800G光模块一插一大排。华为这次拿出的NPO(近封装光学)技术,一枚光引擎模块就能顶9个800G光模块,整个超节点用5500个光引擎,替代了48000个800G光模块。 什么概念?翻译一下,以前要四万八千条数据通道干活,现在五千五百条就干完了,还省下550多千瓦的功耗。 为什么这么较劲互联?汪涛的解释是,大规模算力集群最大的痛点,不是算力不够,是算力利用率太低,行业里十万卡集群的MFU(模型算力利用率)普遍不到30%。也就是说,你买了一万张卡,七千张的算力浪费在故障修复和等待上。 MFU每提升1个百分点,10万亿参数的大模型训练,周期就能缩短3天。 华为的路线很清晰:把单节点的密度和利用率做到极致,然后一年一代往前走。960DT明年一季度准备就绪,960PR明年三季度落地,2028年昇腾970,2029年昇腾980,节奏安排得满满的。 9月22日,杭州云栖大会,阿里平头哥发布了新一代训推一体AI芯片真武V900。 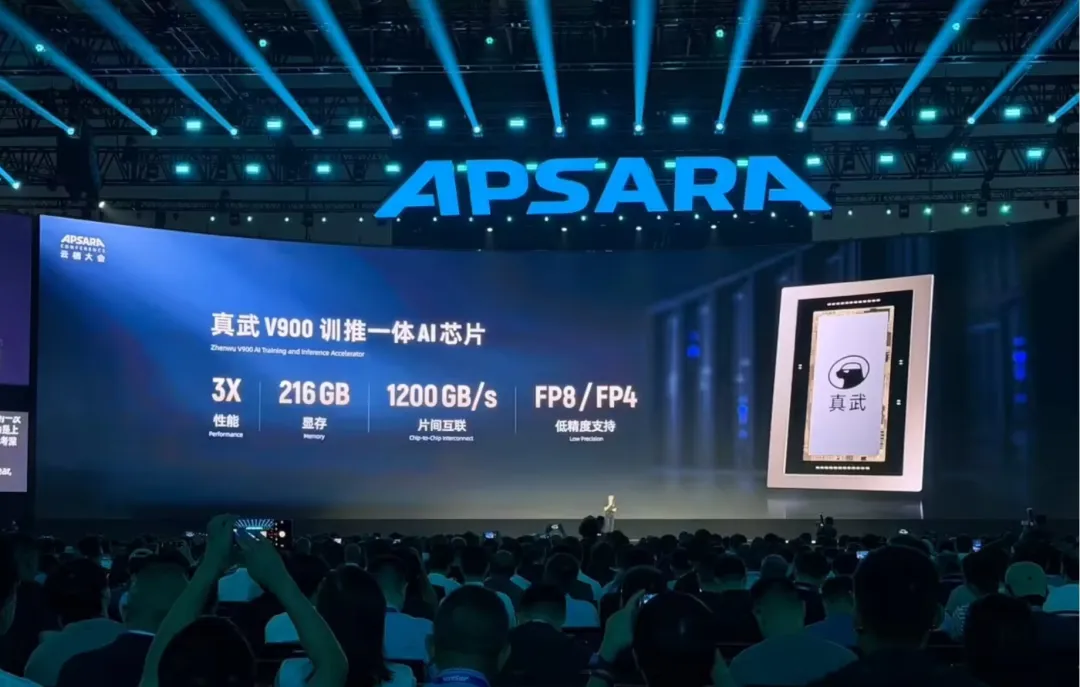
单卡层面,V900算力是上一代M890的3倍,216GB大显存,片间互联带宽1200GB/s,支持FP8和FP4低精度计算。 但阿里的杀手锏也不是单卡,而是“巨集群”。 真武V900搭配自研的ICN Switch互联芯片,可以实现千卡全带宽互联、统一内存编址,即让上千颗V900像一颗“超级芯片”一样协同工作。而基于V900构建的AI集群,官方说法是:单一集群最多可以扩展到50万卡。 50万卡是什么概念?目前国内落地的国产算力集群,行业普遍估算刚刚迈过十万卡级别。50万,就是当前落地量级的五倍。 而且阿里不是只造一颗芯片。V900、ICN Switch交换芯片、倚天CPU、磐脉网卡、镇岳SSD主控,涵盖算力、存储、网络的五大核心芯片全部自研,等于把整座数据中心的“心脏”和“神经”都攥在自己手里。 这套东西已经跑过真实大模型了:上一代M890的超节点,跑通了阿里的Qwen3.8和月之暗面的Kimi K3,都是超过2万亿参数的大家伙。平头哥官方还说,它家的芯片已经服务了超过650家企业客户。 华为和阿里,几乎是同一时间,给了国产算力两个完全不同的答案,详细的比较见下图: 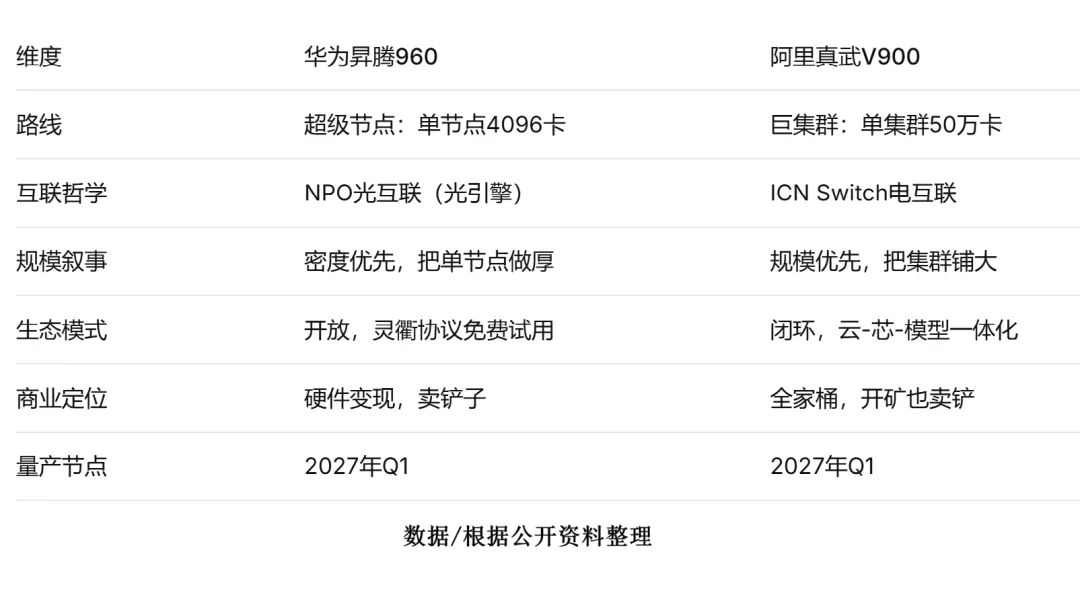
表格中专业术语比较多,不过可以概括为一句话:华为想造一台最强的“超级计算机”,阿里则打算建一座最大的“算力超级工厂”。 这两条路的分叉,将直接影响产业链。 华为走光互联,5500个光引擎替代4.8万个光模块,注意,这不是“光模块要完蛋”这么简单,而是价值从“模块”向“光引擎”转移。单模块的价值量随之大幅上移,这对做光引擎、CPO、硅光的公司来说,是结构性变化。 阿里电互联(ICN Switch交换芯片)为核心,重心在交换芯片、存储主控这些“电”的方向,利好的是另一个链条。 两条路如何不同,背后都藏着一个共同的判断:单卡跑分时代结束了。 以前国产芯片总被吐槽“单卡打不过英伟达”。但训练大模型从来不是靠一颗芯片,而是靠几万颗芯片协同干活。能把它们连起来不散架、不掉速、利用率拉满,才是真本事。华为死磕MFU、阿里做统一内存编址,都是在解决同一个问题。 英伟达自己也在做同一件事,它的机柜级方案NVL72,就是把72颗GPU用高速互联连成一台机器(加上36颗CPU),然后整柜交付。你看,单卡再强,最后还是要拼系统。 现在回到标题的问题:谁才是答案? 从架构看,华为离英伟达更近。NVL72的本质就是一个“超级节点”,华为的昇腾960超节点走的正是同一套哲学,把卡连成一台计算机,硬件变现,一年一代。两者的差别,只是国产替代了英伟达的互联和生态。 而阿里更像谷歌。谷歌的TPU不对外卖,只服务自家的云和模型;阿里同样把V900装进自家的云,绑定通义模型生态。阿里离“卖芯片的英伟达”远一些,但离“算力巨头”更近,它的护城河不是单颗芯片,是50万卡的云。 所以结论是:单卡跑分时代已经过去,系统为王,这个趋势下,华为选了密度,阿里选了规模,路线不同,但都指向同一个方向,把国产算力从“拼单卡”拉到“拼系统”的牌桌上。 先把丑话说在前面。 首先,这两款芯片都还没量产。纸面参数不等于真实性能,2027年一季度之前,还有流片验证、客户测试、产能爬坡三道坎,简单说需要让子弹飞一会儿。 其次,出口管制政策几乎每月一变。美国那边2026年以来已经出了好几轮新规,这个故事随时可能被政策打断。 丑话说完了,说正事。 如果算力需求的基本面不变(Kimi K3参数2.8万亿、Qwen3.8达2.4万亿,中国每天推理的Token已经涨到500万亿的量级)那国产算力这条产业链,故事才刚刚开始。 因此两个方向值得留意: 一是华为链,包括光引擎、CPO、超节点服务器、液冷电源。华为这套NPO方案省下550千瓦功耗,散热和供电的增量需求是实打实的。 二是阿里链,包括交换芯片、存储主控、云厂商资本开支。阿里把五大核心芯片都自研了,配套的国产供应链会跟着受益。 最后,问一句:你支持“密度派”还是“规模派”? ——END——
01
华为最狠的不是卡的数量
02
阿里的杀手锏
03
两条路,谁才是答案?