ARTICLE · 1081941
用AI从零开始FPGA设计
用AI从零开始FPGA设计
这个项目最初遇到一个射频接收问题。 宽带信号进入射频收发机后,I、Q两路很难始终保持理想的一致性。由此产生的镜像干扰还会随频率变化,同一组简单调整很难照顾整个带宽。我们把这类问题称为频率相关镜像,也就是 frequency-dependent image。 WBQEC可以先理解成一套宽带IQ镜像校准方案。经过前期方案比较,我最后选定8-tap复数滤波器做补偿。这里先不展开算法,只需要知道它的用途。滤波器持续修正接收数据,尽量让不同频率位置的镜像都降下来。 项目里的ideal也由此而来。它来自产品对接收效果的要求,是判断补偿有没有用的参照。 模型在电脑里跑通以后,事情只完成了一部分。它还要跟得上真实数据,能放进现有工程,占用的资源能够接受,最后还得在板上看到改善。于是,我决定用这个项目完整走一遍FPGA开发流程。AI参与了代码、脚本和工具执行,我负责确定问题、选择路线,并审查每一步能得出什么结论。 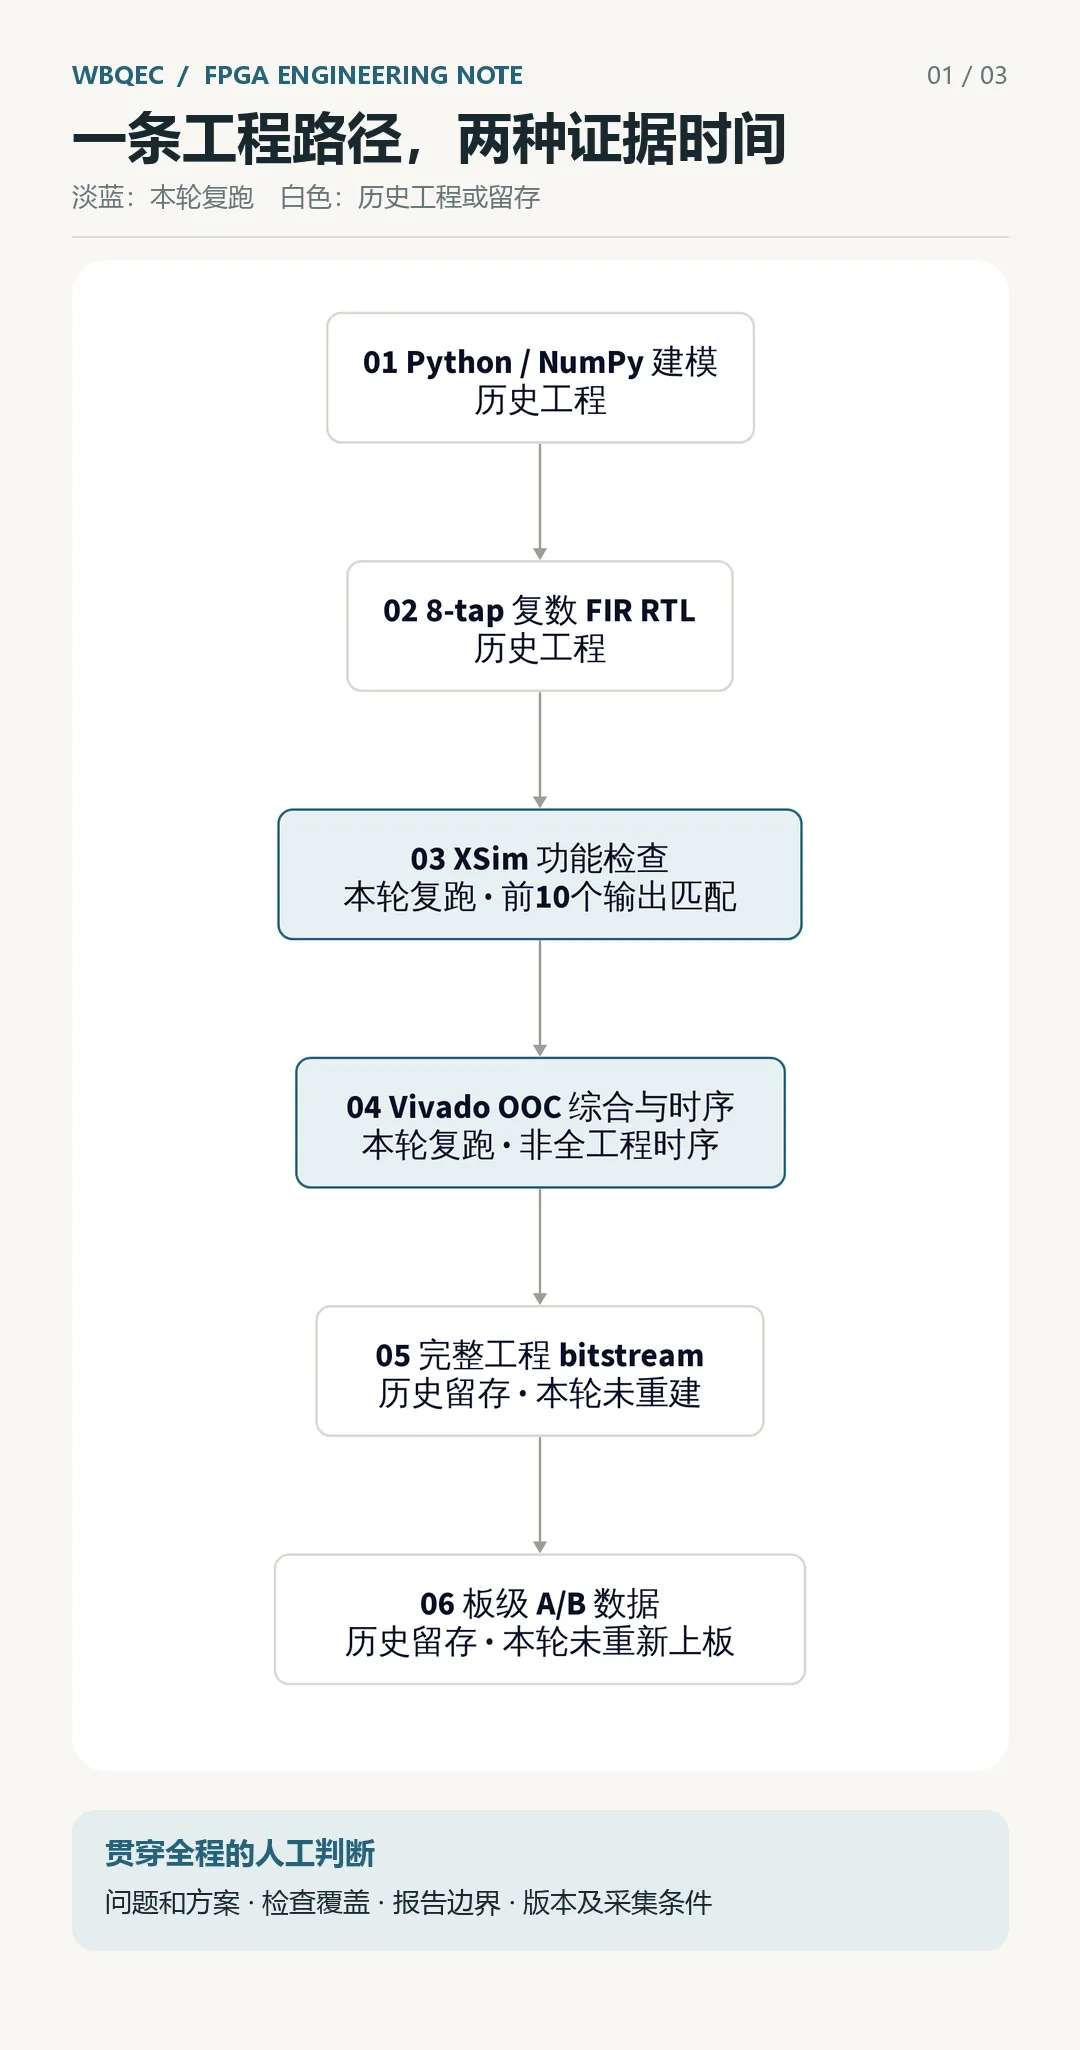
图1:WBQEC FPGA工程路径;淡蓝为本轮复跑,白色为历史工程或留存,人工判断贯穿各环节 我先把问题边界和测试数据交给AI,让它用Python和NumPy整理输入、运行模型,并检查补偿前后的效果。这个阶段在WSL终端调用数据分析脚本。对外只展示调用形式,不公开工程内的脚本名。 python3 <数据分析脚本>.py AI先调用脚本,遇到报错就回到数据格式和文件路径继续查,跑完以后再把补偿前后的数据和图整理出来。我没有只看脚本是否正常结束,还核对了输入数据来源、前后对照的测试条件,以及结果能支持怎样的结论。 这一步让我确认复数滤波器值得继续做,也确定了后续FPGA需要实现的功能。第一阶段先验证补偿功能。这样安排可以先回答一个最直接的问题,滤波器放到硬件里以后到底有没有用。 第一次上板如果把后续功能也一起带进去,任何一处出错都很难定位。我决定先做补偿器,其余功能留到下一阶段独立验证。 方向定下以后,AI根据现有工程接口协助生成和修改Verilog RTL,同时准备testbench和测试向量。当前模块是一只8-tap复数FIR,工作在61.44 MSPS,每个时钟接收一个IQ样本,输出延迟为2个时钟周期。补偿功能可以切换,方便后面做补偿前后的对比。 代码出来后,我重点看数据位宽和时钟有没有沿用原工程约定,滤波器接入的位置对不对,原有接收、SPI和调试路径有没有被无意改动。AI可以很快写出一版RTL,接入位置和系统边界仍要由熟悉项目的人确认。 为了不影响原来的共享工程,我还要求把改动放进独立的Vivado工程副本。后面的综合、bitstream和调试文件都从这份副本产生,出问题时也能退回原工程。 RTL写完以后,AI先用Icarus Verilog做快速回归,再调用Vivado 2019.1自带的XSim复跑同一份设计。XSim的三个步骤分别是编译、展开和运行。 xvlog --sv fir_comp.v fir_tb.v xelab fir_tb -s fir_tb_sim xsim fir_tb_sim -runall 日志给出的结果很好看。10个受检查输出全部匹配,0个不匹配,最后还有一个醒目的PASS。 我让AI继续检查testbench本身,没有直接引用这个PASS。随后发现,仿真虽然送入了1000个样本,也准备了993个有效输出的期望值,现有断言实际只统计了前10个输出。 所以这一步的准确结论只有一句话,当前受检查的10个输出全部匹配。它还不能证明993个有效输出已经逐点一致。工具完成了仿真,AI找到了日志和检查范围,我据此把结论限定在证据覆盖的位置。下一步仍需补齐全量checker。 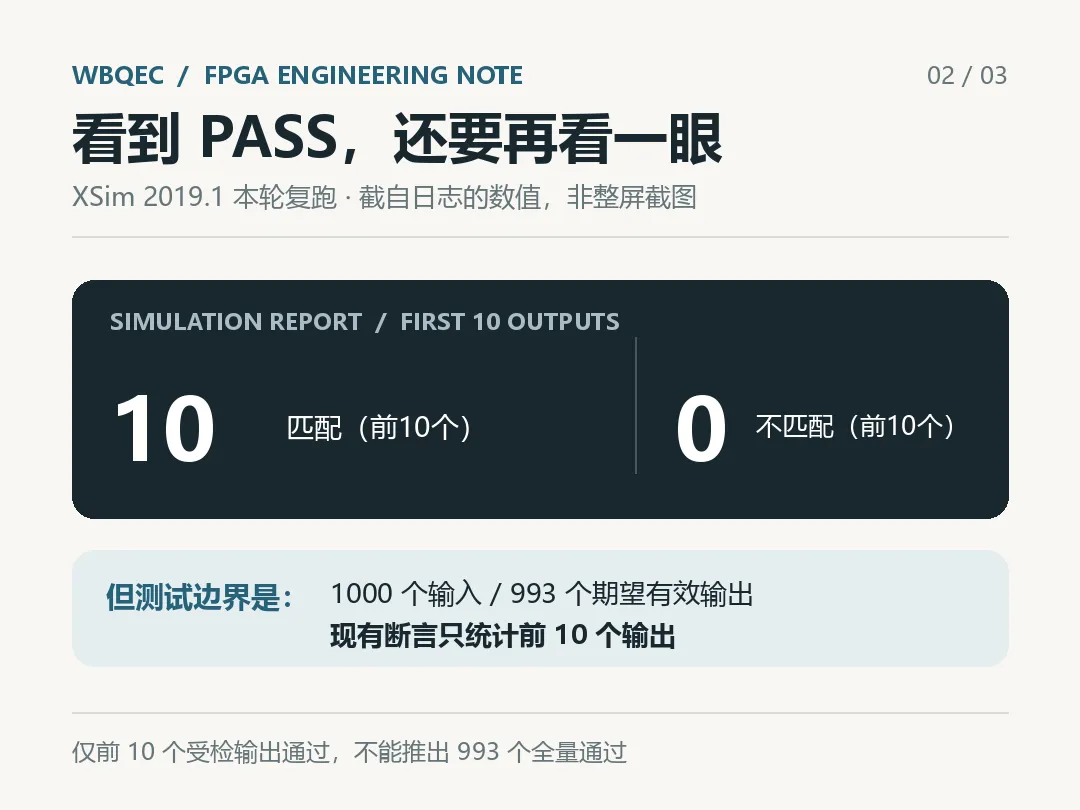
图2:XSim本轮复跑的前10个受检查输出全部匹配;现有PASS并不代表993个有效输出全量通过 仿真没有暴露功能错误后,我确认了目标器件和61.44 MHz时钟,让AI建立一个独立的模块级OOC工程。OOC可以先单独综合滤波器,较快得到资源和时序数据,不必每次都重跑整个接收工程。 Python脚本运行在WSL中,Vivado 2019.1安装在Windows侧。AI通过Windows命令入口启动Vivado批处理,再由Tcl脚本调用综合和报告命令。下面只展示脱敏后的调用形式,具体安装位置和脚本名由使用者填写。 /c "\vivado.bat -mode batch -source <模块综合脚本>.tcl" Tcl脚本内部会启动 synth_1,等待综合结束,再输出资源报告和时序摘要。 这次重新综合的结果是339个LUT、234个触发器和32个DSP48,没有使用BRAM。约束时钟为61.44 MHz,对应周期16.276 ns。Setup WNS为+12.163 ns,TNS为0。 如果只摘这两个数,很容易写出“时序通过”。同一份报告还给出了−0.058 ns的Hold WHS、−8.806 ns的Hold THS,共有161个Hold端点未通过。报告同时提示70个输入端口和33个输出端口没有设置I/O delay,而且这仍是综合后的模块级结果,没有经过完整布局布线。 我没有把它签成板级时序收敛。AI擅长把Vivado跑起来,也能从几百行报告里抓出关键数字。数字意味着什么、证据能支撑多大的结论,仍要结合工程状态判断。 模块确认后,才回到完整Vivado工程。这里要跑综合、布局布线和bitstream生成,处理时间比模块级检查长得多。AI使用Tcl脚本调用 synth_1 和 impl_1,一直执行到 write_bitstream,随后检查运行状态以及 .bit、.ltx 文件是否生成。下面是脱敏后的调用形式,不是本次重新执行完整工程的记录。 vivado -mode batch -source <完整工程构建脚本>.tcl 我在启动前确认使用的是独立工程副本,并核对目标器件、顶层和约束版本。脚本完成后会把bitstream和调试探针文件复制到独立目录,同时写下时间戳和来源工程。这样下一次上板时,不会误拿旧工程根目录里那份不含FIR的bitstream。 这一段需要说明时间边界。项目此前确实生成并保存了FIR对应的bitstream和LTX,也用它们做过板级验证。写这篇文章时,我让AI重新跑了XSim和模块级OOC综合,没有重新执行完整工程的bitstream构建。历史产物可以说明这条流程曾经走通,不能冒充本次新生成的文件。 上板阶段使用Vivado Hardware Manager。下载前,我先确认板卡、JTAG目标和bitstream版本。AI准备的Tcl脚本会连接硬件服务器、核对目标、下载bitstream,再把对应的LTX绑定到调试核。这里只列出脱敏后的调用形式,不公开工程脚本名。 vivado -mode batch -source <硬件操作脚本>.tcl 随后用ILA分别采集原始状态和补偿状态的数据,再由脚本计算镜像抑制结果。AI很适合做这些重复动作,整理采集文件、计算统计值。板卡是否连接正确、采集条件是否一致、这组结果能否代表产品性能,仍由我逐项核对。 历史A/B数据覆盖20个离散IF频点,分别是正负2 MHz、正负4 MHz,直到正负20 MHz,不含0 MHz。原始状态的平均IRR为33.8225 dB,开启补偿后达到65.286 dB,平均提高约31.46 dB。补偿后的最低值为55.68 dB,20个点全部高于50 dB,其中18个点高于60 dB。 这些数据回答了我最开始的问题。在当时的测试条件下,复数滤波器进入FPGA以后确实改善了频率相关镜像。它们只覆盖20个离散频点,不能替代连续频段、不同温度电压、不同芯片批次和最终产品签核。本次写作也没有重新连接JTAG或采集新的IQ数据,文中的板测结果来自项目留存记录。 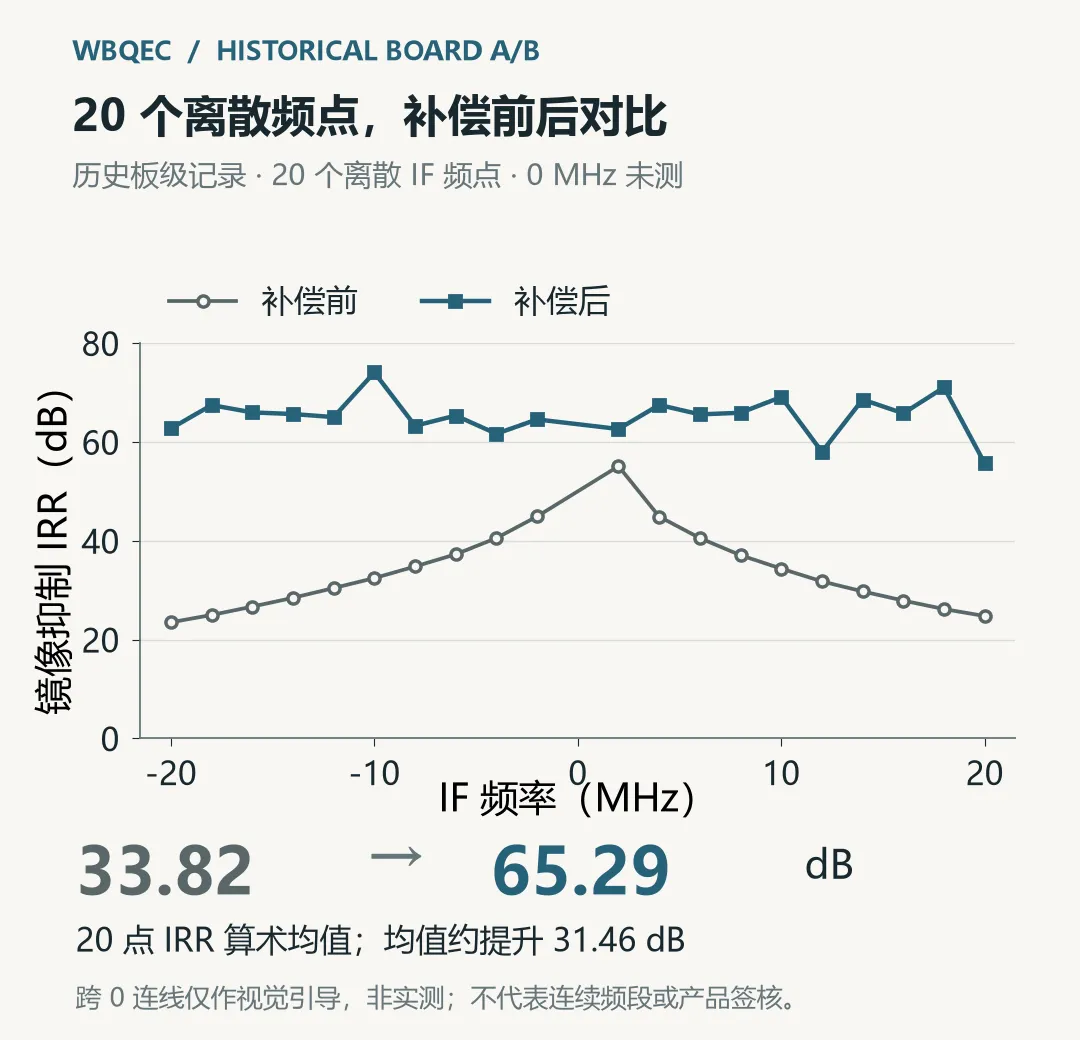
图3:历史板级A/B的20个离散IF频点;0 MHz未测,相邻实测点以直线连接,仅辅助阅读;IRR均值约由33.82 dB提升至65.29 dB,非连续频段或产品签核 回头看这次开发,AI最有用的地方很具体。它能在Python、Verilog、XSim、Vivado Tcl、Hardware Manager和数据分析脚本之间连续工作,代码出错就读日志,工具跑完就整理报告。原本要反复手动完成的操作,被压缩成了可以复现的脚本。 我的工作集中在另一端。我决定先解决频率相关镜像,选择复数滤波器,先验证补偿功能;我也要检查测试覆盖、工程版本、约束条件和硬件数据,决定什么时候可以往下走。 一个PASS不会自动变成验证完成,一个正的WNS也不会自动变成板级时序收敛。AI能把工具跑得很快,工程结论仍然要有人负责。 目前完成的是WBQEC复数滤波器补偿的第一阶段,后续功能还没有完成板级闭环。下一步要补齐993个有效输出的逐点检查,再为后续功能建立独立的板级验证证据。
【一次AI辅助的FPGA工程实录】
【先让模型回答值不值得做】
【我先把目标缩小了一半】
【第一次看到PASS,我没有停】
【让Vivado给出资源和时序】
【从完整工程产生bitstream】
【最后还要看板上结果】