ARTICLE · 1093196
文档驱动开发-信息智能萃取-让工具变聪明:认出谁在说、显卡加速、直接问知识库
前三篇我们说了内容怎么进来、怎么存住。这篇说一下:存进来之后,怎么让工具变得更聪明——而且聪明的每一步,都不越过"数据不出本机"这条线。
一、项目需求
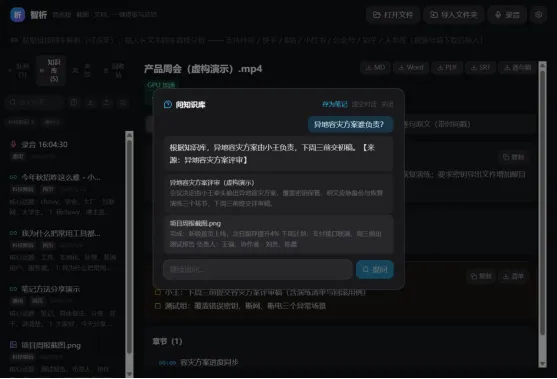
到这个阶段,发现三个痛点。一是长会议录音转出来一大片文字,分不清谁说了什么,整理纪要还得自己对人。二是纯 CPU 转写虽然够用,但一小时的录音还是要等上一阵子,我电脑里那块 NVIDIA 显卡一直闲着。三是库里东西多了之后,"搜索"开始不够用了——我常常不是想找某条笔记,而是想问一个问题,比如"上次那个方案到底是谁负责"。
这一版实现的痛点功能:
1、说话人分离+声纹识别:转写自动区分"发言人 1、发言人 2",你告诉它一次"这是老王",以后新录音它自己就认出来了2、GPU 加速:检测到 NVIDIA 显卡自动启用,长音频出稿速度快好几倍;没有显卡就老老实实走 CPU,功能一个不少3、问知识库:直接用大白话提问,支持多轮追问,回答会标出来源条目,点一下就能跳到原文位置4、大模型按需接入:想更聪明可以接自己的大模型 API,默认关闭,不接也能用本地检索问答
二、项目功能
演示内容全部是我自制的虚构素材,不涉及任何真实会议和真实人物。
演示 1 ·一段三人会议录音,自动分清谁在说
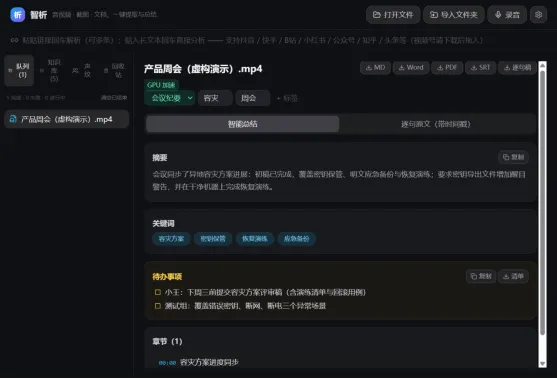
• 输入:一段我用合成语音拼的 40 秒虚构会议录音,三个人轮流说话。• 工具的操作:转写完成后自动按说话人分段;我把"发言人 1"改成"小王",工具提示"已记住小王的声纹"。• 输出:下一段录音里小王再开口,名字直接自动标好。智能摘要和待办里写的也是真名,不会出现"发言人 2 负责跟进"这种没法用的句子。
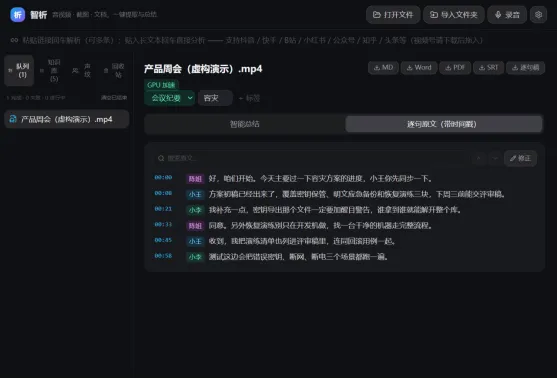
逐句原文里,每段话前面标着说话人真名和时间戳;左上角"GPU 加速"标识表示这条走的是显卡通道。
演示 2 · 直接问知识库一个问题
三、功能背后的思考(重点)
这三个功能,同样各有一个逻辑值得讲讲。
功能一:声纹识别,让它"先问过我,再记住"
全自动的声纹聚类技术上能做,但误判一次就会污染库:把张三的声音记成李四,后面越认越错。所以我加了一步"人工确认":工具只负责分段,名字由我确认过一次,声纹才入库。
思维沉淀:自动化的边界应该划在"错得起"的地方。错不起的那一步,留给人。
功能二:GPU 加速,永远留一条 CPU 退路
显卡加速这东西很挑环境:驱动版本、显存大小、模型兼容性,任何一个不对就崩。所以我的设计是"检测到合适的显卡就加速,检测不到就安安静静走 CPU",为此转写引擎做了双通道,启动时自动选路,GPU 通道半路出问题也会自动降级,而不是直接罢工。
思维沉淀:加速只是提供选择,不是没它就不能运行。
功能三:大模型默认关闭
接大模型能让问答更聪明,但它意味着内容要离开本机。这个项目的第一原则是数据不出本机,所以我把大模型做成了"可选插件":默认关闭,用本地检索照样能问答;你想接,就自己填自己的 API 地址和密钥,配置只存在你电脑上。智能程度你说了算,隐私底线工具说了算。
思维沉淀:凡是和隐私原则冲突的功能,都应该是可选开关,而不是默认。