ARTICLE · 1093432
国象里的 AI丨Stockfish 鳕鱼引擎是怎么给局面打分的?
国象里的 AI丨Stockfish 鳕鱼引擎是怎么给局面打分的?昨天,2026 年第 46 届世界国际象棋奥林匹克团体赛刚结束。相信不少棋童家长和我一样,用 lichess 看直播给中国队加油,顺便靠棋局旁边的引擎评分判断谁局面占优。看直播时,谁领先了多少分,也成了我们这些“伪棋迷”闲聊的话题。 大部分平台像 lichess 一样,用的都是国际象棋领域最强大的引擎之一 Stockfish,简称 SF,国内也叫鳕鱼。 
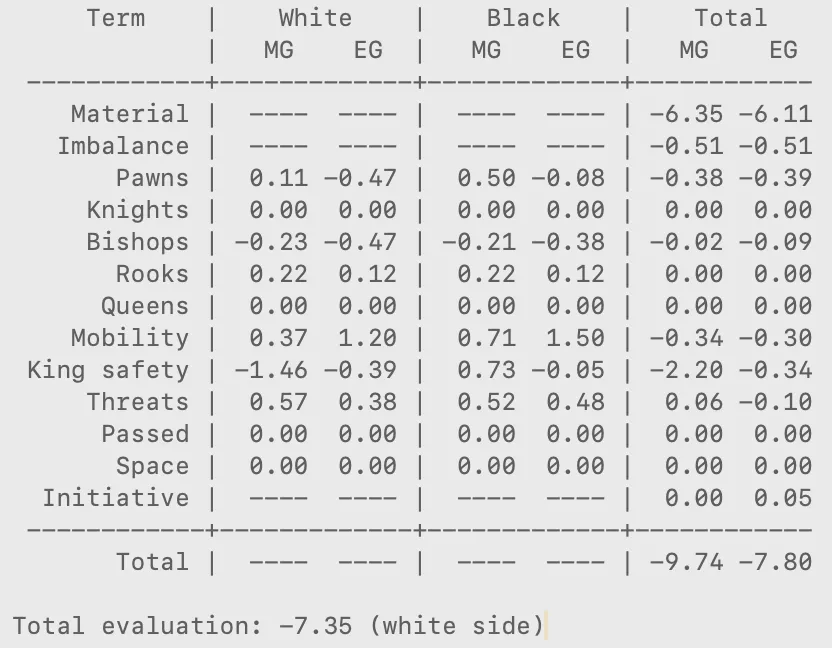
SF 的最新版本是 SF 19,从版本 12 开始引入神经网络 NNUE,版本 11 是最后一个“手搓”版本。虽然 SF 11 的计算准确度比 SF 19 低一些,但它的评估依据是分项设计的(也叫经典手工评估,HCE),反而更适合我们弄明白:AI 到底在看局面的哪些方面?理解了这些,对棋手自己快速判断局面也会有所帮助。 所以,我把 SF 11 的评估逻辑整理出来,供大家参考。 可以把 SF 11 想象成一个特别有经验的教练。他看一盘棋,不是只数谁多几个子,而是同时从 13 个角度打分: 就是基础子力价值。谁多子、谁少子,这是我们陪赛时最常说的,也最直观。只不过,这里的子力价值并不是简单数子——引擎里每个棋子都有固定的基础分值,而且中局和残局的分值还不一样。比如兵在残局会“升值”,因为离升变更近了。 这一项看的是棋子搭配。比如双象对双马,谁更划算?有些局面马象组合比双马好,双象优势方会加分。也就是说棋子数量相同,组合不同,评分也不同。 兵形是健康的还是脆弱的?通路兵、连通兵加分;叠兵、孤兵、落后兵、兵岛(己方的兵被对方的兵隔开,分成了几块互不相连的“岛屿”)扣分。还要考虑悬兵、兵链、受保护通路兵、外侧通路兵等进行微调。 马在中心(e5、d5、e4、d4)通常比边线强。如果马站在一个己方兵保护、对方兵又打不到的格子上,那就是“前哨马”,价值极高。被己方兵挡住、活动受限的是“坏马”,在 a/h 线的“边线马”通常也较差。 核心是双象优势和“好象/坏象”。双象覆盖两种颜色,通常加分。如果己方兵链主要压在象同色的格子上,象被自己的兵挡住,就是“坏象”;兵链在异色格,象就活跃,是“好象”。象在开放斜线上也更值钱。 车需要开放线才能发挥威力。在没有任何兵的直线上加分;在只有对方兵的半开放线上也加分。白方车冲到 7 线(对黑方而言是 2 线),能攻击对方兵和王,通常加分。两个车互相保护、在同一条线或相邻线上配合,也加分。 后是最强棋子,但也最容易被骚扰。后可移动的安全格子越多越值钱;和其他棋子协同进攻加分;如果暴露在对方攻击下,可能被追打而失去节奏,扣分。开局阶段后过早出动,容易被对方马象攻击,通常不利。 这一项是“活动空间”的量化。引擎会数每个棋子能安全移动到的格子数,然后按棋子类型查表加分。车在开放线上可移动格子多,加分高;象在长斜线上活动,加分;马在中心可移动格子多,加分。 这是最复杂的项之一。王前面的兵盾完不完整?对方有多少棋子参与攻击王周围区域?每种棋子权重不同。王周围有多少格子被对方控制?王在中心且线路开放时非常危险。这一项在中局极其重要,残局则相对次要。 当前有没有迫在眉睫的战术危险?如果一个棋子被攻击且没有保护,相当于可能被白吃,扣分。如果有保护,但攻击者价值更低(比如用马攻击后),交换对攻击方有利,被攻击方扣分。牵制、叉子等战术威胁也会被考虑。 通路兵越靠近升变格,威胁越大,加分越高。两个或多个通路兵在同一区域互相支持,威力倍增,额外加分。如果前方被对方棋子挡住,价值降低;如果被己方子力保护,加分。 空间就是己方棋子可以自由活动的区域大小。通常看中心区域(比如c3-f6 的 4x4 区域)内,己方控制、又不被对方兵攻击的格子数。己方兵后方的格子可能加倍计算,因为那是安全的后方活动空间。空间大的一方调动余地多,但空间过大也可能兵形薄弱。 这一项主要出现在残局,看王能不能主动参与进攻或限制对方王。如果己方王能靠近对方王,限制其活动,甚至“包抄”到对方王背后,加分;对方王更主动,己方扣分。这一项和通路兵、空间配合,决定残局是能赢还是只能和。 SF 11 不会把这 13 项分数直接一加就完事。它更像一个分阶段、有权重的精密计算系统: 第一,中局和残局分开算。 同一个概念,在中局和残局价值完全不同。比如马在开局和中局通常比象有力,但残局棋盘开放后,象的价值可能反超。所以引擎对同一个局面会算两套分:一套中局(MG),一套残局(EG)。 第二,平滑过渡。 引擎会根据场上剩余非兵子的数量,判断当前更接近中局还是残局,然后把 MG 和 EG 两套分数加权混合得到最终评分。 第三,权重靠海量测试。 每一个评估项的具体算法和权重,都不是拍脑袋想出来的。开发者设计后,会通过一个叫 Fishtest 的分布式测试框架,让全球志愿者贡献算力,跑数百万盘对局来验证。只有能显著提升引擎胜率的改动,才会被合并到代码里。 一起来看一个局面变化,感受下引擎的“思考方式”。 局面一:白方少子严重,还有个叠兵,王的安全也很差,总分 -7.35(为说明变化,仅做静态评估,不让引擎做深度思考),白方败势。 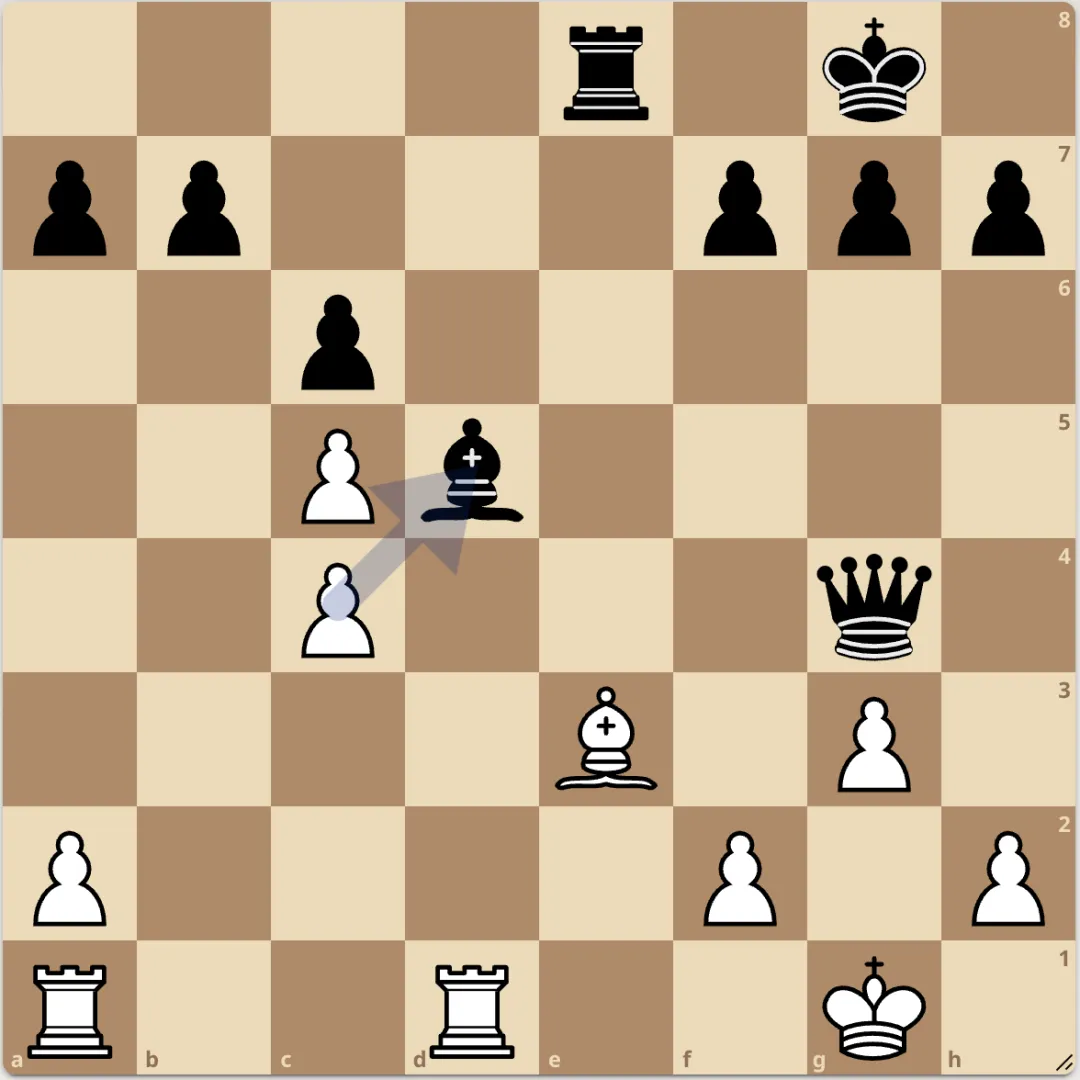
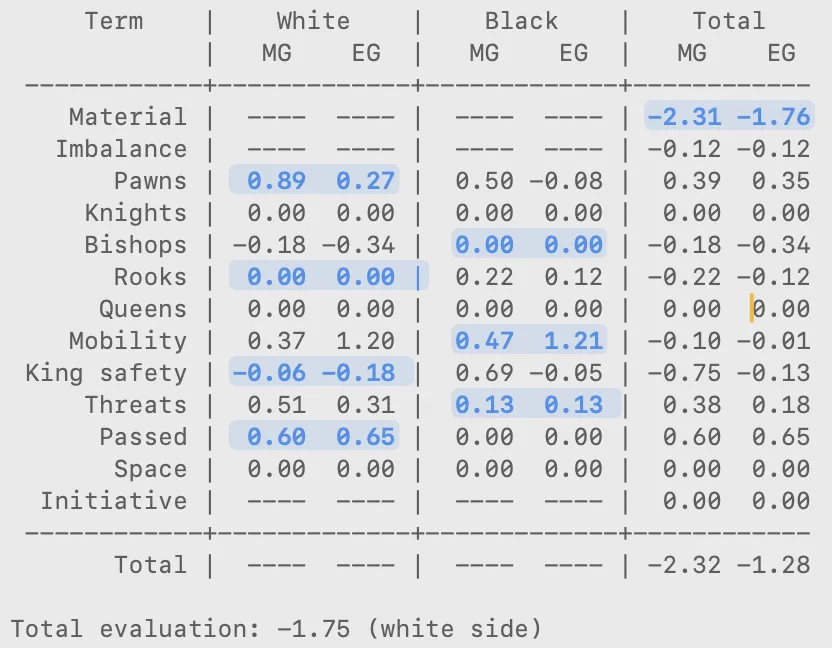
局面二:白方走了 cxd 吃象,子力差距缩小,王的安全好了些,还出现了通路兵加分,总分从 -7.35 变成 -1.75,白方有些好转。 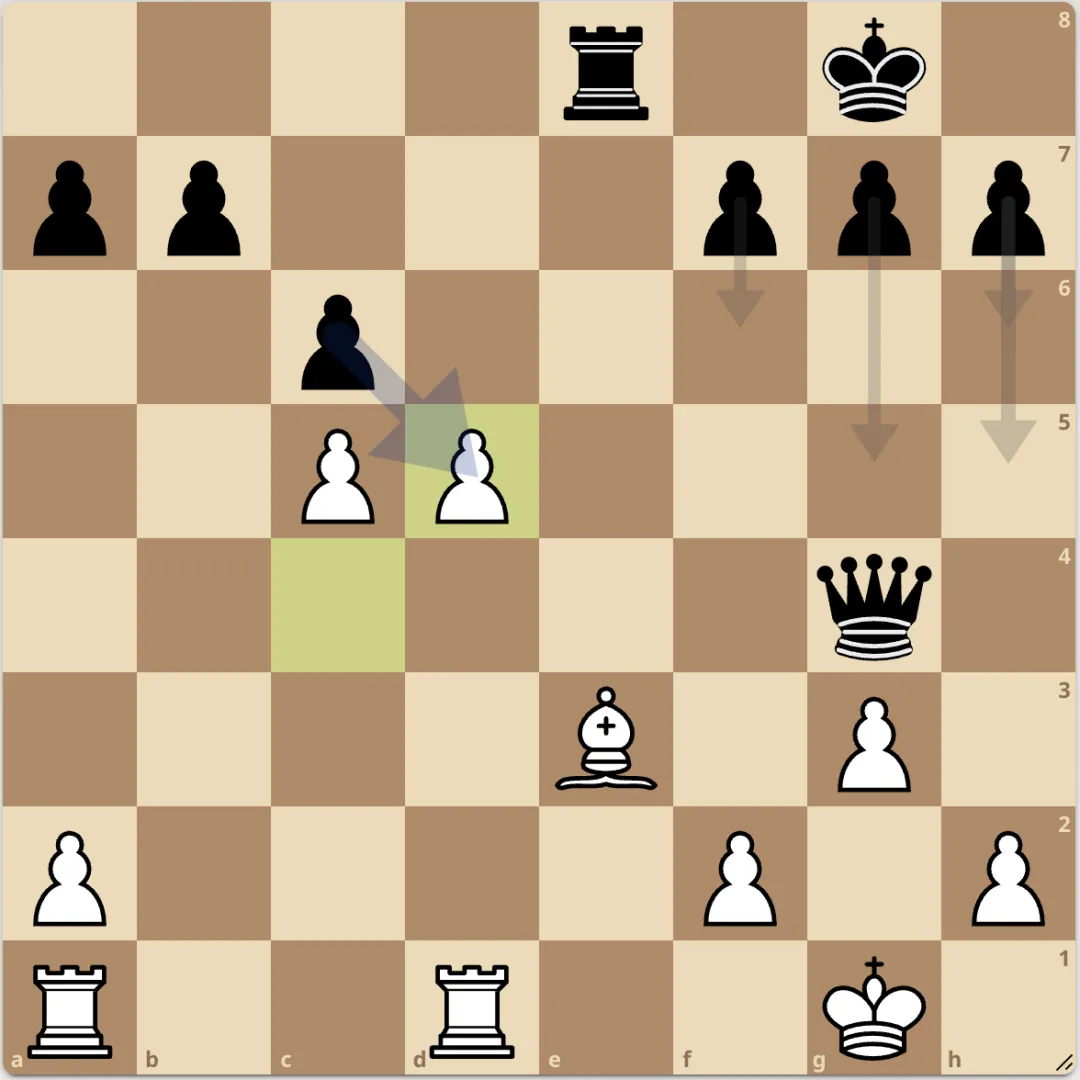
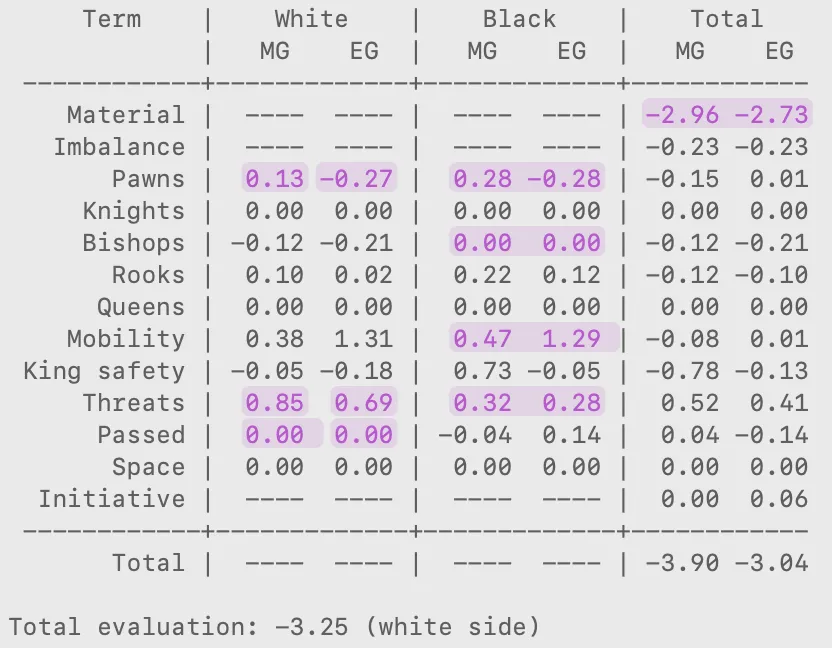
局面三:黑走 cxd,子力差距再次变大,虽然威胁项有加分,但总分回到 -3.25,白方劣势扩大。值得一提的是由于通路兵的不同阶段的威力不一样,兵形结构在中局 MG 和残局 EG 中的评估略微不同。 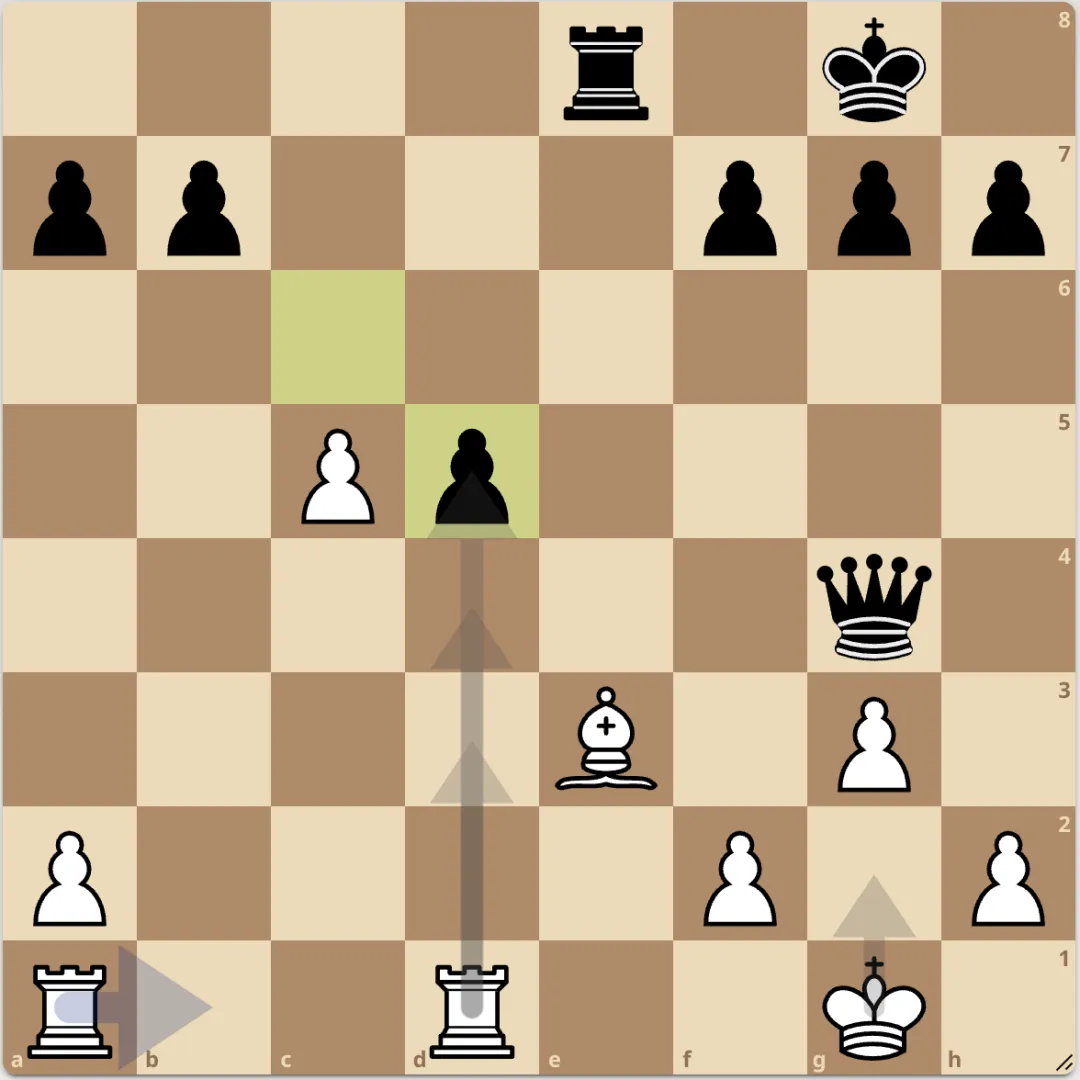
理解这些,至少有三个好处: 陪赛看评分时,知道这个分数不只是“多子少子”,还包含了兵形、王安全、棋子活跃度等。领先 1 分不一定稳赢,落后 1 分也不一定没机会。 自己下棋时,可以按这几个维度快速扫描局面:子力、兵形、王安全、棋子活跃度、有没有战术威胁。这比只数子全面得多。 看引擎分析时,可以留意 `eval` 输出里哪一项扣分最多,那往往就是局面的关键问题所在。 SF 12 开始引入 NNUE 神经网络,最新是 SF 19。NNUE 不再依赖手工设计的评估项,而是用神经网络直接输出评估值,理解起来要更复杂一些,后续我们再深入探讨。
那么这个评分到底是怎么来的呢?
一、鳕鱼看局面,主要看这 13 个方面
1. 子力 Material
2. 子力失衡 Imbalance
3. 兵形结构 Pawns
4. 马的位置 Knights
5. 象的评估 Bishops
6. 车的评估 Rooks
7. 后的评估 Queens
8. 机动性 Mobility
9. 王的安全 King Safety
10. 威胁 Threats
11. 通路兵 Passed
12. 空间 Space
13. 主动权 Initiative
二、不是简单相加,而是“分阶段混合”
三、举个栗子