ARTICLE · 1095193
多品牌GPU如何协同?软件调优与算力运营正在形成新市场
企业采购算力后最常见的第二个问题是:不同品牌、不同代际、不同规模的GPU怎样放进同一个业务体系?硬件可以分别上架,但模型、容器、调度、监控和计费不能各自为政。软件协同因此成为AI基础设施中最有持续收入潜力的一层。
一、多品牌环境为什么难?
NVIDIA以CUDA、NCCL、TensorRT-LLM和NIM形成完整生态;AMD以ROCm、HIP、通信库和开放框架推进;国产平台也拥有各自的编译器、算子库和运行时。相同模型在不同平台上的量化格式、算子支持、通信方式和性能特征不同。
真正困难的不是让程序运行,而是让它稳定、高效并可维护。某个模型从CUDA迁移到ROCm或国产平台以后,可能出现算子回退、显存碎片、通信效率下降或版本冲突。解决这些问题需要长期积累真实模型数据,而不是一次安装。
二、最值得做的六类软件产品
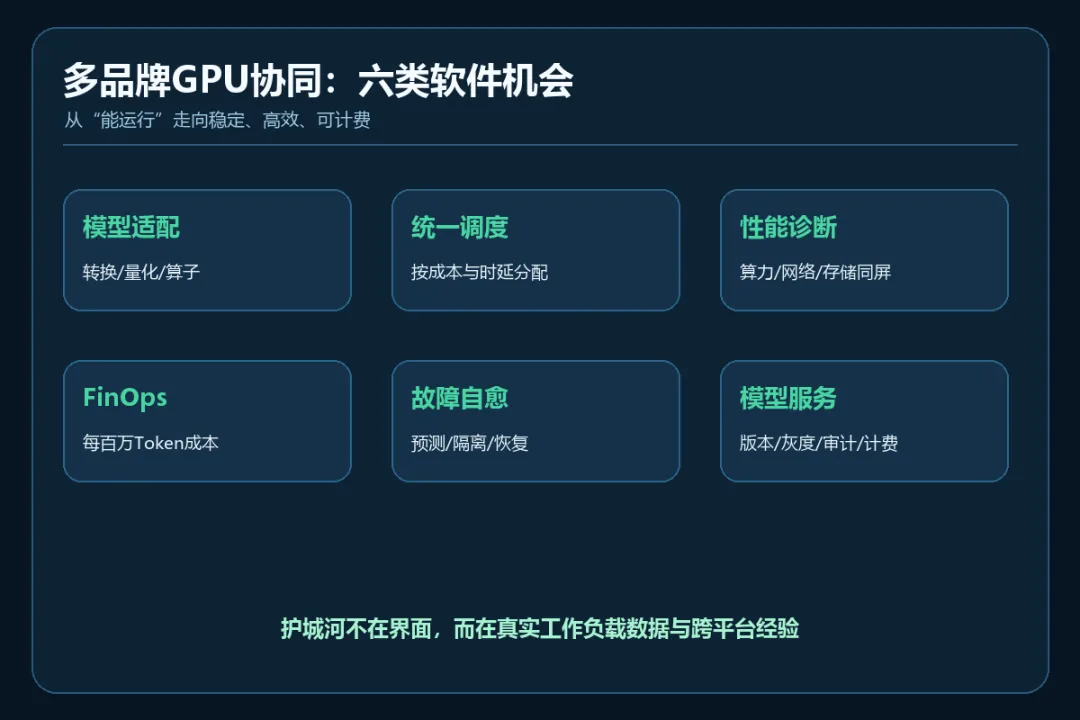
第一,跨平台模型适配,把模型转换、量化、算子替换和精度验证做成流水线。第二,统一调度,根据模型、显存、时延、成本和数据合规要求,把任务分配给最合适的集群。第三,性能诊断,把GPU利用率、网络通信、存储等待和模型阶段放在同一时间轴上。
第四,容量与成本管理,把设备折旧、电费、机房费和运维费换算成每百万Token成本。第五,故障自愈,根据ECC错误、链路重传、温度和作业日志自动隔离问题节点。第六,模型服务平台,为客户提供版本管理、灰度发布、限流、审计和计费。
三、商业模式应该从项目费转向结果费
传统系统集成按人天收费,项目结束后收入停止。算力运营软件更适合三种模式:按管理GPU数量收费;按Token或作业量抽取平台费;按节省的电费、提升的利用率或缩短的任务时间分享收益。
例如,客户原有GPU平均利用率只有35%,通过排队、切分、弹性推理和闲时训练提升到55%,新增的有效产能不需要再次采购GPU。对客户而言,这比买一批新设备更容易计算回报;对服务商而言,也能形成持续合同。
四、创业团队从哪里切入?
不要一开始就做“万能算力平台”。应选择一个高痛点入口,例如跨品牌推理、训练故障诊断、模型迁移、成本计量或私有化模型服务。先在一个行业形成数据和案例,再向上下游扩展。
竞争壁垒主要来自四类资产:经过真实工作负载验证的配置库;跨品牌算子与性能数据;客户运行日志形成的诊断规则;能够连接机房、服务器、容器和模型的完整可观测性。界面容易复制,真实运行数据和工程经验不容易复制。
结论:硬件价格会波动,软件版本会更新,但企业始终需要把算力变成稳定业务结果。多品牌GPU越普及,跨平台适配、调度、监控和成本优化的市场越大。
官方资料来源:NVIDIA软件与多节点调优文档;AMD ROCm与Instinct基础设施文档;HPE Private Cloud AI官方资料。
本文由数茵智能科技根据公开官方资料原创整理并核验。