ARTICLE · 1096663
扫描件送货单怎么转 Excel?9 月实测 72 张 12 分钟,数据不用出电脑
扫描件送货单怎么转 Excel?9 月实测 72 张 12 分钟,数据不用出电脑
先说一个网上教程不会告诉你的事:大部分"拍照转 Excel"的脚本,输出的是"每行一段文字",不是表格。
我看了 9 月 24 日那篇被转得很多的实测文章(来源:今日头条 2026-09-24,作者橘味猫),它的核心代码最后写出来的是两列:图片文件名、识别内容。号称"一键转 Excel",实际是把图片里的文字按行堆进一个表里,行列结构并没有还原——你还得自己再拆一遍。
这不是说那个方案没用。它的实测数据是真实的:72 张扫描验收单,人工预估 8 小时,脚本 12 分钟跑完,只有少量模糊单元格需要简单校对。问题在于,你得知道它到底替你干了什么、没干什么。
一、四条路线摆开看
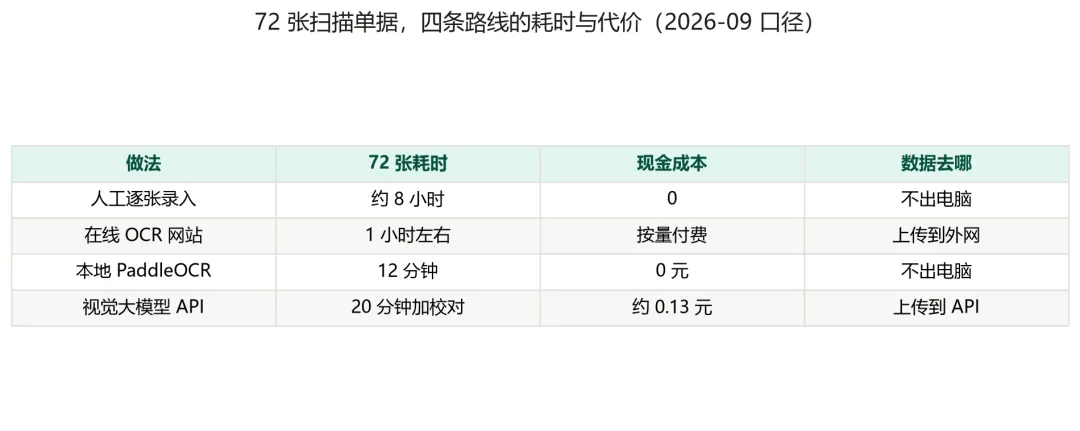
(人工耗时来自来源的预估;本地 OCR 的 12 分钟来自来源实测;API 成本按下面的口径算)
这四条里,第二条和第四条都有同一个问题:财务、审计单据一旦上传外网,就不是技术问题了。所以真正可选的是第一条和第三条的组合。
二、成本其实不是问题
很多人以为"用大模型识别图片很贵",算一遍就知道不是。
DeepSeek 官方文档(2026-09-29 版)写得很清楚:图片按尺寸折算成 token,进入模型前会先缩放,单张图片的 token 消耗有上限,是 1024 个。2000×2000 和 5000×5000 的图,缩放后消耗的 token 数一样。它还提供一个 detail 参数,选 low 会把图缩到 512×512,更省 token。
按这个上限算:72 张 × 1024 = 7.37 万输入 token。加上每张约 200 个输出 token,合计 8.8 万 token。按 flash 模型空闲时段价(缓存未命中 1 元、输出 4 元每百万),一共 0.13 元,高峰时段翻倍也就 0.26 元。
一张不到 0.002 元。
所以这笔账的真正成本不是钱,是你第一次把流程跑通的那半天。这一点得说清楚,否则很容易被"AI 很便宜"骗进去,结果发现光调格式就花了两天。
三、三步走,别把活全交给模型
正确的分工是这样的:
第三步里最值钱的是"标异常"。模型不负责把表格排对,它负责告诉你哪几行需要人看一眼——这一步把 8 小时的活压到"看 20 分钟"。
四、验收只留两条硬指标
复杂的校验规则没必要做,两条就够:
第二条为什么重要?因为来源实测里说的"少量模糊单元格",最容易错的恰恰是小数点。一个数字错,整张报表返工,这个风险比效率损失大得多。
五、三条红线
六、什么情况下值得搞这套
门槛量是每月扫描单据超过 50 张,或者单据格式固定(同一家供应商的送货单长得一样,可以把 OCR 存成自定义模板,准确率会明显提升)。
低于这个量,人工敲更快。一个月只有十来张单据的话,装环境、调参数、写校验脚本的时间,够你手敲半年。
【待补充·真实素材】这里放一次真实成交价截图 / 一次真实翻车经历 / 一段和卖家的真实对话。
问题留给你:如果 OCR 能识别出 95% 的文字,剩下 5% 的错误里有一个是小数点错位,你是愿意花 8 小时全人工,还是愿意花 20 分钟复核机器标出来的那几行?