ARTICLE · 1097847
AI 写的代码说不清为什么?这个开源工具给 AI 编码装了行车记录仪
用 Claude Code 干活的人多半遇到过这种场面:review 的时候看到一段改动,测试全过、功能正常,但就是看不懂为什么这么写。去问提交代码的同事,他让 AI 重跑了三轮,自己也讲不清当时是怎么谈下来的。
还有一个更常见的麻烦。AI 干着干着跑偏了,你想回到半小时前那个还正常的状态,发现会话窗口早关了,中间的讨论、试错、被否掉的方案,全都没了。
这两个麻烦指向同一件事:AI 把写代码的成本打了下来,但「代码为什么长这样」的知识,第一次开始大规模流失。Git 记录了每一次改动的结果,却从来没有地方存放改动背后的对话、取舍和约束。
这个开源项目要补的就是这一层。
Entire 是一个挂在 Git 工作流里的开源命令行工具(Go 编写,MIT 协议)。它在后台自动记录 AI 编码助手的完整会话——每条 prompt、每次回复、动过的文件、token 用量——并把每一段记录和你仓库里的 commit 绑定存档,形成可以搜索、可以溯源的历史。
类比一下:Git 是代码的「结果账本」,Entire 是 AI 写代码的「行车记录仪」。
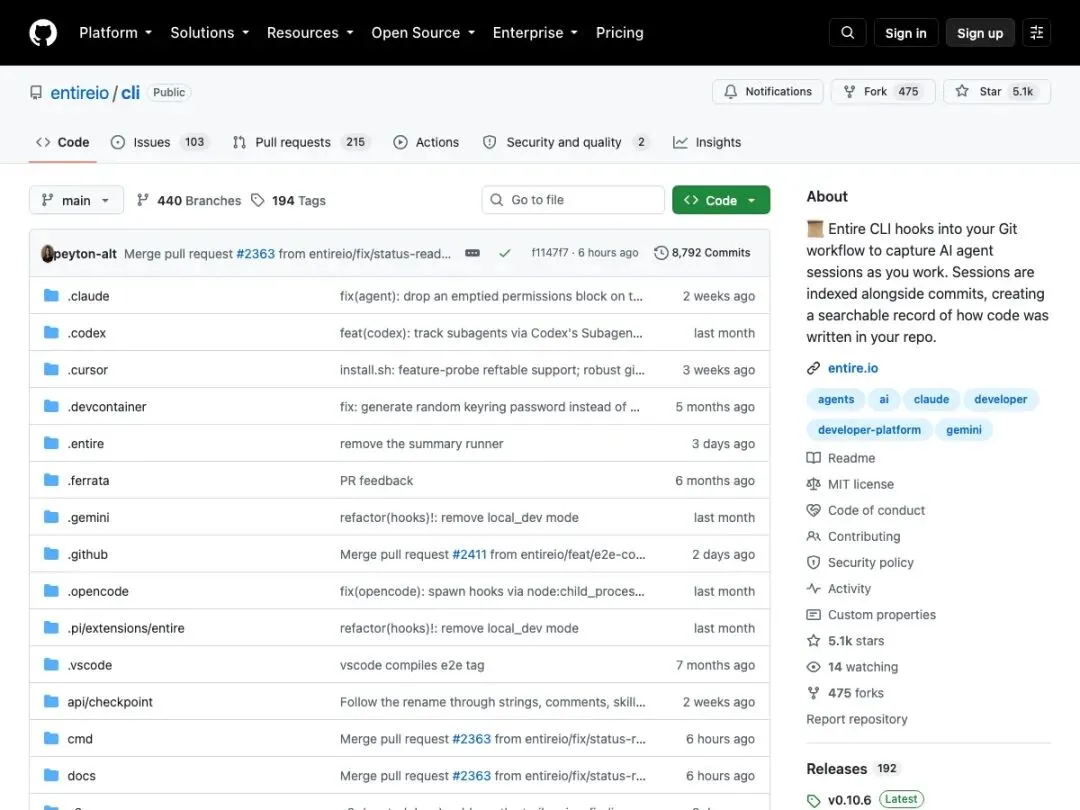 Entire CLI 项目主页
GitHub 地址: github.com/entireio/cli现有的三种做法,都有缺口
在 Entire 出现之前,想留下 AI 的「工作过程」,大概有三种路子,各有各的别扭。
第一种是依赖各家工具自带的会话历史。Claude Code 有 /resume,Codex 也有自己的历史记录。问题是这些历史只存在各家自己的目录里,格式私有,跟你的 Git 仓库完全脱节。换个工具,历史就断档;换了台电脑,想同步还得自己折腾。
第二种是靠自觉,把重要结论手动贴进 commit message。能坚持下来的人很少,而且信息量断崖式缩水——一次会话几十轮对话,最后能进 commit message 的往往只有一句「update auth logic」。
第三种是让 AI 往分支上自动提交 WIP commit 留痕。过程是留下了,代价是分支历史被污染,真正的 diff 淹没在几十个中间提交里,review 成本不降反升。
这三种做法的共同缺陷是:过程记录和代码版本是两张皮。而「为什么这么改」这个信息,恰恰必须在「改成了什么」的旁边才有用。
Entire 的思路是不另建一套系统,直接把过程记录塞进 Git 自己的存储机制里。
核心机制:把会话变成 Git refs
在仓库里跑一次 entire enable,它会装好 Git hooks,之后你像平常一样用 AI 干活,Entire 在后台默默工作。
它的工作流程分三步。
AI 工作期间,正在进行的会话现场暂存在一条短命的影子分支(shadow branch)上,你的工作分支完全不受影响。当你或者 AI 执行 git commit 时,Entire 把这次 commit 之前积累的会话数据——完整对话记录、改动的文件、token 用量,甚至子 agent 的任务记录——凝结成一个 checkpoint(检查点),并在你的 commit 上打一个 Entire-Checkpoint 标记,把两者关联起来。
checkpoint 的存放位置是整个设计最有意思的地方:它不进分支历史,而是作为独立的 Git ref 存在,路径形如 refs/entire/checkpoints/,就躺在仓库自己的 Git 对象库里。
这个选择带来三个直接好处。你的提交历史保持干净,Entire 从不在活动分支上创建 commit;每个 checkpoint 是独立的 ref,可以被单独 push 和 fetch,另一台机器上写的 checkpoint 按需取回就行,不用拉整条历史;checkpoint 跟着仓库走,clone 仓库时历史记录一起带过去,不存在「换个环境记录就丢」的问题。
一些细节也能看出设计上的成熟度:checkpoint ID 用 26 位 ULID,天然按时间排序;同一个 commit 上跑多个 AI 会话互不干扰;对 Git worktree 的多工作区场景做了独立追踪。
顺带说一句这个架构的来历。Entire 在 2026 年 7 月中旬把存储层重构成了现在这套 ref-based 方案,官方的说法是为了让 agent 历史越滚越大之后,push 和读取依然保持轻快。从博客的更新频率看,这个项目当前处于高速迭代期。
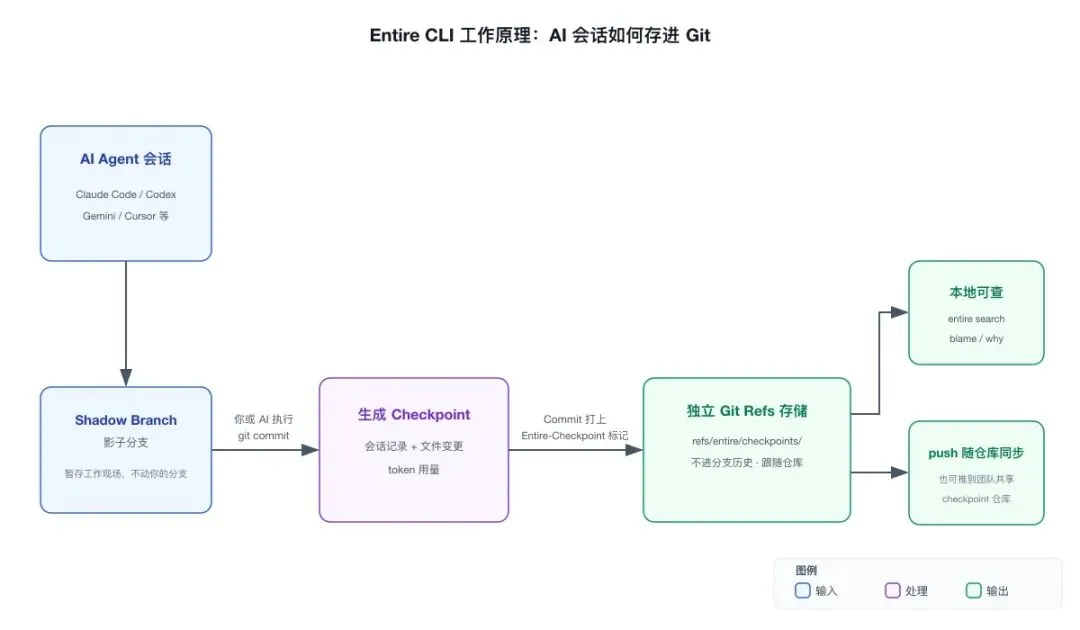 Entire 的 checkpoint 机制:AI 会话如何存进 Git
能干什么:从一行代码查回一次对话
存档只是手段,真正有价值的是查。
最点睛的是这两个命令。entire blame 类似 git blame,但它告诉你每一行代码出自哪次 AI 会话、哪个模型、哪位作者;entire why 更进一步,从某一行直接跳回产生它的那次 prompt 和对话现场。git blame 的 AI 时代续篇,说的就是这个。
第二个能力是恢复。entire session resume 可以从任意 checkpoint 接着干,不管是 AI 跑偏了想回退,还是同事接手你干到一半的活,都能精确回到当时的状态继续。
第三个是搜索。entire search 支持语义加关键词的混合搜索,搜的不只是代码,还包括所有会话内容。九月初刚上线的 Agentic Search 进一步把这个能力开放给 agent 自己调用——让 AI 在动手前先查「这类改动以前是怎么做的」。
第四个是跨工具接力。会话状态可以带着走:Claude Code 干到一半,改用 Codex 接手,不需要从零重新交代背景。这是各家工具自带历史完全做不到的。
第五个是团队沉淀。checkpoint 可以推送到一个专门的共享仓库,新成员接手项目时,顺着「prompt 到改动再到 commit」的路径就能看懂每段代码的来龙去脉。
上手:两条命令,之后无感
安装很简单,macOS 用 Homebrew 一行搞定:
bash brew install --cask entireio/tap/entire
Linux 和 Windows 各有官方安装脚本。装完在仓库目录里执行:
bash entire enable --agent claude-code
它会装好 Git hooks 并配好对应 agent 的接入。之后每天像平常一样用 AI 干活就行,记录、凝结、存档全部自动发生。想看状态随时 entire status,不想要了 entire disable 会拆掉 hooks,代码和提交历史原样不动。
代价与边界:下手之前想清楚这几件事
先说最关键的一条:开源的是 CLI,不等于一切都是开源免费的。使用前需要 entire login 注册账号,checkpoint 数据本体确实存在你本地仓库的 Git 对象库里,这部分数据主权在你手上;但账号体系、云端搜索、团队协作,以及它正在铺的 Git hosting 业务,都走 Entire 的云服务。CLI 用 MIT 协议开源,商业闭环在云端,这个边界用之前要分清楚。
安全设计倒是有诚意:敏感信息在存储前会自动检测并脱敏,内部跑了两套秘密扫描引擎;登录凭证存操作系统钥匙串;CI 环境支持环境变量注入 token,不用落盘。不过话说回来,把一个第三方工具挂进 AI 会话的数据流,本身就值得谨慎评估——社区里确实有开发者因为这类顾虑对同类工具保持距离。好在数据本地持有加协议开源,给了你审查的余地。
第二,这是个年轻且高速演进的项目。从官方博客看,七、八、九三个月几乎每周都有新版本,功能在快速变化的同时也意味着今天的行为明天可能调整。对不同 agent 的支持深度也不均匀:子 agent 活动记录对 Claude Code 和 Droid 是完整支持,Codex 和 Cursor 还是有限支持。
第三,它解决的是「AI 时代的过程记录」,如果你主要还在手写代码,会话记录的收益会大打折扣。这个工具的价值前提是:你的日常工作流里 AI 已经是主力生产者。
结尾
回过头看,Entire 踩中的是一个结构性缺口。软件开发的整套基础设施——issue、仓库、pull request、code review——全是为「人写代码」设计的。当写代码的主力变成 AI,为 AI 重建这套基础设施就只是时间问题。
Entire 的答案有个聪明的起点:不另起炉灶,把「为什么」直接变成 Git 的一部分。代码版本有 Git 管,AI 会话版本也有 Git 管,两本账用同一套机制记,谁都不用换工具。
这个 CLI 背后的团队野心也不小,官网的愿景文档里规划了三层:agent 版本控制、让 agent 之间共享记忆的语义推理层、再到面向 AI 的全新协作流程。能不能做成另说,但方向判断是对的——当「为什么这么写」和代码本身一样值钱的时候,它就值得一个像样的版本管理系统。
GitHub 地址: github.com/entireio/cli