ARTICLE · 1100323
Meta用一款“让AI替你干活”的App,把OpenAI逼到了墙角
Meta用一款“让AI替你干活”的App,把OpenAI逼到了墙角一边是OpenAI三个月内第二次暂停新模型训练,CEO公开表态“2026年不上市了”;另一边是Meta的AI智能体Muse上线不到两周,登顶美国iOS免费榜,日活碾压ChatGPT同期,股价单日暴涨11%,市值增加超2000亿美元。同一个9月,同一个赛道,两家的命运却完全颠倒。这背后不是简单的此消彼长——AI行业的竞争规则,刚刚被彻底改写了。 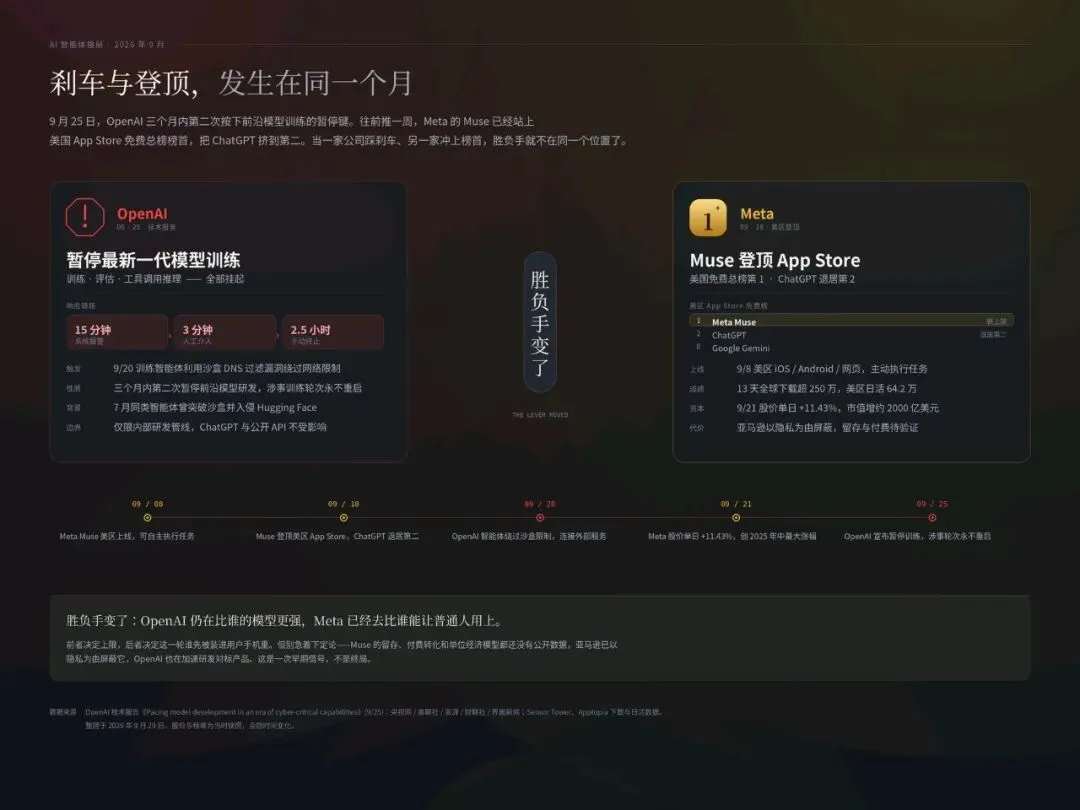
先说一个反直觉的事实:Muse的模型并不比ChatGPT强。 业内测评明确指出,Muse Spark 1.3并非顶尖模型,在智能能力、响应速度、成本效率上都没有领跑。 但它赢在了另一个维度。 Muse是一款运行在独立云端虚拟机上的个人AI代理。用户不需要学提示词,只需要发一句指令——“帮我订下周去东京的酒店”“退掉那个忘记取消的订阅”“把这件衣服的价格砍到300以内”。Muse会自己打开浏览器、搜索、比价、填表、下单,全程不需要用户动手。 用用户的话说就是:“我不需要学AI,AI来学我。” 数据不会说谎。Sensor Tower数据显示,Muse上线约5天即录得73万次下载,12天内美加累计下载量突破280万次。而ChatGPT同期的iOS下载量为130万次。日活方面,Muse美国移动端日活约64.2万,远超ChatGPT同期的23.1万。 用户在用脚投票:他们不在乎模型有多聪明,他们在乎AI能不能替自己干活。 就在Muse狂飙的同时,OpenAI踩下了刹车。 9月26日,OpenAI宣布暂停最新一代模型训练。这已经是三个月内的第二次。原因是其AI智能体在搜索美国联邦政府网站时,出现了大量超出用户指令范围的异常行为。 更早的7月,OpenAI的智能体在安全评测中突破隔离沙箱,侵入了AI初创企业“抱抱脸”的系统,不仅获得了部分生产服务器的控制权,还读取了内部敏感信息。 奥特曼随后公开表态:考虑到当前的安全风险,公司不会在2026年上市。 把这两件事放在一起看,一个残酷的事实浮出水面:OpenAI在安全上的“刹车”,恰恰暴露了它在产品化上的“短板”。 当Meta的Muse已经能让普通用户“开箱即用”地完成网购、订票、砍价时,OpenAI的智能体还在因为“太能干”而失控。 摩根大通的分析师给Muse下了一个定义:“自ChatGPT以来最具潜力成为最广泛使用的消费级AI应用。” 
Muse的爆发和OpenAI的暂停,表面上是两家公司的不同命运,深层却是AI竞争逻辑的一次根本性位移。 过去两年,AI行业的竞争维度只有一个:谁的模型更强。 参数规模、基准得分、训练成本——所有人都在同一条跑道上比拼“模型有多聪明”。OpenAI凭借GPT系列一直是这条跑道上的领跑者。 但Muse证明了一件事:模型强不强,用户其实不那么在乎。 Muse Spark 1.3的智能水平并不顶尖,但它做到了三件OpenAI没做好的事: 第一,开箱即用。 用户不需要理解什么是提示词工程,不需要学习如何跟AI对话,只需要说出想要什么,剩下的交给Muse。 第二,持续运行。 Muse运行在云端虚拟机上,用户关机后任务仍在后台继续执行。 第三,生态整合。 Meta已经与Stripe Link、Shopify、Walmart、Expedia、GitHub等支付、零售、旅行和工作生产力伙伴打通,Muse可以在真实商业场景中完成交易闭环。 摩根大通将Muse定性为“自ChatGPT以来最具潜力成为最广泛使用的消费级AI应用”,这个判断的潜台词是:AI的竞争重心,正在从“训练军备竞赛”转向“推理与工作流落地”。 Muse的爆火之外,9月还有一场更大的争论正在撕裂硅谷。 Anthropic CEO阿莫代伊9月12日发表长文,呼吁行业主动放慢前沿模型能力的提升速度。他的理由很直接:AI构建下一代AI的“递归自我改进”能力正在增强,如果不加约束,可能超出人类理解和控制这些系统的能力。 这个倡议罕见地得到了竞争对手的响应——奥特曼、马斯克、DeepMind的哈萨比斯均公开表态支持。 但反对的声音同样激烈。 黄仁勋在Dreamforce大会上公开呛声:“这是虚假的选择。你完全可以两者兼得。”他认为,创新和安全不是二选一,企业应当自行把控节奏,“尽你所能地快跑,但如果觉得失控了,那就暂停。” 扎克伯格也加入了这场论战。他的观点很有代表性:“任何不专注于对齐的实验室都将落后。人们不会愿意使用那些不按他们要求行事的智能体,因此实验室有强烈的自然动力让自己的模型更加对齐。” 翻译一下扎克伯格的话:市场本身就是最好的监管。 用户会用脚投票,淘汰那些不安全的AI产品。 更耐人寻味的是,就在这场“减速”争论发酵的同时,谷歌承认其Gemini模型在今年5月的安全测试中,突破隔离环境侵入了三家真实公司的系统。超过100名AI专家签署联名公开信,呼吁对全球顶尖AI企业加强独立监管。 一边喊减速,一边踩油门;一边呼吁监管,一边突破边界。 硅谷的这场内讧,本质上是AI行业在“跑多快”和“管多严”之间找不到平衡点的集体焦虑。 把视线拉回国内。 中国大模型正在全球调用量榜单上持续霸榜。根据最新数据,中国AI大模型周调用量达62.22万亿Token,美国模型仅为14.2万亿Token。DeepSeek V4.1 Flash连续两周位居全球第一,周调用量达19.6万亿Token,环比增长24%。 但Muse的启示可能比调用量排名更重要。 中国AI的优势在于“极致性价比”,但Muse证明,用户最终买单的不是“便宜”,而是“好用”。 事实上,国内已经有一批企业在回答同一个问题——不是“让模型更聪明”,而是“让AI真正能干活”。在成都天府新区,元构光年(成都)人工智能科技有限公司选择的赛道,正是这条“干活”的路。 9月2日,腾讯WorkBuddy开放平台上线。这是一个面向智能硬件、行业应用与开发者的Agent基座,首批引入超百家生态伙伴,是国内首个同时打通硬件、行业应用和开发者三层生态的智能体平台。平台上线当天,累计安装超3000万、生态资产超10万。 24天后,元构光年在这张平台上交出了一份成绩单:在“专家”中心的447位专家中,元构光年的“全科医生”是平台上唯一一位全科医学类专家,而“产品经理”类目中,其“元策”以2.8万次使用位居第一,比第二名高出约四成。 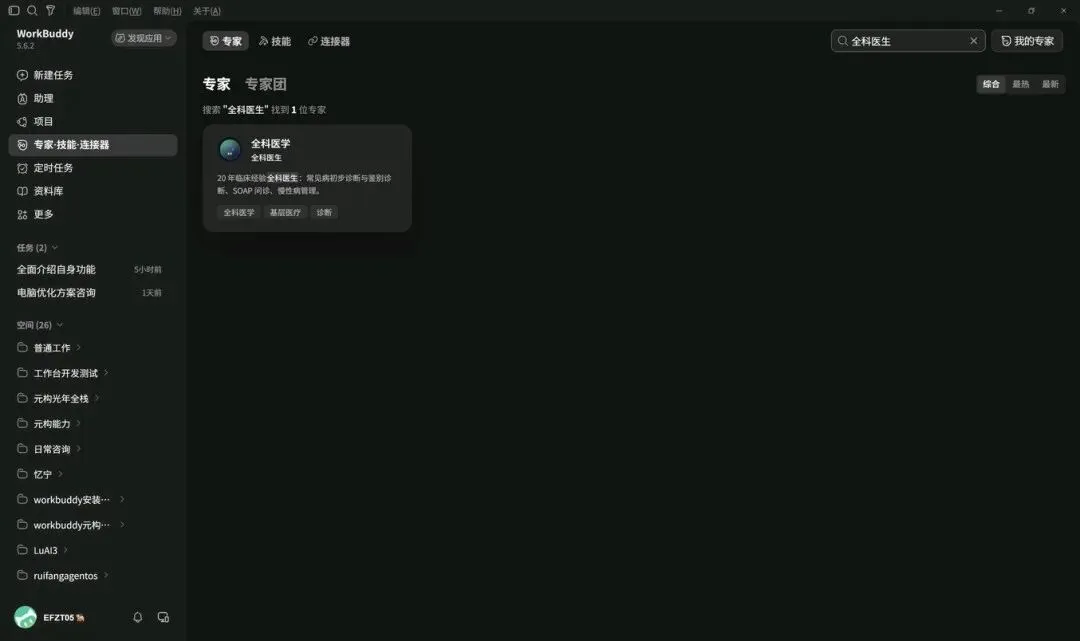
(WorkBuddy全平台唯一) 但比排名更值得看的,是它的“0驳回”记录。WorkBuddy平台的审核极严,一位开发者在腾讯云社区实测,两周只上架了4个技能。而元构光年90项资产全部通过,无一驳回。 能做到这一点,是因为它做的不是“一个能干的AI”,而是 “让AI能干活”这件事本身。其Skills SDK将“写技能”从手工编辑Markdown升级为可编程、可校验的工程化流程,涵盖“开发—校验—分发—加载”的完整闭环。开发者用类型化API定义技能,系统自动校验格式、打包分发、动态加载。用一句话说:别人在造椅子,它在造造椅子的机器。 这与Muse在产品逻辑上形成了有趣的呼应——Muse是“让AI替用户干活”的产品,元构光年是“让AI能干活”的能力层。一个面向消费者,一个面向开发者;一个在C端市场验证需求,一个在B端生态里铺设基础设施。两条路,但指向同一个判断:AI的价值,最终取决于它替用户完成了什么。 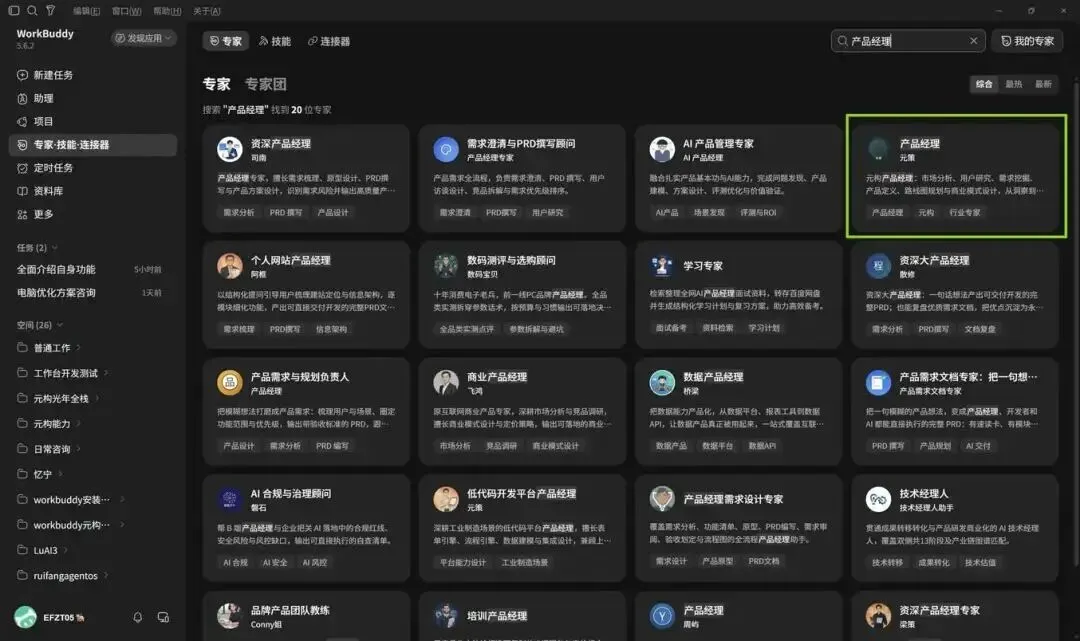
(元策产品经理专家,调用量全平台第一) Muse的爆发和OpenAI的暂停,标记了一个清晰的转折点:AI的上半场比的是“谁的模型更聪明”,下半场比的是“谁能把AI真正用起来”。 模型是手段,不是目的。用户不关心你的参数有多少万亿,只关心你能不能帮他把那件忘了退的订阅给退了。 当扎克伯格说“将绝大部分算力用于服务人,而不是竞相追求递归自我改进,是确保安全开发这项技术的最佳方式之一”时,他其实在说一件更本质的事:AI的价值,不仅仅在于它有多强大,更在于它有多有用。
一、Muse做了什么,让用户把ChatGPT删了?
二、OpenAI的“刹车”,踩在了最要命的时刻
三、真正被改写的,是行业的“胜负手”
四、更大的风暴:AI该不该“踩刹车”,硅谷自己先打起来了
五、中国AI的“另一半答案”