ARTICLE · 1102464
把一本 PDF 变成能追问的学习网页:这个开源 Skill,让 AI 学习有据可查
把一本厚书丢给 AI,它给你吐一份总结——你是不是也这么用过?看起来很爽,但一追问细节就露馅:这句结论是原文哪一页说的?它答不上来。今天这个开源 Skill,就是来治这个病的。
先还原一个几乎人人都踩过的坑:
你要啃一份几百页的 PDF——可能是行业报告、可能是教材、也可能是一篇超长的技术白皮书。
偷个懒,把它丢给 AI:"帮我总结一下。"
几秒钟,一份条理清晰的摘要就出来了。看着真香。
然后你顺着摘要往下问:
•
"第三章那个结论的推导过程是怎样的?"
•
"这个数据在原文哪一页?"
•
"这里说的例外情况,原文有提吗?"
AI 开始含糊其辞,甚至一本正经地编。
因为它给你的是"二手转述",中间那一步——回到原文——断了。
一句话:AI 总结最大的问题从来不是"不准",而是"无法核验"。
01learn-from-materials:一个专治"看了等于没看"的学习 Skill
learn-from-materials 是一个基于开放 Agent Skills 规范的学习助手。
它干的事,可以说得很直白:
把书籍、PDF、PPT、Word、网页,甚至一堆散装材料,转化成"可追溯的知识库 + 能交互的学习网页 + 同步的 Markdown"。
注意关键词——可追溯。
它不是帮你"总结一下",而是帮你把一份材料真正读完、拆透、并且每一步都能回到原文。
它强调几件事,条条都戳在 AI 学习的痛点上:
•
完整阅读:不跳读、不臆测,先把材料走完
•
出处可核验:每条结论都指得回原文位置
•
材料事实与模型补充分离:哪些是书上写的、哪些是 AI 加的,分得清清楚楚
•
离线优先、最小权限:默认不联网,你的东西留在你自己电脑上
GitHub 仓库:github.com/dmoshehun-prog/learn-from-materials
02它能吃下什么
几乎覆盖了你手上所有"想学但啃不动"的材料:
| 类型 | 格式 |
|---|---|
| 电子书 | PDF、EPUB、MOBI / AZW / AZW3 |
| 办公文档 | DOCX、PPTX / PPTM |
| 网页与文本 | HTML、Markdown、TXT、RTF |
| 合集 | 多份材料一起丢进来也行 |
一份能啃,一摞也能啃。
效果展示
以下依次展示人物传记、金融市场展望报告和学术论文三种材料生成的学习页。每组选取同一套六板块学习页中的不同部分,并非展示每个示例的全部页面。
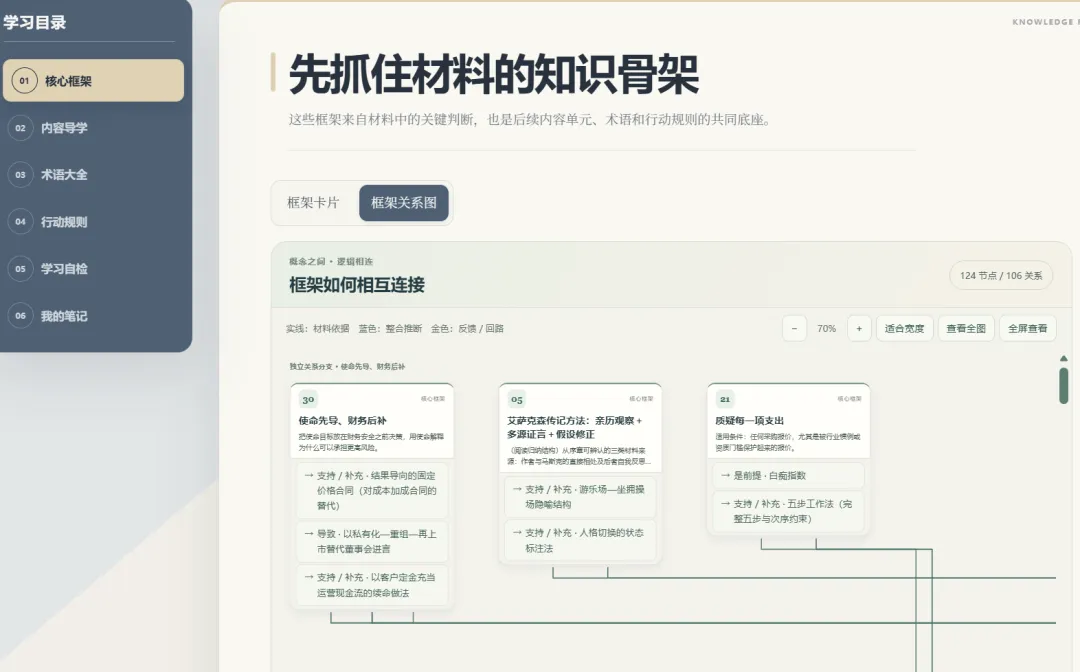
1. 人物传记:《埃隆·马斯克传》
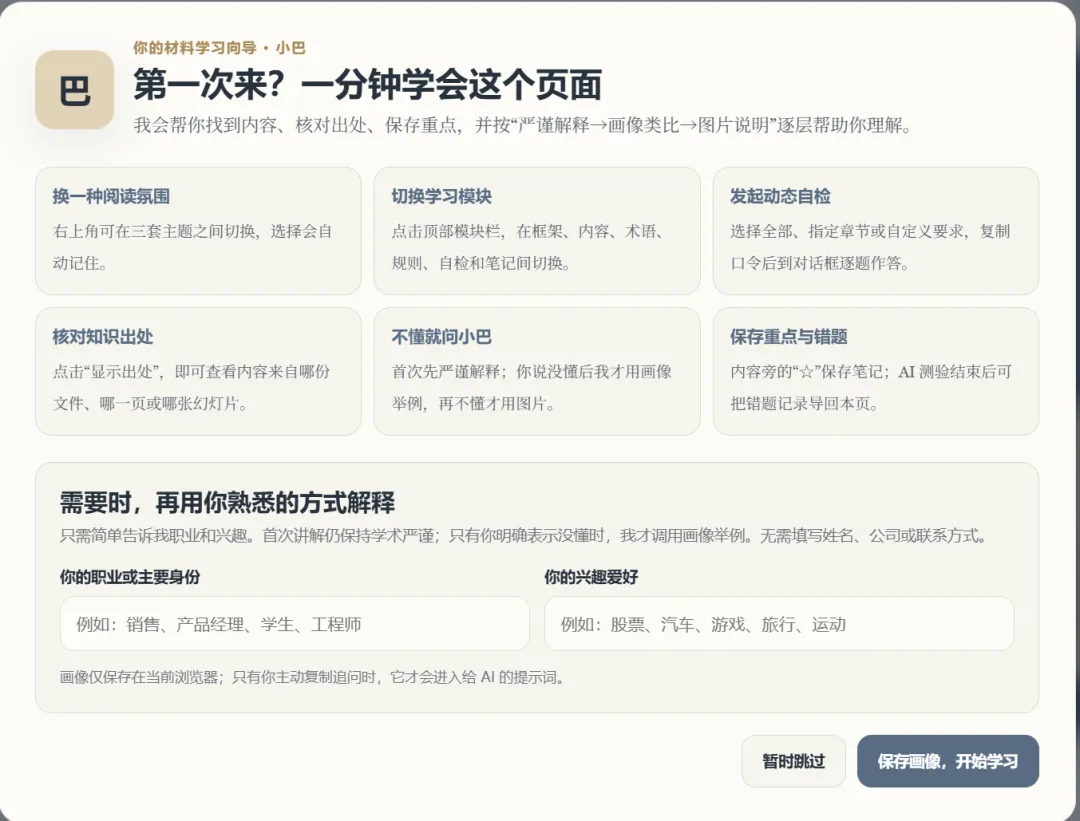
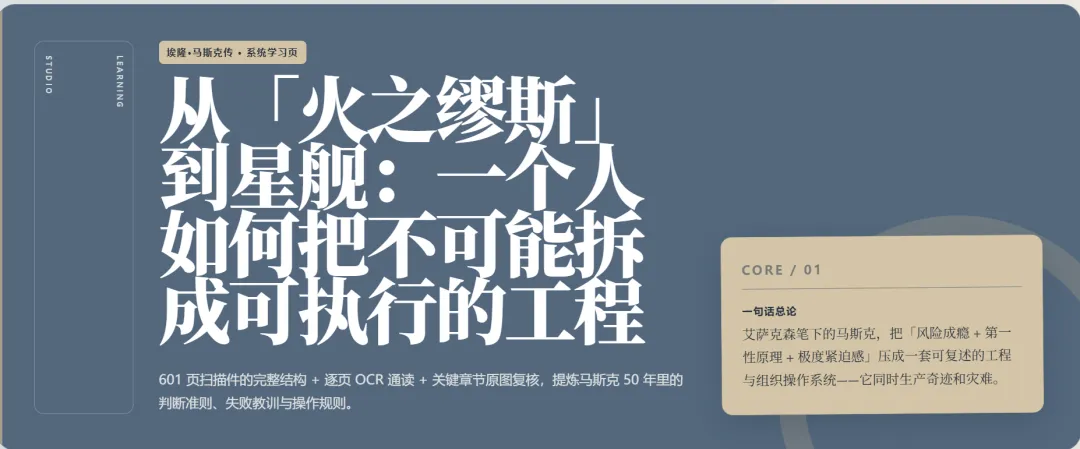
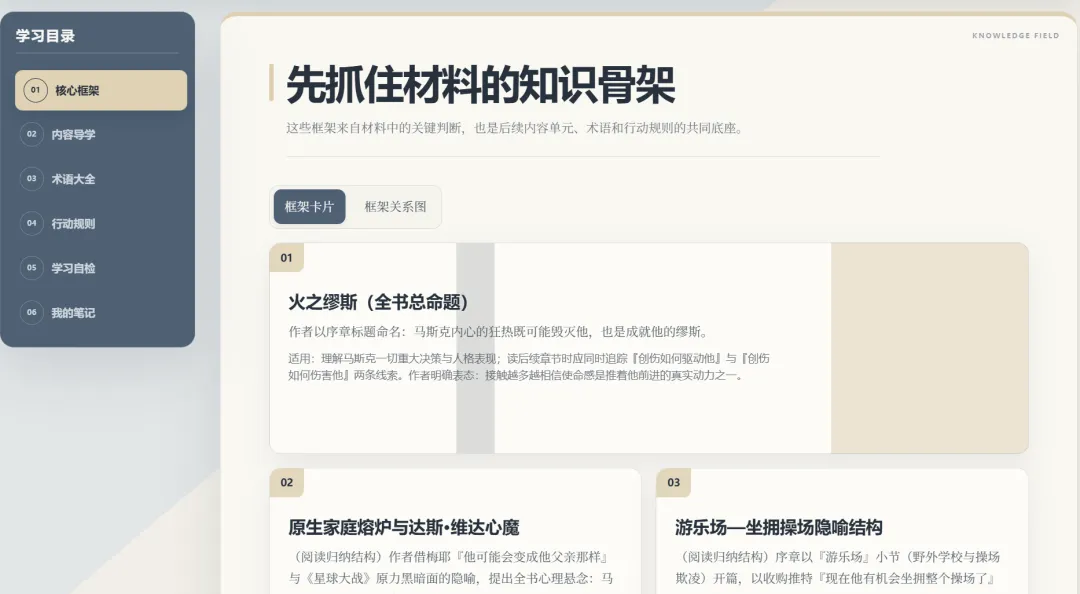
首次使用引导介绍学习模块和仅保存在浏览器本地的可选画像。生成的页面从整本书的一句话总论,延伸到核心框架卡片及其关系图。
首次使用引导
系统学习页封面
核心框架卡片
框架关系图(局部)
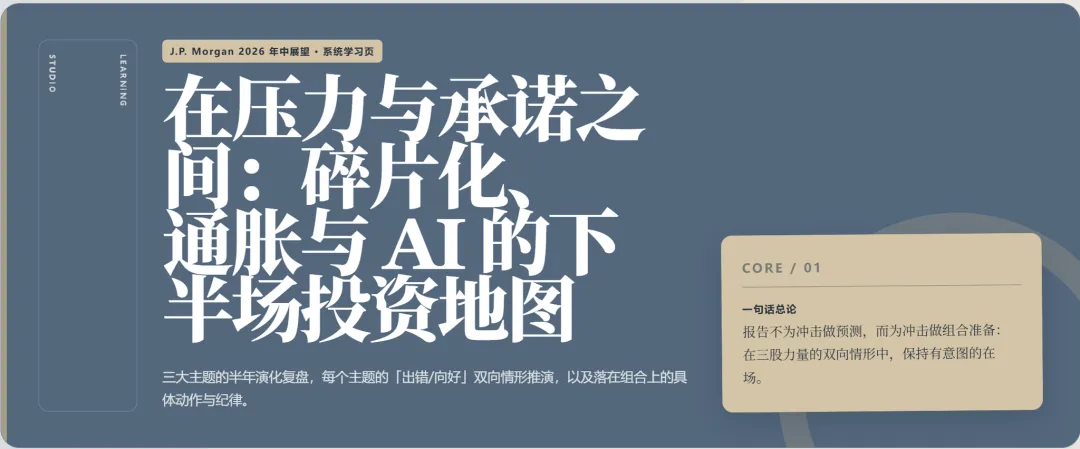
2. 金融市场展望报告:J.P. Morgan《2026 年中展望》
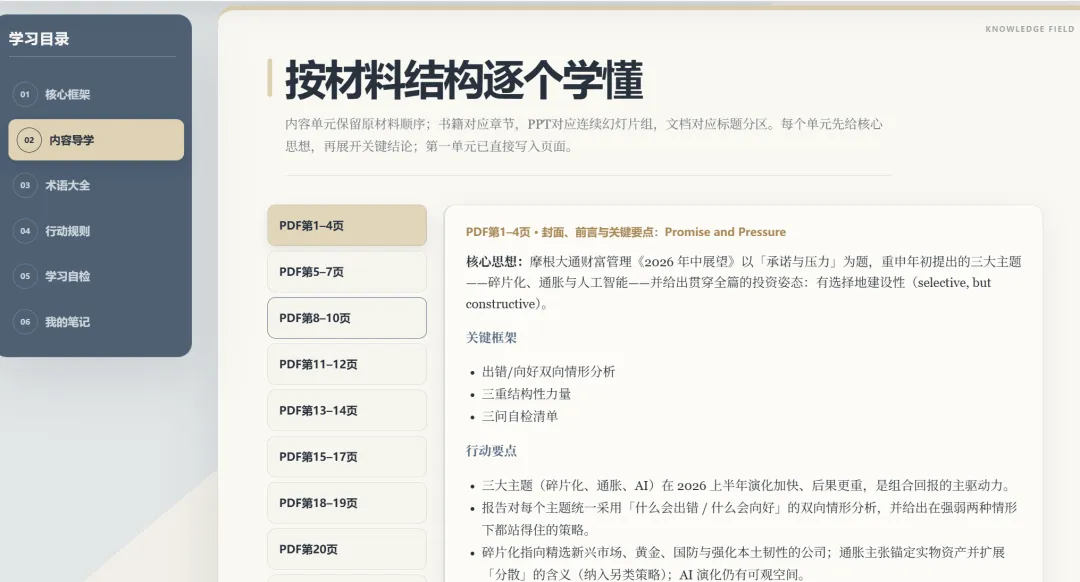
这一示例展示同一流程如何把金融市场展望 PDF 整理为系统学习页。内容导学保留 PDF 页段,并分别呈现单元的核心思想、关键框架和行动要点。
系统学习页封面
带 PDF 页段的内容导学
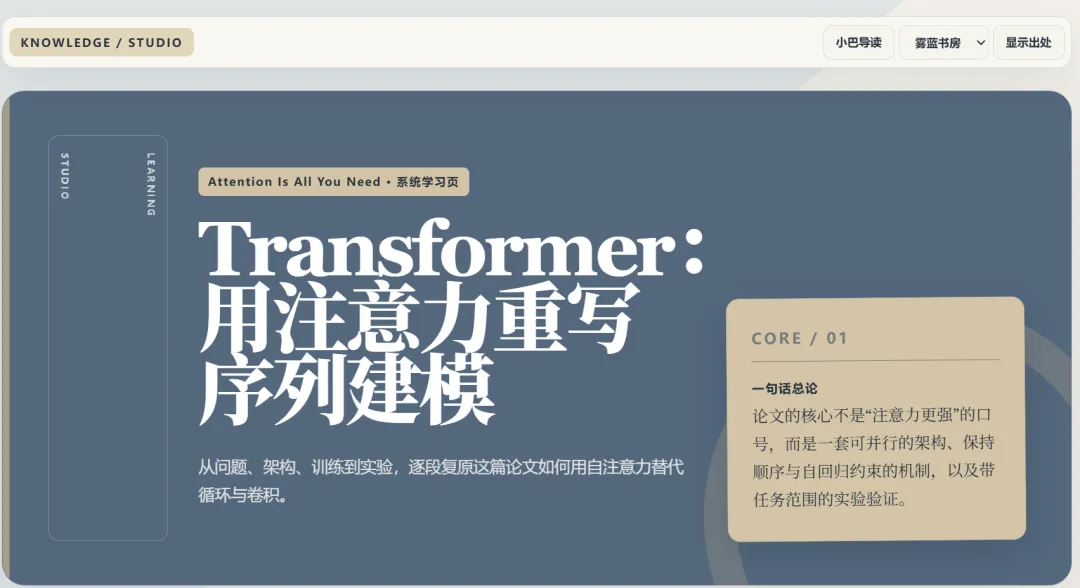
3. 学术论文:《Attention Is All You Need》
论文示例展示如何把研究论证整理成学习页,并通过方法论关系图呈现有任务边界的推理结构。下图仅是图谱的局部视图。
系统学习页封面
方法论关系图(局部)
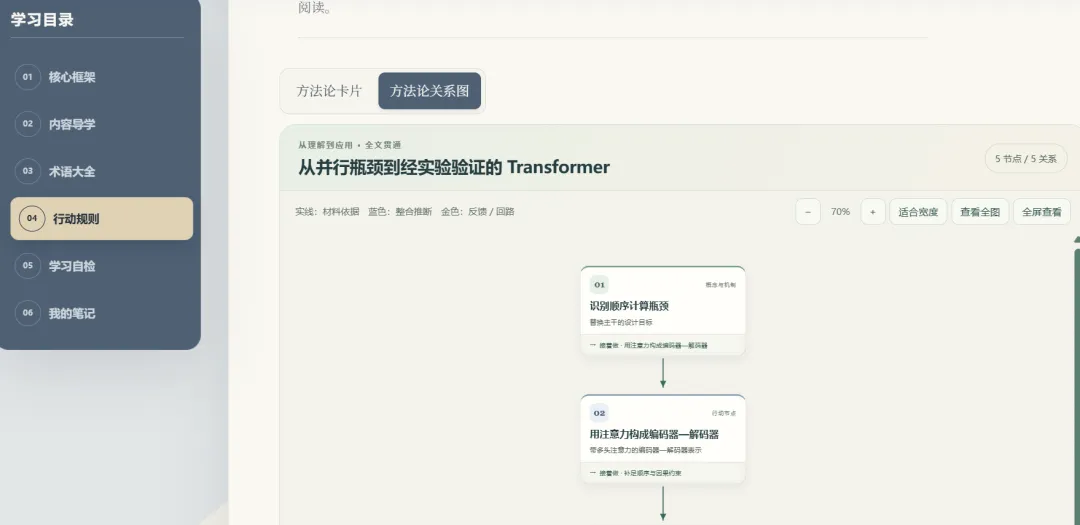
这些截图展示页面组织方式,不构成对每项论断、出处或生成结论的独立核验。原材料及截图涉及的内容版权归各自权利人所有;本仓库不包含对应原始材料或完整生成结果。请只处理并展示你有权使用的材料。如需无需原材料的合成演示,可打开整体方法论示例或中文版功能示例。
03两种学习深度,先问你一句"要多深"
这是它比普通总结工具聪明的地方。
开始之前,它会先让你选学习深度:
•
快速了解:先把骨架和主线抓出来,适合"先看看值不值得深读"
•
系统学习:逐章逐节拆解,适合"这门东西我真的要学进去"
同一份材料,你想走个过场还是打穿它,由你定。
04产出三样东西
跑完之后,你会拿到:
| 产物 | 是什么 |
|---|---|
| .learnkb/ 知识库 | 可追溯的结构化知识底座,藏着所有来源映射 |
| 交互式学习网页 | 一个自包含的单文件 HTML,双击就能开 |
| 同步 Markdown | 干净、可以直接进你笔记库的文本 |
其中那个单文件 HTML,是最直观的惊喜——不用搭环境、不用起服务,一个文件就是一套完整的学习站点。
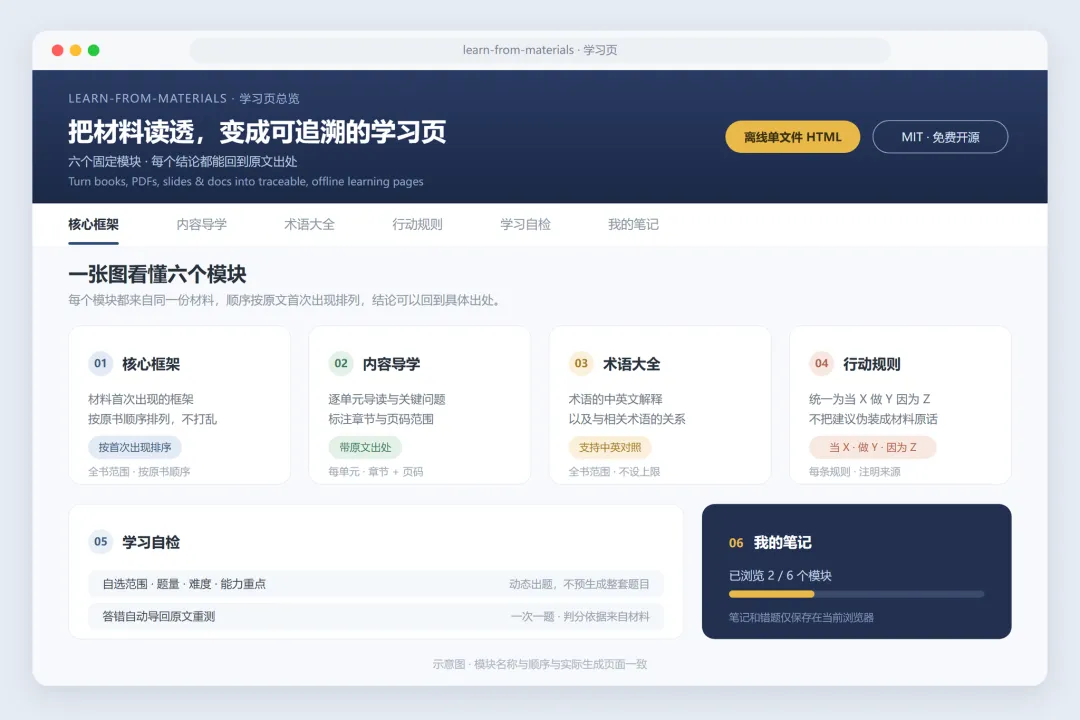
05学习网页里,固定有六个模块
页面结构是定死的,一共六块:
| 模块 | 干什么 |
|---|---|
| 01 核心框架 | 先把整份材料的骨架立起来 |
| 02 内容导学 | 带你走一遍,标注章节与页码范围 |
| 03 术语大全 | 把材料里的关键概念集中收口 |
| 04 行动规则 | 把"该怎么做"提炼成可执行条目 |
| 05 学习自检 | 动态生成自测题,答错会导回原文重测 |
| 06 我的笔记 | 边读边记,笔记就存在页面里 |
注意每个模块的顺序——它按术语在原文中首次出现的顺序排列,而不是随便堆。
它是照着你这份材料的真实结构生成的,不是套模板。
06真正的杀招:可追溯
这是它和所有"AI 总结工具"拉开差距的地方。
它给 PDF 页码、PPT 幻灯片、EPUB 章节都建立了细粒度的来源映射。
也就是说:网页里任何一个结论,你都能一路点回它到底出自原文的哪一页、哪一张、哪一章。
更进一步,它会把内容明确分成四类:
| 类别 | 含义 |
|---|---|
| 材料依据 | 原文白纸黑字写着的 |
| 材料未覆盖 | 材料里根本没讲的(如实告诉你"没有") |
| 模型补充 | AI 自己补的背景知识,明确标注 |
| 外部核验 | 引用了外部资料来交叉印证的 |
这份"诚实",才是它最值钱的地方。
普通 AI 总结,会把它自己脑补的东西,和原文混在一起喂给你,你还分不出来。
而它把"书上说的"和"它自己想的"物理隔开——你看到的每一条,都知道该信几分。
07它甚至会给自己的总结"查漏"
一份材料动辄几百页,AI 真的读完了吗?还是漏了一大块?
learn-from-materials 内置了一套质量控制机制:
•
覆盖审计:检查材料有没有被完整覆盖
•
总结双向映射:总结 ↔ 原文,两边对得上
•
反向覆盖抽查:从原文反查,看有没有被漏掉的段落
•
来源哈希 + 增量更新校验:材料改了,能识别出哪些需要重跑
说人话就是:它不只生成,还自己检查自己有没有偷懒。
08装到哪?四个主流 Agent 环境都能用
它遵循开放的 Agent Skills 规范,只要环境能读文件、跑本地命令、认得 SKILL.md,就能接:
| 环境 | 技能目录 |
|---|---|
| Claude Code | ~/.claude/skills/ |
| Codex | ~/.agents/skills/ |
| WorkBuddy | ~/.workbuddy/skills/ |
| GitHub Copilot CLI | ~/.copilot/skills/ 或 ~/.agents/skills/ |
安装就是一条 git clone,以 Claude Code 为例:
●●●CODE
git clone https://github.com/dmoshehun-prog/learn-from-materials.git ~/.claude/skills/learn-from-materials装好之后,用法更是简单到一句话:
"请用 learn-from-materials 系统学习这本 PDF,并生成可追溯知识库和学习网页。"
剩下的交给它。
09几个要说清楚的边界
第一,它是个新项目。
Star 数还不高(不同平台统计在两三百量级),社区和打磨程度远没法和成熟项目比。尝鲜可以,别急着当成生产力刚需。
第二,依赖环境和工具链。
需要 Python 3.10+;想要浏览器交互验证的话,还得有 Node.js、Playwright、Chromium;如果材料是扫描版 PDF 或图片密集的幻灯片,那还得有 OCR 或视觉能力,否则它"看不见"内容。
第三,纯聊天环境玩法有限。
如果你的 AI 只能聊天、碰不到文件系统也跑不了 Python,那只能用上一部分提示流程,材料提取、覆盖校验、网页渲染这些核心能力都用不了。
第四,隐私设计是加分项。
默认离线、不联网、不自动装依赖,你的笔记、学习画像、错题记录只存在本地浏览器里。
第五,血缘要交代清楚。
它基于 virgiliojr94 的 book-to-skill 项目二次创作而来(MIT 协议),分发时要保留 LICENSE.md 和 NOTICE.md。
10写在最后
用 AI 学习这件事,我们其实一直卡在同一个地方:
我们得到了"结论",却失去了"来路"。
一份漂亮的摘要,看起来省了时间,实际上把你和原文之间最关键的连接——可核验——给切断了。学得越快,忘得越快,也越不敢用。
learn-from-materials 的价值,不在于它总结得多好。
而在于它逼着 AI 做一件反直觉的事:慢下来,把每句话都钉回原文。
能追问、能溯源、能自检——这才叫"把材料学会了",而不是"把材料过了一遍"。
下次再想把一本厚书丢给 AI 之前,先问一句:
它给我的东西,我能核对吗?
GitHub 仓库:github.com/dmoshehun-prog/learn-from-materials
觉得有用的话,点个赞 or 分享给身边还在"AI 总结一看就会、一考就废"的朋友。