ARTICLE · 1102743
AI视频角色图分三档做,群众演员到主角一次配齐
角色图分三档 · 群众演员到主角
一张群像、一张角色卡、两张主角图,一场戏就配齐了
该精的精确,该糙的糙掉
EDITOR'S NOTE
2026.09做AI视频的人,早晚会撞上同一堵墙。
一场两分钟的戏,主角的脸能换三次。前一个镜头还算清秀,镜头一切,下巴宽了一圈,眼睛也换了形状。观众说不清哪里不对,但就觉得假。
还有一种更隐蔽的。街上那几个路人,六个长得像六胞胎。同一件深蓝外套,同一头黑直发,同一个体型,同一个站姿。扫一眼就知道,这不是一条街,是同一张图复制了六遍。
经过一批实战短剧的磨练,我们的办法挺朴素,把一场戏里的角色分三档,每一档做到什么程度,心里有数就行。
下面是我跑出来的整套图,中间踩到的地方也一并说了。
先说清楚一件事。下面这八张图全部是重做的,没有用原文里任何一张。出图我走的是直接调生图平台这条道,没有经过原文那套写剧情顺带出图的链路。模型换成别的,做法一样成立。
01
PART
一场戏的角色,本来就不用都做精
NOT ALL EQUAL
很多人一说给AI视频做角色,第一反应是每个出现的人来一张角色卡。
这个念头一起,人就被拖住了。一场戏里路人十几个,一个个做,做到天亮也做不完。
那篇给的是个省力的分法。
群众演员算最低档,他们只要不重复就行,脸上什么细节根本不重要。
女二和主要配角是次优档,他们的特点得控制住。
男主女主是最高档,脸和身形都要锁死。
档位分清楚,力气就知道往哪使。
OVERVIEW
一场戏的角色,按出镜分量分三档
档位不是质量高低,是出场分量。观众记不住路人的脸,但一定记得住重复的脸。
02
PART
群众演员,一张群像图就够
CROWD IN ONE SHEET
最低档的做法最省,一整场戏的群众演员,通常只做一张群像全身图。
听着有点敷衍,其实够用。因为观众看路人根本不记脸,他记的是轮廓,是那件亮黄色的雨衣,是那个特别高的胖个子,是那头漂过的金发。
所以区分群众演员靠的是三样,服装、体型、发色。这三样拉开了,观众就觉得街上站着六个不同的人。
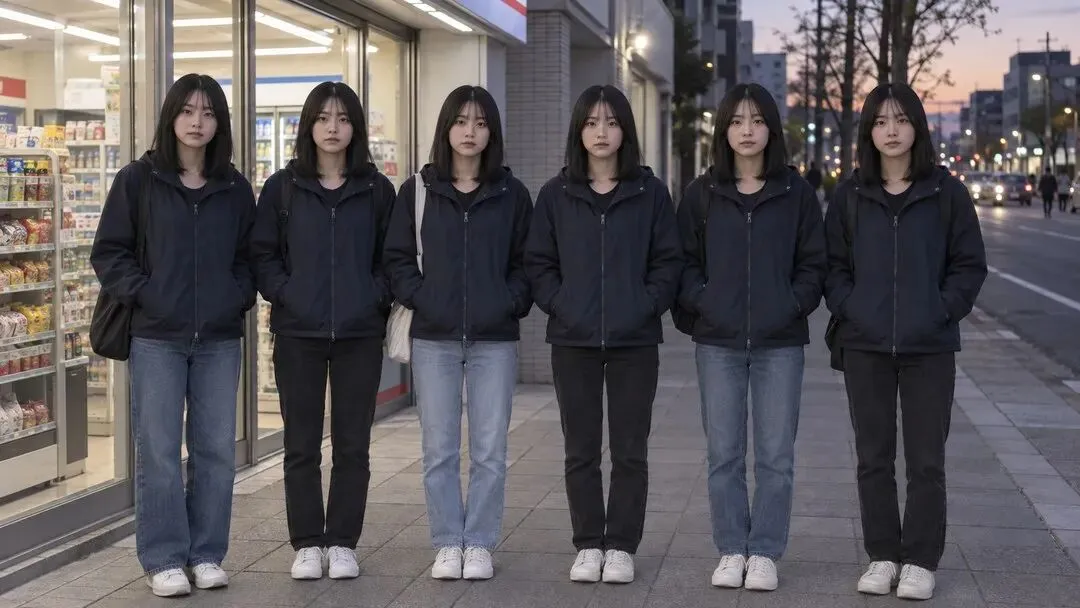
第一版群像,六个人几乎是同一张脸换了六次
我第一版就翻在这儿。指令写得太笼统,只写了路人、街边、傍晚,出来的六个人几乎一模一样。深色外套,黑直发,连站的姿势都差不多。
第二版把每个人单独写了一条。黄的雨衣配发髻,高壮的灰卫衣剃了两侧,老太太的花衬衫配烫过的灰棕卷发,细高个的少年漂了金发,红色开衫扎长马尾,穿绿色工服的是个敦实的中年人。
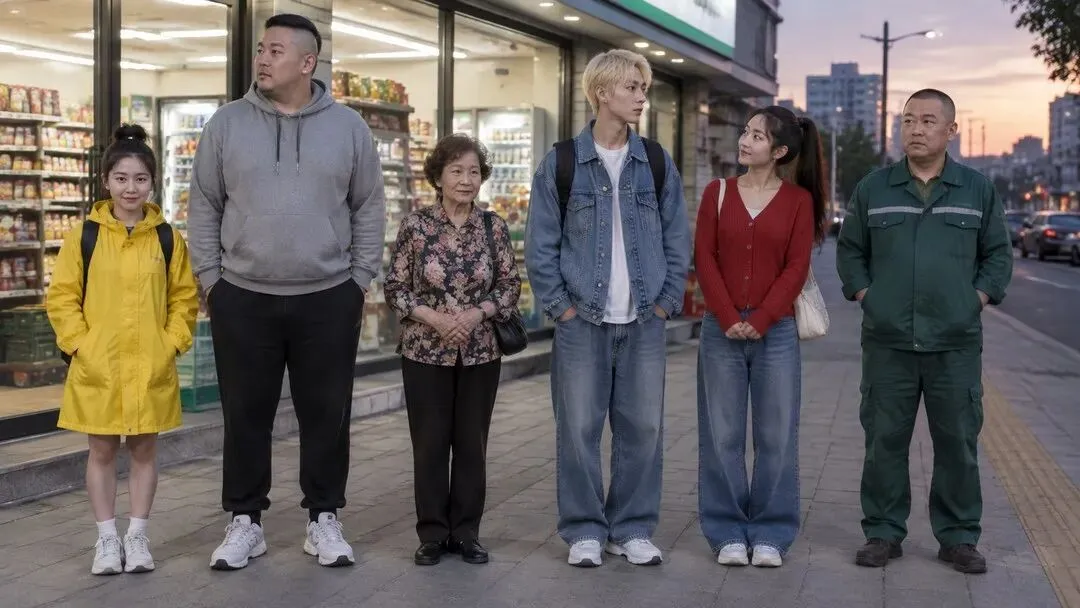
第二版群像,同一条街,六个人一眼分得开
两张并着看,差别就出来了。
这里有个反着来的地方。群众演员的脸你越不写,出来的效果反而越安全。你一旦把五官写细,模型就开始认真雕那张脸,六个人雕下来,很容易雕成一家人。
03
PART
女二和主要配角,特点是你说出来的
SAY THE TRAITS
次优档不一样了。这些角色有台词,有镜头,出场不止一次,特点必须控制住。
那篇里有句话我记得很清楚。他说要把角色特点明确告诉模型,不然它做出来的角色就会比较平。
这话看着像废话,我试完才知道有多实在。
我拿女二试的。设定是打扮张扬,戴一副很时尚的大眼镜,头发是波浪卷。
第一次我只写了年轻女性,站在便利店门口。出来的就是一个标准的路人。
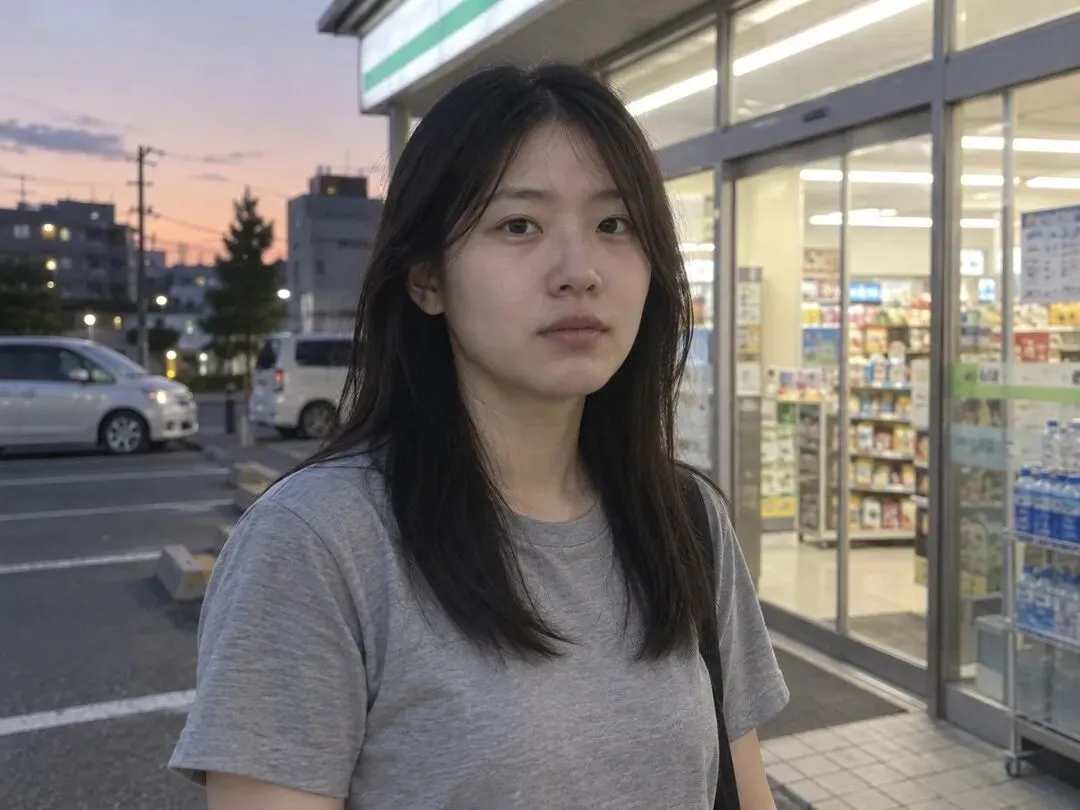
第一版女二,她没错,只是谁都能替她站在这儿
你说它错吗,它没错,它确实是个年轻女性。但你要的是一个张扬的女二,它给你的是一块可以站在任何人旁边的背景板。
把特点补齐,再上角色卡的做法,出来的是这张。
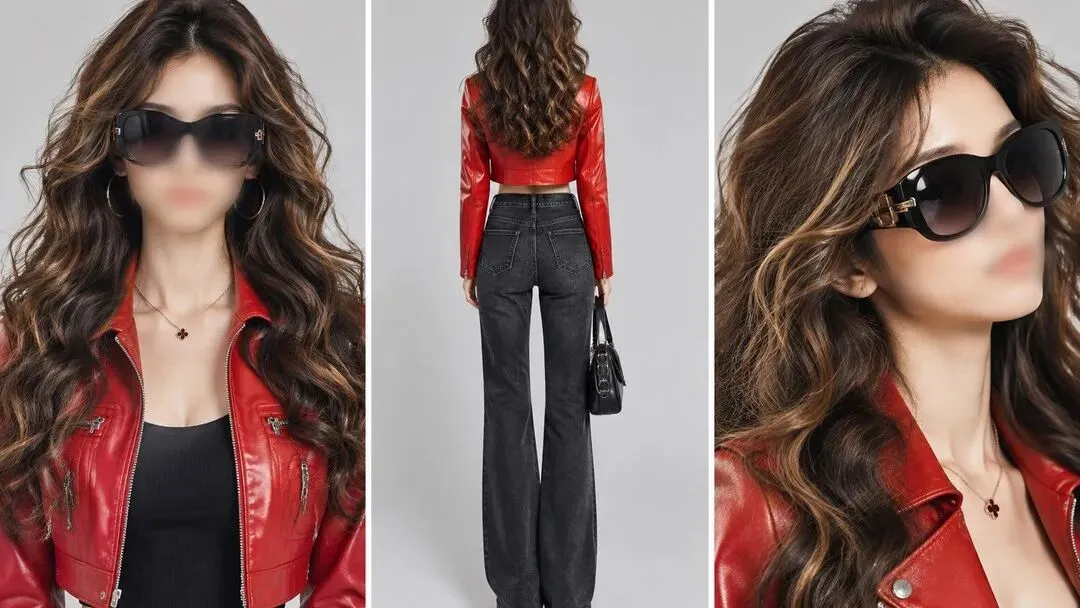
女二角色卡,正面虚化、背面全身、右侧近景
女二的角色卡做三格。左边正面,脸故意虚掉,只留轮廓。中间背面全身,看衣服和发型。右边近景,脸同样虚着,看的是发型、眼镜和配饰。
正面那张为什么要把脸虚掉,我一开始也没想明白。后来懂了,这张卡要交代的是身形、比例和穿搭,脸可以另外单独去锁。
04
PART
男主女主,脸和身形分开锁
LOCK FACE AND BODY
最高档的两个角色,做法和前面都不一样,要出两张图。
一张是近景上半身,管面部细节。
另一张是全身,不带面部细节。管比例和穿搭,保证远景、全身镜头里的人和近景是同一个人。
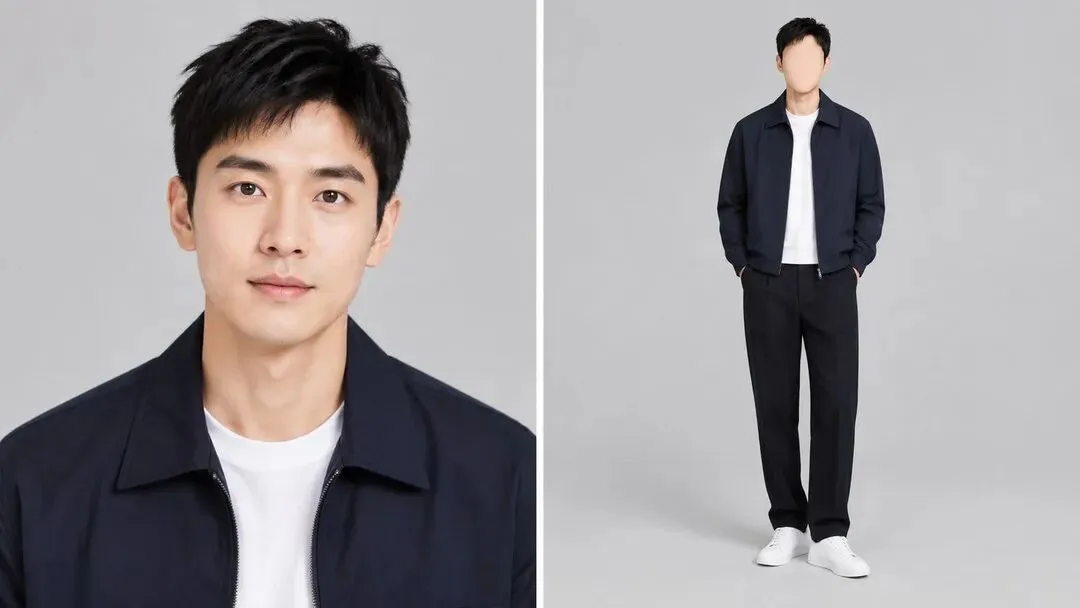
男主,左边锁脸,右边锁身形
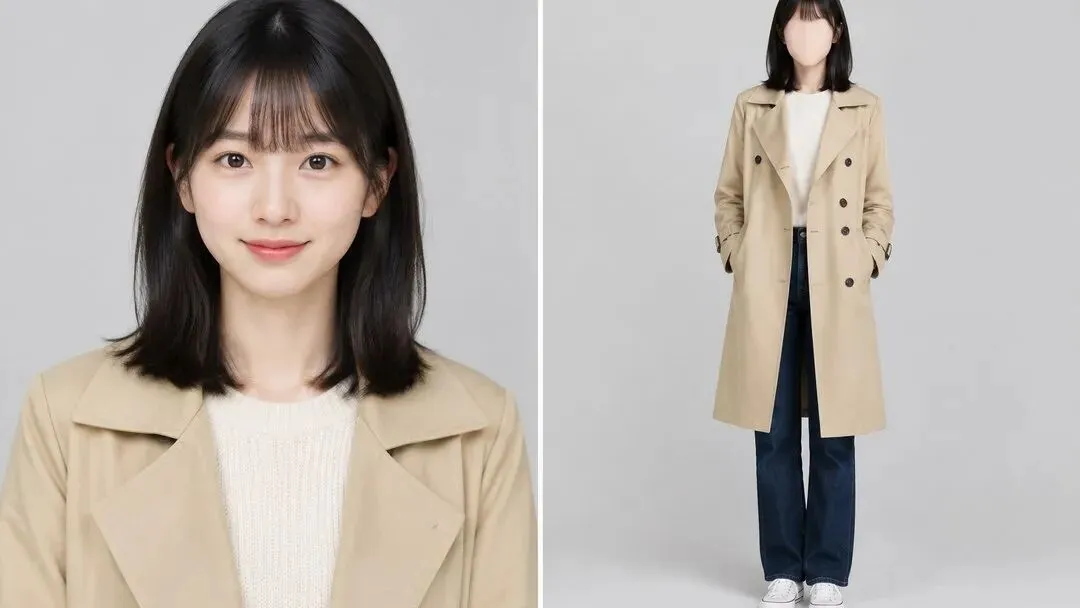
女主,同一套做法
说个我自己的感受。以前做角色,我总想在一张图里把什么都交代清楚,结果哪一样都不够准。拆成两张之后反而好办了,脸归脸,身体归身体。
05
PART
同一个角色换状态,要单独再做
ONE STATE ONE SHEET
这里有个坑,那篇专门点过。
女主在戏里前后状态不一样,比如前一幕背包,后一幕不背。这种情况不能指望模型自己脑补,要单独再做一张。
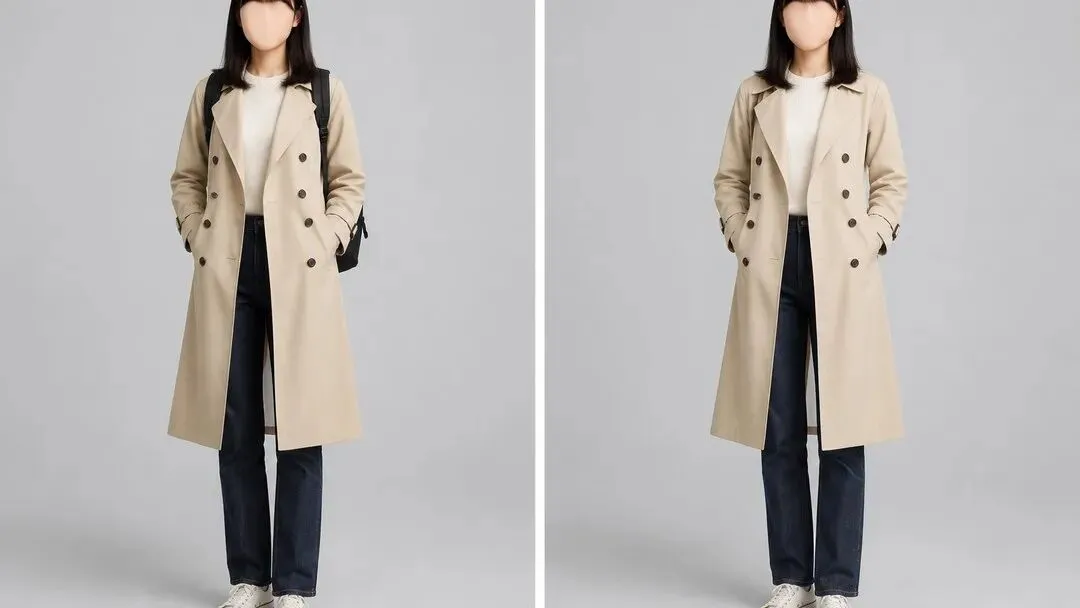
同一个人,同一个姿势,同一个机位,只差肩上那个包
别嫌这一步麻烦。AI视频里最容易出戏的,就是这种小东西前后对不上。上一幕包在肩上,下一幕包没了,观众立刻就跳出来了。
同样的道理,女主换了场景、换了季节、换了衣服,每一种都要重新出一张近景加一张全身。
角色资产这件事,是按状态数出来的,不是按人头数出来的。
06
PART
场景也是资产,最容易漏掉
THE PLATE TOO
顺着上面再聊一句。
大家做角色图的时候,特别容易把场景漏掉。
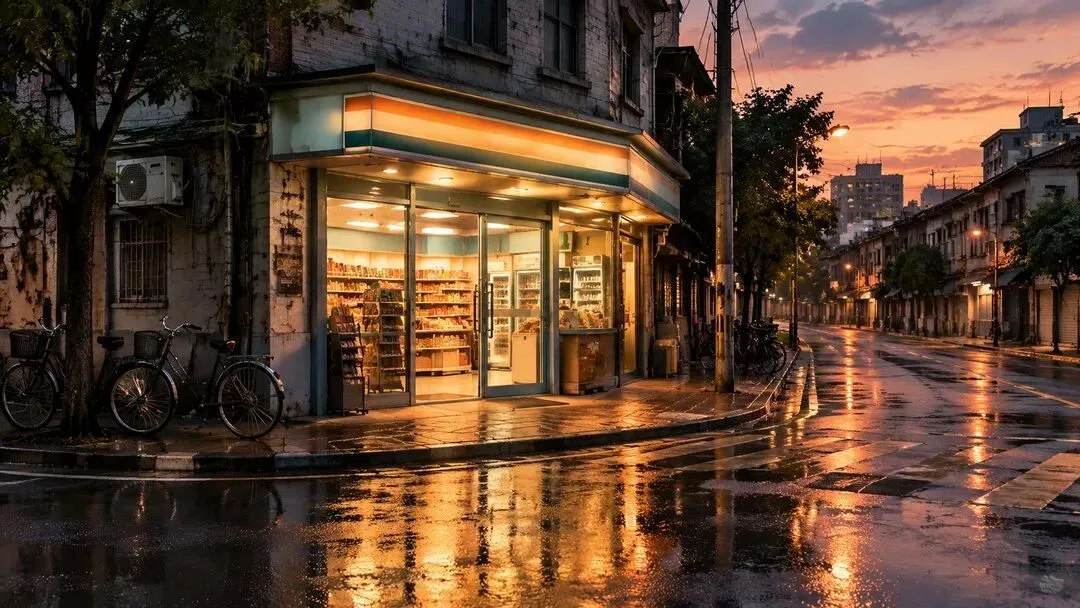
便利店门口的空镜,一个人都没有
同样的故事里,这个街角傍晚是什么光,店里的灯从哪儿透出来,湿地上反的是什么颜色,先定下来。
它的用处是给后面的镜头打底。人物站在哪、光从哪边来、地面反什么色,都有个准了。不然每一段单独生成,光的方向都能打架。
空镜做起来比角色省事得多,随手就出了。但它省下来的麻烦一点不比角色少。
END
END
顺序变了
ORDER CHANGED
我把这套图跑完,最大的感受不是省了多少时间。
是顺序变了。
以前做AI视频,先想清楚剧情,再回头补资产。补资产这一步最枯燥,也最容易拖着不做,拖到最后就凑合了。
现在这两件事可以揉在一起。你写剧情、写提示词的时候,顺手就把这场戏要用的图出掉了。分档的逻辑一清楚,甚至连想都不用想,最低档出一张,最高档出两张,中间那档看戏份。
我做了三十年设计教育,有一条体会放这儿说。我们这行做东西,习惯了每个部件都做到位,一张图恨不得改二十遍。放在单张作品上,这是本事。放在一条视频上,就是灾难,因为你永远做不完。
分档这件事教的是另一种判断,哪儿必须精确,哪儿差不多就行。
回到开头那堵墙。它其实不是一道技术墙,是一道判断墙。你分得清哪张脸重要、哪张脸不重要,这堵墙就绕过去了。
分档不是偷懒,是把力气花在观众真正会看的地方。
我是柳老师,一个把 AI 当同事用了三年、也踩过三年坑的设计教育老兵。这里只写我自己跑通过的路子。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING