ARTICLE · 1102812
写中文技术文档、产品文案和界面文案,这个Skill专治AI的空话和翻译腔
你让AI写一份中文产品介绍,它会写得很顺——「全新升级的智能化解决方案」,「打通全链路,为企业赋能」,读完什么信息也没留下。你再让它写接口文档,Invalid 翻成「非法」,Unauthorized 翻成「未授权」,中英文之间没有空格,标点用的还是英文逗号。
这是一个刚在GitHub上一个中文技术文档写作Skill想解决的事。定位很明确:面向中文技术文档、产品文案与界面文案的写作 Skill。装上之后,你的 AI 工具在写、改、校对这三类中文内容时会多一套约束——哪些词是空话、哪些直译是错的、中外文之间该怎么留白,以及一条最要紧的:改写时不许改变事实。
它挑的不是文风问题,是三类高频毛病
它不教你怎么写得有感染力,专治三件很具体的事。
一是空话。 仓库里有一份黑话清单:赋能、抓手、闭环、沉淀、对齐、拉通、打通、洞察、心智、链路、兜底、落盘、透传。处理方式不是禁用,而是要求写清楚这个词到底指什么动作——赋能改成「提供」,落盘改成「写入文件」,透传改成「原样传给下游」,闭环改成「完整流程」,或者干脆列出开始、处理和完成的条件。
二是机械直译。 这在接口文档上尤其要命。它的做法是不给英文状态词排唯一的中文对应:Success 可以是「已完成」、「已处理」或「请求成功」,取决于接口里的真实语义;Invalid 不默认翻成「非法」;把 Unauthorized 一律翻成「未授权」也是错的,这个错的实际含义往往是根本没登录,而不是权限不够。文档里配了一句挺实在的话:先确认状态在当前接口中的真实含义,再选择中文。
三是排版。 中英文和数字之间要不要空一格,用不用直角引号「」而不是弯引号,日期写「2026 年 9 月 29 日」还是「2026年9月29日」。这些在中文技术写作里长期没有统一说法,它给了一套,而且每条都配了正反例对照表。
最值钱的一条,和文风毫无关系
翻遍整个仓库,最重的那条规则既不关于空话也不关于排版,而是关于事实。
改写时不得改变或补造事实。不新增原文没有提供的日期、数字、时限、能力和 SLA,不删除前置条件和失败处理,不把「可能」「通常」「建议」改成确定结论。信息不够的时候保留原意,或者明确标记待确认,不许自己补齐。
这条被提到最高优先级是今年 8 月的事。作者在当时的合并说明里写得很直白:之前的版本可能会引入原文没有的日期和 SLA 数值,还把某个具体项目的约定混进了通用规范。八月的更新把「事实保真」排在「表达优化」前面,同时把 SKILL.md 从 481 行砍到 163 行,详细规则拆成四份按需读取的参考文件。
文件膨胀到 481 行,模型不会更遵守它,只会读到一半开始漏。真正影响输出质量的是优先级排序,不是条目数量。对比那些教你「写得更漂亮」的提示词——它们把风格排在最前面。这份 Skill 的第一句是:准确先于修辞,清晰先于热闹。
它不做什么,比它做什么更值得看
这份 Skill 最特别的地方,是清楚地写出了自己放弃的部分。
它列了一份「依赖语境、不应由检查器自动替换」的词:场景、生态、体系、路径、触点、卡点、布局、矩阵、颗粒度、复盘、梳理、输出、提炼。理由很直白——这些词不是错,只是容易被滥用,硬改会把本来对的句子改坏。错词那栏也是同样做法:「阀值」是确定的错,改成「阈值」;「登录系统」要结合语境,因为「登陆月球」并没有错。
自动检查的结果分三档:error 是高度确定的错误,默认让检查失败;warning 是依赖语境的可疑表达,需要人判断;style 是项目自己的风格偏好。不是所有 warning 都会让 CI 挂掉,除非主动开严格模式。
它借鉴了英语技术文档的受控语言标准,但反复声明只是借鉴思路,不表示符合该标准,并且明确指出英语的受控词典和句长规则不能直接移植到中文。
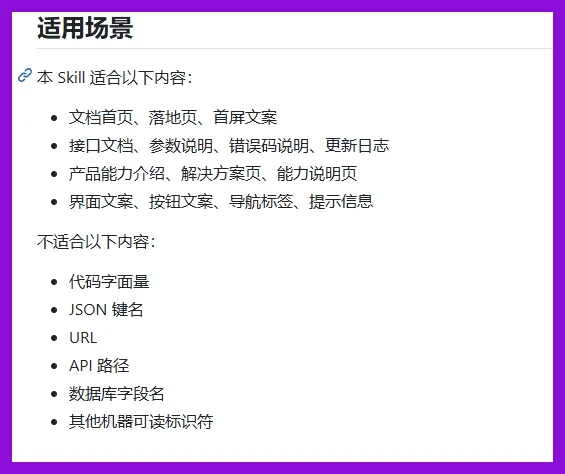
连代码字面量、JSON 键名、URL、API 路径、数据库字段名都被排除在外,改写时一律不碰。
适用边界同样写死了:如果写的是公众号推文、小红书文案或者故事性内容,这套规则明确说别套。它是为技术文档、接口说明、产品文案和界面文案设计的,用在营销文案上会写得很干。
一个 AI 写作规则愿意主动划出这么多「别管」,比它那几十条正面规则更能说明成熟度。
教程演示:装到OpenCode里,全程不用碰终端
这个 Skill 的门槛比你想象的低——它不是软件,就是一个装着 Markdown 的文件夹,要做的是把它放到 AI 工具能读到的地方。
最省事的办法:让 OpenCode 自己装
在 OpenCode 的对话框里直接说:
请把这个 Skill 安装到用户级技能目录:
https://github.com/Fenng/Tech-Doc-Style-Chinese
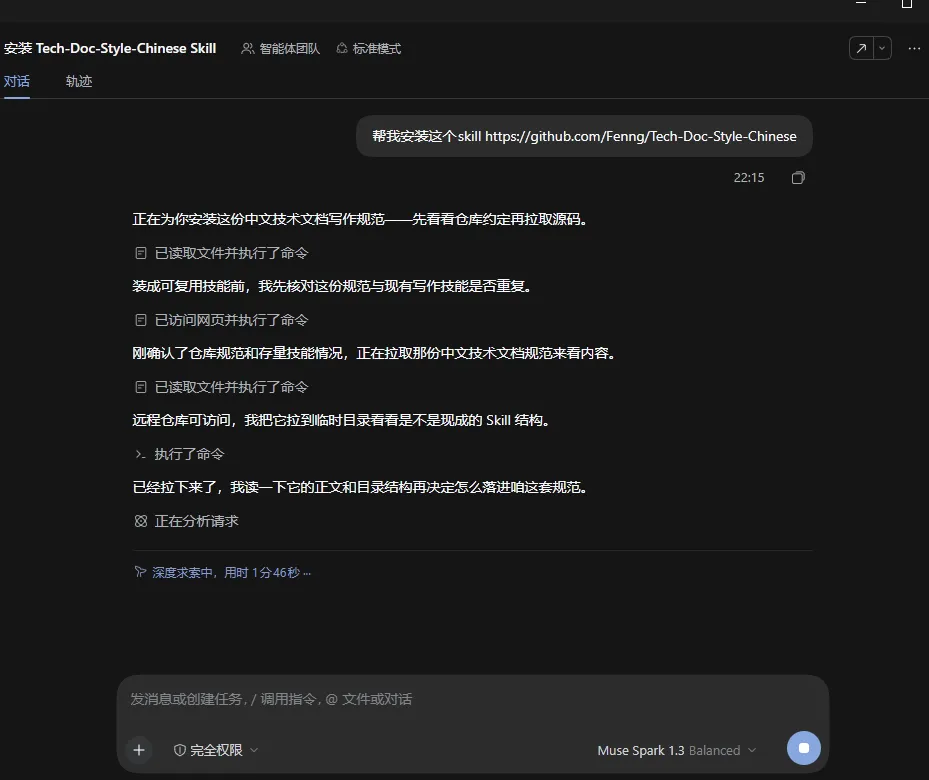
OpenCode 有终端能力,它会自己把仓库拉下来,放进用户目录下的 .config/opencode/skills/ 里。
装完之后新开一个会话,让它确认一下「列出你目前可用的技能」,看到 tech-doc-style-chinese 出现在列表里就算成功。技能清单是会话开始时载入的,当前这个会话里多半还看不到。
不想让它自动动手,就手动复制
浏览器打开仓库主页,右上角有个绿色 Code 按钮,点开选 Download ZIP,文件会下成一个压缩包。解压后你会看到一个 tech-doc-style-chinese-main 的文件夹,这个文件夹就是全部内容。
然后在用户目录里找到 .config 文件夹(Mac 上可能需要按 Command+Shift+G 输路径才能看到隐藏文件夹),进去找到 opencode 文件夹,在里面新建一个叫 tech-doc-style-chinese 的文件夹,把刚才解压出来的内容整个复制进去。复制完的样子应该是在 tech-doc-style-chinese 里面直接能点开看到 SKILL.md,而不是多套一层目录。同样新开一个会话让它列技能,看到名字出现就成了。
别的客户端路径
同一套逻辑换目录就行:Claude Code 放在用户目录的 .claude/skills/ 下,Codex 放在 .codex/skills/ 下。OpenCode 官方文档确认过,这三个位置都会被发现,目录名必须和 SKILL.md 里声明的名字一致,而且只能用小写字母、数字和连字符——tech-doc-style-chinese 符合要求。
还有个常见状况:Windows 用户有时会遇到权限弹窗,那是系统在拦你往用户目录里写东西,正常允许就行。
装好之后,先拿一段真东西试
别一上来就让它写新文档。找一段以前写过、你自己也知道不够好的文案,让它改。它分四种模式——撰写、改写、校对、审阅——其中改写和审阅最容易看出差别。直接这么说:
用 tech-doc-style-chinese 把下面这段改得克制一点,不要增加原文没有的信息:
然后粘一段熟悉的文字。
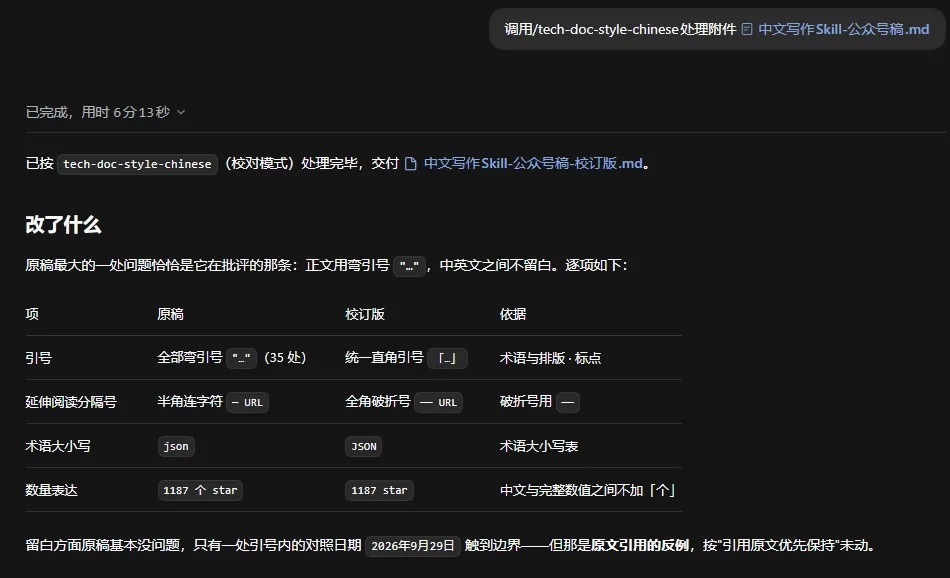
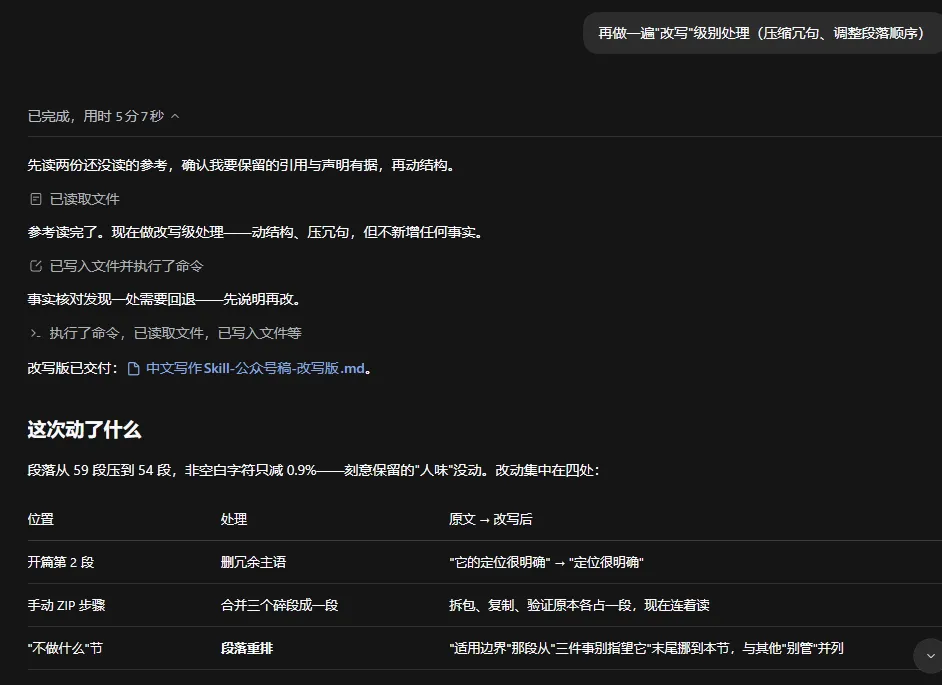
想看它更狠的一面,就专门拿接口文档试。给它一段带 Bad Request、Unauthorized、Invalid 的错误码说明,看它会不会老实问实际语义,而不是直接翻成「请求错误」「未授权」「非法」。它没问,说明规则没吃进去。
它还自带两个零依赖小工具,一个扫文案里的高频问题,一个把中文段落里手动断开的行拼回成一段。第二个工具解决的是一个很少有人注意的问题:中英混排的段落一旦硬换行,某些渲染器会在断点处多吐或吞掉一个空格。
两件事别指望它
说两个诚实的限制。
它改不了模型本身的语言倾向。 装上之后,模型想写「赋能」的时候仍然可能想写,只是规则会拦住一部分。这是概率问题,不是开关。别指望装完就百分之百生效。
它只管可见正文。 代码、路径、字段名、命令、配置项一律不碰——这是对的,但也意味着不能指望它帮你整理接口的字段命名。
我的判断
它没有试图教模型怎么写漂亮,这点和市面上大多数写作提示词正好相反。真正有价值的是那份「不做什么」的清单——知道哪些词不能自动替换、哪些错误不能顺手改、哪些标准不能声称符合,这份克制比规则本身稀缺得多。
如果每天的工作里有相当一部分是审阅 AI 生成的中文,或者在给团队写文档,值得花十分钟装上试试。如果压根不写中文技术内容,它没什么用。
项目资源
想深入了解可以看看这些:
- 项目主页 —— https://github.com/Fenng/Tech-Doc-Style-Chinese
- 技能入口 SKILL.md(规则原文,建议直接读一遍)—— https://github.com/Fenng/Tech-Doc-Style-Chinese/blob/main/SKILL.md
- 术语与排版参考(黑话清单和正反例最全的部分) —— https://github.com/Fenng/Tech-Doc-Style-Chinese/blob/main/references/terminology-and-typography.md