ARTICLE · 1106654
AI 读长文就崩溃?AMD 开源方案砍掉 98% 显存,让 200 万 tokens 成为现实
你让 AI 读一本 500 页的技术手册。
读到第 300 页,它忘了第 50 页讲什么。你再追问,它一脸茫然地给你编一段看似合理的答案。
这不是模型笨。是它的“工作记忆”不够用。
每次 AI 处理长文本,背后都在疯狂消耗一种叫 KV cache 的显存。文本越长,显存越爆,直到系统直接崩溃。
但 AMD 刚刚发布了一个开源方案,把这个瓶颈砍掉了98%。
它叫 Zebra-HyLo。不是重新训练一个大模型,而是把一个普通的 LLM“升级回收”成能处理200 万 tokens的长上下文怪物。别人花 400 倍的数据量,都没做到它这个效果。
今天我们来聊聊,为什么“少即是多”在 AI 世界里突然成立了。
先搞清楚一个基础问题,为什么 AI 读长文会崩溃。
你用过 ChatGPT 或者 Claude 就知道,对话太长之后,模型会“忘记”前面的内容。这不是幻觉,是物理限制。
Transformer 架构每次处理文本,都需要为每个 token 存储一组中间状态,叫做 Key 和 Value 矩阵。这些矩阵合起来就叫 KV cache。模型在生成下一个词的时候,需要不断回头查阅这些缓存,才能保持上下文连贯。
问题在于,KV cache 的大小跟文本长度成正比。文本翻一倍,显存翻倍。
拿 Llama-3.2-3B 举例,这个模型在 MI300X 显卡上跑到 64K tokens 就内存溢出了。64K 听起来不少,大概相当于几万页文档。但你想让它读完一整个代码库,或者处理一份几十万字的技术规范,根本不够用。
这就是为什么你的 AI 读不完那本 500 页手册。不是算力不够,是内存装不下那些中间状态。
那怎么解决?
两条路,一条都不完美
业界目前有两个方向。
方向一:压缩 KV cache
比如 DeepSeek 搞的 MLA(Multi-head Latent Attention),把 Key 和 Value 投影到一个低维空间,缓存体积大幅缩小。Google 的 GQA(Grouped-Query Attention)也类似,让多个注意力头共享一组 KV,减少冗余存储。
压缩有效,但治标不治本。你压得再狠,KV cache 还是随文本线性增长。10 万 tokens 装不下,100 万 tokens 照样爆。
方向二:换架构
传统 Transformer 的注意力机制,每个 token 都要跟前面所有 token 算一遍关系,复杂度是平方级的。有人就想了,能不能用别的序列建模方式替代?
Mamba 和 Gated DeltaNet(GDN)就是这类尝试。它们属于线性注意力模型,用固定大小的循环状态处理序列,内存不随文本长度增长。不管文本是 1 万 token 还是 100 万 token,内存消耗恒定。
听起来完美?问题是,这类模型在精确检索上打不过注意力机制。你让它从 100 页文档里找一个具体数字,它可能给你返回一个“大概”的答案。
压缩治标,换架构丢精度。
有没有办法两个都要?
Zebra-HyLo,“升级回收”而不是“推倒重来”
AMD 的思路很有意思。它没有从头设计一个新架构,而是把现有的 Transformer 模型“改造”了。
这个方案叫 Zebra-HyLo,全称 Hybrid Long-context。核心动作是把一部分 Transformer 层替换成更高效的组件,同时保留原始模型已经学到的知识。
AMD 管这叫 upcycling,升级回收。你把它理解为“旧楼改造”就行。地基还在,结构还在,但内部换成了更节能的系统。
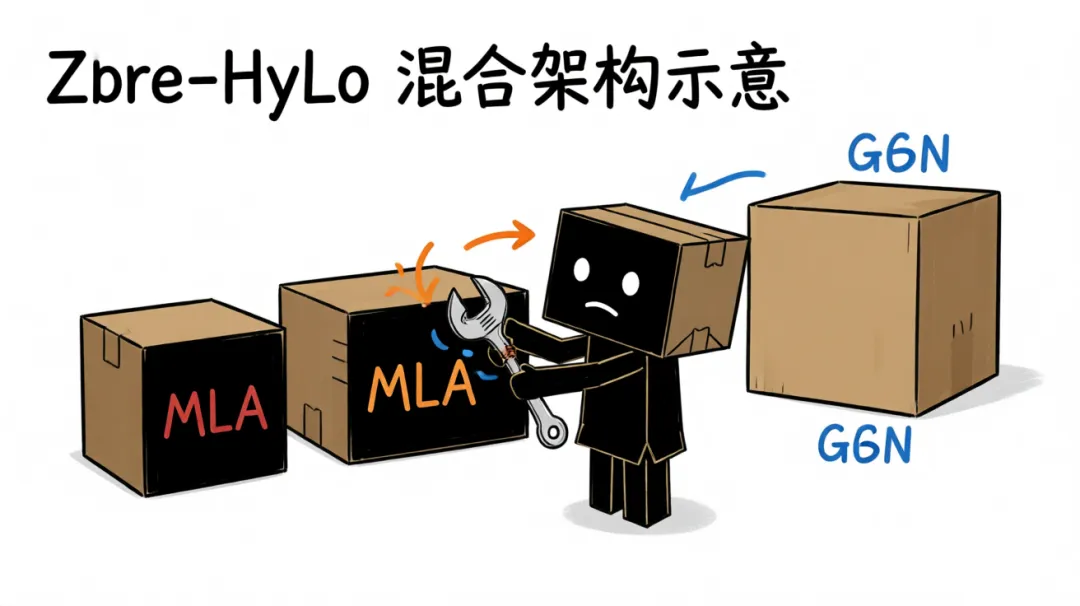
具体怎么改?以 HyLo-Llama-6MLA22GDN 为例。
原始 Llama-3.2-3B 有 28 层全注意力 Transformer。改造之后:
• 6 层变成了 MLA • 22 层变成了 GDN
MLA 提供精确的 token 级检索能力,通过低秩压缩把 KV cache 压到原来的几十分之一。GDN 不使用 KV cache,用固定大小的状态处理序列建模,专门负责长距离依赖。
两者一配合,效果是这样的:
| 2% | 削减 98% | ||
| 200 万 tokens | 32 倍扩展 |
这个数字什么概念?原来读到 64K 就崩溃的模型,现在能稳定处理 200 万 tokens,相当于 3000 页文档,或者一个中型代码库的全部代码。
关键是,模型没有“失忆”。因为大部分知识是从原始 Transformer 继承过来的,只是推理方式变了。
三层压缩,刀刀见血
为什么能砍掉 98%?我们来算一笔账。
第一刀,架构替换
28 层 Transformer 变成 6 层 MLA 加 22 层 GDN。GDN 层完全不使用 KV cache,直接砍掉 78.6% 的层。
第二刀,低秩压缩
剩下的 6 层 MLA,通过低秩投影把 KV cache 压缩到极小体积。DeepSeek 早期研究显示,MLA 单独即可在其层上实现 81% 的压缩。
第三刀,混合调度
MLA 层和 GDN 层各司其职,精确检索和长程记忆分离处理,避免了冗余计算。
三刀下去,98% 的显存需求蒸发了。
但这里有一个关键问题,哪些层该换成 MLA,哪些该换成 GDN?总不能随机分配。
AMD 用了一个叫敏感度分析的方法。简单说,就是逐层测试原始 Transformer 对 KV cache 压缩的敏感程度。敏感度高的层,说明它承担的任务复杂,需要精确注意力,就分配给 MLA。敏感度低的层,处理的是更宏观的序列关系,交给 GDN 就够了。
这个分配策略,决定了最终架构的性能上限。
一个反常识的发现
架构改造只是第一步。AMD 在实验中发现了一个很多人会忽略的问题。
混合架构本身,不会自动继承长上下文能力。
什么意思?你把 Transformer 改成 MLA 加 GDN 的混合体,内存效率确实上去了。但如果你只在 8K 上下文长度上训练,模型在 64K 任务上照样抓瞎。
数据为证。HyLo-Llama-6MLA22GDN 如果只在 8K 训练,RULER-8K 得分 55.1,看起来还行。但 RULER-64K 直接掉到0.8。几乎等于零。
换成两阶段训练,先 8K 再逐步扩展到 64K,同样的架构,RULER-64K 飙到46.3。
| 46.3 | 近60倍 |
差距是 近60倍。
长上下文能力不是架构给的,是训练给的。架构只决定了效率上限,训练才决定能力边界。
很多人以为换个架构就万事大吉了。Zebra-HyLo 的实验告诉你,没那么简单。你必须显式地教模型如何处理长上下文,它才能真正处理长上下文。
10B 对 400B,效率才是王道
还有一个数字值得拿出来说。
HyLo-Qwen-1.7B 用了大约10B tokens的训练数据,在 RULER-64K 基准上显著优于 JetNemotron。JetNemotron 用了多少?400B tokens。
40 倍的数据量差距,HyLo 反而赢了。
这不是偶然。upcycling 策略的核心优势在于,它不需要从头教模型“什么是语言”。基础模型已经会了。HyLo 只需要通过蒸馏,把长上下文能力注入到新的混合架构里。
这就像让一个成年人学开车,和让一个婴儿长到能开车的年龄。前者几周搞定,后者要等十几年。
10B tokens 训练出的模型,在长上下文任务上打败了 400B tokens 训练的竞品。这不是说数据不重要,是说方法比数据量更关键。
AMD 的算盘
聊完技术,看看商业逻辑。
AMD 在 AI GPU 市场的份额大概在 5-7%。NVIDIA 吃了 80%。正面硬刚训练算力,AMD 没什么胜算。
但推理是另一个故事。
推理阶段对 CUDA 生态的依赖远低于训练。企业部署推理服务,更关心成本、效率、显存利用率。这些恰好是 AMD 能发力的地方。
Zebra-HyLo 的战略意图很清晰:
1. 放大硬件优势:MI300X 有 192GB HBM3 显存,是 H100 的 2.4 倍。但显存大不代表用得好。Zebra-HyLo 把 KV cache 砍掉 98%,同样的硬件能服务更长的上下文,把内存优势转化为成本优势。 2. 差异化竞争:NVIDIA 擅长训练,AMD 就专注推理。推理优化对 CUDA 的依赖低,ROCm 生态的短板被绕过去了。 3. 开源生态:Zebra-HyLo 用了 Apache 2.0 许可证,代码开源,14 个检查点全部放在 HuggingFace 上,还集成了 vLLM 推理引擎。这套组合拳下来,开发者采用门槛极低。
Meta、微软、OpenAI、Anthropic 都已经在用 AMD 的 MI300X 做推理。现在 AMD 又提供了软件层面的长上下文优化,客户粘性只会更强。
不跟你拼算力,拼效率。这是 AMD 在 AI 时代的生存哲学。
200 万 tokens,能干什么?
说了这么多技术,回到最实际的问题。200 万 tokens 的上下文,到底能做什么?
• 代码库分析:一个中型项目的全部代码,大概 6 万行,约等于 200 万 tokens。你可以把整个项目丢给 AI,让它做全局架构审查、跨文件依赖分析、重构建议。不再是局部补全,是全局理解。 • 长文档处理:3000 页的技术文档、法律合同、研究报告,一次性全部读入。不用分段,不用检索,端到端理解。 • 企业级知识库:把公司的全部内部文档、技术规范、历史记录放进上下文,AI 直接做跨文档推理。传统 RAG 系统需要检索加拼接,现在可以端到端处理。 • 长对话与智能体:AI 助手在长时间多轮交互中积累的历史记录,不再因为超出上下文窗口而丢失。
这些场景的共同点是,它们都需要长上下文,而长上下文推理的成本一直高到不切实际。
Zebra-HyLo 把这个成本砍掉了 98%。原本需要 8 张卡才能跑的长上下文任务,现在可能一张卡就够了。
结语
回到开头那个问题。你的 AI 不是笨,是记性差。
Zebra-HyLo 做的事情,就是给它换了一个更大的“工作记忆”,同时让它消耗更少的资源。
10B tokens 打败 400B tokens,98% 的显存需求被砍掉,200 万 tokens 成为现实。这不是堆算力的故事,是巧劲的故事。
在所有人都喊着“更大、更多、更强”的时候,AMD 选择了一条不太一样的路。不是做得更多,是算得更精。
下次你再遇到 AI“读到一半就忘了”的情况,也许该想想,问题不在模型,而在我们让它记东西的方式。
方式变了,边界就不一样了。