ARTICLE · 1107598
2.3亿判例喂饱GPT-6!OpenAI突袭顶级律所,54%准确率震动全网
作者 | 点点· 编辑 | 阿策
法律圈迎来了一场剧烈震荡
就在最近,OpenAI 毫无预警地亮出了一张王牌,Astra for Law。
消息一出,硅谷与华尔街的法律精英圈瞬间炸锅。有人在社交媒体上惊呼:“初级律师助理(Paralegal)的好日子彻底到头了!”甚至有早期测试者向媒体直言,它的表现“已经超过了律所的资深律师和不少合伙人”。
▲ OpenAI 官方正式发布 Astra for Law
但仅仅几个小时后,舆论画风突变
有人翻出官方测试数据,指着那行数字大声嘲讽:“搞了半天,法律检索正确率才 54%? 谁敢雇一个只有一半概率说真话的律师?”
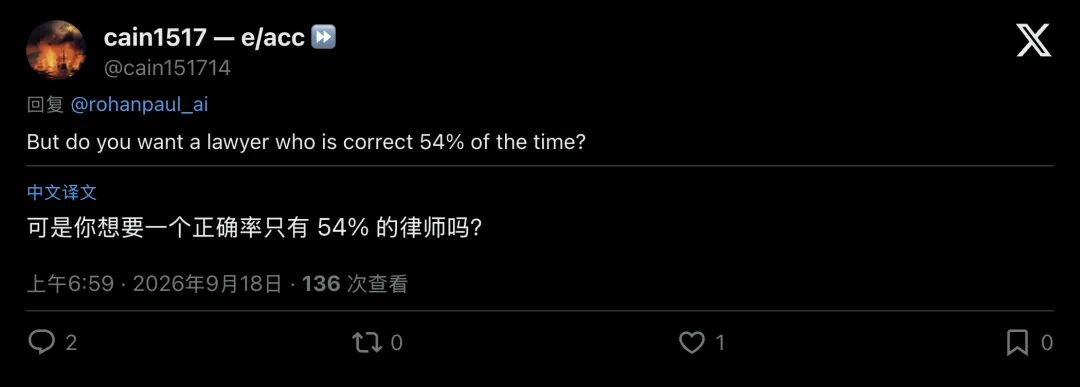
▲ 社交媒体上对“54% 正确率”的质疑与嘲讽
这到底是生产力的降维打击,还是又一场被吹破的 AI 营销泡沫?
当把这套系统的底层逻辑、评测标准与行业真相层层剥开后,你会发现:那个看似不及格的“54%”,背后藏着一个足以震动整个专业服务行业的技术真相。
0154% 的真相:为什么在法律界,“90分”比“0分”更致命?
要看懂这场争论,首先必须搞清楚:这个让全网吵翻天的 54%,测的到底是什么?
在日常对话里,AI 如果回答对了 90% 的内容,你大概率会给它打个高分。但在严苛的法律实务中,逻辑完全相反,一份“90分”的法律备忘录,往往比“0分”更致命。
想象一下:一个初级律师通宵达旦,写出了一份看似无懈可击的诉讼策略,引经据典、逻辑严密。然而,他引用的 10 个先例判决里,唯独有 1 个在半年前被巡回上诉法院推翻了。
在法庭上,这一个致命漏洞就足以让整场官司满盘皆输,甚至让律所面临委托人的巨额索赔与行业惩戒。
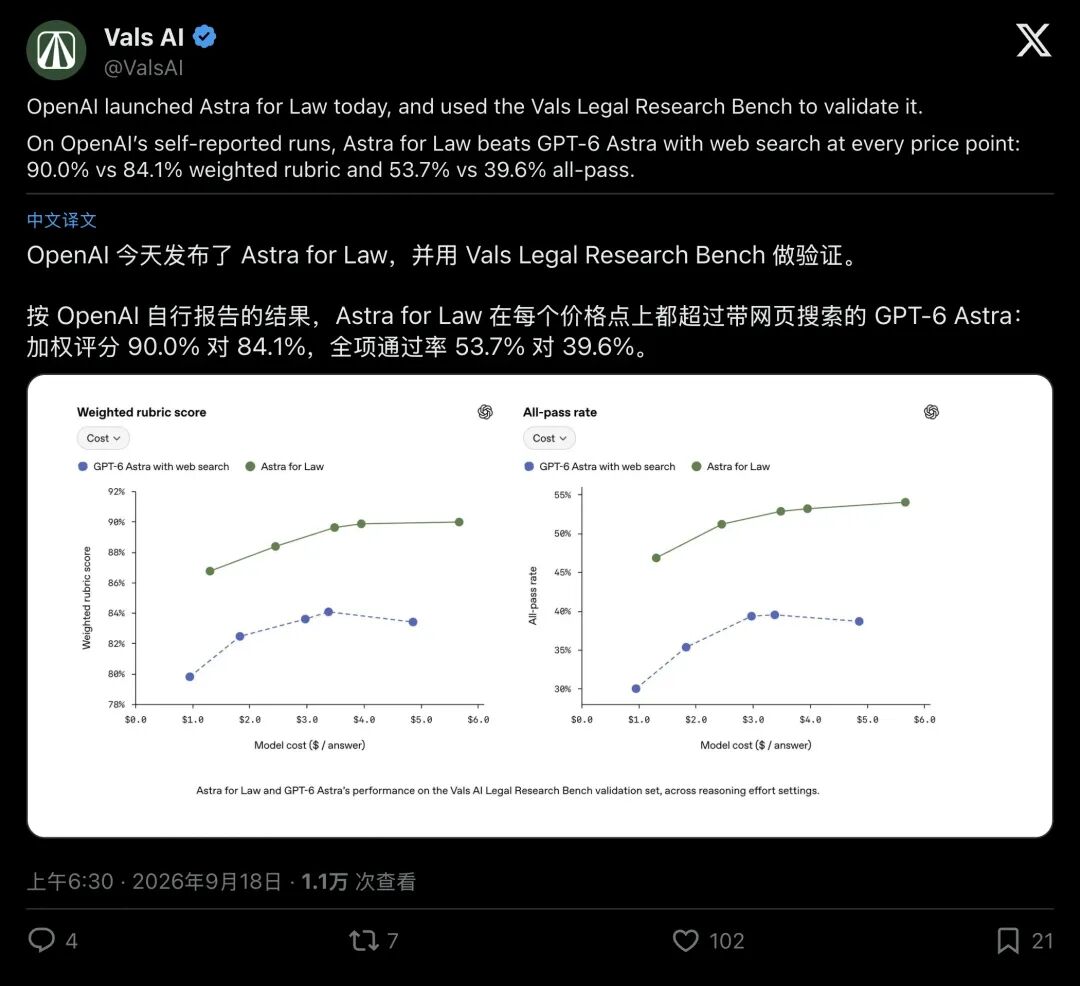
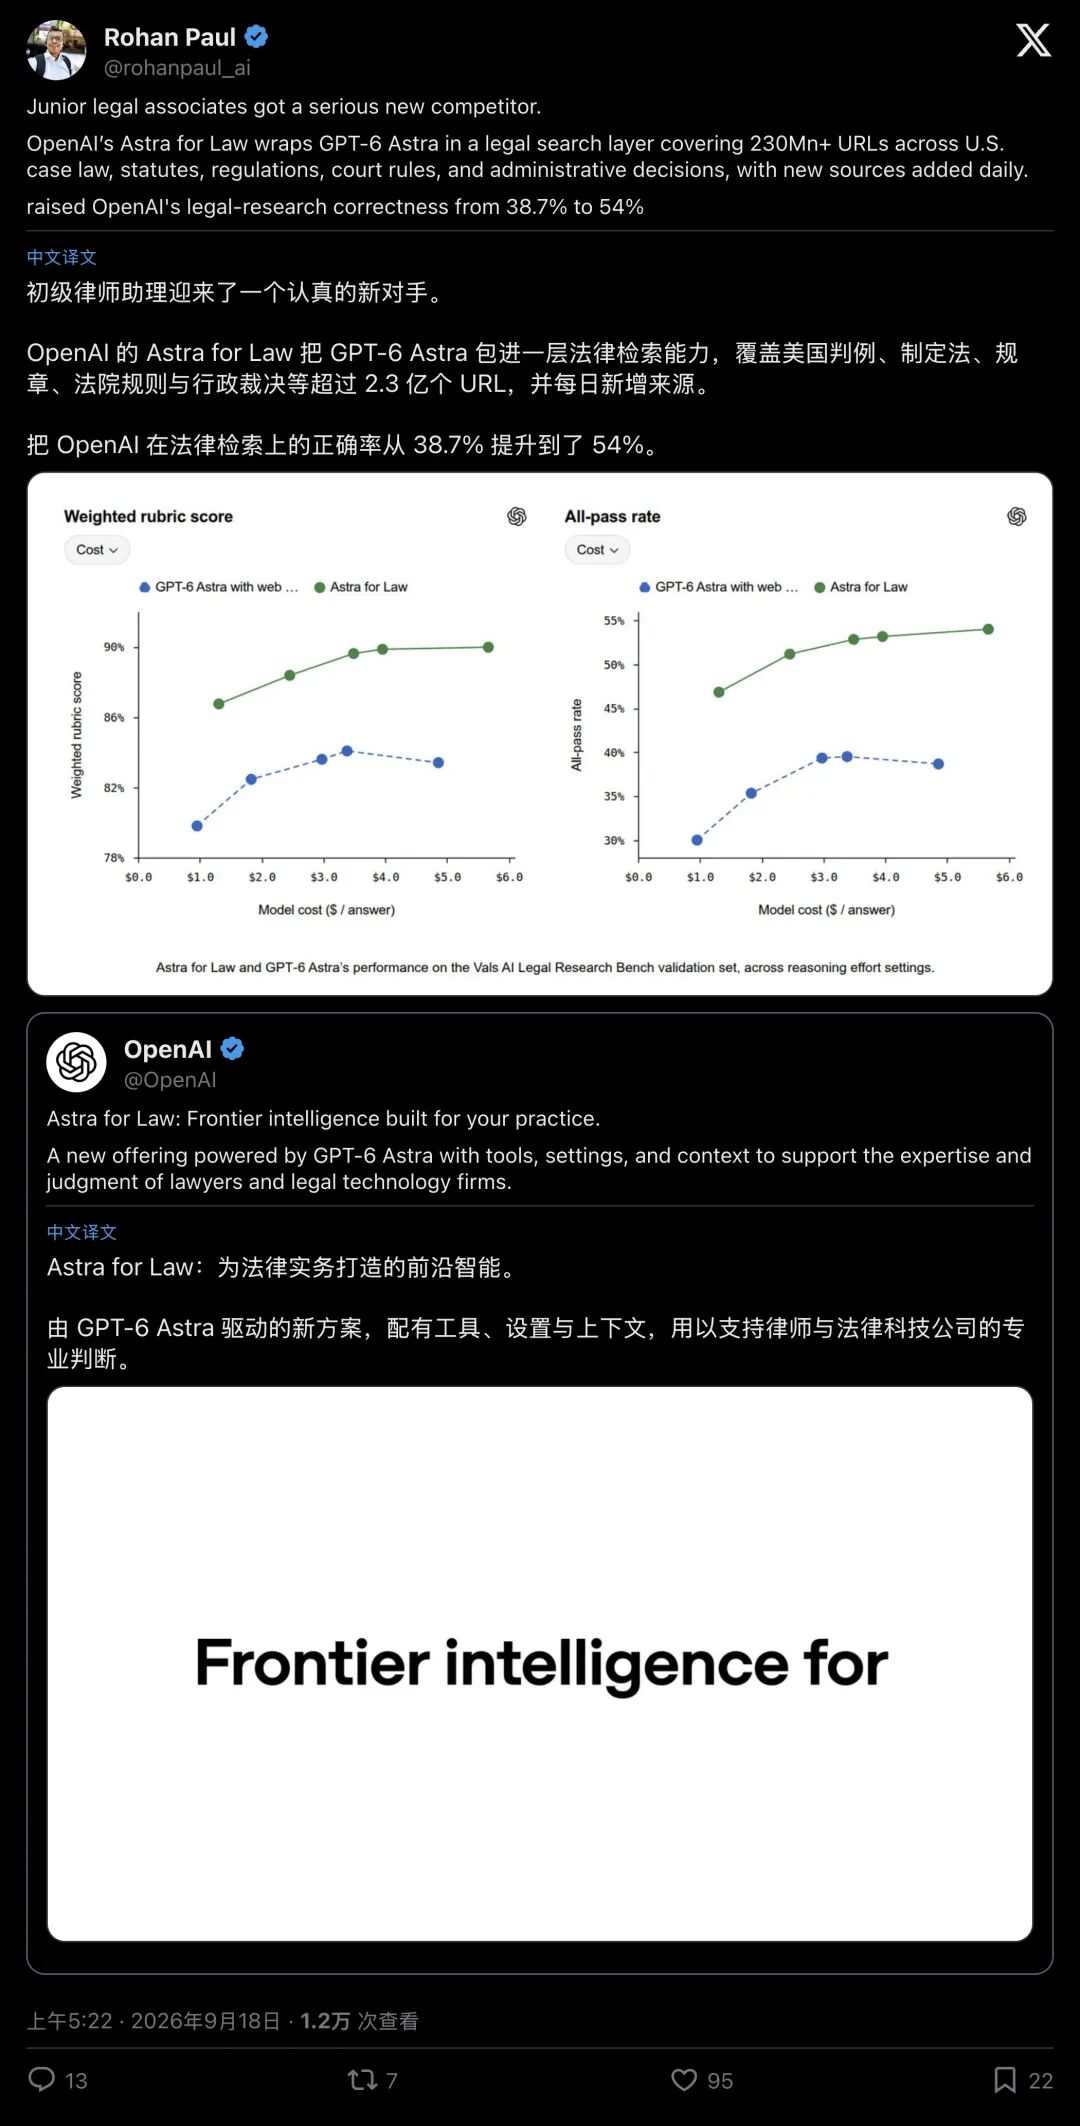
▲ 评测机构 Vals AI 公布的测试对比数据
这就是权威基准机构 Vals AI 在设计“法律检索基准(Legal Research Bench)”时的残酷哲学:全项通过(All-Pass)机制。
在这次评测中,全美资深执业律师亲手写了 200 道极其复杂的实务考题。每道题都配有严苛的“评分细则(Rubric)”,平均包含 9.35 个检查点:
控制性先例找全了吗? 裁判规则(Holding)与附带意见(Dicta)分清了吗? 对应管辖区的特殊除外条款指出了吗? 引用格式与卷册号精确无误吗?
只要有 1 个细节漏掉,整道题直接判定为 0 分。
在这套“零容忍”的严刑峻法下:
哪怕是普通版 GPT-6 Astra 挂载网页搜索,全项通过率也只有 38.7%。 而装备了专属法律武器库的 Astra for Law,直接将全对率拉到了 54.0%(加权细则得分高达 90.0%)。 检索相关判例的能力提升了 24%,关键段落命中率提升了最高 54%。
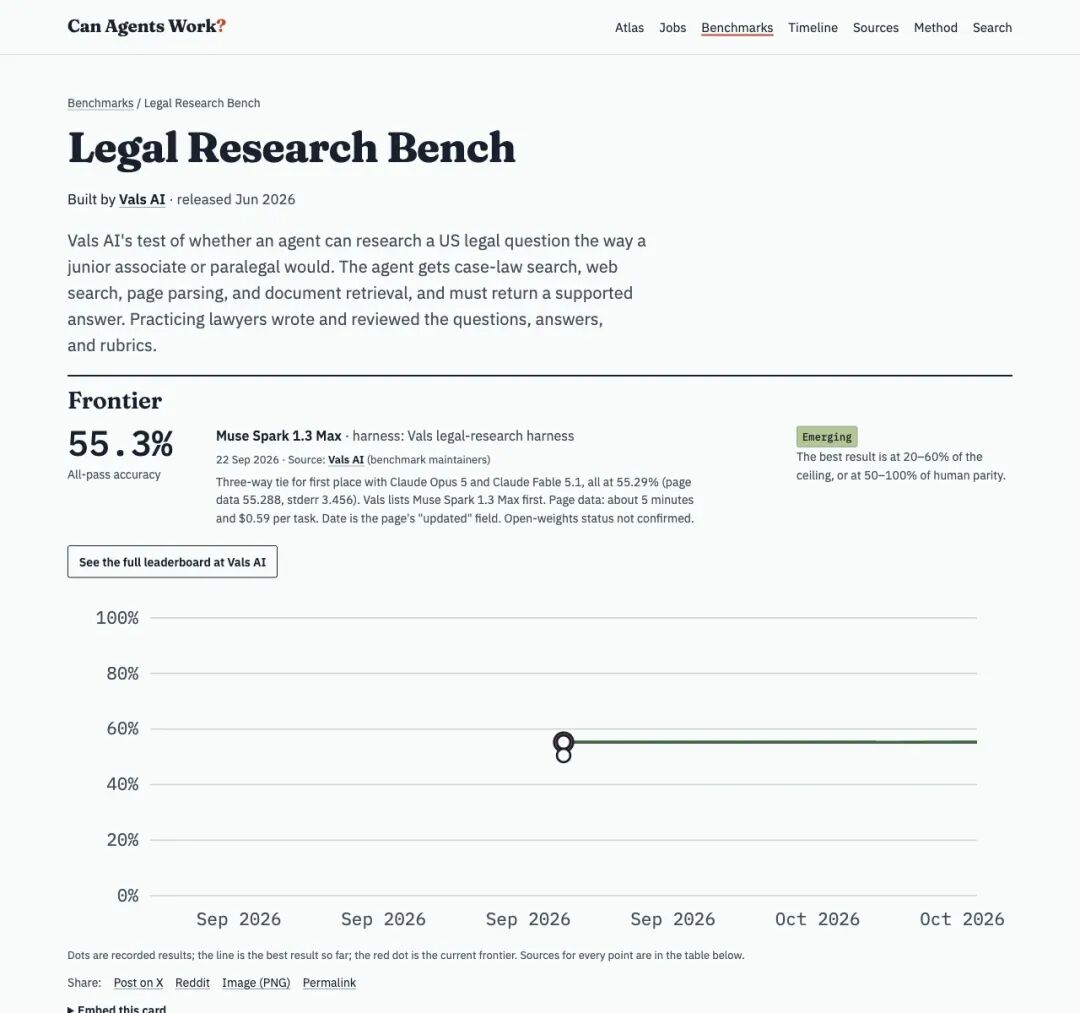
▲ Vals Legal Research Bench 公开榜单目前的前沿极限仅为 55.3% 左右
放眼全球顶尖大模型,在不公开的盲测测试集上,全球最高纪录也仅仅停留在 55.3% 左右。
这个 54% 绝非随手碰运气的胡乱作答。在毫无人工干预的前提下,AI 已经能够像成熟的初级律师助理一样,独立将一半以上的高难度案件做到全流程毫无瑕疵。
022.3亿判例装进大脑:OpenAI 打造的“超级法律挂件”
很多人以为 OpenAI 又秘密训练了一个全新的基座大模型。
事实并非如此官方给出的定位是:Astra for Law 是以 GPT-6 Astra 为底座,专门面向法律工作进行系统级配置与工具融合的“AI 法律底座”。
它的核心杀手锏,来自那座深不见底的专用检索库,Legal Search Index。
▲ OpenAI 官方展示的 Legal Search Index 界面
OpenAI 与非营利组织 Free Law Project(知名法律数据库 CourtListener 的母体)深度联手,把超过 2.3 亿个权威法律网址一口吞下,并且保持每日动态更新。
这其中包括:
- 覆盖超过 99.9% 已发表的美国先例判决
; 联邦与各州的现行制定法、行政规章与法院诉讼规则; 海量的行政裁判与官方解释。
▲ 行业研究者对 Astra for Law 架构与能力的梳理
当用户在对话框中输入复杂的跨境知识产权纠纷或反垄断审查问题时,模型会直接穿透 2.3 亿个权威信源,精准下潜到特定巡回区裁判文书的特定段落,告别了以往在互联网杂乱资讯中盲目检索的低效与偏差。
在模型选择器里,它的代号是简洁有力的 gpt-6-astra-law。
通用大模型那种“看似口若悬河、实则法条编造”的幻觉硬伤,由此被这套专用法律检索层死死套上了缰绳。
03权力与隐私的双轨制:大所狂欢,小所为何不安?
技术突破固然令人振奋,然而更让法律行业感受到寒意的,是随之而来的“准入鸿沟”与“隐私特权”。
根据官方公告,Astra for Law 首批仅通过 Trusted Access 向受邀的极少数顶级大型律所开放,Harvey、Legora 等法律科技巨头则作为首批 API 伙伴入场。
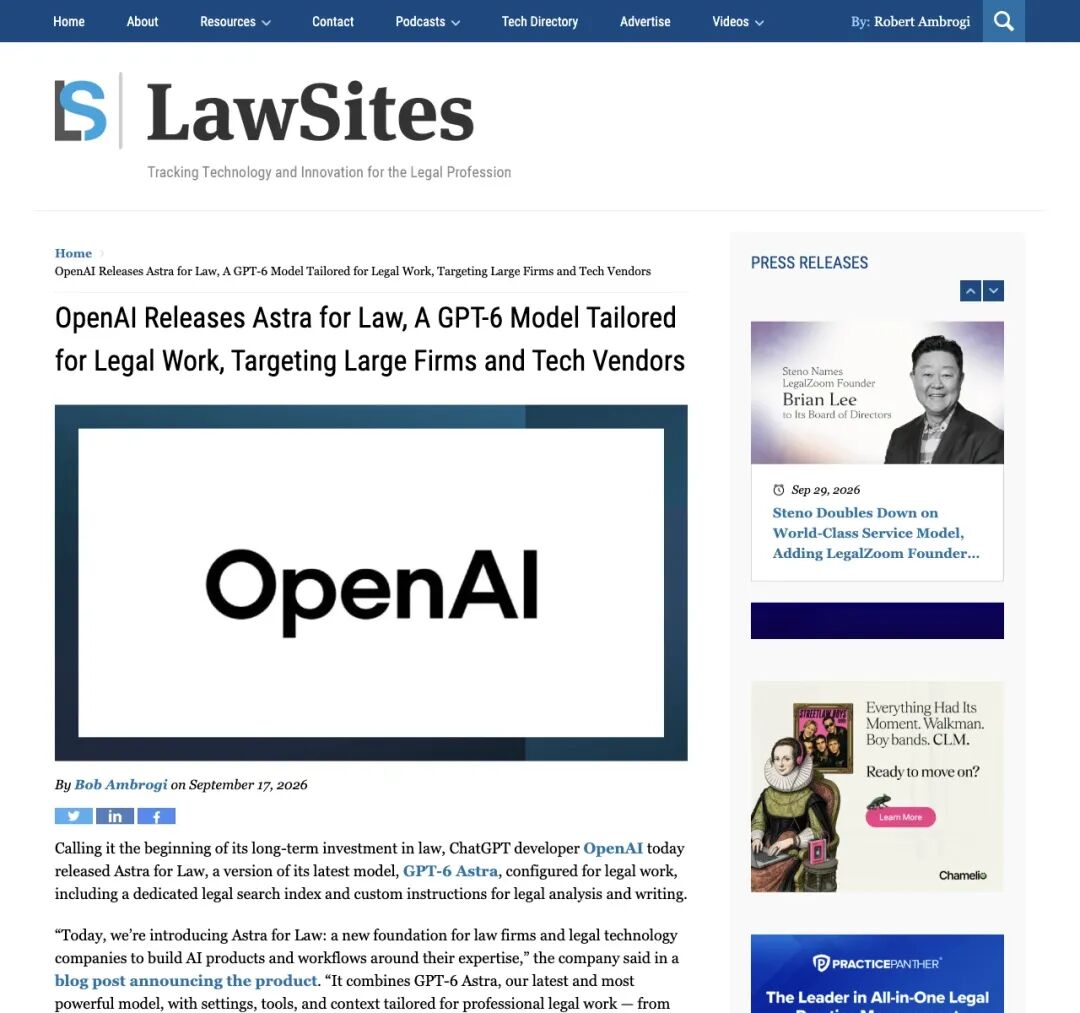
▲ 法律科技媒体 LawSites 对大所准入与行业影响的报道
更敏感的神经在于数据安全
在英美法系中,“律师-客户保密特权(Attorney-Client Privilege)”是律所生存的生命线。任何客户信息一旦泄露,律师将面临灭顶之灾。
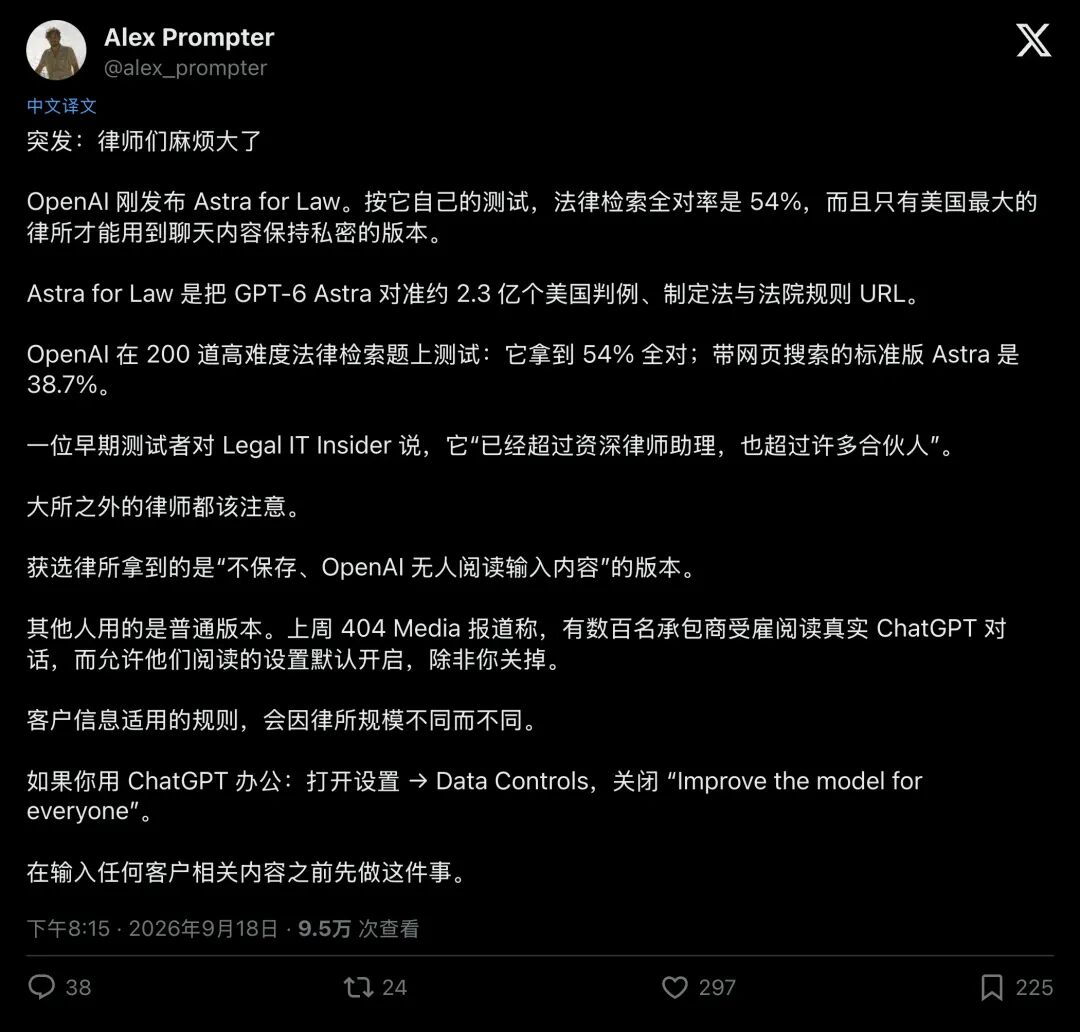
▲ 社交媒体长帖揭露的大所特权与普通用户隐私分层
据外媒与行业博主梳理,目前的规则呈现出鲜明的“双轨制”:
- 顶级大所专属
:拥有零数据保留(Zero Data Retention)通道,聊天记录不落盘,OpenAI 员工无权查看,数据绝不参与后续训练; - 普通个人与小所
:如果直接使用默认设置的网页版工具,对话数据可能进入人工复核与模型迭代池中。
科技媒体 404 Media 此前曾披露,大量数据标注员正在审阅部分通用 ChatGPT 对话。
这导致不少独立律师在社交平台上紧急呼吁:“在往对话框里输入任何客户案情之前,先去设置里关掉‘为所有人改进模型’的开关!”
AI 并没有一夜之间消灭阶级,反而用算力和安全策略,在顶级华尔街大所与普通事务所之间,筑起了一道更深的高墙。
04终局思考:人类律师真的要被取代了吗?
当一个拥有 2.3 亿法律文献、全天候秒级响应、严苛考核下全对率超过 54% 的 AI 站在面前,年轻律师们的出路在哪里?
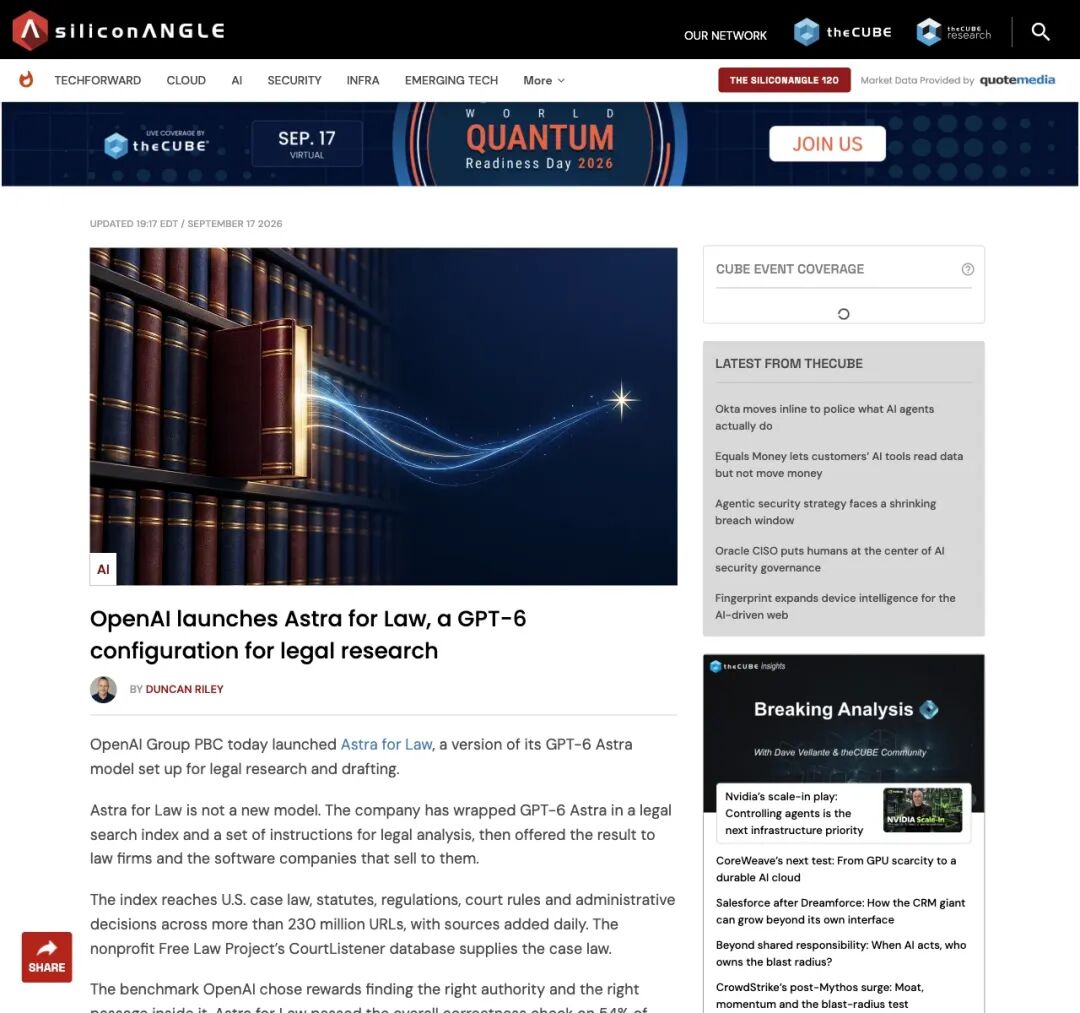
▲ SiliconANGLE 分析 Astra for Law 作为 GPT-6 专业配置的行业价值
要回答这个问题,我们需要看清法律工作的本质。
过去一百年里,一个年轻律师进入律所的前三年,往往充当着“人肉文献检索机”的角色:在成千上万页的卷宗和数据库里翻找相似先例,做摘要、挑错字、对格式。这是一种极其繁重、枯燥却又必不可少的体力劳动。
而 Astra for Law 的出现,正是宣告了“纯体力检索型”岗位的加速黄昏。
但它能够取代人类律师的终极判断吗?依然不能
正如 Vals AI 在基准测试中所揭示的技术瓶颈:当面对跨司法管辖区的先例冲突(Circuit Split)、面对法官自由裁量权极大的复杂商业博弈、面对需要洞察人性的庭审辩论时,AI 依然无法替代那个签署名字、承担法律责任的人类大脑。
OpenAI 官方在帮助文档中做出了严谨提示:在依赖任何生成答案之前,必须由专业人员审核回答与引文。
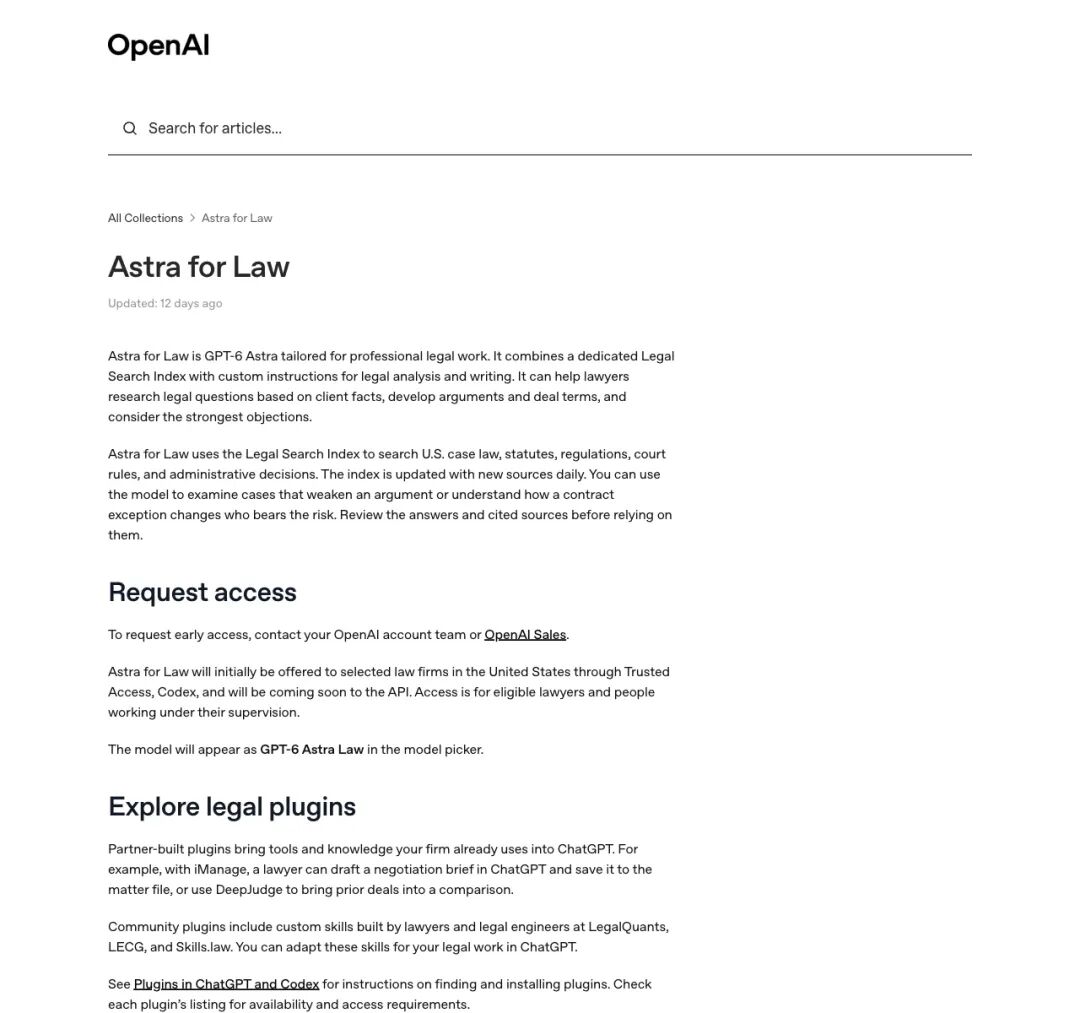
▲ OpenAI 帮助中心明确提示:使用前必须人工复核引用与结论
未来律所的分水岭愈发清晰:
那些只会做机械检索、排斥新工具的从业者,将率先面临职业生存危机; 而把 2.3 亿法律智慧装进武器库、将精力全力聚焦于商业洞察、法理架构与诉讼博弈的“超级个体”,则将掌握行业的主动权。
风暴已经席卷而来,坐在屏幕前的每一位专业人士,都已身在局中。