ARTICLE · 1111728
当 AI 开始替你行动,界面开始不再像界面
过去几十年,计算机界面一直在解决同一件事:
人怎样操作机器。
你打开 App,找到功能,点击按钮,输入参数,确认执行。
你知道文件在哪,知道功能在哪,知道哪一步该由自己完成。
但 2026 年开始,很多新产品正在把这个前提一点点拿掉。
Meta Muse、OpenAI Dots、Microsoft Project Solara,以及一批企业 Agent 产品,表面上看依然有聊天框、卡片、侧边栏和设置页;但它们共同在做的事情,已经不是“给 Chatbot 找一个更漂亮的 UI”。
它们开始让机器在你离开之后,继续替你行动。
OpenAI 对 Dots 的描述非常直接:它是一个可承担持续责任、拥有云电脑、可跨连接应用工作的常驻 Agent;Meta Muse 也把长期目标、后台行动、跨应用执行和权限控制放进了同一个产品定义里。
这意味着,未来人机交互最重要的问题,是:
“机器什么时候可以替我行动?”
“它能做到哪里?”
“它凭什么这样做?”
“什么时候必须回来找我?”
“如果它做错了,我怎样把权力拿回来?”
这不是简单地 UI 风格的变化,这是计算机第一次开始把“执行权”从界面里抽走。
而未来界面的任务,也会从“让人操作机器”,变成“让人委托、限制、监督并收回机器的行动权”。
一、未来的电脑首页,可能只剩三件事
想象一下,几年后的某个早晨。
你打开电脑。
它不再先给你二十个 App 图标,不再先给你几百封邮件,也不一定先给你一个空白聊天框。
它可能只给你三类东西。
第一类:
我在替你推进什么。
“你的竞品研究正在进行,两个新的市场变化已经进入待判断状态。”
“客户流失预警已启动,有三位客户满足介入条件。”
“下周的商务出差已经完成初步安排,有一项航班选择需要你确认。”
第二类:
昨天什么发生了变化。
“竞争对手更新了定价策略,影响分析已生成。”
“项目预算减少 10%,原计划中的两项工作被重新排序。”
“一个此前成立的研究假设,被新的数据推翻。”
第三类:
哪些地方必须由你决定。
“两个供应商都符合条件,但成本和交期存在取舍。”
“需要一次性付款 2600 美元,超过了当前授权上限。”
“任务看似完成,但系统无法确认订单是否真的提交成功。”
可以把它压缩成三个词:
Goals — Changes — Exceptions。
这看起来像一个更聪明的 Dashboard 仪表盘。
但它其实不是。
Dashboard 的前提是:人看数据,再操作系统。
而这个新界面的前提是:机器已经在替人行动,人只在关键处重新出现。
这才是 Agent Interface 和传统软件界面的根本差别。
二、2026 年发生的,不是 Chatbot 找到了下一种皮肤
如果只看视觉,这一轮变化很容易被低估。
还是输入框,还是聊天记录,还是文件上传,还是侧边栏。
但底层交互的基本单位,已经开始移动。
过去是:Message
你问一句,机器答一句。
接着是:Task
你不再问“这个行业最近有什么新闻”,而是说“帮我把这个行业过去三个月的重要变化理一遍”。
机器会自己搜索、筛选、调用工具、保存中间状态、整合信息,然后过一段时间把结果交回来。
再往前一步,正在出现的是:Responsibility 责任
不是:“帮我查一下今天发生了什么。”
而是:
“持续关注这个领域,真正重要的变化出现时告诉我。”
不是:“整理今天的邮件。”
而是:
“管理我的收件箱,只把我必须亲自处理的事交给我。”
这三者的差异,不只是任务长度。
Task 会结束。
Responsibility 不会。
Task 的状态是 Done。
Responsibility 的状态更接近:
Active、Suspended、Escalated、Revoked。启用、暂停、升级、撤销。
这也是常驻 Agent 最重要的变化。
它开始拥有长期目标、工作历史、权限边界、事件订阅、世界状态和待履行的职责。
于是,真正重要的问题变成:
它现在负责什么? 它承诺了什么? 它在等待什么事件? 它拥有什么权限? 它做了哪些动作? 它在什么情况下必须回来找我? 我怎样暂停它、收回它的权限,或者把它交给另一个人管理?
这已经不像在使用一个软件功能。
更像是在管理一个被长期委托的数字角色。
三、执行权正在离开界面
传统 GUI 的伟大之处,在于它把机器的复杂功能,变成了人可以逐步操作的对象。
窗口、菜单、文件夹、按钮、鼠标指针,本质上都在回答一个问题:
我怎样让计算机完成这件事?
路径通常是这样的:
打开 App → 找到功能 → 点击按钮 → 填写参数 → 确认执行 → 看结果
这套路径的前提是:人负责导航、选择、执行和确认。
但 Agent 正在把其中越来越多的环节接过去。
未来的路径会逐渐变成:
表达结果 → 系统理解意图 → Agent 选择工具与路径 → 机器行动 → 人只在关键处介入
微软 Project Solara 对这轮变化的表达很激进:从“打开的软件”走向“被调用的智能”,从按钮和图形界面走向意图表达,设备则成为进入长期运行智能的窗口。它提出的“just-in-time UI”,本质上是在设想:同一个 Agent 可以根据设备、上下文和交互方式,临时生成适合此刻的界面。
这意味着,最先消失的可能不是屏幕,而是 mode selection 模式选择。
今天的用户还常常需要判断:
我现在应该搜索,还是问 Chat? 应该开 Deep Research,还是开浏览器? 应该调用 Agent,还是自己操作网页? 应该进入哪一个 App? 应该选择哪一种工作流?
未来这些选择会越来越多地变成系统内部的问题。
人表达 Outcome 结果,机器决定 Execution 执行。
与此同时,App 不会真正消失。
它会从过去的“人类导航单位”,逐渐降级成未来的“机器能力容器”。
过去是:人知道功能藏在哪个 App。
未来是:Agent 知道哪个 App、工具、网站、协议、模型或服务可以完成这件事。
这不是 App 消失。
而是 App 从前台入口,退到后台能力层。
四、人类没有失去控制权,只是控制权换了位置
当机器开始接管执行,最自然的担忧是:
AI 越强,人是不是越失去控制权?
这其实把“操作权”和“行动权”混在了一起。
传统 GUI 给人很强的 过程控制。
点哪个菜单、打开哪个文件、选哪条路径、填写什么参数、执行哪个动作,都是人决定。
Agent 拿走这些过程操作后,表面看,人类似乎失去了一部分控制。
但更准确的描述是:
人类的控制权,正在从“如何做”迁移到“要做什么、做到哪里、什么情况下必须停下来”。
过去,人控制:
每一步操作; 每一个菜单; 每一次输入; 每一个执行动作。
未来,人更可能控制:
最终目标; 可接受的代价; 优先级; 时间边界; 金额边界; 数据边界; 对外沟通边界; 例外处理规则; 是否接受结果; 是否继续授权。
以商务出差为例。
传统 UI 下,你需要:
打开订票 App → 搜索城市 → 选择日期 → 对比航班 → 看价格 → 填个人信息 → 确认支付。
Agent-native 的表达可能是:
“按我过往的商务出差偏好处理。超过 3000 元、涉及改签风险、红眼航班或签证问题时再问我。”
前者是Control every step。
后者是Control policy and boundary。
人不再是亲自移动鼠标的人。
人开始变成 Principal:定义目标、授予有限权力、处理价值冲突、接受最终结果的人。
这也是未来界面最深的一层变化:
Human agency 不等于 human operation。
人不必亲手操作每一步,仍然可以拥有结果、边界和责任。
五、反直觉:AI 越强,界面未必越少
一种流行想象是:
AI 越可靠
→ 人越不需要操作
→ UI 越少
→ 最终只剩语音,或一个聊天框。
这只说对了一半,人确实会越来越少参与连续执行。
但这不等于人应该什么都看不见。
因为如果 Agent 一天完成几千次动作,让人逐条看几千条日志,没有任何意义。
人不需要知道:
它点了哪个按钮。
它打开了哪个网页。
它复制了哪一段文字。
它调用了第几个工具。
人真正需要知道的是:
它为什么相信这个结果; 哪个假设发生了变化; 哪个动作不可逆; 哪个结果无法验证; 它动用了什么权限; 它为什么认为自己有资格这样做; 它在哪里触及了默认规则的边界。
因此,未来 UI 既不会简单走向“更多透明”,也不会走向“完全黑箱”。
它会走向:
Just enough transparency 恰到好处地透明
低风险、可逆、确定、短任务,UI 可以越来越隐形。
高风险、不可逆、不确定、涉及真实价值取舍的任务,UI 不但不能消失,反而会变得比今天更重要。
可以把未来交互写成一个简单函数:
Interface = f(Risk, Reversibility, Uncertainty, Duration)
它大致会导向几种不同制度:
低风险、可逆、确定、短任务:Invisible Automation; 风险略高:Act → Inform; 涉及付款、对外沟通、重要修改:Prepare → Approve; 高不确定性、创造性任务:Shared Workspace; 长期、多 Agent、高责任任务:Role / Policy / Exception UI。
所以,未来 UI 会从 continuous interaction 持续互动,变成 selective intervention 选择性干预。
平常,机器自动流过。
到了真正需要人类判断的地方,机器停下来。
六、未来界面真正要管理的,不是页面,而是行动权
如果一个 Agent 要替人行动,人和机器之间究竟需要被明确管理什么?
答案是一套新的关系对象。
1. Goal:人想让世界变成什么样
Goal 不是一句 Prompt。
Prompt 是表达方式。
Goal 才应该是持续存在的系统对象。
比如:
“完成一本关于 AI 时代技术品味的书。”
这个 Goal 下面,未来可能天然挂着:
Context; 相关文件; Research; Deadline; Budget; Success criteria; 当前状态; Agents; Decisions; History; Constraints。
它可能持续几个月,甚至几年。
你离开电脑之后,它依然存在。
所以,Goal 很可能成为 File、Folder、Project 之上的新抽象。
因为文件终于开始被放进一个更接近人类意图的结构里。
2. Responsibility:谁长期负责这件事
Task 是:
“查一下今天发生了什么。”
Responsibility 是:
“持续关注这个领域,出现真正重要的变化时告诉我。”
Task 是工作的分解单位。
Responsibility 才是长期委托的单位。
这也是为什么“AI 员工”这个词虽然粗糙,却抓到了一点什么:未来的关键不只是某个 Agent 能否做完任务,而是它是否拥有明确、持续、有限的职责域。
但“数字员工”仍然不够准确。
Agent 不应该被赋予无限责任。
它应当是一个受限角色。
它有职责,也有权限边界;能主动行动,也必须接受暂停、撤权和接管。
3. State:我们共同面对的现实是什么
未来复杂协作的中心,是双方共同面对的 State 状态。
它可能是:
代码库; 文档; 表格; 设计稿; 客户状态; 供应链数据; 订单; 日程; 数据集; 研究资料; 一个正在变化的世界模型。
所以未来复杂知识工作最稳定的形态,很可能不是Shared conversation。
而是:
Shared state 共享状态
人和 Agent 围绕同一个 Artifact 工作。
聊天退到边缘,负责澄清、协商、批评、重定向。
真正的“共同事实”,存在于 Artifact 和 State 里,而不是聊天记录里。
AG-UI 这类新协议之所以值得注意,因为它开始把 Agent 状态、UI intent、工具调用和用户交互视为同一条实时交互边界上的对象。
4. Trigger:机器什么时候可以主动行动
传统 GUI 的核心时间结构是:
now。
点击以后,现在执行。
常驻 Agent 的时间结构则是:
if / when / until。
如果价格低于某个阈值; 收到某个人的邮件时; 如果项目三天没有进展; 一旦竞品发布新产品; 如果一个研究结论被新证据推翻; 每周五生成一次简报; 当客户流失风险达到某个等级时。
Trigger 触发器不是高级版日程。
它是:
机器何时获得 Initiative 的条件。
没有 Trigger,所谓“全天候 Agent”大概率仍然只是一个后台 Chatbot。
5. Authority:机器能做到哪里
传统软件权限问的是:
App 能不能访问相机?
Agent 世界的问题是:
这个 Agent 在什么条件下,可以代表我做什么?
这完全不是一个层级。
未来的授权会越来越像:
可以读邮件,但不能发送; 可以草拟合同,但不能签署; 100 美元以下的采购可以自行处理; 公开发布必须人工确认; 可以与供应商协商,但不能承诺价格; 晚上十点以后,只有 P0 风险可以打扰; 可以访问项目资料,但不能把数据带出组织边界。
过去软件有 Settings。
Agent 时代,越来越重要的对象会是:
Policy 规则
Settings 管理软件如何运行。
Policy 管理机器可以代表谁行动、行动到什么程度。
Workday 已经把 Agent Interaction Policy 作为独立安全对象,用来定义哪些用户可以调用哪些 Agent 技能。
这只是很早期的形态,但方向已经出现了。
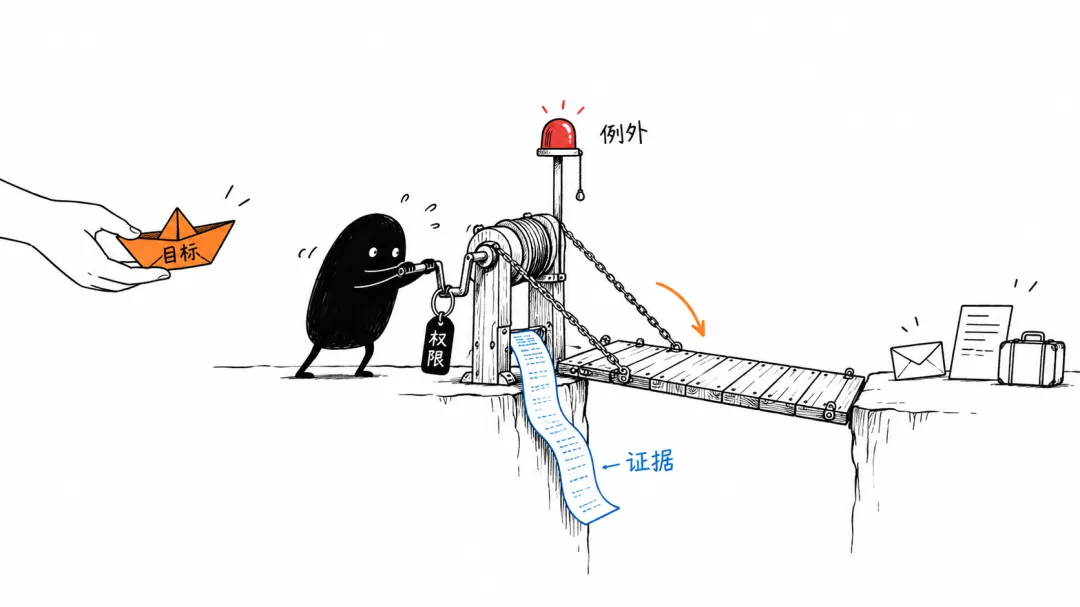
6. Exception:机器在哪里必须把权力交还给人
Notification 说的是:
Something happened。
Exception 说的是:
Machine agency stops here. Human agency required.
这是完全不同的东西。
未来的 Exception 可能包括:
两个方案都可行,但成本和时间存在不可自动化的取舍; 付款超过预算; 某个高风险动作需要扩大权限; 先前成立的假设被新数据推翻; 结果看似完成,但无法验证; Agent 遇到与既定目标冲突的新情况; Agent 无法继续推进,需要重新定义目标。
Exception 是权力交接点。
也是未来 Agent Inbox 最值得关注的地方。
过去的 Inbox 是:别人希望我做什么。
未来的 Inbox 更可能是:
机器在哪些地方不能替我做决定。
7. Verification:我怎么知道它真的做对了
AI 越强,人越不应该逐步盯着它做事。
人应该看证据。
未来最重要的迁移,可能是:
Reasoning visibility → Evidence visibility。
我们今天经常观看:Agent 做了什么。
未来更重要的会是:有什么证据证明它做对了?
这会带来一批新对象:
Receipt; Evidence; Source; Test; Provenance; Diff; Outcome verification。
人不需要重读整个系统。
人需要知道:
它改了什么。
为什么改。
哪些地方仍然不确定。
什么证据支持它说“完成了”。
W3C 最新的《Web User Agents》草案也已经把软件“代表用户行动”放到更严肃的位置:它把保护、诚实和忠诚视为 user agent 对用户的基本职责。这个草案,说明浏览器、助手和 Agent 正开始共享一种更本质的定义:它们不是单纯呈现信息的工具,而是代表用户与外部世界交涉的软件。
8. Recovery:如果不对,我怎样把权力拿回来
传统 Ctrl+Z 撤销的是:一次编辑。
Agent 世界需要撤销的是:一条自主行动轨迹。
这可能意味着:
Pause; Cancel; Rollback; Revoke; Restore; Fork; Compensate。
你不只是撤销一封邮件,可能需要暂停整个持续责任,收回权限,恢复到某个检查点,取消后续计划,甚至要求系统对已经发生的动作做补偿。
所以 Recovery 恢复比 Undo 撤销更像 Agent 时代的基础能力。
行动能力越大,可恢复性越重要。
这不是因为模型不够聪明。
而是因为“替人行动”这件事本身,就要求人始终保有收回行动权的能力。
七、GUI 之后,是一门新的交互语法
GUI 时代,Window、Icon、Menu、Pointer 的意义,在于它们把复杂计算函数,变成了用户可以理解和操作的对象。
Agent 时代真正对应的,不太可能是一组新的视觉控件。
它更像一组新的关系原语:
Goal
Responsibility
State
Authority
Trigger
Exception
Verification
Recovery
以及一组新的动词:
Define
Delegate
Grant
Observe
Act
Escalate
Verify
Override
Revoke
Accept
把它们连起来,就得到一条新的交互语法:
人定义 Goal。
人委托 Responsibility。
人授予有限 Authority。
Agent 观察 State。
Trigger 激活行动。
Agent 在边界内执行。
出现 Exception 时升级给人。
人做价值判断或重新定向。
Agent 提供 Verification。
人接受结果,或暂停、撤权、恢复。
注意,这里已经很少出现传统 GUI 的核心动词:
Click、Open、Scroll、Navigate、Launch app。
它们没有完全消失,但正在退到更底层。
GUI 把机器的功能变成可操作对象;
Agent Interface 要把机器的行动权变成可操作对象。
八、Chat、生成式 UI、共享工作区和眼镜,不是在争同一个终局
今天关于未来界面的讨论,常常把很多不同层的东西混在一起。
Chat、Canvas、Generative UI、语音、眼镜、Agent OS、Shared Workspace,看上去都在竞争“下一代界面”。
其实它们解决的不是同一个问题。
1、Chat:未来的语言化控制通道
Chat 不会消失。
它仍然是人表达模糊意图最自然的入口。
但它不太适合承载一切。
Chat 更适合:
发起委托; 澄清目标; 协商取舍; 质疑结果; 中断任务; 重新定向; 追问“为什么”; Debug Agent 的判断。
它更像:
语言化的 Command Line + Negotiation Channel。
重要,但不等于整个操作系统。
2、Shared Workspace:复杂创造的真正中心
当人和 Agent 真正一起写代码、做研究、改文档、设计产品、分析数据时,最重要的并不是聊天记录。
而是共同操作的对象。
Conversation at the edge,Artifact at the center。
聊天负责协商。
Artifact 承担共同事实。
这也是为什么未来所有界面不会都缩成一个输入框。
复杂工作必须有共同状态、结构化对象、差异视图、验证机制和可恢复历史。
3、Generative UI:把语义临时编译成最适合当前任务的界面
Generative UI 很重要,但它解决的是:
这一刻,机器应该给人呈现什么操作表面?
同一个 Exception,有时适合两个按钮。
有时适合一张比较表。
有时适合地图。
有时适合一段 Diff。
有时适合一个模拟器。
Google A2UI 的思路很有代表性:Agent 不直接交付一张任意生成的网页,而是用结构化数据表达“应该渲染什么”,再由宿主应用用自己的组件系统生成界面。
这意味着:
UI 开始从 application property,变成 runtime output。
但 Generative UI 不是终局。
它只是 Presentation Layer 的突破。
真正决定一张临时界面该长什么样的,是更底层的语义对象:这是授权、异常、验证、恢复,还是目标取舍。
所以:
Generative UI 的终局不是没有原语的 UI。
恰恰相反,它需要更稳定的语义原语,才能每次生成不同但正确的界面。
4、Ambient Interface:屏幕不会消失,它会变成信心表面
眼镜、耳机、戒指、手机、桌面设备,都可能成为 Agent 出现的入口。
低风险任务当然会越来越无界面化。
提醒、记录、导航、整理、环境感知,很多动作会在你没有主动打开软件时发生。
但这不意味着屏幕消失,更准确的描述是:
Screen 将从 execution surface,变成 confidence surface。
平时,它不必出现。
当你需要比较、验证、授权、复盘、撤回或处理风险时,它出现。
不是为了让你操作机器。
而是为了让你确认自己仍掌握局面。
九、未来的桌面,不是 App 首页,而是注意力路由器
回到开头的三块未来首页。
经过前面的拆解,它们不再只是一个漂亮猜想。
它们是 Agent-native 计算最自然的结果。
1、What I care about
Goal / Responsibility 目标/责任
什么在被持续推进。
什么被暂停。
什么需要重设边界。
什么长期由谁负责。
2、What has changed
State / Results / Verification 状态 / 结果 / 验证
世界发生了什么变化。
Agent 做了什么。
它留下了什么证据。
哪些结果已经验证,哪些仍然不确定。
3、What needs me
Exception / Decision / Authority request 例外 / 决定 / 权限请求
哪些地方到了机器行动的边界。
哪些地方必须由人做价值判断。
哪些地方需要扩大、收回或修改授权。
这其实就是未来的 Agent Inbox。
它不再是 Email Inbox,是:
Human Attention Router 人类注意力路由器。
当 Agent 足够多以后,人类最稀缺的资源不再是输入命令的能力。
而是注意力。
不是“怎样让机器开始做事”。
而是“在什么时刻,什么事情值得我亲自出现”。
十、多 Agent 时代,界面最终会像组织结构
如果未来一个人不再只拥有一个 AI,而是拥有:
研究 Agent; 编码 Agent; 日程 Agent; 财务 Agent; 招聘 Agent; 个人 Agent; 公司 Agent; 以及一群临时 Subagents;
那么“和二十个 Agent 逐一聊天”,不可能成为稳定界面。
人也不会愿意观看二十个 Agent 的完整内部协作过程。
未来人真正需要管理的是:
Role; Responsibility; Authority; Budget; Policy; Escalation; Evidence; Ownership。
这也是为什么 Agent UI 最后会越来越像 Organization UI。
Salesforce 已经在产品层面呈现了很早期的形态:一个任务可以同时分配给 AI Agent 与人类审核者,Agent 先填充内容,再停下来等待人类审阅;无法完成时,也可以转交给预设的 fallback assignee。
它说明,软件开始第一次以一种可委托、可约束、可追责的角色,进入组织结构。
过去的组织图只安排人和部门。
未来的组织图会开始安排:
人; Agent; 工作流; 权限; 预算; 审批; 责任边界; 例外升级路径。
十一、界面将成为人类意图、机器行动权与责任交接发生的地方
未来不会只有一种“AGI 的 iPhone 界面”。
不会所有事情都变成 Chat,不会所有屏幕都消失,不会所有任务都交给 AI。
真正稳定下来的,是不同风险、不同责任、不同不确定性之下的几套交互制度。
低风险任务,自动化会隐形。
复杂创造,人和 AI 会共同编辑同一个世界状态。
高风险行动,会需要结构化授权、证据、验证和确认。
长期多 Agent 系统,会要求我们管理角色、责任、预算与升级路径。
所以,未来 UI 的问题不再是:“我怎样让机器做这件事?”
而是:
“我想让世界变成什么样?”
“谁来持续负责?”
“它可以做到哪里?”
“它什么时候可以自己行动?”
“什么情况下必须回来找我?”
“我怎样知道它做对了?”
“做错以后,我怎样把行动权拿回来?”
过去,界面让人学会操作机器。
接下来,界面要让人学会把机器的行动权交出去,又在必要时拿回来。
>/作者:王零壹,920.org.cn(AI Research Institute)创始人,港大AIBT研究生,前上市公司 CMO。长期研究 AI 产品、Agent 架构与商业增长,并持续观察技术变迁如何重塑人的工作、判断与生活。
*运营公众号「AIGC从0到1」,为虎嗅、腾讯新闻等平台作者;
*著有《AIGC从0到1》系列丛书、及东方寓言小说《飞将军》;
*善于洞察先机,中文互联网第1个意识到OpenClaw范式价值的人(1月26日);
关注我,一起AIGC从0到1~