ARTICLE · 1112390
四成AI负载,搬去开源模型
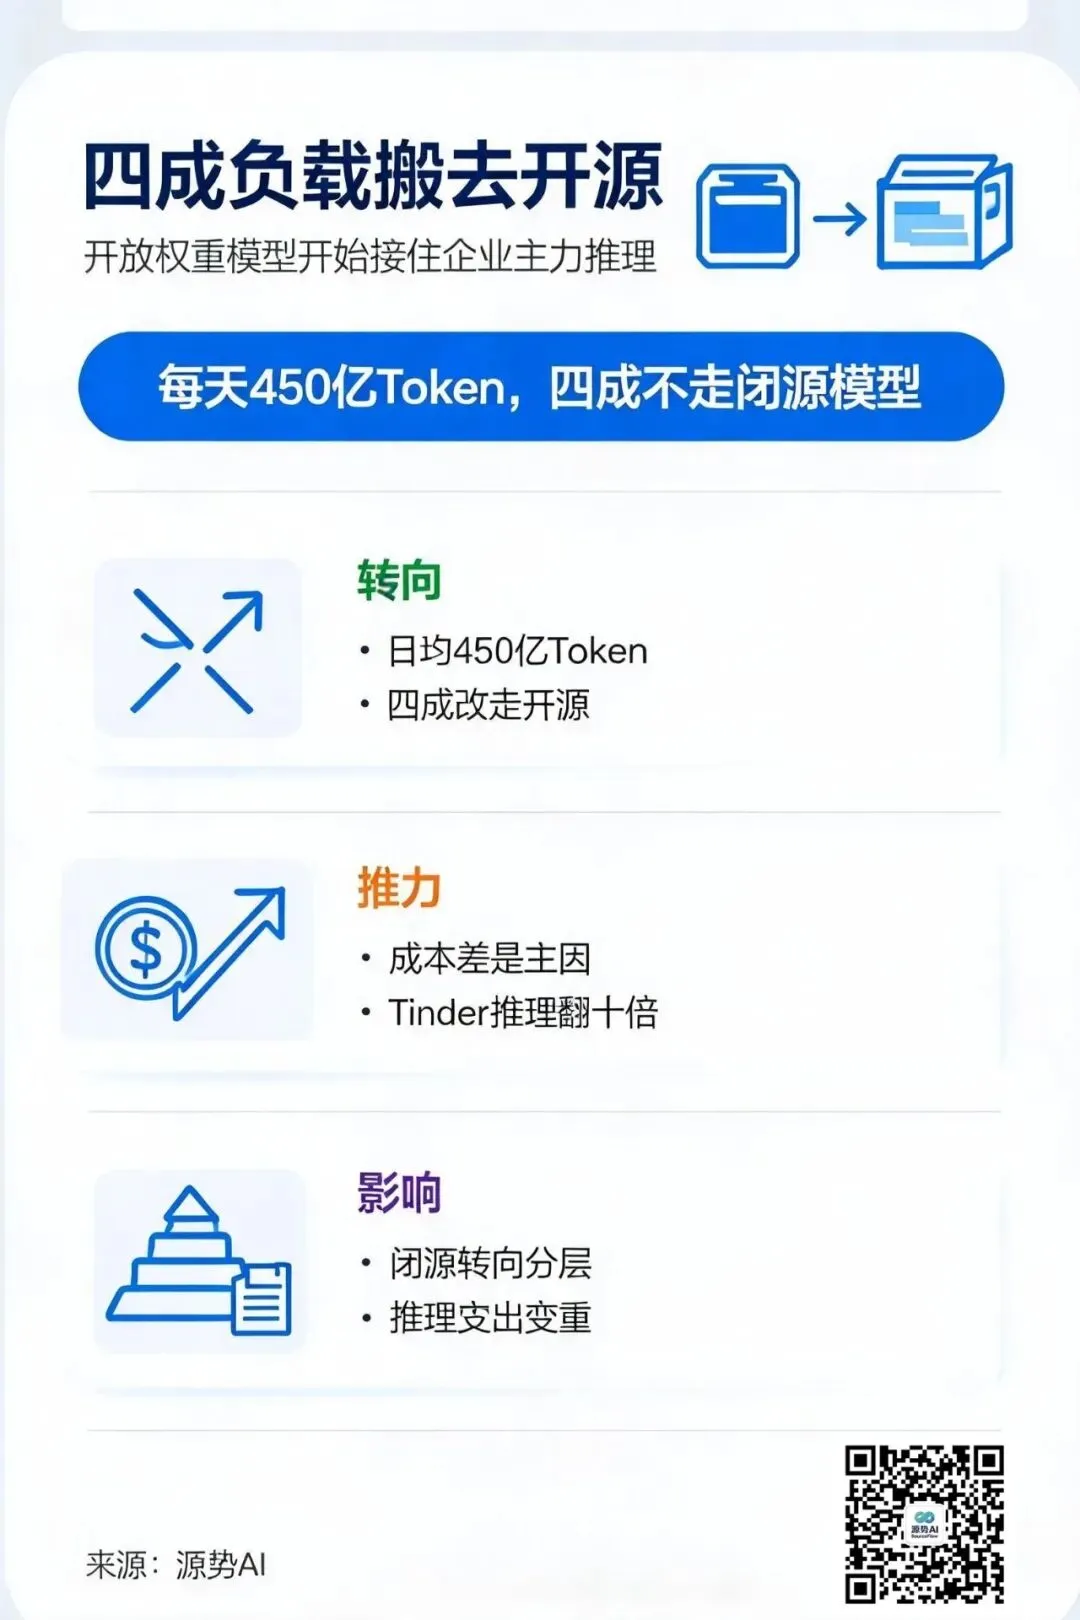 图注:一图读懂本文要点——开放权重模型正在接住企业的主力推理负载。
美国企业正在悄悄换掉一部分模型供应商。据《金融时报》报道,一批原本主要调用 OpenAI、Anthropic 前沿模型的公司,开始把越来越多的任务迁到开放权重模型上(来源:机器之心,转引自《AI行业24小时_20261002》)。
AT&T 是其中走得最远的。这家公司每天处理约 450 亿 Token,其中约 40% 的 AI 工作负载已经运行在开放模型上,公司给出的目标是一年内把比例提到 70%(来源:机器之心,转引自《AI行业24小时_20261002》)。
Tinder 的账本更能说明动机。CTO Vinay Kuruvila 透露,按年初规模估算,公司全年 AI 支出约 100 万美元,到 7 月已经变成一年 1000 万美元(来源:机器之心,转引自《AI行业24小时_20261002》)。涨了十倍之后,公司把一部分普通用户请求转给开放权重模型,并认为前沿模型对约九成任务已经够用。
三组数字画的是同一条曲线
企业侧的动作之外,还有两组旁证。
AlphaSense 的统计是:今年 8 到 9 月,美国企业在业绩电话会和投资者会议中提到 open weight 或 open source 模型的次数,比去年同期增加 6 倍(来源:机器之心,转引自《AI行业24小时_20261002》)。在 Vercel AI Gateway 上,今年 8 月处理的 Token 中有 56% 来自开放权重模型,而去年 12 月这个比例只有 7%(来源:机器之心,转引自《AI行业24小时_20261002》)。
把这几组数放在一起,曲线是清楚的:调用量在往便宜的一端走。名单里已经出现 DeepSeek、智谱等中国厂商,AT&T 的做法也不是下载即用,而是用自有数据调优,让部分任务的效果与闭源模型相当(来源:机器之心,转引自《AI行业24小时_20261002》)。
口径要先说清,否则数字会打架。40%、70%、450 亿 Token 都是 AT&T 自述,不是独立审计;"约九成任务够用"是 Tinder 高管的判断;56% 只反映单一网关的流量结构,不代表全市场占比;"提及次数增加 6 倍"统计的是会议文本,不等于采购金额增长(来源:机器之心,转引自《AI行业24小时_20261002》)。被迁走的是可以分流的任务,不代表企业放弃闭源前沿模型。
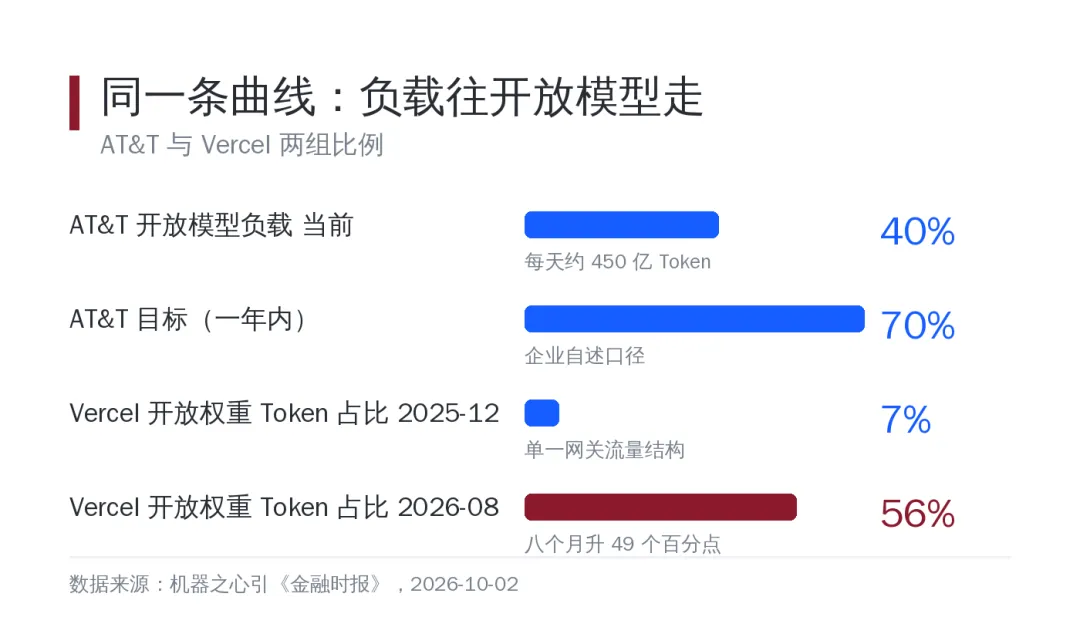 图注:AT&T 的开放模型负载从四成往七成走,Vercel 网关上的开放权重 Token 占比八个月内从 7% 升到 56%——两条线画的是同一个方向(数据来源:机器之心,转引自《AI行业24小时_20261002》)
分流的不是算力,是任务
这件事真正的变化,不在模型替换,而在任务分类。
源势AI 在 8 月写过《大模型定价,正在分裂》:2026 年 6 月的国内价格表上,DeepSeek V4-Flash 每百万 Token 输出 2 元,智谱 GLM-5.2 输出 28 元,同为国产旗舰,价格差了 14 倍(来源:《国内大模型价格与Benchmark综合对比》全模型版,2026 年 6 月,转引自源势AI《大模型定价,正在分裂》)。价差不是能力差距的同义词——那一篇里同时列了数据:DeepSeek V4-Flash 只要 2 元输出,SWE-Verified 仍拿到 79.0。
当同一个任务用哪档模型都能交差,选择逻辑就从"谁最聪明"变成"这任务值不值得用最贵的模型"。AT&T 把可分流负载的上限设到七成,等于承认了一件事:它的大部分 AI 工作量,并不需要前沿模型的能力上限。
这对做预算的团队是一条可操作的方法。先按容错边界把工作负载切两堆——出错代价高、必须最强的放一堆,够用就行的放另一堆,再给两堆配不同的模型与价格。这个动作比等下一轮降价更早拿到结果。
便宜的那一端也有代价
迁移不是免费的。开源模型的单价低,但省下的钱要拿工程能力去换。
用自有数据调优、把模型部署在可控环境里、为不同任务维护路由,这些活本来由供应商打包在 API 费里,现在需要自己承担。AT&T 之所以能走到四成,前提是它有足够的工程团队把调优和路由做起来;对工程资源有限的中小企业,把任务简单搬到开放模型上,很可能省下的是账单,付出的是稳定性和响应速度。
这也是为什么"分流"比"替换"更准确:先把低风险、高频、对延迟不敏感的任务搬过去,跑通了再扩大比例。一步全换,风险和收益都不划算。
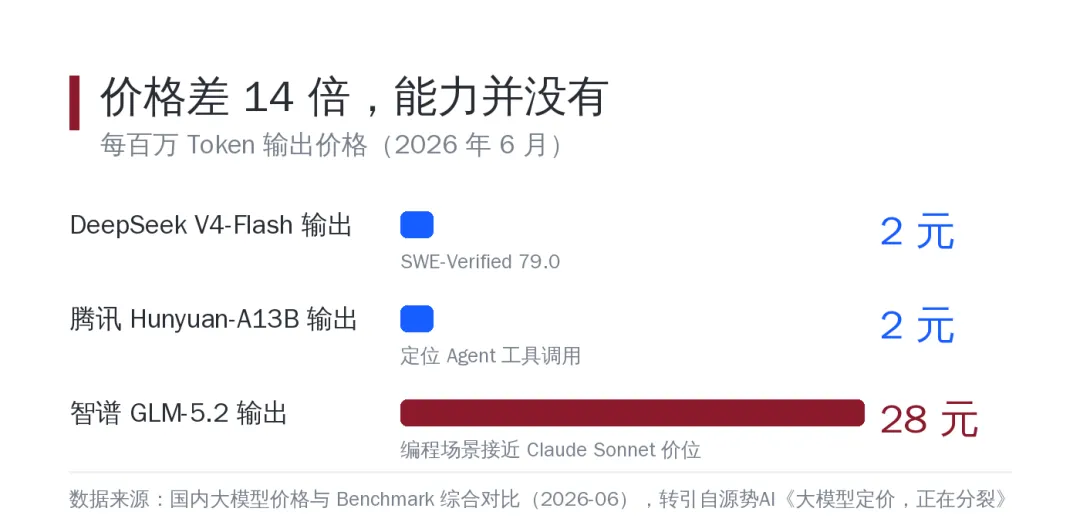 图注:国产旗舰模型每百万 Token 输出价格,最低 2 元与最高 28 元之间相差 14 倍;DeepSeek V4-Flash 输出 2 元时,SWE-Verified 仍拿到 79.0(数据来源:《国内大模型价格与Benchmark综合对比》全模型版,2026 年 6 月,转引自《大模型定价,正在分裂》,源势AI,2026-08-10)
源势AI观点
第一,看模型采购新闻,先看任务结构,不看采购总额。企业把负载迁向开放权重,不等于减少 AI 投入,而是把钱从"通用最强"挪到"场景够用"。评估一家公司的 AI 成熟度,一条实用的标准是:它能不能说清哪些任务必须用最贵的模型。
第二,路由能力比模型选型更值钱。模型越多、价差越大,把任务分配给合适模型的策略价值就越高。我们给客户做 Token 聚合时,第一条建议从来不是换模型,而是先把任务分层——同一批负载,分完层再选模型,降本空间通常比单换一家供应商大。
第三,把口径写进采购合同。AT&T 的 40% 与 70% 都是自述,第三方只看到单一网关的 56%(来源:机器之心,转引自《AI行业24小时_20261002》)。真正要落到纸面上的,是"哪些任务走哪个模型、失败时怎么回退、延迟和可用性到哪一档",而不是一个笼统的"开放模型占比"。
开源模型不是更聪明,是更便宜够用。企业正在用这个判断,重写模型市场的账本。
参考材料
- 机器之心引《金融时报》《美国企业把 AI 负载迁向开放权重模型》,2026-10-02
- 源势AI《大模型定价,正在分裂》,2026-08-10
- 《国内大模型价格与Benchmark综合对比》全模型版,2026 年 6 月
话题标签:#开放权重 #模型路由 #AI成本
源势AI · 企业智能化的推动者
最懂企业业务的 AI 全栈服务商
大模型 Token 聚合平台
企业 FDE 与智能体落地
AIGC 影视制作
官网 www.srcflow.cn | 邮箱 contact@srcflow.cn
关注我们 · 获取更多 AI 前沿洞察
推荐阅读