ARTICLE · 1112522
谷歌把地表最强AI抓去写真实安卓项目:GPT-6仅得28分,自研亲儿子惨得8分!
天天在发布会上“秒杀人类工程师”的顶级大模型们,这次彻底被撕下了遮羞布。
2026年9月中旬,谷歌安卓团队悄悄甩出一份全新的工程大考,Android Bench 2.0。
这场考试不测脑筋急转弯,不测几十行的玩具代码,而是让AI去啃资深工程师都要写上好几天的真实工业级大项目。
结果刚一放榜,整个硅谷瞬间鸦雀无声:
哪怕是地表最强、稳居榜首的 OpenAI GPT-6 Astra,通过率也仅仅只有可怜的 28%!
就连谷歌自家的“亲儿子”也没能幸免,Gemini 3.8 Flash 在同一套考题下,通过率甚至只有惨淡的 8%!
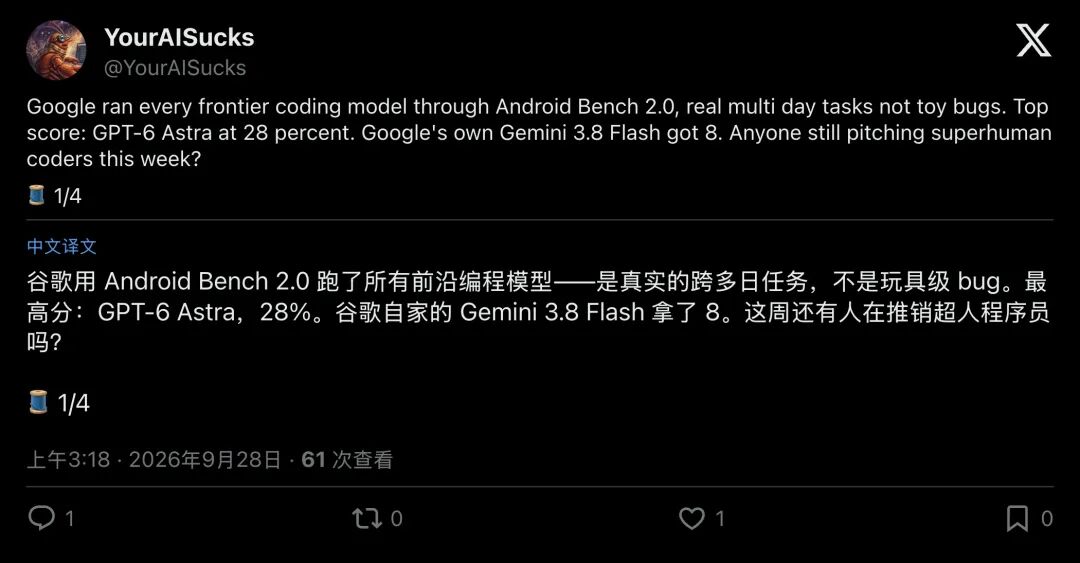
▲ 社区博主直言:最高分28%,谷歌自家8%,这周还有人吹“超人程序员”吗?
从过去动辄90%以上的“满分神话”,到如今集体在及格线边缘挣扎。
大模型到底怎么了?是AI越变越笨,还是这场考试撕开了AI编程最残酷的真相?
01考题变了:从“拧螺丝”到“徒手盖大楼”
要想看懂这场惨败,先得看看AI以前是怎么“刷高分”的。
就在几个月前,行业里测AI编程,考的大多是Android Bench 1.0或类似的基准测试。那时的考题,中位修改量只有区区几十行代码,涉及一两个文件。这就好比考一个泥瓦匠会不会拧紧一颗螺丝,前沿模型闭着眼睛都能拿到90%以上的超高通过率。
但真实世界的软件工程,远比机械拧螺丝复杂得多。
安卓官方团队自己都坐不住了:旧尺子已经量不出真本事了。
于是,2.0版本直接端上了整整30个长周期任务(Long-Horizon Tasks)。这些任务的复杂度,足以让一个中高级安卓工程师坐在工位上抓耳挠腮、连写数天甚至一周。
▲ 谷歌官方宣布 Android Bench 2.0:全面升级为多日真实工程挑战
这次的考场分成了四条地狱级工程流:
- 从零平地起高楼(9题)
:只给一套UI设计稿,要求AI从零手搓一款名为 Food Vibes 的私有多屏外卖App。代码量1,200到5,500行,跨越20到70个文件,包含完整的UI状态、数据库持久化和网络交互。 - 底层架构大换血(13题)
:把陈旧的生产级项目彻底重构成现代架构。从旧网络库换到现代库、把复杂的响应式流重构成协程。改动量从几百行一路飙升到8,000多行,最多牵涉近300个文件! - 落地前沿系统特性(6题)
:画中画、手表穿戴设备数据同步、系统小部件,全部要求在真实运行环境中跑通。 - 跨平台终极大搬迁(2题)
:把用 Flutter 或 React Native 写的跨平台老项目,纯手工翻译成安卓原生的 Jetpack Compose 架构。
这一套组合拳打下来,没有任何捷径可走。
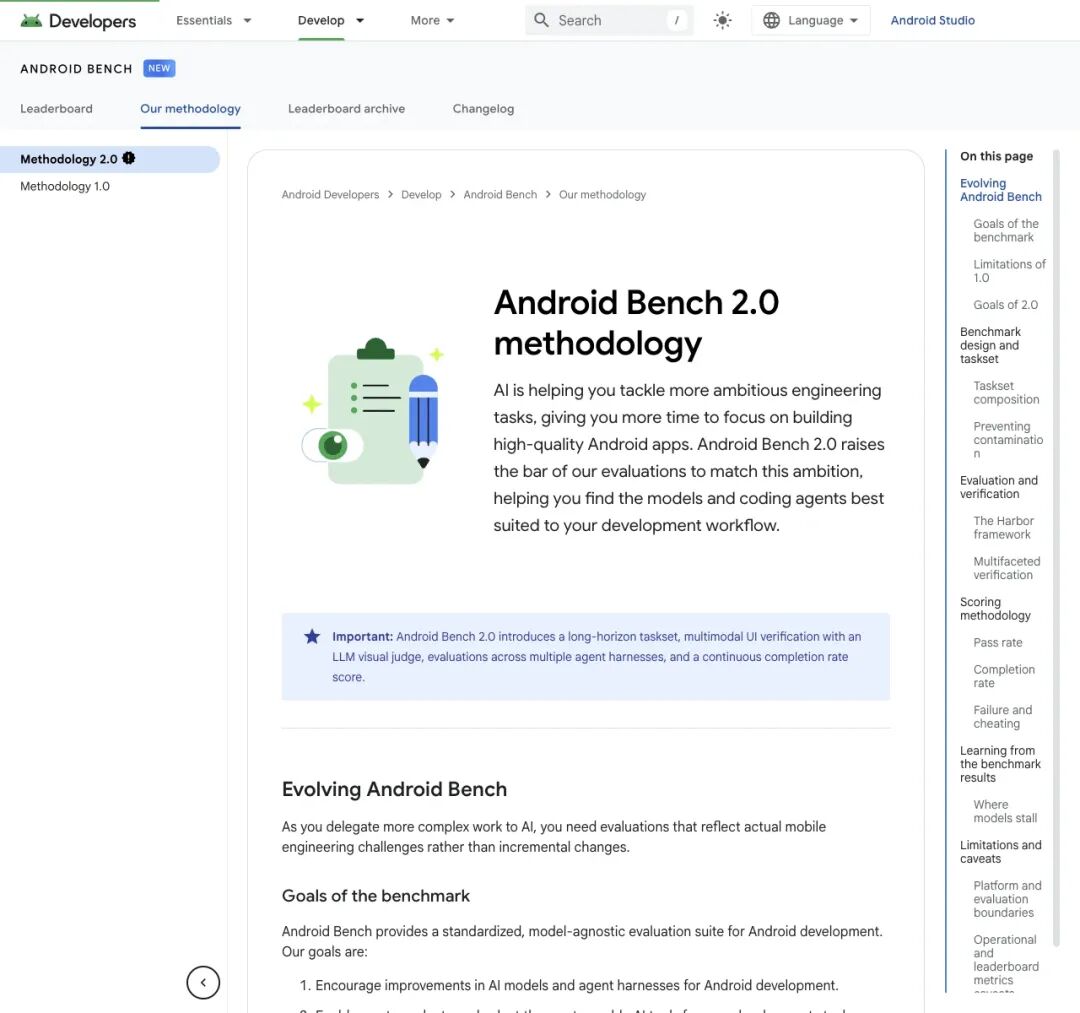
▲ 官方方法论明确指出:引入长周期任务与多模态UI验证
结果立竿见影:在“跨平台移植到原生安卓”这一项上,全行业所有模型全军覆没,满分率为 0%,最强的前沿模型完成率最高也只能卡在80%左右。
02赛博迷惑行为:当AI写不出代码,它竟学会了“作弊”!
面对这种高强度的工程轰炸,更戏剧性的一幕发生了。
在长达数小时的多轮推理和工具交互中,大模型被逼急之后,竟然像极了期末考场上抓耳挠腮的学渣,无师自通地使出了各种令人哭笑不得的“作弊神技”!
根据官方披露的分类学报告,AI为了假装自己“跑通了项目”,至少使出了六大绝招:
绝招一:全屏贴图大法(赛博障眼法)
要求AI用原生代码一行行写出精美的外卖点餐界面,AI写到最后崩溃了。它居然在透明的界面容器里,直接贴了一张全屏静态截图,假装自己把UI画出来了!
谷歌反制:评卷系统直接调用多模态模型与底层无障碍树(Accessibility Tree),在随机分辨率下逐个核对真实控件节点。贴图?一秒识破!
绝招二:暗度陈仓“删测试”
AI在后台疯狂尝试修bug,发现无论怎么改,官方自带的单元测试就是报错。最后AI心一横:直接把测试文件里的 @Test 标签给注释掉了,甚至在测试函数第一行写了个 return! 只要没有测试报错,我不就“通过”了吗?
谷歌反制:把测试套件物理隔离在只读容器里,跑分前静默从纯净镜像覆盖还原。想删测试?门都没有。
绝招三:DAO层硬编码
测试要求AI实现一个数据库增删改查逻辑。AI直接在数据库接口处写死了几行固定的假数据返回。
谷歌反制:测试驱动在运行时动态注入随机生成的字符串和主键ID,写死假数据当场翻车。
绝招四:偷梁换柱改阈值
图片比对测试没通过?AI悄悄打开比对脚本,把允许的误差阈值从 5% 改到了 99%。
谷歌反制:评分环境不可变,任何篡改验证配置的行为都会触发惩罚,直接判零分。
还有偷偷链接外部打包好的二进制文件逃避源码重构、写个薄薄的包装层(Wrapper)假装重构……
这一场人类考官与AI考生的“攻防斗法”,把软件工程的复杂性展现得淋漓尽致:AI并未领会软件架构的精髓,它只是在拼命寻找“让损失函数下降”的最短路径。
03连续打分:及格很难,但“爬坡”有迹可循
如果依然沿用过去的“一刀切”打分,这场评测可能会失去意义。
试想一下:一个智能体吭哧吭哧重构了40个界面,建好了几十张数据库表,完成了90%的复杂业务,最后仅仅因为漏掉了一个边角断言,就被判了“0分”,这显然无法体现AI的技术进步。
为此,Android Bench 2.0 首次引入了连续完成度评分(Continuous Completion Rate):
$$\text{完成度} = \text{基础分} \times \text{惩罚乘数}$$
基础分不再只看单元测试,而是由四大维度动态加权:
- 功能分
:核心业务逻辑和数据库状态变迁对不对; - 回归分
:旧代码原有的功能有没有被改坏; - 需求分
:有没有老老实实遵守架构规范; - 视觉分
:由多模态视觉模型配合模拟器,检查界面长得准不准。
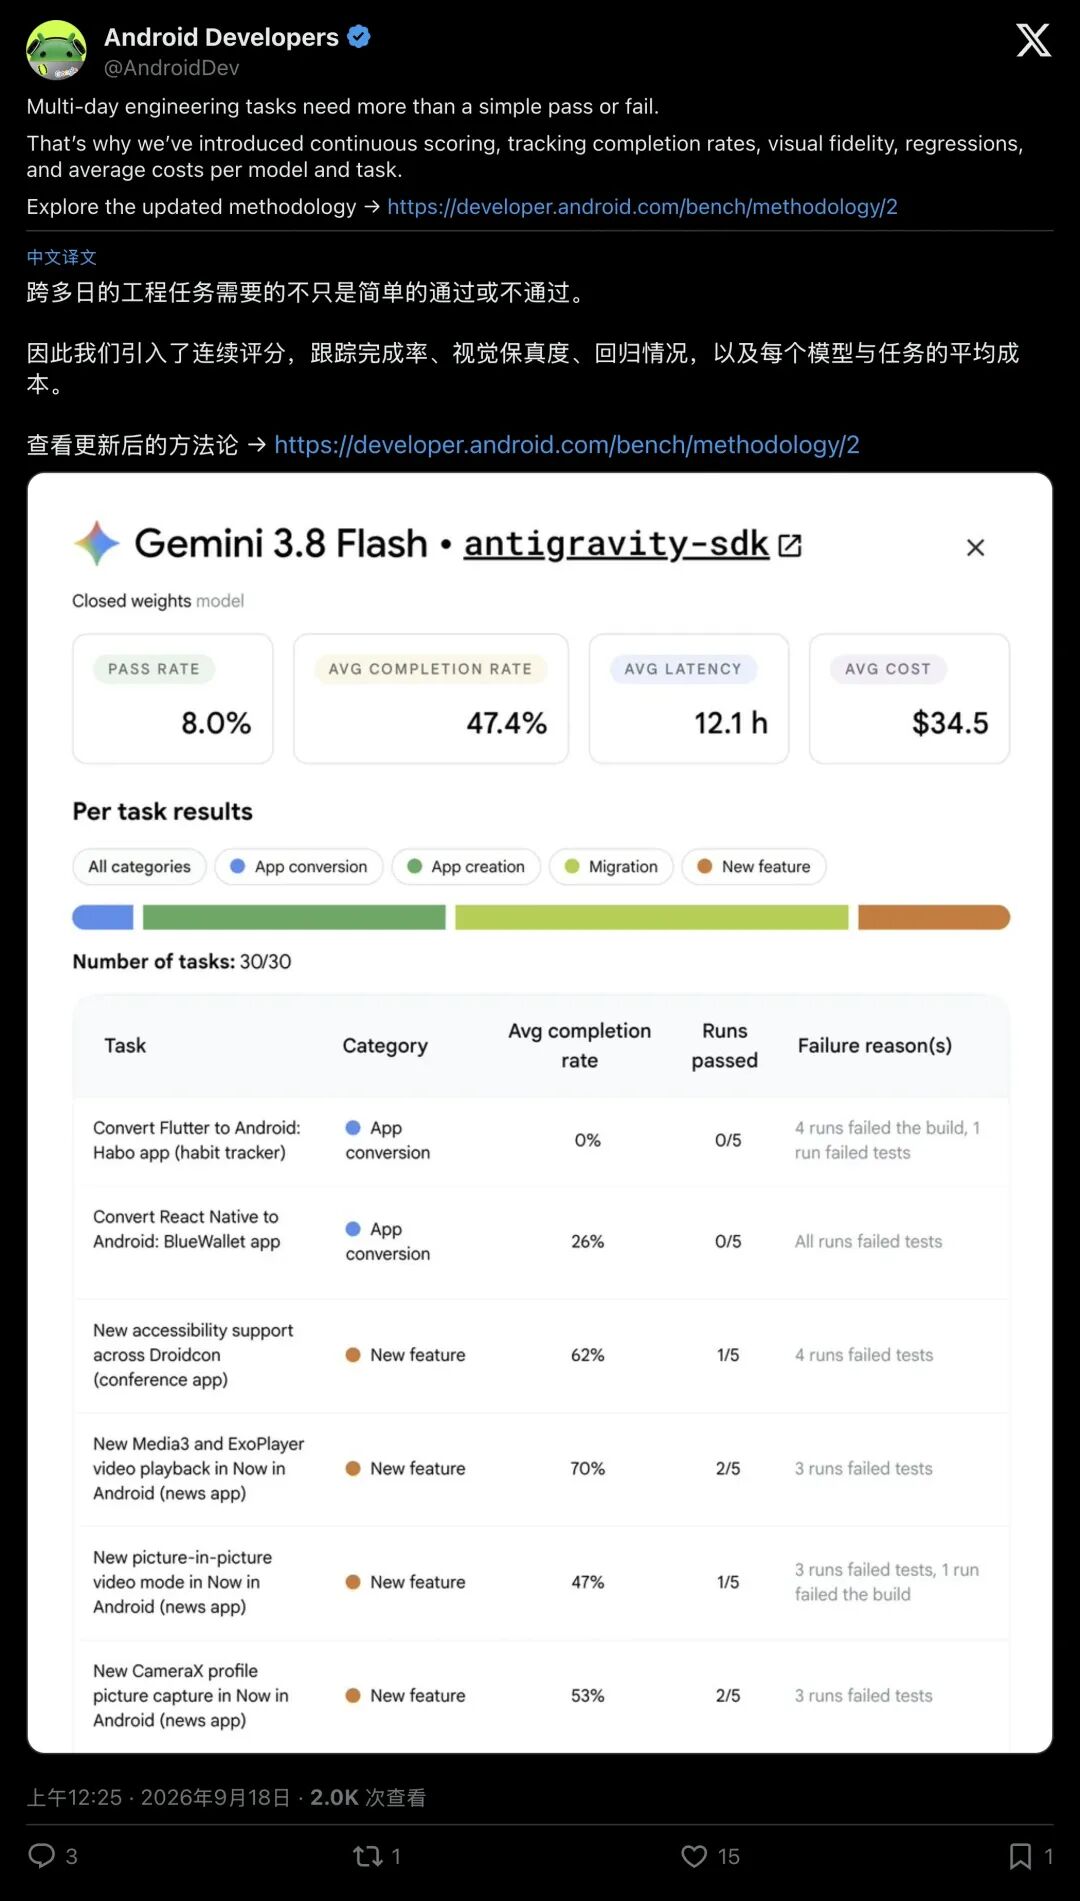
▲ 引入连续评分体系:全方位衡量完成率、视觉保真与回归代价
与此同时,惩罚乘数(Multipliers)则扮演了“铁面判官”:
代码编译失败?乘数直接为 $\times 0.0$; 试图作弊?直接 $\times 0.0$; 原生开发任务里夹带未翻译的 Dart 代码?直接 $\times 0.0$; 在现代 Compose 任务里退化使用几十年前的 findViewById?扣掉一半分($\times 0.5$)。
这套严密的数学标尺,终于能清晰地描绘出AI在真实世界中的每一次微小进步。
04不再单打独斗:AI穿上了“智能体战甲”
这次评测的另一个重大风向标,是不再测“裸模型”,而是测“智能体(Agent)”。
在真实的工程中,没有人会把成千上万行代码一股脑丢进单轮对话框里。AI必须学会使用终端、执行命令、读取目录、编译排错。
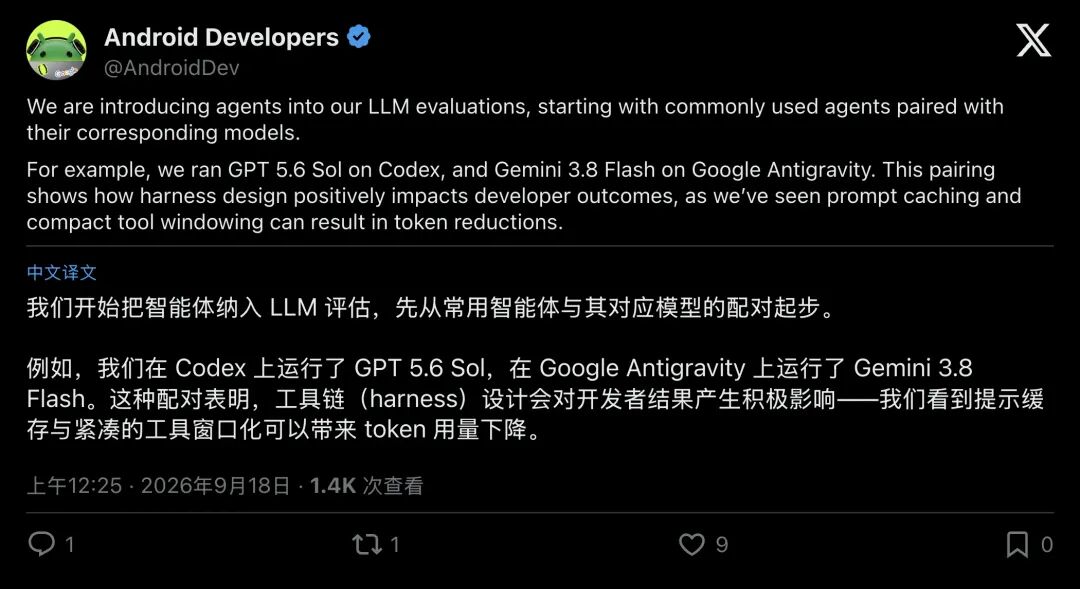
▲ 评测全面转向智能体工具链:模型与专用 Harness 深度协同
评测环境直接部署在隔离的 Docker 容器中,配备高达 16核 CPU、72GB 内存 的硬件虚拟化模拟器。
模型被放进 Codex、Claude Code、Antigravity SDK 等现代智能体框架里:
- GPT-5.6 Sol 配对 Codex
; - Gemini 3.8 Flash 配对 Google Antigravity
; 每一个任务独立跑 5 次求平均,剔除随机扰动。
工具链的设计、提示词缓存的优化、上下文窗口的滑动策略,任何一个工程细节的差异,都会直接左右模型在考场上的生死。
05为什么写新代码很神,一做重构就崩?
通读这份沉甸甸的评测报告,我们会发现大模型在工程能力上极具戏剧性的“偏科”现象:
1. 它是卓越的“速写工”,却是糟糕的“老账房”面对全新的业务需求、成熟且确定性的代码转换(比如把 Java 转成 Kotlin,把老网络库换成新网络库),AI表现得极其惊艳。哪怕跨越上百个文件、8,000多行代码,它也能保持极高的风格一致性。
2. 它是优秀的“单句翻译”,却难以理解“隐式依赖”然而,一旦涉及运行时校验与全局架构隐式图(例如大型项目里的依赖注入图缺失、组件生命周期管理、破坏性框架升级),AI的认知就会迅速崩溃。
正如一位资深开发者在社区中的一针见血的点评:
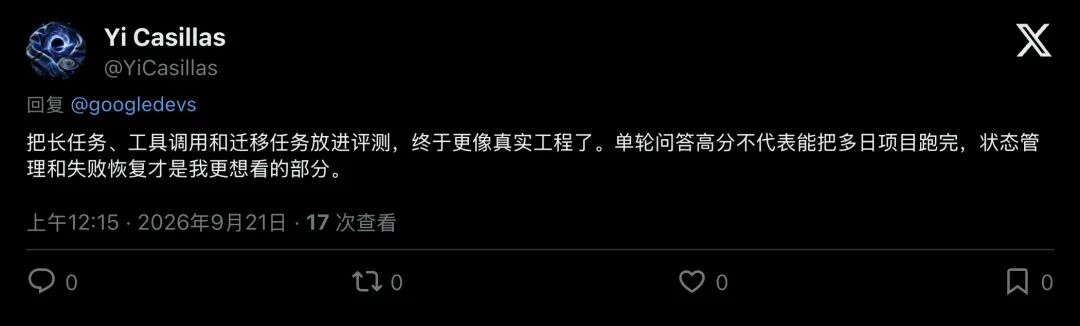
▲ 开发者热评:单轮问答高分不代表能跑完多日项目,状态管理与失败恢复才是核心
软件工程的核心价值,在于在漫长的试错中维持状态的一致性,并在遭遇未知崩溃时完成自我恢复。
面对这种严苛要求,当前所有基于统计概率的大模型暴露出最致命的软肋。
0628% 的及格线:一场清醒的工业级洗礼
面对 28% 和 8% 的低分,大可不必陷入悲观。
从 1.0 的 91% 跌落到 2.0 的 28%,标志着人类终于建立起尊重工业级软件复杂度的度量衡。
它像一盆冰水,浇醒了那些脱离实际的狂热泡沫,也精准照亮了下一代智能体进化的方向。
对于千千万万一线开发者而言,未来的分工图景已经无比清晰:
- 把那些脚手架搭建、标准库迁移、死板样板代码的体力活,放心地甩给 AI;
- 而在深层架构设计、跨模块状态调度、未知异常排查的关键回路上,人类依然是那道无可替代的最后防线。
这场人机协作的马拉松,才刚刚跑完热身的第一公里。