ARTICLE · 1113065
当 AI 能生成电影级画面,却讲不好一个故事:AIGC 视频的叙事鸿沟,媒体产线怎么补
— 本文主题示意:AI 能画出电影级画面,却未必连得成一个好故事。配图由 AI 生成,仅供示意。
QUOTE
卡住 AI 视频的,从来不是画质,而是故事连不连得起来。
—— 默默
本文看点
01
权威点名的天花板:4K、叙事手法、物理规律仍是短板
02
社区共识:瓶颈是"制片记忆",不是画质
03
一线解法:用工程把"一致性"钉死
01
THE CEILING
权威已经把"天花板"点名了
9 月 11 日,2026 浦江创新论坛·文化科技融合专题论坛举行。中国工程院院士、深圳大学讲席教授丁文华在发言里,给当下 AIGC 视频的能力边界划了一条很实在的线。效率是真的,潜力也是真的,但边界要认清楚。
当前 AIGC 生成视频最高质量约为 HD,尚不全面具备 4K 生成能力。
在事件、故事层面仍有较大差距,不支持正叙、倒叙、插叙、闪回等叙事手法,达不到蒙太奇式呈现。
生成内容无法保证符合物理世界的所有客观规律。
但要紧的是后面那半句——"能生成"不等于"能交付可信、可追更的内容"。媒体要是把"画面好看"误读成"可以当新闻素材播出去",这一步就容易翻车。
— AI 视频能力边界:画质已逼近电影级,但叙事手法与物理规律仍是短板。配图由 AI 生成,仅供示意。
02
PRODUCTION MEMORY
社区的冷观察:瓶颈不在画质,在"记忆"
创作者圈子里最近也在说同一件事,只是换了词。行业聚合 AGI HUNT 9 月 14 日的日报里提到:一位 Reddit 用户本想测试"生成式视频能不能撑起一部长片",结果意外做完了 7 部时长一小时的电影。他复盘下来的结论很扎心——瓶颈根本不是漂亮的片段,而是"production memory"(制片记忆):生成几千次之后,得靠人记住角色的脸、服装、地点,还有情绪史。
换句话说,模型很会"画好这一帧",但它没有一个贯穿全片的"角色 / 场景 / 情绪"记忆。你让它连着生成一个小时的连续故事,它就露怯了。
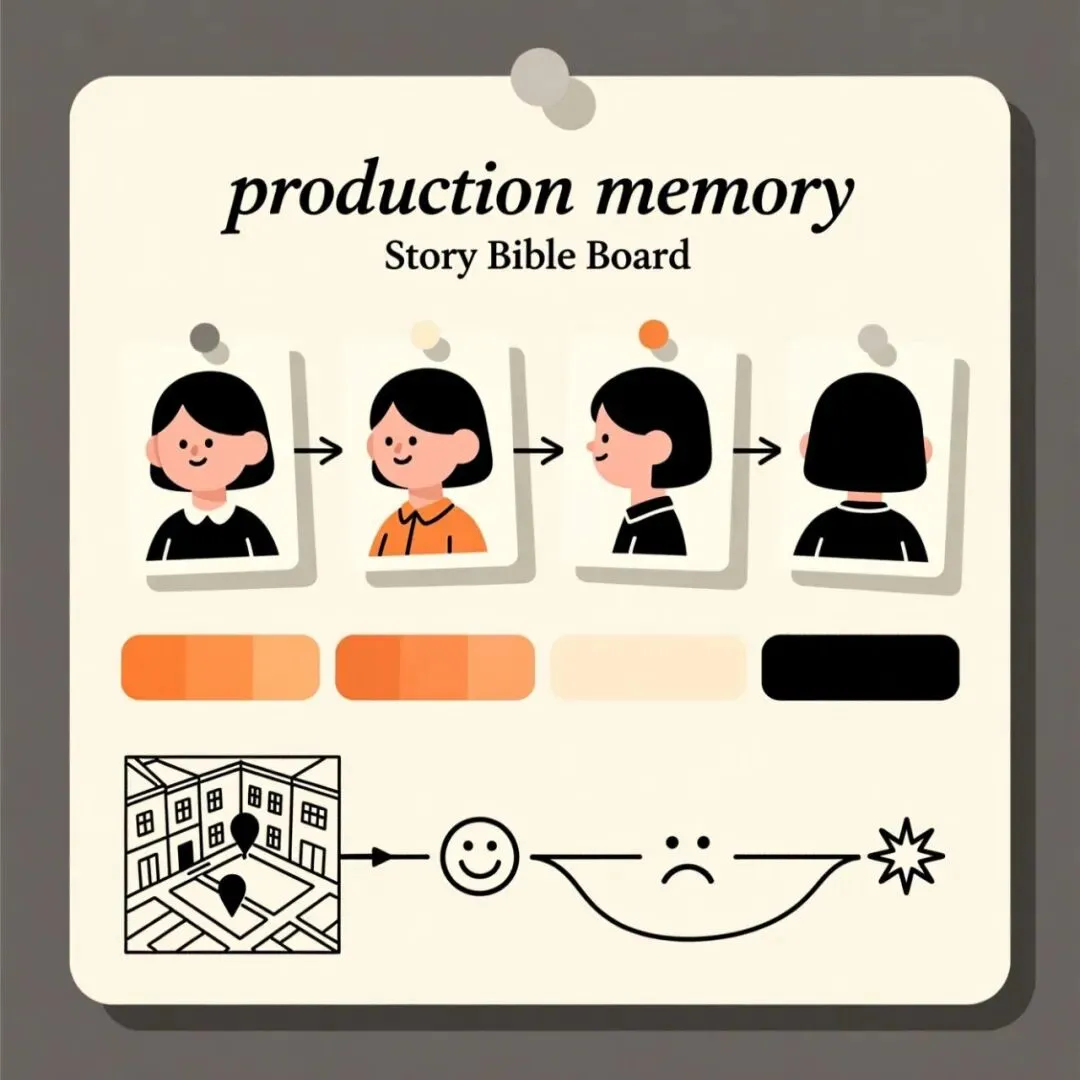
— "制片记忆":把角色的脸、服装、地点、情绪史钉成一张可复用的"故事圣经"。配图由 AI 生成,仅供示意。
「把叙事权先交出去,内容就散了;叙事权留在人手里,AI 才是最好的画笔。」
03
WHY THE GAP
为什么会有这道"叙事鸿沟"?
拆开看,原因其实很工程:
训练目标是单镜头,不是连续剧。主流文生视频模型按"一段提示词 → 一段画面"训练,没有内建的跨镜头状态。
角色 / 场景一致性靠"抽卡"而非"约束",没有把角色卡、场景卡、关系卡变成可复用的工程资产。
事实与情绪没有底座。人物关系、时间线、地点这些确定性东西,一旦靠模型即兴发挥,就会漂移。
「这三点的本质,都是缺一个"制片记忆"层——一个横跨生成全过程的、可靠的角色 / 场景 / 事实状态。」
04
THE FIX
一线解法:把"一致性"做成工程产物
第一,用"编剧搭子"先把一致性钉死
苏报的"影擎"漫剧创作平台(产品版本 v2.9.5)思路就很对症:你聊一句创意,AI 陪你把剧本拆成人物、场景、道具、分镜,每条都带名字、描述、提示词;再到"角色·场景·道具"环节,用人物四视图保证角色多角度一致性。等这些"卡"建好了,才进入生成视频。一致性不是抽出来的,是先在工程里定义好、再让模型照着走。
第二,用多智能体把"连贯叙事"焊进流水线
我们有一项已授权的发明专利——"一种基于多智能体协同的 AI 智能短视频生成方法及系统"(专利号 ZL 2025 1 1044744.8)。它的链路是:输入解析 → 分镜头脚本生成(镜头编号、景别、运镜、时长、情绪)→ 素材检索补全 → 分镜头视频生成 → 风格融合剪辑 → 情绪匹配背景音乐并同步混音 → 成片输出。它要解决的,正是"现有 AI 短视频只能生成 5–10 秒单场景片段、缺连贯叙事"的痛点。
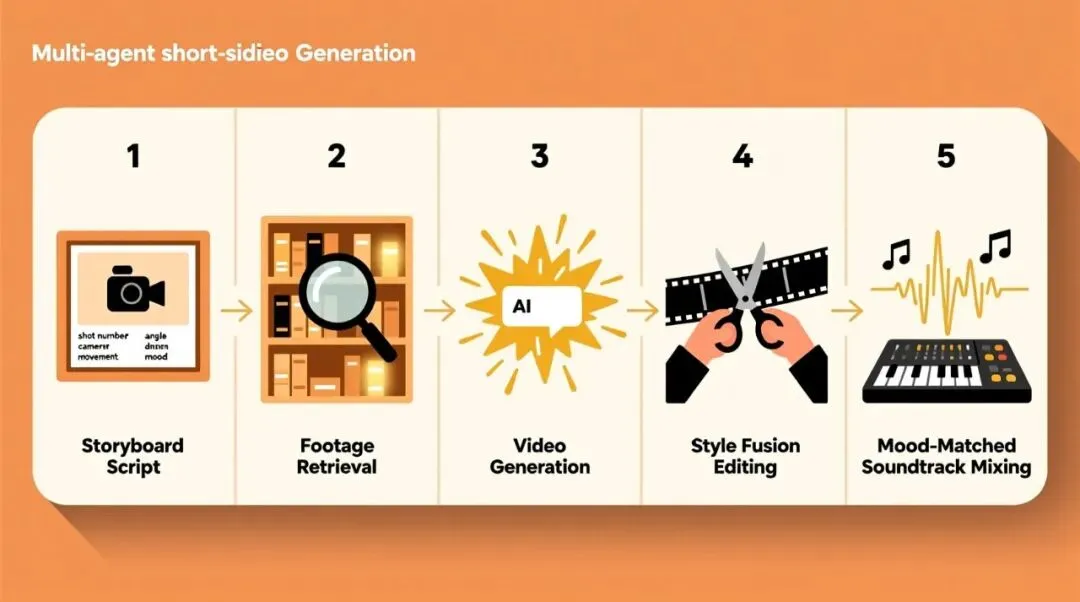
— 多智能体短视频生成流水线:分镜→检索→生成→剪辑→配乐,每一步都可校验。配图由 AI 生成,仅供示意。
第三,把知识图谱当"制片记忆"底座
我们"五库合一"的新闻数据中台里,沉淀了上百万级实体与关系的新闻知识图谱。对 AI 视频来说,它就是事实与一致性的底座:角色是谁、和谁什么关系、在什么地点、什么时间,模型生成时有了可追溯的锚点,漂移就少。这也呼应了我们一直说的那句:从"信息找人"到"人问信息",底座建好了,上面的智能体才跑得稳。
— 新闻知识图谱作为事实与一致性底座,托住每一段 AI 视频。配图由 AI 生成,仅供示意。
05
5 STEPS
给媒体技术人的 5 步补法
动笔之前,把角色卡、场景卡、关系卡定下来。别让模型即兴发挥——即兴的代价,是后面无穷无尽的"穿帮返工"。
分镜 → 检索 → 生成 → 剪辑 → 配乐,每一步都留可校验的接口。一致性不是某一个模型的魔法,而是一串约束的合力。
事实核查锚点、角色关系、地点时间,都从底座里取,而不是让模型"现编"。这是新闻类内容最该守住的一条线。
显性标识 + 隐形标识,从生成那一刻就打上,不事后补。观众有权知道眼前这段是不是 AI 做的。
情感浓度高的戏、临场判断、责任担当,这些留给真人。我们一直讲——AI 做重复、人做创造。模型把"重复劳动"吃了,人才有精力去做真正要动脑子、要担责任的那部分。
∞
EPILOGUE
结尾:模型替不了"讲故事"
工具在飞快升级,这是好事。可"讲故事"这件最朴素的事,模型暂时还替不了——它擅长画好每一帧,却还不擅长把一百帧连成一段让人愿意追下去的人生。
「对媒体来说,最大的资产从来不是最炫的模型,而是把几十年攒下的稿件、图片、视频,变成 AI 能稳稳调用的'事实与一致性底座'的能力。底座稳了,上面的智能体才不会跑偏;记忆建好了,故事才连得起来。」
我是 默默,一名传媒技术老兵,长期在一线折腾大模型赋能媒体生产与传播的那点事。
如果今天这篇对你搭 AI 视频产线有点用,欢迎点赞、在看、转发三连,我们下篇见。